

什么是 Mercury 2?
Mercury 2 是 Inception Lab 面向生产工作负载的快速推理模型,适用于延迟在代理循环、检索流水线与高并发应用中被放大的场景。
与标准的一次只解码一个 token 的自回归大模型不同,Mercury 2 采用扩散式的生成流程,以并行方式不断完善文本。这是其在合适的部署条件下能实现极高吞吐量的核心原因。
Mercury 2 的关键能力包括:
与 OpenAI 兼容的集成
Mercury 2 提供与 OpenAI 兼容的 API,意味着您只需更改基础 URL 与模型名称,就能使用现有的 OpenAI 客户端库。这使其可直接嵌入到现有应用、代理框架与生产流水线中,无需更换 SDK 或调整架构。
长上下文支持
该模型支持约 128K token 的上下文窗口,适用于需要传递大型证据集合、多步工具输出、会话轨迹或结构化中间态的工作流。
结构化输出与代理就绪
Mercury 2 能可靠处理受模式约束的 JSON,并支持工具式交互。由此可实现查询规划、工具参数生成、步骤间的结构化状态传递,以及对格式确定性有要求的验证流水线等用例。
运行时推理控制
与大多数通用模型不同,Mercury 2 提供诸如 reasoning_effort(从 instant 到 high)、可选推理摘要、流式输出与扩散式流式输出等操作控制。这些旋钮允许您在流水线不同阶段按调用粒度权衡速度、深度与交互性。
面向生产的成本模型
定价结构针对高频工作负载进行了优化,输入 token 成本低,且缓存的输入 token 享有大幅折扣。这对系统提示与上下文在多次模型调用中重用的代理循环与多步流水线尤为有利。
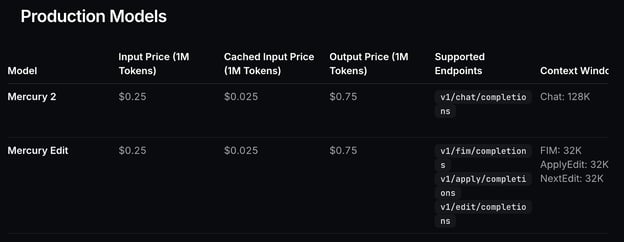
图: 模型定价
Mercury 2 如何工作?
传统大模型以自回归方式生成文本,按顺序一次生成一个 token。
token 1 - token 2 - token 3… 这使延迟与输出长度强耦合,因为每个 token 依赖前一个 token,延迟随输出长度线性增长。在每个用户请求可能触发多次模型调用的代理系统中,这会成为瓶颈。
Mercury 2 采用不同的方法。它不是顺序解码,而是使用受扩散启发的并行完善过程。模型先生成初稿,然后在少量步骤中同时完善多个 token。
生成过程更像迭代编辑,而非逐字输入,这提升了吞吐并减少了多次调用流水线的端到端延迟。
这一完善过程也支持 diffusing 模式,即在 UI 中流式展示中间草稿并逐步改进。用户可实时看到文本演变为最终形态,尤其适用于演示、交互式应用和实时研究界面。
这种架构使 Mercury 2 尤其适合延迟在多阶段推理中被叠加的系统,而非一次性提示。
Mercury 2 教程:构建实时多步研究代理
本节我们将使用 Mercury 2 构建一个实时研究助手,它可以接收复杂问题、搜索网页、跨多来源进行推理,并在数秒内返回有依据的答案。系统并非单次提示-响应交互,而是运行快速的多步代理循环,每一步都提炼出生成可靠结果所需的信息。
从高层看,应用执行五项核心任务:
- 查询扩展: 我们 生成多个聚焦的搜索查询(以结构化 JSON 表示),覆盖问题的不同方面。
- 并行网页搜索: 然后并发执行所有查询,以最小化延迟并快速收集多样化来源。
- 证据规范化: 我们将搜索结果清洗并压缩为紧凑的证据 JSON,便于模型推理。
- 基于来源的综合: 我们还 仅使用提供的证据生成结构化答案,并添加如
[S1]、[S2]的行内引文。 - 可选验证环节: 用户还可以 运行第二次模型调用,审阅草稿答案并移除或弱化任何证据不支持的陈述。验证阶段采用轻量的“生成-批判-修正”模式,即模型将草稿与证据对照审阅,并为更强的事实依据进行修订。
应用生成两类主要输出:
- 基于来源的洞见,带有链接到网页证据的行内引文。
- 执行透明度,包括生成的搜索计划、检索到的来源以及分步延迟。
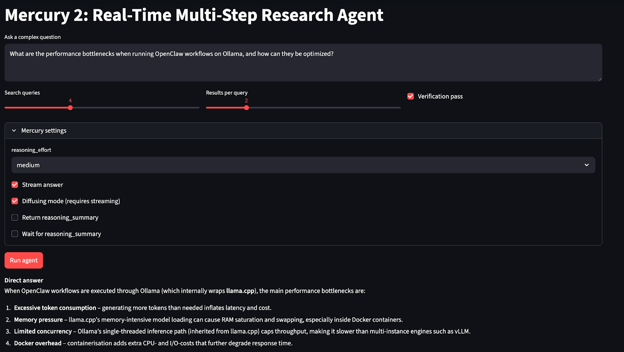
步骤 1:获取 API 访问
在构建研究代理之前,需要先获取 Mercury 2 API 的访问权限。由于 Mercury 2 目前通过提前体验提供,本步骤确保您拥有从应用进行推理调用所需的凭据与端点配置。
您可在此申请访问:https://www.inceptionlabs.ai/early-access。
账户获批后:
- 登录 Inception 平台
- 前往 API Keys
- 点击 Create API Key
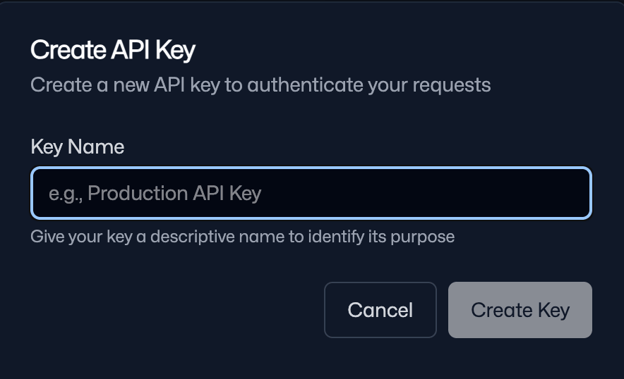
- 提供名称并复制生成的密钥
请妥善保存该密钥,您将用它来验证所有 API 请求。
注意:初次注册可获得 10,000,000 个免费 token,足以完成本实验。
步骤 2:环境配置
既然已经有了 API 访问权限,下一步是为构建和运行 Mercury 2 研究代理准备本地环境。由于 Inception API 与 OpenAI 兼容,我们可以使用标准的 OpenAI Python 客户端,并搭配用于网页界面与搜索流水线的一组库。同时,我们将保存的 API 密钥存储为环境变量。
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”"我们安装运行 Mercury 2 研究代理所需的核心依赖并配置安全的 API 访问。我们使用标准的 OpenAI 客户端进行模型调用,使用 Streamlit 构建交互界面,使用 aiohttp 以并行方式运行网页搜索以实现低延迟检索,并结合 beautifulsoup4 与 lxml 解析搜索结果。
安装完成后,请将 INCEPTION_API_KEY 设置为环境变量,以保证凭据安全,并使应用在运行时可自动完成身份验证。
下一步,我们将实现 Mercury 客户端并构建核心多步代理流水线。
步骤 3:Mercury 客户端
本步骤完成三项工作:导入全局使用的库,从环境安全读取 API 密钥,并初始化指向 Inception 基础 URL 的 OpenAI 客户端。
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)上述代码片段初始化了一个 Mercury 2 客户端,并导入应用所需的支撑栈,包括用于 UI 的 Streamlit、用于异步网页请求的 aiohttp、用于解析搜索结果的 BeautifulSoup,以及用于 JSON 处理、计时和数据结构的标准 Python 工具。
随后我们从环境变量读取 INCEPTION_API_KEY,配置 Inception 基础 URL 以正确路由请求,并将模型名设为 "mercury-2",以便后续调用均使用目标推理模型。
最后,通过自定义基础 URL 初始化 OpenAI 客户端,从而能够使用标准的 chat.completions 接口调用 Mercury 2。
步骤 4:网页搜索工具
接下来需要一个可从网络获取最新信息的检索步骤。在本教程中,我们将使用 DuckDuckGo 的 HTML 端点 并直接解析结果,因为它无需额外的 API 密钥,且足够快速,适合原型开发。
从高层看,我们实现三件事:
- 针对 DuckDuckGo 的 HTML 结果页运行查询
- 将顶部结果解析为结构化的
SearchResult格式 - 对结果去重并打包为紧凑 JSON,便于 Mercury 后续引用
DDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidence上述工具定义了四个关键组件:
- 异步网页检索:
ddg_search()使用aiohttp查询 DuckDuckGo 的 HTML 端点,并结合 BeautifulSoup 与 lxml 解析响应。每条结果被提取为结构化格式,函数在达到max_results后停止以降低延迟,从而允许多个搜索并行异步执行。 - 文本规范化:
clean_text()帮助函数移除多余空白与格式杂质,使摘要保持紧凑可读。结果通过SearchResult数据类存储,标准化输出并让后续阶段不受原始 HTML 结构影响。 - 跨查询去重:代理运行多个查询时,常会重复出现相同页面。
dedupe_results()通过标准化 URL 移除重复,确保证据集合在上下文窗口内保持多样与高效。 - 为模型推理打包证据:
pack_evidence()将结果转换为带稳定标识符的紧凑 JSON 结构。摘要被修剪至约 320 个字符,以便合并证据能适配模型上下文,并在后续用行内引文进行引用。
给读者的说明:
这种使用 DuckDuckGo HTML 的方法便于原型开发,因为无需额外 API 密钥,但并非生产级搜索:
- HTML 布局可能变更,导致选择器失效
- 限速/反爬虫可能阻断抓取
- 结果质量与排序可能波动
若需生产可用版本,请替换为稳定的搜索 API(SerpAPI、Bing Web Search、Google Programmable Search、Brave Search 等),其余代理逻辑可保持不变。
接下来,我们将把这一检索层接入 Mercury 2,使模型能生成搜索查询、对收集的证据进行推理,并输出基于来源的答案。
步骤 5:Mercury 调用
本步骤将 Mercury 2 封装到一个小型、可复用的接口后面,同时支持严格的结构化输出(用于规划)与流式文本生成(用于综合与扩散演示)。
目标是在保持每次模型调用一致的同时,通过统一的设置对象暴露 Mercury 的“推理控制项”和流式模式。
def mercury_settings(
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
diffusing: bool = False,
) -> Dict[str, Any]:
return {
"reasoning_effort": reasoning_effort,
"reasoning_summary": reasoning_summary,
"reasoning_summary_wait": reasoning_summary_wait,
"diffusing": diffusing,
}
def mercury_json(
system: str,
user: str,
max_tokens: int = 400,
reasoning_effort: str = "medium",
) -> Dict[str, Any]:
def _call(messages) -> str:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=0.0,
stream=False,
extra_settings=mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
diffusing=False,
),
)
return (resp.choices[0].message.content or "").strip()
text = _call(
[{"role": "system", "content": system}, {"role": "user", "content": user}]
)
try:
return json.loads(text)
except json.JSONDecodeError:
pass
m = re.search(r"\{.*\}", text, flags=re.DOTALL)
if m:
try:
return json.loads(m.group(0))
except json.JSONDecodeError:
pass
repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
repair_user = (
"Fix the following so it is valid JSON and matches the required schema.\n\n"
"REQUIRED SCHEMA:\n"
"{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
"BROKEN OUTPUT:\n"
f"{text}"
)
fixed = _call(
[{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
)
try:
return json.loads(fixed)
except json.JSONDecodeError:
m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
if not m2:
raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
return json.loads(m2.group(0))
def mercury_text(
system: str,
user: str,
max_tokens: int = 950,
temperature: float = 0.3,
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
stream: bool = False,
diffusing: bool = False,
stream_callback=None,
) -> str:
if diffusing:
stream = True
extra_settings = mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
diffusing=diffusing,
)
messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
if not stream:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=False,
extra_settings=extra_settings,
)
return (resp.choices[0].message.content or "").strip()
full = ""
stream_resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=True,
extra_settings=extra_settings,
)
for event in stream_resp:
choices = getattr(event, "choices", None) or []
if not choices:
continue
delta = getattr(choices[0], "delta", None)
chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
if not chunk:
continue
if diffusing:
full = chunk
else:
full += chunk
if stream_callback:
stream_callback(full, {"delta": chunk})
return full.strip()在本步骤中,我们定义了包含三大要点的辅助函数:
- 推理控制项设置:
mercury_settings()将reasoning_effort、reasoning_summary、reasoning_summary_wait与diffusing等 Mercury 特定参数集中管理。这样能保持流水线一致,也便于把 Streamlit 的开关直接接入每次模型调用而不重复配置。 - 与模式对齐的 JSON 生成:
mercury_json()用于需要结构化输出的场景。它在temperature=0.0下运行并禁用流式/扩散,以最大化格式稳定性。函数先直接解析 JSON,若失败尝试用正则提取 JSON 块,最后回退到修复流程,强制模型返回符合所需模式的有效 JSON。 - 带可选流式与扩散的文本生成:
mercury_text()同时支持非流式与流式模式。若diffusing=True,会自动开启stream=True,并通过覆盖当前缓冲区的方式更新显示文本。在普通流式模式下,则通过追加增量构建最终响应。可选的stream_callback()钩子允许 UI 实时渲染更新。
在下一步中,我们将使用这些辅助函数实现结构化查询扩展,并将其与网页搜索与证据打包流水线衔接。
步骤 6:结构化查询扩展
现在将 Mercury 2 与网页搜索连接为端到端的研究循环。关键思路是先生成结构化搜索计划,再强制最终答案基于证据负载,以在 UI 中展示 Mercury 的推理控制与流式/扩散模式。
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
system = (
"Return ONLY valid JSON. No markdown.\n"
"Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
"Rules:\n"
f"- MUST produce at least {max(3, n_queries-2)} queries\n"
"- queries <= 12 words, diverse\n"
"- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
"Output must start with '{' and end with '}'."
)
user = f"Question: {question}\nReturn {n_queries} queries."
out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
queries = (out.get("queries") or [])
subqs = (out.get("subquestions") or [])
must = (out.get("must_cover") or [])
if len(queries) == 0:
queries = [
f"{question} benchmarks",
"vLLM edge inference benchmarks",
"llama.cpp edge inference benchmarks",
"vLLM vs llama.cpp quantization",
"llama.cpp Metal CUDA Vulkan performance",
"vLLM KV cache paged attention memory",
][:n_queries]
out["queries"] = queries[:n_queries]
out["subquestions"] = subqs[: min(6, n_queries)]
out["must_cover"] = must[:6]
return out
def answer_with_citations(
question: str,
evidence: List[Dict[str, str]],
*,
reasoning_effort: str,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream: bool,
diffusing: bool,
stream_callback=None,
) -> str:
system = (
"You are a fast research synthesizer.\n"
"Use ONLY the provided evidence.\n"
"Add inline citations like [S1], [S2] using evidence ids.\n"
"If evidence is insufficient, say what's missing."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
"Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.3,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream,
diffusing=diffusing,
stream_callback=stream_callback,
)
def verify_answer(
question: str,
evidence: List[Dict[str, str]],
draft: str,
*,
reasoning_effort: str,
) -> str:
system = (
"You are a verifier.\n"
"Remove/soften any claim not supported by evidence.\n"
"Keep citations [S#]. Return revised answer."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
f"Draft:\n{draft}"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.2,
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
stream=False,
diffusing=False,
)
async def run_agent(
question: str,
n_queries: int,
max_results_per_query: int,
do_verify: bool,
*,
reasoning_effort: str,
stream_answer: bool,
diffusing: bool,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream_callback=None,
) -> Dict[str, Any]:
t0 = time.perf_counter()
plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
t1 = time.perf_counter()
queries = plan.get("queries", [])
async with aiohttp.ClientSession() as session:
tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
lists = await asyncio.gather(*tasks)
flat = dedupe_results([r for lst in lists for r in lst])
evidence = pack_evidence(flat, max_items=18)
t2 = time.perf_counter()
draft = answer_with_citations(
question,
evidence,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream_answer,
diffusing=diffusing,
stream_callback=stream_callback,
)
t3 = time.perf_counter()
final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
t4 = time.perf_counter()
return {
"plan": plan,
"evidence": evidence,
"answer": final,
"timings_sec": {
"expand": round(t1 - t0, 3),
"search_parallel": round(t2 - t1, 3),
"synthesize": round(t3 - t2, 3),
"verify": round(t4 - t3, 3),
"total": round(t4 - t0, 3),
},
}本步骤将四个核心阶段贯通起来:
- 结构化查询规划:
expand_query()要求 Mercury 2 返回包含queries、subquestions与must_cover的严格 JSON,从而生成结构化研究计划。输出通过mercury_json()解析,包含自动 JSON 修复,并在计划为空时使用回退查询集以确保代理继续运行。 - 带引文的基于证据综合:
answer_with_citations()仅使用搜索阶段打包的证据生成初始响应。提示明确限制模型仅使用提供的证据并要求行内引文。输出包含直接答案、关键洞见与注意点,确保响应简洁且可溯源。 - 可选验证以强化依据:
verify_answer()实现“生成-批判-修正”模式。其将草稿答案与相同证据重新对照,移除或弱化不被支持的陈述,同时保留引文标记。该额外步骤以极低延迟开销减少过度泛化并提升事实依据。 - 带性能跟踪的编排:
run_agent()协调整个流程,包括扩展查询计划、使用aiohttp与asyncio.gather()并行执行 DuckDuckGo 搜索、对结果去重并打包为紧凑证据 JSON、生成综合答案以及可选的验证。
步骤 7:Streamlit 界面
最后,我们将代理运行时(run_agent)接入 Streamlit 界面,让用户可以输入问题、调节代理的搜索广度与深度,并审查完整的执行轨迹——最终答案、计时、生成的查询计划和证据集合。
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
"Ask a complex question",
height=120,
placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
max_results = st.slider("Results per query", 1, 6, 2)
with col3:
do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
stream_answer = st.checkbox("Stream answer", value=False)
diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
if diffusing and not stream_answer:
st.info("Diffusing requires streaming. Enabling streaming automatically.")
stream_answer = True
run = st.button("Run agent", type="primary")
if run:
if not question.strip():
st.warning("Enter a question.")
st.stop()
answer_placeholder = st.empty()
status_placeholder = st.empty()
def _stream_cb(text: str, meta: Dict[str, Any]):
answer_placeholder.markdown(text)
with st.spinner("Running…"):
status_placeholder.caption("Planning → searching → synthesizing…")
out = asyncio.run(
run_agent(
question.strip(),
n_queries,
max_results,
do_verify,
reasoning_effort=reasoning_effort,
stream_answer=stream_answer,
diffusing=diffusing,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream_callback=_stream_cb if stream_answer else None,
)
)
status_placeholder.empty()
st.subheader("Answer")
st.write(out["answer"])
st.subheader("Timings (sec)")
st.json(out["timings_sec"])
with st.expander("Plan (queries / subquestions)"):
st.json(out["plan"])
with st.expander("Evidence (search results)"):
st.json(out["evidence"])上述代码定义了 Streamlit 层如何将 run_agent() 函数转化为交互式研究工作流。用户输入问题,控制搜索的广度与深度,并可选开启验证步骤以移除不被支持的陈述。
额外的“Mercury settings”面板提供模型控制项,如 reasoning_effort、streaming 输出与 diffusing 模式。扩散模式需要流式输出,并会在新片段到达时原位更新答案占位符。
运行时,应用会校验输入,在占位符中流式呈现部分输出,然后渲染最终答案及计时,并提供生成计划与证据集合的可展开调试视图。
如需自行尝试,将代码保存为 app.py 并启动:
streamlit run app.py结语
在本教程中,我们构建了一款由 Mercury 2 驱动、具备延迟感知能力的研究代理。系统为用户查询生成结构化搜索计划,随后并行执行网页检索,将结果规范化为紧凑的证据格式,并生成带引文的有依据答案。
我们还加入了可选的验证环节,基于同一证据重新检查草稿并弱化不被支持的陈述。这个简单的“生成–批判–修正”模式在几乎不增加延迟的情况下显著提升了事实依据。
除核心流水线外,应用还提供 Mercury 2 的运行时控制,包括推理力度、流式输出、推理摘要与扩散模式。若要进一步扩展本项目,您可以:
- 将 DuckDuckGo 抓取替换为生产级搜索 API(Bing、SerpAPI、Brave)
- 缓存搜索结果或中间计划,降低重复延迟
- 持久化证据以支持会话记忆或多轮研究
- 新增摘要层,以提升证据筛选质量
若想继续学习如何将 AI 应用于开发任务,推荐学习 AI-Assisted Coding for Developers 课程。
Mercury 2 常见问题
Mercury 2 与传统大模型有何不同?
Mercury 2 采用扩散式并行完善过程,先生成草稿,再在若干步中改进。这使其在延迟累积的多次调用流水线中实现更高吞吐与更佳性能。
什么是 Mercury 2 的 diffusing 模式?
Diffusing 模式会在模型完善输出的过程中流式展示中间草稿。相比逐 token 输入,文本会在原位被逐步重写与改进。
为何要加入验证环节?
验证步骤会基于相同证据重新评估草稿并移除不被支持的陈述。只需一次额外的模型调用,即可提升依据性。
DuckDuckGo 的搜索实现是否可用于生产?
不建议。采用 HTML 抓取是为简化起见且无需 API 密钥,但若页面布局变更可能失效,且可能受限速影响。生产环境请替换为稳定搜索 API,如 Bing Web Search、Brave Search 或 SerpAPI。
Mercury 2 的费用如何?
Mercury 2 为高频工作负载而设计,输入 token 成本低,缓存 token 价格优惠。新用户当前在注册时可获得免费 token,足以完成本教程并试验该代理。

我是一名 Google Developers 机器学习(生成式 AI)领域的专家、Kaggle 三项专家,以及 Women Techmakers 大使,拥有 3 年以上的技术从业经验。2020 年我共同创办了一家健康科技初创公司,目前在佐治亚理工学院攻读计算机科学硕士,专攻机器学习。
Mercury 2 专为生产级推理工作负载而设计,适用于涉及代理工作流(如搜索、规划和检索流水线)的场景。在这些场景中,传统的自回归模型因顺序解码而变慢。在本教程中,我们将使用 Mercury 2 与 Streamlit 搭建一个实时多步研究代理。
在应用中,用户提出复杂问题,系统将其扩展为多个聚焦的搜索查询,并行检索网页结果,将其压缩为结构化证据,然后生成带行内引文、以来源为依据的答案。
可选的验证步骤会基于证据审阅草稿并移除不被支持的陈述。界面还提供 Mercury 的运行时控制,包括推理力度、流式输出,以及可在实时中展示逐步完善过程的扩散式流式输出。
在此过程中,您将学到如何:
reasoning_effort等推理控制项管理运行时行为streaming与diffusing模式,实时可视化迭代完善过程最终应用将返回搜索计划、证据来源与分步延迟,使系统既快速又可审查。