

Apa itu Mercury 2?
Mercury 2 adalah model penalaran cepat Inception Lab yang dirancang untuk beban kerja produksi di mana latensi menumpuk pada loop agen, pipeline pengambilan, dan aplikasi dengan konkurensi tinggi.
Berbeda dengan LLM autoregresif standar yang mendecode satu token pada satu waktu, Mercury 2 menggunakan proses generasi bergaya difusi yang menyempurnakan teks secara paralel, yang menjadi alasan utama kemampuannya mendorong throughput sangat tinggi dengan pengaturan penyajian yang tepat.
Kemampuan utama Mercury 2 meliputi:
Integrasi kompatibel OpenAI
Mercury 2 menyediakan API yang kompatibel dengan OpenAI, artinya Anda dapat menggunakan pustaka klien OpenAI yang ada hanya dengan mengubah base URL dan nama model. Ini memudahkan integrasi ke aplikasi, kerangka agen, dan pipeline produksi yang sudah ada tanpa mengharuskan perubahan SDK atau arsitektur.
Dukungan konteks panjang
Model ini mendukung jendela konteks sekitar 128K token, cocok untuk alur kerja yang perlu mengoper kumpulan bukti besar, keluaran alat multi-langkah, jejak percakapan, atau status antara terstruktur.
Keluaran terstruktur dan siap untuk agen
Mercury 2 menangani JSON dengan skema terbatasi secara andal dan mendukung interaksi bergaya alat. Ini memungkinkan kasus penggunaan seperti perencanaan kueri, pembuatan argumen alat, pengoperan status terstruktur antarlangkah, dan pipeline verifikasi di mana format deterministik penting.
Kontrol penalaran runtime
Tidak seperti sebagian besar model serbaguna, Mercury 2 menyediakan kontrol operasional seperti reasoning_effort (instan hingga tinggi), ringkasan penalaran opsional, output streaming, dan streaming bergaya difusi. Pengatur ini memungkinkan Anda menyetel kompromi antara kecepatan, kedalaman, dan interaktivitas per panggilan tergantung tahap pipeline.
Model biaya berorientasi produksi
Struktur harga dioptimalkan untuk beban kerja berfrekuensi tinggi, dengan biaya token input rendah dan diskon signifikan untuk token input yang di-cache. Ini bermanfaat untuk loop agen dan pipeline multi-langkah di mana prompt sistem dan konteks digunakan ulang di banyak panggilan model.
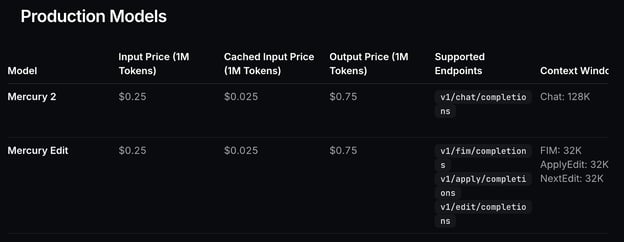
Gambar: Harga model
Bagaimana Cara Kerja Mercury 2?
LLM tradisional menghasilkan teks secara autoregresif, memproduksi satu token dalam urutan.
token 1 - token 2 - token 3… Ini membuat latensi sangat terkait dengan panjang output karena setiap token bergantung pada token sebelumnya, sehingga latensi bertambah linier dengan panjang output. Ini menjadi hambatan pada sistem agen di mana Anda mungkin menjalankan beberapa panggilan model per permintaan pengguna.
Mercury 2 mengambil pendekatan berbeda. Alih-alih decoding berurutan, model ini menggunakan proses penyempurnaan paralel yang terinspirasi difusi. Model menghasilkan draf awal lalu menyempurnakan banyak token secara bersamaan dalam sejumlah kecil langkah.
Generasi lebih menyerupai penyuntingan iteratif daripada mengetik langkah demi langkah, yang meningkatkan throughput dan mengurangi latensi ujung-ke-ujung dalam pipeline multi-panggilan.
Proses penyempurnaan ini juga memungkinkan mode diffusing, di mana draf antara di-stream dan ditingkatkan secara progresif di UI. Pengguna dapat menyaksikan teks berkembang menuju bentuk finalnya secara real time, yang sangat berguna untuk demo, aplikasi interaktif, dan antarmuka riset langsung.
Arsitektur ini membuat Mercury 2 paling cocok untuk sistem di mana latensi menumpuk di beberapa tahap penalaran alih-alih prompt satu kali.
Tutorial Mercury 2: Bangun Agen Riset Multi-Langkah Real-Time
Pada bagian ini, kita akan membangun asisten riset real-time menggunakan Mercury 2 yang dapat menerima pertanyaan kompleks, menelusuri web, bernalar lintas banyak sumber, dan mengembalikan jawaban berbasis sumber dalam hitungan detik. Alih-alih interaksi satu prompt–satu respons, sistem menjalankan loop agen multi-langkah yang cepat, di mana setiap langkah menyempurnakan informasi yang dibutuhkan untuk menghasilkan hasil yang andal.
Secara garis besar, aplikasi melakukan lima tugas inti:
- Perluasan kueri: Kami menghasilkan beberapa kueri penelusuran yang terfokus (dalam JSON terstruktur) untuk mencakup berbagai aspek pertanyaan.
- Penelusuran web paralel: Lalu, kami menjalankan semua kueri secara bersamaan untuk meminimalkan latensi dan mengumpulkan sumber yang beragam dengan cepat.
- Normalisasi bukti: Kami membersihkan dan mengompres hasil penelusuran menjadi JSON bukti ringkas yang dapat digunakan model untuk bernalar.
- Sintesis berbasis sumber: Kami juga menghasilkan jawaban terstruktur hanya menggunakan bukti yang disediakan, dengan sitasi inline seperti
[S1],[S2]. - Verifikasi opsional: Pengguna juga dapat menjalankan panggilan model kedua yang meninjau draf jawaban dan menghapus atau melunakkan klaim yang tidak didukung oleh bukti. Tahap verifikasi menerapkan pola Generate–Critique–Fix yang ringan, di mana model meninjau drafnya sendiri terhadap bukti dan merevisinya agar landasan faktualnya lebih kuat.
Aplikasi menghasilkan dua keluaran utama:
- Wawasan berbasis sumber dengan sitasi inline yang ditautkan ke bukti web.
- Transparansi eksekusi, termasuk rencana penelusuran yang dihasilkan, sumber yang diambil, dan latensi per langkah.
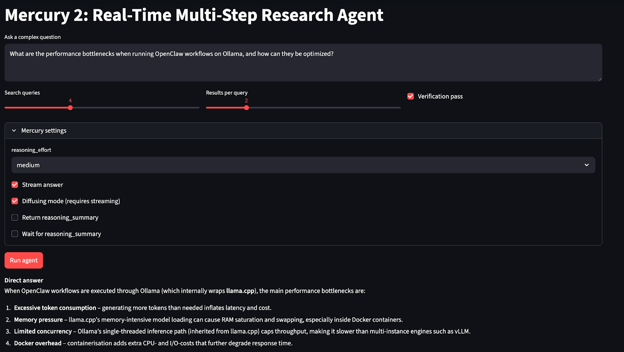
Langkah 1: Dapatkan akses API
Sebelum kita membangun agen riset, pertama-tama kita perlu akses ke API Mercury 2. Karena Mercury 2 saat ini tersedia melalui early access, langkah ini memastikan Anda memiliki kredensial dan konfigurasi endpoint yang diperlukan untuk melakukan panggilan inferensi dari aplikasi Anda.
Anda dapat meminta akses di sini: https://www.inceptionlabs.ai/early-access.
Setelah akun Anda disetujui:
- Masuk ke Inception Platform
- Navigasikan ke API Keys
- Klik Create API Key
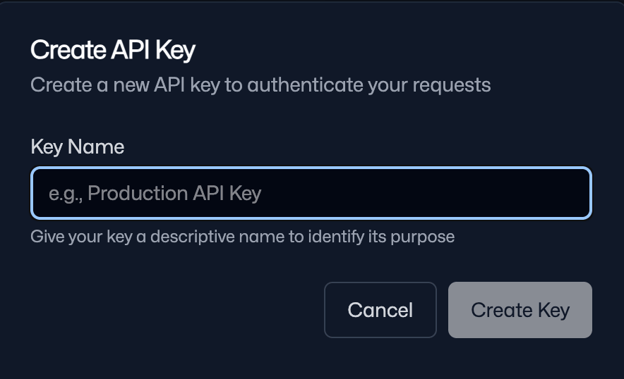
- Berikan nama dan salin kunci yang dihasilkan
Simpan kunci ini dengan aman karena Anda akan menggunakannya untuk mengautentikasi semua permintaan API.
Catatan: Anda mendapatkan 10.000.000 token gratis saat pertama kali mendaftar, cukup untuk menjalankan eksperimen ini.
Langkah 2: Menyiapkan lingkungan
Sekarang Anda memiliki akses API, langkah berikutnya adalah menyiapkan lingkungan lokal untuk membangun dan menjalankan agen riset Mercury 2. Karena API Inception kompatibel dengan OpenAI, kita dapat menggunakan klien OpenAI Python standar bersama serangkaian pustaka untuk antarmuka web dan pipeline penelusuran. Kita juga menyimpan kunci API sebagai variabel lingkungan.
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”Kita memasang dependensi inti yang diperlukan untuk menjalankan agen riset Mercury 2 dan mengonfigurasi akses API yang aman. Kita menggunakan klien OpenAI standar untuk panggilan model, Streamlit untuk membangun antarmuka interaktif, aiohttp untuk menjalankan penelusuran web paralel demi pengambilan berlatensi rendah, dan beautifulsoup4 dengan lxml untuk mengurai hasil penelusuran.
Setelah memasang paket, setel INCEPTION_API_KEY Anda sebagai variabel lingkungan untuk menjaga kredensial tetap aman dan memungkinkan aplikasi melakukan autentikasi otomatis saat runtime.
Pada langkah berikutnya, kita akan mengimplementasikan klien Mercury dan membangun pipeline agen multi-langkah inti.
Langkah 3: Klien Mercury
Langkah ini menyambungkan tiga hal: mengimpor pustaka yang akan kita gunakan di seluruh aplikasi, memuat kunci API secara aman dari lingkungan, dan menginisialisasi klien OpenAI yang diarahkan ke base URL Inception.
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)Cuplikan kode di atas menginisialisasi klien Mercury 2 dan mengimpor tumpukan pendukung untuk aplikasi, termasuk Streamlit untuk UI, aiohttp untuk permintaan web asinkron, BeautifulSoup untuk mengurai hasil penelusuran, dan utilitas Python standar untuk penanganan JSON, pengukuran waktu, dan struktur data.
Kita kemudian membaca INCEPTION_API_KEY dari variabel lingkungan dan base URL Inception dikonfigurasi untuk merutekan permintaan dengan benar, serta nama model disetel ke "mercury-2" sehingga semua panggilan berikutnya menggunakan model penalaran yang dimaksud.
Terakhir, klien OpenAI diinisialisasi dengan base URL kustom, memungkinkan Mercury 2 dipanggil menggunakan antarmuka chat.completions standar.
Langkah 4: Alat penelusuran web
Selanjutnya, kita memerlukan langkah pengambilan yang dapat mengambil informasi terbaru dari web. Dalam tutorial ini, kita akan mengimplementasikan alat penelusuran menggunakan endpoint HTML DuckDuckGo dan mengurai hasilnya langsung karena tidak memerlukan kunci API tambahan dan cukup cepat untuk prototyping.
Secara garis besar, kita mengimplementasikan tiga hal:
- Menjalankan kueri terhadap halaman hasil HTML DuckDuckGo
- Mengurai hasil teratas ke format terstruktur
SearchResult - Menghapus duplikasi dan mengemas hasil ke JSON ringkas yang dapat dirujuk Mercury nanti
DDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceUtilitas di atas mendefinisikan empat komponen kunci:
- Pengambilan web asinkron: Fungsi
ddg_search()menjalankan kueri ke endpoint HTML DuckDuckGo menggunakanaiohttpdan mengurai respons dengan BeautifulSoup dan lxml. Setiap hasil diekstrak ke format terstruktur, dan fungsi berhenti setelah entrimax_resultsuntuk menjaga latensi tetap rendah. Ini memungkinkan banyak penelusuran dieksekusi secara paralel secara asinkron. - Normalisasi teks: Pembantu
clean_text()menghapus spasi berlebih dan artefak pemformatan agar cuplikan tetap ringkas dan mudah dibaca. Hasil kemudian disimpan menggunakan dataclassSearchResult, yang menstandarkan output dan menjaga tahap berikutnya tetap independen dari struktur HTML mentah. - Deduplikasi antar kueri: Saat agen menjalankan beberapa kueri penelusuran, halaman yang sama sering muncul berulang. Fungsi
dedupe_results()menghapus duplikasi dengan menormalkan URL, memastikan set bukti tetap beragam dan efisien dalam jendela konteks. - Pengemasan bukti untuk penalaran model: Fungsi
pack_evidence()mengonversi hasil menjadi struktur JSON ringkas dengan pengidentifikasi stabil. Cuplikan dipangkas hingga ~320 karakter agar gabungan bukti muat dalam konteks model dan dapat dirujuk nanti menggunakan sitasi inline.
Catatan untuk pembaca:
Pendekatan HTML DuckDuckGo ini ramah prototipe karena tidak perlu kunci API tambahan, tetapi bukan penelusuran siap produksi:
- Tata letak HTML dapat berubah dan merusak selector
- Pembatasan laju / perlindungan bot dapat memblokir scraping
- Kualitas dan pemeringkatan hasil dapat bervariasi
Jika Anda menginginkan versi siap produksi, ganti dengan Search API yang stabil (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search, dll.) dan biarkan bagian agen lainnya tetap sama.
Selanjutnya, kita akan menghubungkan lapisan pengambilan ini ke Mercury 2 sehingga model dapat menghasilkan kueri penelusuran, bernalar atas bukti yang dikumpulkan, dan menghasilkan jawaban berbasis sumber.
Langkah 5: Panggilan Mercury
Pada langkah ini, kita membungkus Mercury 2 di balik antarmuka kecil yang dapat digunakan ulang yang mendukung keluaran terstruktur ketat (untuk perencanaan) dan generasi teks streaming (untuk sintesis dan demo diffusing).
Tujuannya adalah menjaga setiap panggilan model konsisten, sekaligus mengekspos “pengatur penalaran” Mercury dan mode streaming melalui satu objek pengaturan.
def mercury_settings(
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
diffusing: bool = False,
) -> Dict[str, Any]:
return {
"reasoning_effort": reasoning_effort,
"reasoning_summary": reasoning_summary,
"reasoning_summary_wait": reasoning_summary_wait,
"diffusing": diffusing,
}
def mercury_json(
system: str,
user: str,
max_tokens: int = 400,
reasoning_effort: str = "medium",
) -> Dict[str, Any]:
def _call(messages) -> str:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=0.0,
stream=False,
extra_settings=mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
diffusing=False,
),
)
return (resp.choices[0].message.content or "").strip()
text = _call(
[{"role": "system", "content": system}, {"role": "user", "content": user}]
)
try:
return json.loads(text)
except json.JSONDecodeError:
pass
m = re.search(r"\{.*\}", text, flags=re.DOTALL)
if m:
try:
return json.loads(m.group(0))
except json.JSONDecodeError:
pass
repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
repair_user = (
"Fix the following so it is valid JSON and matches the required schema.\n\n"
"REQUIRED SCHEMA:\n"
"{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
"BROKEN OUTPUT:\n"
f"{text}"
)
fixed = _call(
[{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
)
try:
return json.loads(fixed)
except json.JSONDecodeError:
m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
if not m2:
raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
return json.loads(m2.group(0))
def mercury_text(
system: str,
user: str,
max_tokens: int = 950,
temperature: float = 0.3,
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
stream: bool = False,
diffusing: bool = False,
stream_callback=None,
) -> str:
if diffusing:
stream = True
extra_settings = mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
diffusing=diffusing,
)
messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
if not stream:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=False,
extra_settings=extra_settings,
)
return (resp.choices[0].message.content or "").strip()
full = ""
stream_resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=True,
extra_settings=extra_settings,
)
for event in stream_resp:
choices = getattr(event, "choices", None) or []
if not choices:
continue
delta = getattr(choices[0], "delta", None)
chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
if not chunk:
continue
if diffusing:
full = chunk
else:
full += chunk
if stream_callback:
stream_callback(full, {"delta": chunk})
return full.strip()Pada langkah ini, kita mendefinisikan fungsi pembantu dengan tiga komponen kunci:
- Pengaturan pengatur penalaran: Fungsi
mercury_settings()memusatkan parameter spesifik Mercury sepertireasoning_effort,reasoning_summary,reasoning_summary_wait, dandiffusing. Ini menjaga pipeline konsisten dan memudahkan menghubungkan toggle Streamlit langsung ke setiap panggilan model tanpa menduplikasi konfigurasi. - Pembuatan JSON selaras skema:
mercury_json()digunakan saat agen membutuhkan keluaran terstruktur. Ia berjalan dengantemperature=0.0dan menonaktifkan streaming/difusi untuk memaksimalkan stabilitas format. Fungsi mencoba mengurai JSON secara langsung, lalu mencoba mengekstrak blok JSON via regex, dan akhirnya jatuh ke langkah perbaikan yang memaksa model mengembalikan JSON valid sesuai skema yang diperlukan. - Generasi teks dengan streaming dan difusi opsional: Fungsi
mercury_text()mendukung mode non-streaming maupun streaming. Jikadiffusing=True, ia otomatis memaksastream=True, dan memperbarui teks yang ditampilkan dengan menimpa buffer saat ini. Dalam mode streaming normal, ia menambahkan delta untuk membangun respons akhir. Kait opsionalstream_callback()memungkinkan UI merender pembaruan secara langsung.
Pada langkah berikutnya, kita akan menggunakan pembantu ini untuk mengimplementasikan perluasan kueri terstruktur dan menghubungkannya ke pipeline penelusuran web serta pengemasan bukti.
Langkah 6: Perluasan kueri terstruktur
Sekarang, kita menghubungkan Mercury 2 dan penelusuran web menjadi loop riset ujung-ke-ujung. Gagasan kuncinya adalah pertama menghasilkan rencana penelusuran terstruktur, kemudian memaksa jawaban akhir berbasis payload bukti, untuk menampilkan kontrol penalaran Mercury dan mode streaming/diffusing di UI.
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
system = (
"Return ONLY valid JSON. No markdown.\n"
"Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
"Rules:\n"
f"- MUST produce at least {max(3, n_queries-2)} queries\n"
"- queries <= 12 words, diverse\n"
"- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
"Output must start with '{' and end with '}'."
)
user = f"Question: {question}\nReturn {n_queries} queries."
out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
queries = (out.get("queries") or [])
subqs = (out.get("subquestions") or [])
must = (out.get("must_cover") or [])
if len(queries) == 0:
queries = [
f"{question} benchmarks",
"vLLM edge inference benchmarks",
"llama.cpp edge inference benchmarks",
"vLLM vs llama.cpp quantization",
"llama.cpp Metal CUDA Vulkan performance",
"vLLM KV cache paged attention memory",
][:n_queries]
out["queries"] = queries[:n_queries]
out["subquestions"] = subqs[: min(6, n_queries)]
out["must_cover"] = must[:6]
return out
def answer_with_citations(
question: str,
evidence: List[Dict[str, str]],
*,
reasoning_effort: str,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream: bool,
diffusing: bool,
stream_callback=None,
) -> str:
system = (
"You are a fast research synthesizer.\n"
"Use ONLY the provided evidence.\n"
"Add inline citations like [S1], [S2] using evidence ids.\n"
"If evidence is insufficient, say what's missing."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
"Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.3,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream,
diffusing=diffusing,
stream_callback=stream_callback,
)
def verify_answer(
question: str,
evidence: List[Dict[str, str]],
draft: str,
*,
reasoning_effort: str,
) -> str:
system = (
"You are a verifier.\n"
"Remove/soften any claim not supported by evidence.\n"
"Keep citations [S#]. Return revised answer."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
f"Draft:\n{draft}"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.2,
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
stream=False,
diffusing=False,
)
async def run_agent(
question: str,
n_queries: int,
max_results_per_query: int,
do_verify: bool,
*,
reasoning_effort: str,
stream_answer: bool,
diffusing: bool,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream_callback=None,
) -> Dict[str, Any]:
t0 = time.perf_counter()
plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
t1 = time.perf_counter()
queries = plan.get("queries", [])
async with aiohttp.ClientSession() as session:
tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
lists = await asyncio.gather(*tasks)
flat = dedupe_results([r for lst in lists for r in lst])
evidence = pack_evidence(flat, max_items=18)
t2 = time.perf_counter()
draft = answer_with_citations(
question,
evidence,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream_answer,
diffusing=diffusing,
stream_callback=stream_callback,
)
t3 = time.perf_counter()
final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
t4 = time.perf_counter()
return {
"plan": plan,
"evidence": evidence,
"answer": final,
"timings_sec": {
"expand": round(t1 - t0, 3),
"search_parallel": round(t2 - t1, 3),
"synthesize": round(t3 - t2, 3),
"verify": round(t4 - t3, 3),
"total": round(t4 - t0, 3),
},
}Langkah ini menyambungkan empat tahap inti:
- Perencanaan kueri terstruktur: Fungsi
expand_query()menghasilkan rencana riset terstruktur dengan meminta Mercury 2 mengembalikan JSON ketat yang berisiqueries,subquestions, danmust_cover. Keluaran diurai menggunakanmercury_json(), yang mencakup perbaikan JSON otomatis, serta set kueri cadangan yang memastikan agen tetap berjalan bahkan jika model mengembalikan rencana kosong. - Sintesis berbasis bukti dengan sitasi: Fungsi
answer_with_citations()menghasilkan respons awal hanya menggunakan bukti yang dikemas dari tahap penelusuran. Prompt secara eksplisit membatasi model pada bukti yang disediakan dan mensyaratkan sitasi inline. Keluaran mencakup jawaban langsung, wawasan kunci, dan catatan kehati-hatian, memastikan respons tetap ringkas dan dapat ditelusuri ke sumber. - Verifikasi opsional untuk penguatan landasan: Fungsi
verify_answer()menerapkan pola Generate–Critique–Fix. Ia mengevaluasi ulang draf jawaban terhadap bukti yang sama dan menghapus atau melunakkan klaim yang tidak didukung sambil mempertahankan penanda sitasi. Langkah tambahan ini mengurangi generalisasi berlebihan dan meningkatkan landasan faktual dengan overhead latensi minimal. - Orkestrasi dengan pelacakan kinerja: Fungsi
run_agent()mengoordinasikan seluruh alur kerja, termasuk memperluas rencana kueri, menjalankan penelusuran DuckDuckGo paralel menggunakanaiohttpdanasyncio.gather(), menghapus duplikasi dan mengemas hasil ke JSON bukti ringkas, menghasilkan jawaban tersintesis, dan opsional menjalankan verifikasi.
Langkah 7: UI Streamlit
Terakhir, kita akan menyambungkan runtime agen (run_agent) ke antarmuka Streamlit sehingga pengguna dapat memasukkan pertanyaan, menyetel cara agen menelusuri, dan memeriksa jejak eksekusi lengkap—jawaban akhir, waktu, rencana kueri yang dihasilkan, dan bundel bukti.
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
"Ask a complex question",
height=120,
placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
max_results = st.slider("Results per query", 1, 6, 2)
with col3:
do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
stream_answer = st.checkbox("Stream answer", value=False)
diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
if diffusing and not stream_answer:
st.info("Diffusing requires streaming. Enabling streaming automatically.")
stream_answer = True
run = st.button("Run agent", type="primary")
if run:
if not question.strip():
st.warning("Enter a question.")
st.stop()
answer_placeholder = st.empty()
status_placeholder = st.empty()
def _stream_cb(text: str, meta: Dict[str, Any]):
answer_placeholder.markdown(text)
with st.spinner("Running…"):
status_placeholder.caption("Planning → searching → synthesizing…")
out = asyncio.run(
run_agent(
question.strip(),
n_queries,
max_results,
do_verify,
reasoning_effort=reasoning_effort,
stream_answer=stream_answer,
diffusing=diffusing,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream_callback=_stream_cb if stream_answer else None,
)
)
status_placeholder.empty()
st.subheader("Answer")
st.write(out["answer"])
st.subheader("Timings (sec)")
st.json(out["timings_sec"])
with st.expander("Plan (queries / subquestions)"):
st.json(out["plan"])
with st.expander("Evidence (search results)"):
st.json(out["evidence"])Kode di atas mendefinisikan bagaimana lapisan Streamlit mengubah fungsi run_agent() menjadi alur kerja riset interaktif. Pengguna memasukkan pertanyaan, mengendalikan keluasan dan kedalaman penelusuran, dan opsional mengaktifkan langkah verifikasi yang menghapus klaim tidak didukung.
Panel “Mercury settings” tambahan menampilkan pengatur model seperti reasoning_effort, output streaming, dan mode diffusing, yang memerlukan streaming dan memperbarui placeholder jawaban di tempat saat potongan baru tiba.
Saat dijalankan, aplikasi memvalidasi input, melakukan streaming output parsial ke placeholder, lalu merender jawaban akhir bersama waktu eksekusi dan tampilan debug yang dapat dibuka-tutup untuk rencana yang dihasilkan dan bundel bukti.
Untuk mencobanya sendiri, simpan kode sebagai app.py dan jalankan:
streamlit run app.pyKesimpulan
Dalam tutorial ini, kita membangun agen riset yang sadar latensi dengan Mercury 2. Sistem menghasilkan rencana penelusuran terstruktur untuk kueri pengguna, lalu menjalankan pengambilan web paralel, menormalisasi hasil menjadi format bukti ringkas, dan menghasilkan jawaban berbasis sumber dengan sitasi.
Kita juga menambahkan langkah verifikasi opsional yang memeriksa ulang draf terhadap bukti yang sama dan melunakkan klaim yang tidak didukung. Pola Generate–Critique–Fix sederhana ini secara signifikan meningkatkan landasan faktual dengan tambahan latensi minimal.
Di luar pipeline inti, aplikasi menampilkan kontrol runtime Mercury 2, termasuk upaya penalaran, output streaming, ringkasan penalaran, dan mode diffusing. Untuk mengembangkan proyek ini lebih jauh, Anda dapat:
- Mengganti scraper DuckDuckGo dengan API penelusuran produksi (Bing, SerpAPI, Brave)
- Menyimpan cache hasil penelusuran atau rencana antara untuk mengurangi latensi berulang
- Menyimpan bukti untuk memori sesi atau riset multi-giliran
- Menambahkan lapisan peringkasan untuk seleksi bukti berkualitas lebih tinggi
Untuk terus belajar tentang penggunaan AI untuk tugas pengembangan, saya merekomendasikan kursus AI-Assisted Coding for Developers.
FAQ Mercury 2
Apa yang membuat Mercury 2 berbeda dari LLM tradisional?
Mercury 2 menggunakan proses penyempurnaan paralel bergaya difusi, menghasilkan draf dan memperbaikinya dalam beberapa langkah. Ini memungkinkan throughput lebih tinggi dan kinerja lebih baik dalam pipeline multi-panggilan di mana latensi menumpuk.
Apa itu mode diffusing Mercury 2?
Mode diffusing melakukan streaming draf antara saat model menyempurnakan keluarannya. Alih-alih mengetik token demi token, teks ditulis ulang dan ditingkatkan secara progresif di tempat.
Mengapa menyertakan langkah verifikasi?
Langkah verifikasi mengevaluasi ulang draf terhadap bukti yang sama dan menghapus klaim yang tidak didukung. Ini meningkatkan landasan dengan hanya satu panggilan model tambahan.
Apakah implementasi penelusuran DuckDuckGo siap produksi?
Tidak. Pendekatan scraping HTML digunakan demi kesederhanaan dan tidak memerlukan kunci API, tetapi dapat rusak jika tata letak halaman berubah dan dapat dibatasi lajunya. Untuk penggunaan produksi, gantilah dengan API penelusuran yang stabil seperti Bing Web Search, Brave Search, atau SerpAPI.
Berapa biaya Mercury 2?
Mercury 2 dirancang untuk beban kerja berfrekuensi tinggi dengan biaya token input rendah dan token cache yang didiskon. Pengguna baru saat ini menerima token gratis saat mendaftar, yang cukup untuk menjalankan tutorial ini dan bereksperimen dengan agen.

Saya adalah Google Developers Expert di ML (Gen AI), Kaggle 3x Expert, dan Women Techmakers Ambassador dengan pengalaman lebih dari 3 tahun di bidang teknologi. Saya ikut mendirikan startup health-tech pada 2020 dan sedang menempuh studi magister ilmu komputer di Georgia Tech dengan spesialisasi machine learning.




Mercury 2 dirancang untuk beban kerja penalaran produksi yang melibatkan alur kerja agen seperti penelusuran, perencanaan, dan pipeline pengambilan, di mana model autoregresif tradisional menjadi lambat karena decoding berurutan. Dalam tutorial ini, kita akan menggunakan Mercury 2 untuk membangun agen riset multi-langkah real-time dengan Streamlit.
Di aplikasi, pengguna mengajukan pertanyaan kompleks, lalu sistem mengembangkannya menjadi beberapa kueri penelusuran yang terfokus, mengambil hasil web secara paralel, mengompresnya menjadi bukti terstruktur, dan menghasilkan jawaban berbasis sumber dengan sitasi inline.
Langkah verifikasi opsional meninjau draf terhadap bukti dan menghapus klaim yang tidak didukung. Antarmuka juga menampilkan kontrol runtime Mercury, termasuk upaya penalaran, output streaming, dan streaming bergaya difusi yang menunjukkan respons disempurnakan secara real time.
Sepanjang proses, Anda akan mempelajari cara:
reasoning_effortdan pengatur penalaran lainnyastreamingdandiffusinguntuk memvisualisasikan penyempurnaan iteratif secara real timeAplikasi akhir mengembalikan rencana penelusuran, sumber bukti, dan latensi per langkah, menjadikan sistem cepat sekaligus mudah diperiksa.