

Wat is Mercury 2?
Mercury 2 is Inception Lab’s snelle redeneringsmodel, ontworpen voor productie-workloads waar latentie zich opstapelt in agentloops, retrievalpijplijnen en toepassingen met hoge gelijktijdigheid.
In tegenstelling tot standaard autoregressieve LLM’s die één token per keer decoderen, gebruikt Mercury 2 een diffusie-achtige generatie die tekst parallel verfijnt. Dat is de kernreden waarom het, met de juiste serving-setup, een extreem hoge throughput kan halen.
Belangrijke mogelijkheden van Mercury 2 zijn onder meer:
OpenAI-compatibele integratie
Mercury 2 biedt een OpenAI-compatibele API, waardoor je bestaande OpenAI-clientbibliotheken kunt gebruiken door simpelweg de basis-URL en modelnaam te wijzigen. Zo kun je het zonder SDK- of architectuurwijzigingen in bestaande applicaties, agentframeworks en productiepijplijnen plaatsen.
Ondersteuning voor lange context
Het model ondersteunt een contextvenster van ongeveer 128K tokens, geschikt voor workflows die grote bewijspakketten, meerstaps tool-uitvoer, conversatiesporen of gestructureerde tussentijdse status moeten doorgeven.
Gestructureerde output en agent-gereed
Mercury 2 gaat betrouwbaar om met schema-beperkte JSON en ondersteunt tool-achtige interacties. Dit maakt use-cases mogelijk zoals queryplanning, argumentgeneratie voor tools, gestructureerde staatsoverdracht tussen stappen en verificatiepijplijnen waar deterministische opmaak telt.
Runtime-controles voor redeneren
In tegenstelling tot de meeste generieke modellen stelt Mercury 2 operationele regelaars bloot zoals reasoning_effort (instant tot hoog), optionele redeneringssamenvattingen, streamingoutput en diffusie-achtige streaming. Met deze knoppen kun je per call de afweging tussen snelheid, diepgang en interactiviteit afstemmen, afhankelijk van de fase in de pijplijn.
Productiegericht kostenmodel
De prijsstructuur is geoptimaliseerd voor workloads met hoge frequentie, met lage input-tokenkosten en aanzienlijk gereduceerde kosten voor gecachte inputtokens. Dit is gunstig voor agentloops en meerstaps pijplijnen waar systeemprompts en context over meerdere modelcalls worden hergebruikt.
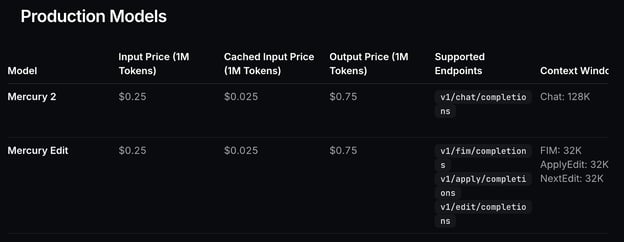
Figuur: Modelprijzen
Hoe werkt Mercury 2?
Traditionele LLM’s genereren tekst autoregressief, waarbij ze één token per keer in volgorde produceren.
token 1 - token 2 - token 3… Dit koppelt latentie sterk aan de outputlengte, omdat elk token van het vorige afhangt, waardoor de latentie lineair groeit met de lengte. Dat wordt een bottleneck in agentsystemen waar je per gebruikersverzoek meerdere modelcalls doet.
Mercury 2 kiest een andere aanpak. In plaats van sequentiële decodering gebruikt het een door diffusie geïnspireerd, parallel verfijningsproces. Het model genereert een initiële concepttekst en verfijnt vervolgens meerdere tokens tegelijk over een klein aantal stappen.
Generatie gedraagt zich meer als iteratief redigeren dan als stap-voor-stap typen, wat de throughput verbetert en de end-to-end latentie in meerstaps pijplijnen verlaagt.
Dit verfijningsproces maakt ook de diffusing-modus mogelijk, waarbij tussentijdse concepten worden gestreamd en in de UI geleidelijk worden verbeterd. Gebruikers kunnen in realtime zien hoe de tekst naar zijn definitieve vorm evolueert, wat vooral nuttig is voor demo’s, interactieve toepassingen en live onderzoeksinterfaces.
Door deze architectuur is Mercury 2 het best geschikt voor systemen waar latentie zich opstapelt over meerdere redeneerstappen in plaats van single-shot prompts.
Mercury 2-tutorial: bouw een realtime, meerstaps onderzoeksagent
In deze sectie bouwen we een realtime onderzoeksassistent met Mercury 2 die een complexe vraag kan verwerken, het web doorzoekt, over meerdere bronnen redeneert en binnen enkele seconden een gefundeerd antwoord geeft. In plaats van één enkele prompt-responsinteractie draait het systeem een snelle meerstaps agentloop, waarbij elke stap de informatie verfijnt die nodig is voor een betrouwbaar resultaat.
Op hoofdlijnen voert de applicatie vijf kerntaken uit:
- Query-uitbreiding: We genereren meerdere gerichte zoekopdrachten (in gestructureerde JSON) om verschillende aspecten van de vraag te dekken.
- Parallelle webzoektocht: Vervolgens voeren we alle queries gelijktijdig uit om de latentie te minimaliseren en snel diverse bronnen te verzamelen.
- Bewijsnormalisatie: We schonen zoekresultaten op en comprimeren ze tot een compact evidence-JSON waar het model over kan redeneren.
- Gefundeerde synthese: We produceren ook een gestructureerd antwoord dat uitsluitend de aangeleverde bewijzen gebruikt, met inline citaties zoals
[S1],[S2]. - Optionele verificatiepass: Gebruiker kan ook een tweede modelcall draaien die het conceptantwoord beoordeelt en claims die niet door het bewijs worden ondersteund, verwijdert of nuanceert. De verificatiefase past een lichte Generate-Critique-Fix-patroon toe, waarbij het model zijn eigen concept toetst aan het bewijs en het herziet voor sterkere feitelijke onderbouwing.
De applicatie levert twee hoofdoutputs op:
- Bron-gefundeerde inzichten met inline citaties gekoppeld aan webbewijs.
- Uitvoeringstransparantie, inclusief het gegenereerde zoekplan, de opgehaalde bronnen en stap-voor-stap latentie.
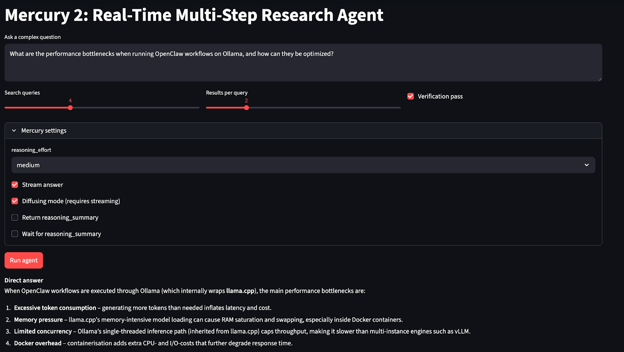
Stap 1: Krijg API-toegang
Voordat we de onderzoeksagent bouwen, hebben we eerst toegang nodig tot de Mercury 2 API. Omdat Mercury 2 momenteel via early access beschikbaar is, zorgt deze stap ervoor dat je de inloggegevens en endpointconfiguratie hebt die nodig zijn om vanuit je applicatie inferentie-calls te doen.
Je kunt hier toegang aanvragen: https://www.inceptionlabs.ai/early-access.
Zodra je account is goedgekeurd:
- Log in op het Inception Platform
- Ga naar API Keys
- Klik op Create API Key
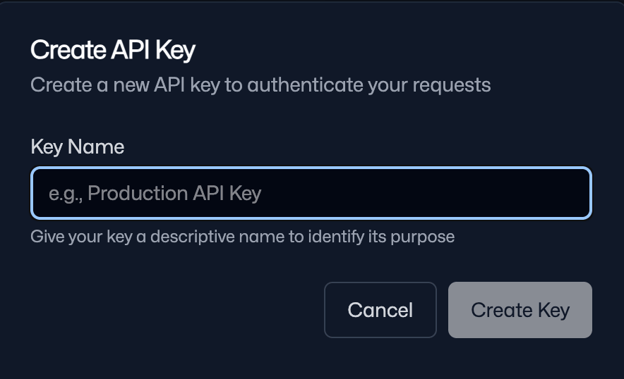
- Geef een naam op en kopieer de gegenereerde sleutel
Bewaar deze sleutel veilig, want je gebruikt ‘m om alle API-verzoeken te authenticeren.
Let op: Je krijgt 10.000.000 gratis tokens bij de eerste aanmelding, voldoende om dit experiment uit te voeren.
Stap 2: Omgevingssetup
Nu je API-toegang hebt, is de volgende stap het voorbereiden van de lokale omgeving om de Mercury 2-onderzoeksagent te bouwen en draaien. Omdat de Inception API OpenAI-compatibel is, kunnen we de standaard OpenAI Python-client gebruiken, samen met een set libraries voor de webinterface en zoekpijplijn. We slaan onze API-sleutel ook op als omgevingsvariabele.
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”We installeren de kern-afhankelijkheden die nodig zijn om de Mercury 2-onderzoeksagent te draaien en configureren veilige API-toegang. We gebruiken de standaard OpenAI-client voor modelcalls, Streamlit om de interactieve interface te bouwen, aiohttp voor parallelle webzoekopdrachten met lage latentie, en beautifulsoup4 met lxml om zoekresultaten te parsen.
Na het installeren van de pakketten stel je je INCEPTION_API_KEY in als omgevingsvariabele om credentials veilig te houden en de applicatie tijdens runtime automatisch te laten authenticeren.
In de volgende stap implementeren we de Mercury-client en bouwen we de kern van de meerstaps agentpijplijn.
Stap 3: Mercury-client
Deze stap verbindt drie zaken: het importeren van de libraries die we in de app gebruiken, het veilig laden van de API-sleutel uit de omgeving en het initialiseren van een OpenAI-client die naar Inception’s basis-URL wijst.
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)De bovenstaande code initialiseert een Mercury 2-client en importeert de ondersteunende stack voor de applicatie, waaronder Streamlit voor de UI, aiohttp voor asynchrone webverzoeken, BeautifulSoup voor het parsen van zoekresultaten en standaard Python-hulpprogramma’s voor JSON-afhandeling, timing en datastructuren.
We lezen vervolgens de INCEPTION_API_KEY uit de omgevingsvariabele, de Inception-basis-URL wordt geconfigureerd om verzoeken correct te routeren en de modelnaam is ingesteld op "mercury-2" zodat alle volgende calls het bedoelde redeneringsmodel gebruiken.
Tot slot wordt de OpenAI-client geïnitialiseerd met de aangepaste basis-URL, zodat Mercury 2 kan worden aangeroepen via de standaard chat.completions-interface.
Stap 4: Webzoektool
Vervolgens hebben we een retrievalstap nodig die actuele informatie van het web kan ophalen. In deze tutorial implementeren we een zoektool met DuckDuckGo’s HTML-endpoint en parsen we de resultaten direct, omdat er geen extra API-sleutels voor nodig zijn en het snel genoeg is voor prototyping.
Op hoofdlijnen implementeren we drie dingen:
- Voer een zoekopdracht uit tegen de HTML-resultatenpagina van DuckDuckGo
- Parse de toppresultaten naar een gestructureerd
SearchResult-formaat - Dedupliceer en pak resultaten in een compact JSON dat Mercury later kan citeren
DDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceDe bovenstaande utilities definiëren vier kernonderdelen:
- Asynchrone webophaling: De functie
ddg_search()doet een verzoek naar DuckDuckGo’s HTML-endpoint metaiohttpen parse’t de respons met BeautifulSoup en lxml. Elk resultaat wordt in een gestructureerd formaat gezet, en de functie stopt namax_resultsitems om de latentie laag te houden. Zo kunnen meerdere zoekopdrachten parallel asynchroon worden uitgevoerd. - Tekstnormalisatie: De helper
clean_text()verwijdert extra witruimte en opmaakartefacten, zodat snippets compact en leesbaar blijven. Resultaten worden opgeslagen met deSearchResultdataclass, die de output standaardiseert en latere stappen onafhankelijk van de ruwe HTML-structuur houdt. - Deduplicatie over queries heen: Wanneer de agent meerdere zoekopdrachten uitvoert, verschijnen dezelfde pagina’s vaak herhaaldelijk. De functie
dedupe_results()verwijdert duplicaten door URL’s te normaliseren, zodat de evidence-set divers blijft en efficiënt binnen het contextvenster past. - Bewijspacking voor modelredenering: De functie
pack_evidence()zet resultaten om in een compact JSON met stabiele identifiers. Snippets worden ingekort tot ~320 tekens zodat het gecombineerde bewijs binnen de context van het model past en later met inline citaties kan worden aangehaald.
Opmerking voor lezers:
Deze DuckDuckGo HTML-aanpak is prototype-vriendelijk omdat er geen extra API-sleutels voor nodig zijn, maar het is geen productierijpe zoekoplossing:
- HTML-layouts kunnen veranderen en selectors breken
- Rate limiting / botbescherming kan scraping blokkeren
- Kwaliteit en ranking van resultaten kan variëren
Als je een productierijpe versie wilt, vervang dit dan door een stabiele Search API (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search, enz.) en laat de rest van de agent ongewijzigd.
Vervolgens koppelen we deze retrievallaag aan Mercury 2 zodat het model zoekopdrachten kan genereren, over het verzamelde bewijs kan redeneren en een bron-gefundeerd antwoord kan produceren.
Stap 5: Mercury-calls
In deze stap kapselen we Mercury 2 in achter een kleine, herbruikbare interface die zowel strikte gestructureerde output (voor planning) als gestreamde tekstgeneratie ondersteunt (voor synthese en de diffusing-demo).
Het doel is om elke modelcall consistent te houden, terwijl Mercury’s “redeneringsknoppen” en streamingmodi via één instellingenobject beschikbaar blijven.
def mercury_settings(
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
diffusing: bool = False,
) -> Dict[str, Any]:
return {
"reasoning_effort": reasoning_effort,
"reasoning_summary": reasoning_summary,
"reasoning_summary_wait": reasoning_summary_wait,
"diffusing": diffusing,
}
def mercury_json(
system: str,
user: str,
max_tokens: int = 400,
reasoning_effort: str = "medium",
) -> Dict[str, Any]:
def _call(messages) -> str:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=0.0,
stream=False,
extra_settings=mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
diffusing=False,
),
)
return (resp.choices[0].message.content or "").strip()
text = _call(
[{"role": "system", "content": system}, {"role": "user", "content": user}]
)
try:
return json.loads(text)
except json.JSONDecodeError:
pass
m = re.search(r"\{.*\}", text, flags=re.DOTALL)
if m:
try:
return json.loads(m.group(0))
except json.JSONDecodeError:
pass
repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
repair_user = (
"Fix the following so it is valid JSON and matches the required schema.\n\n"
"REQUIRED SCHEMA:\n"
"{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
"BROKEN OUTPUT:\n"
f"{text}"
)
fixed = _call(
[{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
)
try:
return json.loads(fixed)
except json.JSONDecodeError:
m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
if not m2:
raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
return json.loads(m2.group(0))
def mercury_text(
system: str,
user: str,
max_tokens: int = 950,
temperature: float = 0.3,
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
stream: bool = False,
diffusing: bool = False,
stream_callback=None,
) -> str:
if diffusing:
stream = True
extra_settings = mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
diffusing=diffusing,
)
messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
if not stream:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=False,
extra_settings=extra_settings,
)
return (resp.choices[0].message.content or "").strip()
full = ""
stream_resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=True,
extra_settings=extra_settings,
)
for event in stream_resp:
choices = getattr(event, "choices", None) or []
if not choices:
continue
delta = getattr(choices[0], "delta", None)
chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
if not chunk:
continue
if diffusing:
full = chunk
else:
full += chunk
if stream_callback:
stream_callback(full, {"delta": chunk})
return full.strip()In deze stap definiëren we helperfuncties met drie kernelementen:
- Instellingen voor redeneringsknoppen: De functie
mercury_settings()centraliseert Mercury-specifieke parameters zoalsreasoning_effort,reasoning_summary,reasoning_summary_waitendiffusing. Dit houdt de pijplijn consistent en maakt het eenvoudig om Streamlit-toggles rechtstreeks aan elke modelcall te koppelen zonder configuratie te dupliceren. - Schema-uitgelijnde JSON-generatie:
mercury_json()wordt gebruikt wanneer de agent gestructureerde output nodig heeft. Het draait mettemperature=0.0en schakelt streaming/diffusie uit om de formaatstabiliteit te maximaliseren. De functie probeert JSON direct te parsen, probeert dan via regex een JSON-blok te extraheren en valt ten slotte terug op een reparatiepass die het model dwingt geldige JSON te retourneren die aan ons vereiste schema voldoet. - Tekstgeneratie met optionele streaming en diffusie: De functie
mercury_text()ondersteunt zowel niet-streaming als streaming modi. Alsdiffusing=True, wordtstream=Trueautomatisch afgedwongen en wordt de weergegeven tekst bijgewerkt door de huidige buffer te overschrijven. In de normale streamingmodus worden deltas toegevoegd om het definitieve antwoord op te bouwen. De optionele hookstream_callback()laat de UI live updates renderen.
In de volgende stap gebruiken we deze helpers om gestructureerde query-uitbreiding te implementeren en ze te koppelen aan de webzoek- en bewijspijplijn.
Stap 6: Gestructureerde query-uitbreiding
Nu koppelen we Mercury 2 en webzoekopdrachten in een end-to-end onderzoekslus. Het kernidee is om eerst een gestructureerd zoekplan te genereren en vervolgens het definitieve antwoord te dwingen te steunen op de bewijslast, om Mercury’s redeneringscontroles en streaming/diffusing-modi in de UI te demonstreren.
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
system = (
"Return ONLY valid JSON. No markdown.\n"
"Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
"Rules:\n"
f"- MUST produce at least {max(3, n_queries-2)} queries\n"
"- queries <= 12 words, diverse\n"
"- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
"Output must start with '{' and end with '}'."
)
user = f"Question: {question}\nReturn {n_queries} queries."
out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
queries = (out.get("queries") or [])
subqs = (out.get("subquestions") or [])
must = (out.get("must_cover") or [])
if len(queries) == 0:
queries = [
f"{question} benchmarks",
"vLLM edge inference benchmarks",
"llama.cpp edge inference benchmarks",
"vLLM vs llama.cpp quantization",
"llama.cpp Metal CUDA Vulkan performance",
"vLLM KV cache paged attention memory",
][:n_queries]
out["queries"] = queries[:n_queries]
out["subquestions"] = subqs[: min(6, n_queries)]
out["must_cover"] = must[:6]
return out
def answer_with_citations(
question: str,
evidence: List[Dict[str, str]],
*,
reasoning_effort: str,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream: bool,
diffusing: bool,
stream_callback=None,
) -> str:
system = (
"You are a fast research synthesizer.\n"
"Use ONLY the provided evidence.\n"
"Add inline citations like [S1], [S2] using evidence ids.\n"
"If evidence is insufficient, say what's missing."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
"Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.3,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream,
diffusing=diffusing,
stream_callback=stream_callback,
)
def verify_answer(
question: str,
evidence: List[Dict[str, str]],
draft: str,
*,
reasoning_effort: str,
) -> str:
system = (
"You are a verifier.\n"
"Remove/soften any claim not supported by evidence.\n"
"Keep citations [S#]. Return revised answer."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
f"Draft:\n{draft}"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.2,
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
stream=False,
diffusing=False,
)
async def run_agent(
question: str,
n_queries: int,
max_results_per_query: int,
do_verify: bool,
*,
reasoning_effort: str,
stream_answer: bool,
diffusing: bool,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream_callback=None,
) -> Dict[str, Any]:
t0 = time.perf_counter()
plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
t1 = time.perf_counter()
queries = plan.get("queries", [])
async with aiohttp.ClientSession() as session:
tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
lists = await asyncio.gather(*tasks)
flat = dedupe_results([r for lst in lists for r in lst])
evidence = pack_evidence(flat, max_items=18)
t2 = time.perf_counter()
draft = answer_with_citations(
question,
evidence,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream_answer,
diffusing=diffusing,
stream_callback=stream_callback,
)
t3 = time.perf_counter()
final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
t4 = time.perf_counter()
return {
"plan": plan,
"evidence": evidence,
"answer": final,
"timings_sec": {
"expand": round(t1 - t0, 3),
"search_parallel": round(t2 - t1, 3),
"synthesize": round(t3 - t2, 3),
"verify": round(t4 - t3, 3),
"total": round(t4 - t0, 3),
},
}Deze stap koppelt vier kernfases aan elkaar:
- Gestructureerde queryplanning: De functie
expand_query()genereert een gestructureerd onderzoeksplan door Mercury 2 te vragen strikte JSON te retourneren metqueries,subquestionsenmust_cover. De output wordt geparsed metmercury_json(), inclusief automatische JSON-reparatie, en een fallback-set queries die ervoor zorgt dat de agent doorgaat, zelfs als het model een leeg plan terugstuurt. - Bewijs-gefundeerde synthese met citaties: De functie
answer_with_citations()produceert de initiële respons met uitsluitend het gepakte bewijs uit de zoekfase. De prompt beperkt het model expliciet tot het aangeleverde bewijs en vereist inline citaties. De output bevat een direct antwoord, kerninzichten en kanttekeningen, zodat de respons beknopt blijft en herleidbaar is naar bronnen. - Optionele verificatie voor onderbouwing: De functie
verify_answer()implementeert het Generate-Critique-Fix-patroon. Ze evalueert het conceptantwoord opnieuw aan de hand van hetzelfde bewijs en verwijdert of nuanceert niet-onderbouwde claims, terwijl citatiemarkers behouden blijven. Deze extra pass vermindert overgeneralisatie en verbetert de feitelijke onderbouwing met minimale latentie-overhead. - Orchestratie met prestatie-tracking: De functie
run_agent()coördineert de volledige workflow, inclusief het uitbreiden van het queryplan, het uitvoeren van parallelle DuckDuckGo-zoekopdrachten metaiohttpenasyncio.gather(), het dedupliceren en inpakken van resultaten in compact evidence-JSON, het genereren van het gesynthetiseerde antwoord en optioneel het uitvoeren van verificatie.
Stap 7: Streamlit-UI
Tot slot koppelen we de agenruntime (run_agent) aan een Streamlit-interface, zodat gebruikers een vraag kunnen invoeren, kunnen bepalen hoe de agent zoekt en het volledige uitvoeringsspoor kunnen inspecteren—eindantwoord, timings, het gegenereerde zoekplan en het bewijspakket.
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
"Ask a complex question",
height=120,
placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
max_results = st.slider("Results per query", 1, 6, 2)
with col3:
do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
stream_answer = st.checkbox("Stream answer", value=False)
diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
if diffusing and not stream_answer:
st.info("Diffusing requires streaming. Enabling streaming automatically.")
stream_answer = True
run = st.button("Run agent", type="primary")
if run:
if not question.strip():
st.warning("Enter a question.")
st.stop()
answer_placeholder = st.empty()
status_placeholder = st.empty()
def _stream_cb(text: str, meta: Dict[str, Any]):
answer_placeholder.markdown(text)
with st.spinner("Running…"):
status_placeholder.caption("Planning → searching → synthesizing…")
out = asyncio.run(
run_agent(
question.strip(),
n_queries,
max_results,
do_verify,
reasoning_effort=reasoning_effort,
stream_answer=stream_answer,
diffusing=diffusing,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream_callback=_stream_cb if stream_answer else None,
)
)
status_placeholder.empty()
st.subheader("Answer")
st.write(out["answer"])
st.subheader("Timings (sec)")
st.json(out["timings_sec"])
with st.expander("Plan (queries / subquestions)"):
st.json(out["plan"])
with st.expander("Evidence (search results)"):
st.json(out["evidence"])De bovenstaande code definieert hoe de Streamlit-laag de functie run_agent() omzet in een interactieve onderzoekswerkflow. De gebruiker voert een vraag in, stuurt de breedte en diepte van de zoekopdracht aan en kan optioneel een verificatiepass inschakelen die niet-onderbouwde claims verwijdert.
Een extra paneel “Mercury settings” toont modelknoppen zoals reasoning_effort, streaming output en diffusing-modus, die streaming vereist en de antwoord-placeholder ter plekke bijwerkt zodra er nieuwe chunks binnenkomen.
Bij uitvoeren valideert de app de invoer, streamt gedeeltelijke output naar een placeholder en rendert vervolgens het definitieve antwoord samen met timings en uitklapbare debugweergaven voor het gegenereerde plan en het bewijspakket.
Wil je het zelf proberen? Sla de code op als app.py en start:
streamlit run app.pyConclusie
In deze tutorial bouwden we een latentie-bewuste onderzoeksagent aangedreven door Mercury 2. Het systeem genereert een gestructureerd zoekplan voor een gebruikersvraag, voert vervolgens parallelle webretries uit, normaliseert resultaten tot een compact bewijsformaat en produceert een gefundeerd antwoord met citaties.
We hebben ook een optionele verificatiepass toegevoegd die het concept opnieuw checkt aan de hand van hetzelfde bewijs en niet-onderbouwde claims nuanceert. Dit eenvoudige Generate–Critique–Fix-patroon verbetert de feitelijke onderbouwing aanzienlijk met minimale extra latentie.
Naast de kernpijplijn stelt de applicatie Mercury 2’s runtime-instellingen bloot, waaronder redeneringsinspanning, streamingoutput, redeneringssamenvattingen en diffusing-modus. Om dit project verder uit te breiden, kun je:
- De DuckDuckGo-scraper vervangen door een productie-zoek-API (Bing, SerpAPI, Brave)
- Zoekresultaten of tussentijdse plannen cachen om herhaalde latentie te verminderen
- Bewijs bewaren voor sessiegeheugen of meerbeurtonderzoek
- Een samenvattingslaag toevoegen voor selectie van bewijs met hogere kwaliteit
Wil je meer leren over het gebruik van AI voor ontwikkelingstaken? Dan raad ik de cursus AI-Assisted Coding for Developers aan.
Mercury 2 FAQ’s
Wat maakt Mercury 2 anders dan traditionele LLM’s?
Mercury 2 gebruikt een diffusie-achtige, parallelle verfijningsmethode: het produceert een concept en verbetert dit in meerdere stappen. Dit maakt hogere throughput en betere prestaties mogelijk in pijplijnen met meerdere calls waar latentie zich opstapelt.
Wat is de diffusing-modus van Mercury 2?
De diffusing-modus streamt tussentijdse concepten terwijl het model zijn output verfijnt. In plaats van token-voor-token te typen, wordt de tekst ter plekke geleidelijk herschreven en verbeterd.
Waarom een verificatiepass opnemen?
De verificatiestap beoordeelt het concept opnieuw aan de hand van hetzelfde bewijs en verwijdert niet-onderbouwde claims. Dit verbetert de onderbouwing met slechts één extra modelcall.
Is de DuckDuckGo-zoekimplementatie productierijp?
Nee. De HTML-scrapingaanpak is gekozen vanwege de eenvoud en het ontbreken van API-sleutels, maar kan stukgaan als paginalayouts wijzigen en kan worden geratelimiteerd. Gebruik voor productie een stabiele zoek-API zoals Bing Web Search, Brave Search of SerpAPI.
Wat kost Mercury 2?
Mercury 2 is ontworpen voor workloads met hoge frequentie, met lage input-tokenkosten en korting op gecachte tokens. Nieuwe gebruikers ontvangen momenteel gratis tokens bij aanmelding, voldoende om deze tutorial te draaien en met de agent te experimenteren.

Ik ben een Google Developers Expert in ML (Gen AI), een Kaggle 3x Expert en een Women Techmakers Ambassador met meer dan 3 jaar ervaring in tech. In 2020 heb ik een healthtech-startup mee opgericht en ik volg een master computer science aan Georgia Tech, met als specialisatie machine learning.
Mercury 2 is ontworpen voor productie-workloads waarin geredeneerd moet worden, zoals agent-workflows met zoek-, plannings- en retrieval-pijplijnen, waar traditionele autoregressieve modellen traag worden door sequentiële decodering. In deze tutorial gebruiken we Mercury 2 om met Streamlit een realtime, meerstaps onderzoeksagent te bouwen.
In de app stelt een gebruiker een complexe vraag, waarna het systeem deze uitbreidt naar meerdere gerichte zoekopdrachten, webresultaten parallel ophaalt, ze comprimeert tot gestructureerd bewijs en een bron-gefundeerd antwoord met inline citaties genereert.
Een optionele verificatiestap beoordeelt de concepttekst aan de hand van het bewijs en verwijdert niet-onderbouwde beweringen. De interface stelt ook Mercury’s runtime-instellingen bloot, waaronder redeneringsinspanning, streamingoutput en diffusie-achtige streaming die laat zien hoe het antwoord in realtime wordt verfijnd.
Onderweg leer je hoe je:
reasoning_efforten andere redeneringsknoppenstreamingendiffusing-modus inschakelt om iteratieve verfijning in realtime te visualiserenDe uiteindelijke applicatie geeft een zoekplan, bewijssources en stap-voor-stap latentie terug, waardoor het systeem zowel snel als inspecteerbaar is.