

Mercury 2 क्या है?
Mercury 2 Inception Lab’s का तेज़ रीजनिंग मॉडल है, जिसे उन प्रोडक्शन वर्कलोड्स के लिए डिज़ाइन किया गया है जहाँ एजेंट लूप्स, रिट्रीवल पाइपलाइंस और हाई‑कन्करेंसी ऐप्लिकेशन्स में लेटेंसी जुड़ती चली जाती है।
मानक ऑटोरिग्रेसिव LLMs जो एक समय में एक‑एक टोकन डिकोड करते हैं, उनसे अलग, Mercury 2 समानांतर में टेक्स्ट को परिष्कृत करने वाली डिफ्यूज़न‑स्टाइल जेनरेशन प्रक्रिया का उपयोग करता है, जो सही सर्विंग सेटअप में अत्यधिक थ्रूपुट देने का मुख्य कारण है।
Mercury 2 की प्रमुख क्षमताएँ:
OpenAI‑कम्पैटिबल इंटीग्रेशन
Mercury 2 OpenAI‑कम्पैटिबल API प्रदान करता है, यानी आप केवल बेस URL और मॉडल नाम बदलकर मौजूदा OpenAI क्लाइंट लाइब्रेरियाँ उपयोग कर सकते हैं। इससे यह मौजूदा ऐप्लिकेशनों, एजेंट फ्रेमवर्क्स और प्रोडक्शन पाइपलाइंस में बिना SDK या आर्किटेक्चर बदलाव के फिट हो जाता है।
लॉन्ग‑कॉन्टेक्स्ट सपोर्ट
मॉडल लगभग 128K टोकन की कॉन्टेक्स्ट विंडो सपोर्ट करता है, जिससे यह बड़े साक्ष्य बंडलों, मल्टी‑स्टेप टूल आउटपुट, बातचीत के निशान, या संरचित इंटरमीडिएट स्टेट पास करने वाले वर्कफ़्लो के लिए उपयुक्त है।
संरचित आउटपुट और एजेंट‑रेडी
Mercury 2 स्कीमा‑कंस्ट्रेन्ड JSON को भरोसेमंद तरीके से संभालता है और टूल‑स्टाइल इंटरेक्शन्स सपोर्ट करता है। इससे क्वेरी प्लानिंग, टूल आर्ग्युमेंट जेनरेशन, चरणों के बीच संरचित स्टेट पास करना, और डिटरमिनिस्टिक फ़ॉर्मैटिंग वाले वेरिफिकेशन पाइपलाइंस जैसे उपयोग‑मामले सक्षम होते हैं।
रनटाइम रीजनिंग कंट्रोल्स
अधिकांश जनरल‑परपज़ मॉडलों के विपरीत, Mercury 2 ऑपरेशनल कंट्रोल्स उपलब्ध कराता है जैसे reasoning_effort (instant से high तक), वैकल्पिक रीजनिंग समरीज़, स्ट्रीमिंग आउटपुट, और डिफ्यूज़न‑स्टाइल स्ट्रीमिंग। ये सेटिंग्स आपको पाइपलाइन के चरण के अनुसार प्रति‑कॉल स्पीड, गहराई, और इंटरेक्टिविटी के बीच संतुलन ट्यून करने देती हैं।
प्रोडक्शन‑ओरिएंटेड कॉस्ट मॉडल
प्राइसिंग संरचना हाई‑फ़्रीक्वेंसी वर्कलोड्स के लिए ऑप्टिमाइज़ है, जिसमें इनपुट टोकन लागत कम है और कैश्ड इनपुट टोकनों पर महत्वपूर्ण छूट है। यह उन एजेंट लूप्स और मल्टी‑स्टेप पाइपलाइंस के लिए फायदेमंद है जहाँ सिस्टम प्रॉम्प्ट्स और कॉन्टेक्स्ट कई मॉडल कॉल्स में पुन: उपयोग होते हैं।
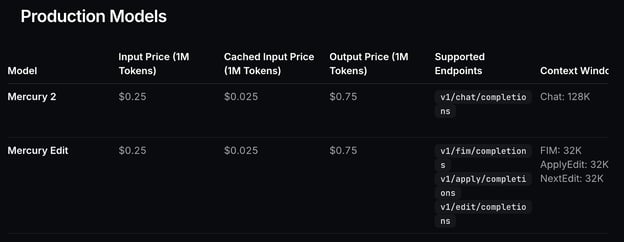
चित्र: Model pricing
Mercury 2 कैसे काम करता है?
पारंपरिक LLMs टेक्स्ट को ऑटोरिग्रेसिव ढंग से जेनरेट करते हैं, क्रम में एक समय में एक टोकन पैदा करके।
token 1 - token 2 - token 3… इससे लेटेंसी आउटपुट लंबाई से कड़ी तरह जुड़ जाती है क्योंकि हर टोकन पिछले पर निर्भर होता है, इसलिए आउटपुट लंबा होने पर लेटेंसी रैखिक रूप से बढ़ती है। यह एजेंट सिस्टम्स में बाधा बन जाती है जहाँ प्रति उपयोगकर्ता अनुरोध कई मॉडल कॉल्स चल सकती हैं।
Mercury 2 अलग तरीका अपनाता है। अनुक्रमिक डिकोडिंग के बजाय, यह डिफ्यूज़न‑प्रेरित समानांतर रिफाइनमेंट प्रक्रिया का उपयोग करता है। मॉडल एक प्रारंभिक ड्राफ्ट बनाता है और फिर कुछ चरणों में एक साथ कई टोकन परिष्कृत करता है।
जनरेशन का व्यवहार चरण‑दर‑चरण टाइपिंग की बजाय इटरेटिव एडिटिंग जैसा होता है, जो थ्रूपुट बढ़ाता है और मल्टी‑कॉल पाइपलाइंस में एंड‑टू‑एंड लेटेंसी घटाता है।
यह रिफाइनमेंट प्रक्रिया डिफ्यूज़िंग मोड भी सक्षम करती है, जिसमें इंटरमीडिएट ड्राफ्ट्स स्ट्रीम होते हैं और UI में क्रमशः सुधरते जाते हैं। उपयोगकर्ता रीयल‑टाइम में टेक्स्ट को उसके अंतिम रूप की ओर बढ़ते देखते हैं, जो डेमो, इंटरैक्टिव ऐप्लिकेशन्स और लाइव रिसर्च इंटरफ़ेस के लिए विशेष रूप से उपयोगी है।
यह आर्किटेक्चर Mercury 2 को उन सिस्टमों के लिए सबसे उपयुक्त बनाती है जहाँ लेटेंसी कई रीजनिंग चरणों में जुड़ती जाती है, न कि सिंगल‑शॉट प्रॉम्प्ट्स में।
Mercury 2 ट्यूटोरियल: रीयल‑टाइम मल्टी‑स्टेप रिसर्च एजेंट बनाएं
इस खंड में, हम Mercury 2 का उपयोग कर एक रीयल‑टाइम रिसर्च असिस्टेंट बनाएंगे जो एक जटिल प्रश्न ले सकता है, वेब पर खोज कर सकता है, कई स्रोतों पर रीजनिंग कर सकता है, और कुछ सेकंड में एक ग्राउंडेड उत्तर लौटा सकता है। सिंगल प्रॉम्प्ट‑रिस्पॉन्स इंटरेक्शन के बजाय, सिस्टम एक तेज़ मल्टी‑स्टेप एजेंट लूप चलाता है, जहाँ हर चरण विश्वसनीय परिणाम देने के लिए आवश्यक जानकारी को परिष्कृत करता है।
उच्च स्तर पर, एप्लिकेशन पाँच मुख्य कार्य करता है:
- क्वेरी विस्तार: हम प्रश्न के विभिन्न पहलुओं को कवर करने के लिए कई केंद्रित सर्च क्वेरियाँ (संरचित JSON में) जेनरेट करते हैं।
- समानांतर वेब सर्च: फिर, हम सभी क्वेरियों को एक साथ निष्पादित करते हैं ताकि लेटेंसी कम हो और विविध स्रोत जल्दी मिलें।
- साक्ष्य सामान्यीकरण: हम सर्च परिणामों को साफ़ करते हैं और उन्हें कॉम्पैक्ट एविडेंस JSON में संपीड़ित करते हैं जिस पर मॉडल रीजनिंग कर सके।
- ग्राउंडेड सिंथेसिस: हम केवल दिए गए साक्ष्य का उपयोग करके संरचित उत्तर तैयार करते हैं, जिसमें
[S1],[S2]जैसे इनलाइन सिटेशन्स होते हैं। - वैकल्पिक वेरिफिकेशन पास: उपयोगकर्ता दूसरा मॉडल कॉल भी चला सकता/सकती है जो ड्राफ्ट उत्तर की समीक्षा कर असमर्थित दावों को हटाता या नरम करता है। वेरिफिकेशन चरण हल्का Generate‑Critique‑Fix पैटर्न लागू करता है, जिसमें मॉडल अपने ही ड्राफ्ट को साक्ष्य के विरुद्ध समीक्षा कर बेहतर तथ्यात्मक आधार के लिए संशोधित करता है।
एप्लिकेशन दो मुख्य आउटपुट देता है:
- इनलाइन सिटेशन्स के साथ स्रोत‑आधारित इनसाइट्स, जो वेब साक्ष्य से जुड़े हों।
- एक्ज़ीक्यूशन ट्रांसपेरेंसी, जिसमें जेनरेट किया गया सर्च प्लान, रिट्रीव किए गए स्रोत, और चरणवार लेटेंसी शामिल है।
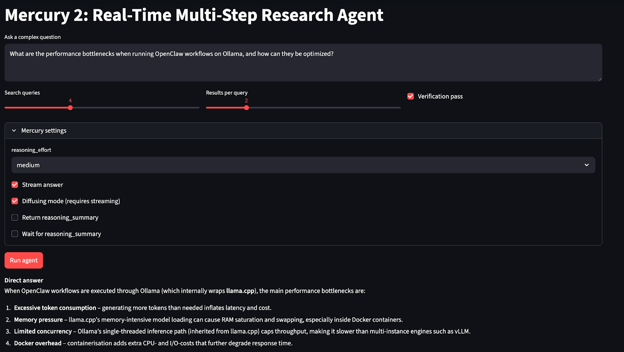
चरण 1: API एक्सेस प्राप्त करें
रिसर्च एजेंट बनाने से पहले, हमें Mercury 2 API तक पहुंच चाहिए। चूँकि Mercury 2 अभी अर्ली एक्सेस के माध्यम से उपलब्ध है, यह चरण सुनिश्चित करता है कि आपके पास अपने ऐप्लिकेशन से इन्फ़रेंस कॉल्स करने के लिए आवश्यक क्रेडेंशियल्स और एंडपॉइंट कॉन्फ़िगरेशन हों।
आप यहाँ एक्सेस का अनुरोध कर सकते हैं: https://www.inceptionlabs.ai/early-access.
एकाउंट अप्रूव होने के बाद:
- लॉग इन करें Inception Platform
- API Keys पर जाएँ
- क्लिक करें Create API Key
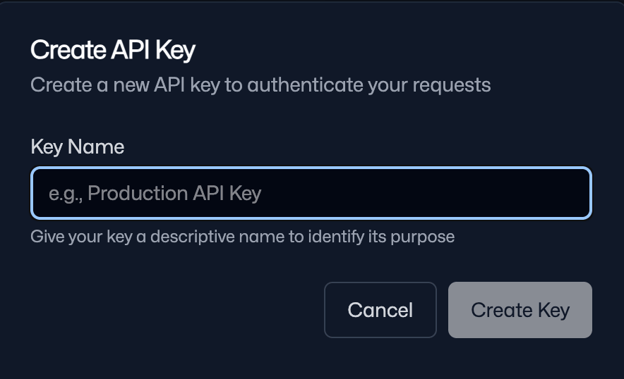
- एक नाम दें और जनरेट हुई कुंजी कॉपी करें
इस कुंजी को सुरक्षित रखें क्योंकि इसी से आप सभी API रिक्वेस्ट्स को ऑथेंटिकेट करेंगे।
नोट: प्रारंभिक साइन‑अप पर आपको 10,000,000 मुफ्त टोकन मिलते हैं, जो इस प्रयोग को चलाने के लिए पर्याप्त हैं।
चरण 2: एनवायरनमेंट सेटअप
अब जब आपके पास API एक्सेस है, अगला कदम Mercury 2 रिसर्च एजेंट बनाने और चलाने के लिए स्थानीय एनवायरनमेंट तैयार करना है। चूँकि Inception API OpenAI‑कम्पैटिबल है, हम मानक OpenAI Python क्लाइंट के साथ वेब इंटरफ़ेस और सर्च पाइपलाइन के लिए कुछ लाइब्रेरियाँ उपयोग कर सकते हैं। हम अपनी सेव्ड API कुंजी को एक एनवायरनमेंट वेरिएबल के रूप में भी स्टोर करते हैं।
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”हम Mercury 2 रिसर्च एजेंट चलाने के लिए कोर डिपेंडेंसीज़ इंस्टॉल करते हैं और सुरक्षित API एक्सेस कॉन्फ़िगर करते हैं। हम मॉडल कॉल्स के लिए मानक OpenAI क्लाइंट, Streamlit इंटरैक्टिव इंटरफ़ेस बनाने के लिए, aiohttp कम‑लेटेंसी रिट्रीवल के लिए समानांतर वेब सर्च चलाने हेतु, और beautifulsoup4 और lxml सर्च परिणाम पार्स करने के लिए उपयोग करते हैं।
पैकेज इंस्टॉल करने के बाद, अपनी INCEPTION_API_KEY को एनवायरनमेंट वेरिएबल के रूप में सेट करें ताकि क्रेडेंशियल्स सुरक्षित रहें और एप्लिकेशन रनटाइम के दौरान स्वतः ऑथेंटिकेट कर सके।
अगले चरण में, हम Mercury क्लाइंट इम्प्लीमेंट करेंगे और कोर मल्टी‑स्टेप एजेंट पाइपलाइन बनाएंगे।
चरण 3: Mercury क्लाइंट
यह चरण तीन चीज़ों को जोड़ता है: ऐप में उपयोग होने वाली लाइब्रेरियों का इम्पोर्ट, एनवायरनमेंट से API कुंजी को सुरक्षित रूप से लोड करना, और Inception के बेस URL की ओर इशारा करते हुए OpenAI क्लाइंट को इनिशियलाइज़ करना।
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)उपरोक्त स्निपेट Mercury 2 क्लाइंट को इनिशियलाइज़ करता है और एप्लिकेशन के सपोर्टिंग स्टैक को इम्पोर्ट करता है, जिनमें UI के लिए Streamlit, असिंक्रोनस वेब रिक्वेस्ट्स के लिए aiohttp, सर्च परिणामों को पार्स करने के लिए BeautifulSoup, और JSON हैंडलिंग, टाइमिंग तथा डेटा स्ट्रक्चर्स के लिए मानक Python यूटिलिटीज शामिल हैं।
फिर हम INCEPTION_API_KEY को एनवायरनमेंट वेरिएबल से पढ़ते हैं, Inception बेस URL रिक्वेस्ट्स को सही ढंग से रूट करने के लिए कॉन्फ़िगर है, और मॉडल नाम "mercury-2" सेट है ताकि सभी अगली कॉल्स लक्षित रीजनिंग मॉडल का उपयोग करें।
अंततः, OpenAI क्लाइंट कस्टम बेस URL के साथ इनिशियलाइज़ होता है, जिससे chat.completions इंटरफ़ेस का उपयोग करके Mercury 2 को कॉल किया जा सकता है।
चरण 4: वेब सर्च टूल
अब हमें रिट्रीवल चरण चाहिए जो वेब से ताज़ा जानकारी ला सके। इस ट्यूटोरियल में, हम DuckDuckGo के HTML एंडपॉइंट का उपयोग कर सर्च टूल इम्प्लीमेंट करेंगे और परिणामों को सीधे पार्स करेंगे क्योंकि इसके लिए अतिरिक्त API कुंजियों की आवश्यकता नहीं और प्रोटोटाइपिंग के लिए पर्याप्त तेज़ है।
उच्च स्तर पर, हम तीन चीज़ें इम्प्लीमेंट करते हैं:
- DuckDuckGo के HTML परिणाम पेज पर क्वेरी चलाना
- शीर्ष परिणामों को संरचित
SearchResultफ़ॉर्मैट में पार्स करना - डीडुप्लिकेट करना और परिणामों को कॉम्पैक्ट JSON में पैक करना ताकि Mercury बाद में सिट कर सके
DDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceऊपर दिए यूटिलिटीज़ चार प्रमुख घटक परिभाषित करती हैं:
- असिंक्रोनस वेब रिट्रीवल:
ddg_search()फ़ंक्शनaiohttpका उपयोग कर DuckDuckGo के HTML एंडपॉइंट को क्वेरी करता है और BeautifulSoup व lxml से रिस्पॉन्स पार्स करता है। हर परिणाम को संरचित रूप में निकाला जाता है और लेटेंसी कम रखने के लिएmax_resultsपर रुक जाता है। इससे कई सर्चेस समानांतर असिंक्रोनसली चल पाती हैं। - टेक्स्ट सामान्यीकरण:
clean_text()हेल्पर अतिरिक्त व्हाइटस्पेस और फ़ॉर्मैटिंग आर्टिफैक्ट्स हटाता है ताकि स्निपेट्स कॉम्पैक्ट और पठनीय रहें। परिणामों कोSearchResultडाटाक्लास में स्टोर किया जाता है, जो आउटपुट को मानकीकृत करता है और अगले चरणों को कच्चे HTML स्ट्रक्चर से स्वतंत्र रखता है। - क्वेरियों के पार डीडुप्लीकेशन: जब एजेंट कई सर्च क्वेरियाँ चलाता है, वही पेज बार‑बार दिख सकते हैं।
dedupe_results()URL को सामान्यीकृत कर डुप्लीकेट हटाता है, जिससे साक्ष्य सेट विविध बना रहता है और कॉन्टेक्स्ट विंडो में कुशल रहता है। - मॉडल रीजनिंग के लिए एविडेंस पैकिंग:
pack_evidence()परिणामों को स्थिर आइडेंटिफ़ायर्स के साथ कॉम्पैक्ट JSON स्ट्रक्चर में बदलता है। स्निपेट्स ~320 कैरेक्टर्स तक ट्रिम होते हैं ताकि संयुक्त साक्ष्य मॉडल के कॉन्टेक्स्ट में फिट हों और बाद में इनलाइन सिटेशन्स से संदर्भित किए जा सकें।
पाठकों के लिए नोट:
यह DuckDuckGo HTML तरीका प्रोटोटाइप‑फ्रेंडली है क्योंकि इसे अतिरिक्त API कुंजियों की ज़रूरत नहीं, पर यह प्रोडक्शन‑ग्रेड सर्च नहीं है:
- HTML लेआउट बदल सकते हैं और सेलेक्टर्स टूट सकते हैं
- रेट लिमिटिंग / बॉट प्रोटेक्शन स्क्रैपिंग को ब्लॉक कर सकते हैं
- रिज़ल्ट क्वालिटी और रैंकिंग में भिन्नता हो सकती है
अगर आप प्रोडक्शन‑रेडी संस्करण चाहते हैं, तो इसे किसी स्थिर Search API (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search, आदि) से बदलें और एजेंट का बाकी हिस्सा यथावत रखें।
अगले चरण में, हम इस रिट्रीवल लेयर को Mercury 2 से जोड़ेंगे ताकि मॉडल सर्च क्वेरियाँ जेनरेट कर सके, एकत्र साक्ष्य पर रीजनिंग कर सके, और स्रोत‑आधारित उत्तर तैयार कर सके।
चरण 5: Mercury कॉल्स
इस चरण में, हम Mercury 2 को एक छोटे, पुन: प्रयोज्य इंटरफ़ेस के पीछे लपेटते हैं जो सख्त संरचित आउटपुट (प्लानिंग के लिए) और स्ट्रीम्ड टेक्स्ट जेनरेशन (सिंथेसिस और डिफ्यूज़िंग डेमो के लिए) दोनों सपोर्ट करता है।
उद्देश्य हर मॉडल कॉल को एकसमान रखना है, फिर भी एक ही सेटिंग्स ऑब्जेक्ट के माध्यम से Mercury के “रीजनिंग कंट्रोल्स” और स्ट्रीमिंग मोड्स को एक्सपोज़ करना है।
def mercury_settings(
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
diffusing: bool = False,
) -> Dict[str, Any]:
return {
"reasoning_effort": reasoning_effort,
"reasoning_summary": reasoning_summary,
"reasoning_summary_wait": reasoning_summary_wait,
"diffusing": diffusing,
}
def mercury_json(
system: str,
user: str,
max_tokens: int = 400,
reasoning_effort: str = "medium",
) -> Dict[str, Any]:
def _call(messages) -> str:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=0.0,
stream=False,
extra_settings=mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
diffusing=False,
),
)
return (resp.choices[0].message.content or "").strip()
text = _call(
[{"role": "system", "content": system}, {"role": "user", "content": user}]
)
try:
return json.loads(text)
except json.JSONDecodeError:
pass
m = re.search(r"\{.*\}", text, flags=re.DOTALL)
if m:
try:
return json.loads(m.group(0))
except json.JSONDecodeError:
pass
repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
repair_user = (
"Fix the following so it is valid JSON and matches the required schema.\n\n"
"REQUIRED SCHEMA:\n"
"{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
"BROKEN OUTPUT:\n"
f"{text}"
)
fixed = _call(
[{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
)
try:
return json.loads(fixed)
except json.JSONDecodeError:
m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
if not m2:
raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
return json.loads(m2.group(0))
def mercury_text(
system: str,
user: str,
max_tokens: int = 950,
temperature: float = 0.3,
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
stream: bool = False,
diffusing: bool = False,
stream_callback=None,
) -> str:
if diffusing:
stream = True
extra_settings = mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
diffusing=diffusing,
)
messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
if not stream:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=False,
extra_settings=extra_settings,
)
return (resp.choices[0].message.content or "").strip()
full = ""
stream_resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=True,
extra_settings=extra_settings,
)
for event in stream_resp:
choices = getattr(event, "choices", None) or []
if not choices:
continue
delta = getattr(choices[0], "delta", None)
chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
if not chunk:
continue
if diffusing:
full = chunk
else:
full += chunk
if stream_callback:
stream_callback(full, {"delta": chunk})
return full.strip()इस चरण में, हम हेल्पर फ़ंक्शन्स तीन प्रमुख घटकों के साथ परिभाषित करते हैं:
- रीजनिंग कंट्रोल सेटिंग्स:
mercury_settings()फ़ंक्शनreasoning_effort,reasoning_summary,reasoning_summary_wait, औरdiffusingजैसी Mercury‑विशिष्ट सेटिंग्स को केंद्रीकृत करता है। इससे पाइपलाइन एकसमान रहती है और Streamlit टॉगल्स को हर मॉडल कॉल में बिना कॉन्फ़िग डुप्लीकेशन के सीधे जोड़ा जा सकता है। - स्कीमा‑अनुरूप JSON जेनरेशन:
mercury_json()तब उपयोग होता है जब एजेंट को संरचित आउटपुट चाहिए। यहtemperature=0.0पर चलता है और फ़ॉर्मैट स्थिरता अधिकतम करने के लिए स्ट्रीमिंग/डिफ्यूज़न को निष्क्रिय करता है। फ़ंक्शन पहले सीधे JSON पार्स करने की कोशिश करता है, फिर regex के जरिए JSON ब्लॉक एक्सट्रैक्ट करने का प्रयास करता है, और अंततः आवश्यक स्कीमा से मेल खाते वैध JSON को बाध्य करने के लिए रिपेयर पास पर फ़ॉलबैक करता है। - वैकल्पिक स्ट्रीमिंग और डिफ्यूज़न के साथ टेक्स्ट जेनरेशन:
mercury_text()फ़ंक्शन नॉन‑स्ट्रीमिंग और स्ट्रीमिंग दोनों मोड्स सपोर्ट करता है। यदिdiffusing=Trueहै, तो यह स्वतःstream=Trueकर देता है, और वर्तमान बफ़र को ओवरराइट करके प्रदर्शित टेक्स्ट अपडेट करता है। सामान्य स्ट्रीमिंग मोड में, यह डेल्टाज़ अपेंड कर अंतिम रिस्पॉन्स बनाता है। वैकल्पिकstream_callback()हुक UI को लाइव अपडेट रेंडर करने देता है।
अगले चरण में, हम इन हेल्पर्स का उपयोग कर संरचित क्वेरी विस्तार इम्प्लीमेंट करेंगे और उन्हें वेब सर्च और एविडेंस पैकिंग पाइपलाइन से जोड़ेंगे।
चरण 6: संरचित क्वेरी विस्तार
अब, हम Mercury 2 और वेब सर्च को एंड‑टू‑एंड रिसर्च लूप में जोड़ते हैं। मुख्य विचार पहले एक संरचित सर्च प्लान जेनरेट करना है, फिर अंतिम उत्तर को साक्ष्य पे-लोड में ग्राउंड करना है, ताकि UI में Mercury के रीजनिंग कंट्रोल्स और स्ट्रीमिंग/डिफ्यूज़िंग मोड्स प्रदर्शित हो सकें।
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
system = (
"Return ONLY valid JSON. No markdown.\n"
"Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
"Rules:\n"
f"- MUST produce at least {max(3, n_queries-2)} queries\n"
"- queries <= 12 words, diverse\n"
"- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
"Output must start with '{' and end with '}'."
)
user = f"Question: {question}\nReturn {n_queries} queries."
out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
queries = (out.get("queries") or [])
subqs = (out.get("subquestions") or [])
must = (out.get("must_cover") or [])
if len(queries) == 0:
queries = [
f"{question} benchmarks",
"vLLM edge inference benchmarks",
"llama.cpp edge inference benchmarks",
"vLLM vs llama.cpp quantization",
"llama.cpp Metal CUDA Vulkan performance",
"vLLM KV cache paged attention memory",
][:n_queries]
out["queries"] = queries[:n_queries]
out["subquestions"] = subqs[: min(6, n_queries)]
out["must_cover"] = must[:6]
return out
def answer_with_citations(
question: str,
evidence: List[Dict[str, str]],
*,
reasoning_effort: str,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream: bool,
diffusing: bool,
stream_callback=None,
) -> str:
system = (
"You are a fast research synthesizer.\n"
"Use ONLY the provided evidence.\n"
"Add inline citations like [S1], [S2] using evidence ids.\n"
"If evidence is insufficient, say what's missing."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
"Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.3,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream,
diffusing=diffusing,
stream_callback=stream_callback,
)
def verify_answer(
question: str,
evidence: List[Dict[str, str]],
draft: str,
*,
reasoning_effort: str,
) -> str:
system = (
"You are a verifier.\n"
"Remove/soften any claim not supported by evidence.\n"
"Keep citations [S#]. Return revised answer."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
f"Draft:\n{draft}"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.2,
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
stream=False,
diffusing=False,
)
async def run_agent(
question: str,
n_queries: int,
max_results_per_query: int,
do_verify: bool,
*,
reasoning_effort: str,
stream_answer: bool,
diffusing: bool,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream_callback=None,
) -> Dict[str, Any]:
t0 = time.perf_counter()
plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
t1 = time.perf_counter()
queries = plan.get("queries", [])
async with aiohttp.ClientSession() as session:
tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
lists = await asyncio.gather(*tasks)
flat = dedupe_results([r for lst in lists for r in lst])
evidence = pack_evidence(flat, max_items=18)
t2 = time.perf_counter()
draft = answer_with_citations(
question,
evidence,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream_answer,
diffusing=diffusing,
stream_callback=stream_callback,
)
t3 = time.perf_counter()
final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
t4 = time.perf_counter()
return {
"plan": plan,
"evidence": evidence,
"answer": final,
"timings_sec": {
"expand": round(t1 - t0, 3),
"search_parallel": round(t2 - t1, 3),
"synthesize": round(t3 - t2, 3),
"verify": round(t4 - t3, 3),
"total": round(t4 - t0, 3),
},
}यह चरण चार कोर स्टेजेस को जोड़ता है:
- संरचित क्वेरी प्लानिंग:
expand_query()फ़ंक्शन Mercury 2 से सख्त JSON (जिसमेंqueries,subquestions, औरmust_coverहों) लौटाने को कहकर संरचित रिसर्च प्लान जेनरेट करता है। आउटपुट कोmercury_json()से पार्स किया जाता है, जिसमें ऑटोमैटिक JSON रिपेयर शामिल है, और फ़ॉलबैक क्वेरी सेट भी है जिससे मॉडल खाली प्लान दे तो भी एजेंट चलता रहे। - सिटेशन्स के साथ एविडेंस‑ग्राउंडेड सिंथेसिस:
answer_with_citations()फ़ंक्शन केवल सर्च चरण से मिले पैक्ड साक्ष्य का उपयोग कर प्रारंभिक उत्तर बनाता है। प्रॉम्प्ट स्पष्ट रूप से मॉडल को दिए गए साक्ष्य तक सीमित करता है और इनलाइन सिटेशन्स आवश्यक करता है। आउटपुट में डायरेक्ट उत्तर, मुख्य इनसाइट्स और केविएट्स शामिल होते हैं, जिससे रिस्पॉन्स संक्षिप्त और स्रोतों से ट्रेस करने योग्य रहता है। - ग्राउंडिंग के लिए वैकल्पिक वेरिफिकेशन:
verify_answer()फ़ंक्शन Generate‑Critique‑Fix पैटर्न लागू करता है। यह उसी साक्ष्य के विरुद्ध ड्राफ्ट उत्तर का पुनर्मूल्यांकन करता है और असमर्थित दावों को हटाता/नरम करता है, जबकि सिटेशन मार्कर्स को बनाए रखता है। यह अतिरिक्त पास न्यूनतम लेटेंसी ओवरहेड के साथ ओवरजनरलाइज़ेशन घटाता है और तथ्यात्मक ग्राउंडिंग बेहतर करता है। - परफ़ॉर्मेंस ट्रैकिंग के साथ ऑर्केस्ट्रेशन:
run_agent()फ़ंक्शन पूरे वर्कफ़्लो का समन्वय करता है—क्वेरी प्लान का विस्तार,aiohttpऔरasyncio.gather()का उपयोग कर समानांतर DuckDuckGo सर्च चलाना, परिणामों को डीडुप और कॉम्पैक्ट एविडेंस JSON में पैक करना, सिंथेसाइज़्ड उत्तर जेनरेट करना, और वैकल्पिक रूप से वेरिफिकेशन चलाना।
चरण 7: Streamlit UI
अंत में, हम एजेंट रनटाइम (run_agent) को Streamlit इंटरफ़ेस से जोड़ेंगे ताकि उपयोगकर्ता प्रश्न दर्ज कर सके, एजेंट कैसे सर्च करे यह ट्यून कर सके, और पूर्ण एक्ज़ीक्यूशन ट्रेस देख सके—अंतिम उत्तर, टाइमिंग्स, जनरेट किया गया क्वेरी प्लान, और एविडेंस बंडल।
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
"Ask a complex question",
height=120,
placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
max_results = st.slider("Results per query", 1, 6, 2)
with col3:
do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
stream_answer = st.checkbox("Stream answer", value=False)
diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
if diffusing and not stream_answer:
st.info("Diffusing requires streaming. Enabling streaming automatically.")
stream_answer = True
run = st.button("Run agent", type="primary")
if run:
if not question.strip():
st.warning("Enter a question.")
st.stop()
answer_placeholder = st.empty()
status_placeholder = st.empty()
def _stream_cb(text: str, meta: Dict[str, Any]):
answer_placeholder.markdown(text)
with st.spinner("Running…"):
status_placeholder.caption("Planning → searching → synthesizing…")
out = asyncio.run(
run_agent(
question.strip(),
n_queries,
max_results,
do_verify,
reasoning_effort=reasoning_effort,
stream_answer=stream_answer,
diffusing=diffusing,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream_callback=_stream_cb if stream_answer else None,
)
)
status_placeholder.empty()
st.subheader("Answer")
st.write(out["answer"])
st.subheader("Timings (sec)")
st.json(out["timings_sec"])
with st.expander("Plan (queries / subquestions)"):
st.json(out["plan"])
with st.expander("Evidence (search results)"):
st.json(out["evidence"])ऊपर का कोड परिभाषित करता है कि Streamlit लेयर कैसे run_agent() फ़ंक्शन को एक इंटरैक्टिव रिसर्च वर्कफ़्लो में बदलती है। उपयोगकर्ता प्रश्न दर्ज करता है, सर्च की चौड़ाई और गहराई नियंत्रित करता है, और वैकल्पिक रूप से ऐसा वेरिफिकेशन पास सक्षम करता है जो असमर्थित दावों को हटाता है।
एक अतिरिक्त “Mercury settings” पैनल मॉडल सेटिंग्स जैसे reasoning_effort, streaming आउटपुट, और diffusing मोड एक्सपोज़ करता है; डिफ्यूजिंग के लिए स्ट्रीमिंग आवश्यक है और नए चंक्स आने पर उत्तर प्लेसहोल्डर को जगह‑जगह अपडेट करता है।
रन पर, ऐप इनपुट को वैलिडेट करता है, आंशिक आउटपुट को प्लेसहोल्डर में स्ट्रीम करता है, फिर अंतिम उत्तर के साथ टाइमिंग्स और जनरेटेड प्लान व एविडेंस बंडल के एक्सपैंडेबल डिबग व्यूज़ रेंडर करता है।
स्वयं आज़माने के लिए, कोड को app.py के रूप में सेव करें और लॉन्च करें:
streamlit run app.pyनिष्कर्ष
इस ट्यूटोरियल में, हमने Mercury 2 द्वारा संचालित एक लेटेंसी‑अवेयर रिसर्च एजेंट बनाया। सिस्टम उपयोगकर्ता क्वेरी के लिए एक संरचित सर्च प्लान जेनरेट करता है, फिर समानांतर वेब रिट्रीवल निष्पादित करता है, परिणामों को कॉम्पैक्ट एविडेंस फ़ॉर्मैट में सामान्यीकृत करता है, और सिटेशन्स के साथ ग्राउंडेड उत्तर तैयार करता है।
हमने एक वैकल्पिक वेरिफिकेशन पास भी जोड़ा जो उसी साक्ष्य के विरुद्ध ड्राफ्ट को फिर से जाँचता है और असमर्थित दावों को नरम करता है। यह साधारण Generate–Critique–Fix पैटर्न न्यूनतम लेटेंसी जोड़कर तथ्यात्मक ग्राउंडिंग को काफ़ी बेहतर बनाता है।
कोर पाइपलाइन से परे, एप्लिकेशन Mercury 2 के रनटाइम कंट्रोल्स एक्सपोज़ करता है, जिनमें रीजनिंग एफ़र्ट, स्ट्रीमिंग आउटपुट, रीजनिंग समरीज़, और डिफ्यूज़िंग मोड शामिल हैं। इस प्रोजेक्ट का विस्तार करने के लिए, आप ये कर सकते हैं:
- DuckDuckGo स्क्रैपर को किसी प्रोडक्शन सर्च API (Bing, SerpAPI, Brave) से बदलें
- बार‑बार आने वाली लेटेंसी घटाने के लिए सर्च परिणाम या इंटरमीडिएट प्लान कैश करें
- सेशन मेमोरी या मल्टी‑टर्न रिसर्च के लिए साक्ष्य को परसिस्ट करें
- उच्च‑गुणवत्ता साक्ष्य चयन के लिए एक समरीकरण लेयर जोड़ें
डेवलपमेंट कार्यों के लिए AI का उपयोग करना और सीखने के लिए, मैं यह कोर्स सुझाता/सुझाती हूँ: AI‑Assisted Coding for Developers.
Mercury 2 FAQs
Mercury 2 पारंपरिक LLMs से अलग कैसे है?
Mercury 2 डिफ्यूज़न‑स्टाइल समानांतर रिफाइनमेंट प्रक्रिया का उपयोग करता है—ड्राफ्ट बनाता है और उसे कई चरणों में सुधारता है। इससे हाई थ्रूपुट और मल्टी‑कॉल पाइपलाइंस में, जहाँ लेटेंसी जुड़ती जाती है, बेहतर परफ़ॉर्मेंस मिलती है।
Mercury 2 का डिफ्यूज़िंग मोड क्या है?
डिफ्यूज़िंग मोड में मॉडल अपने आउटपुट को रिफाइन करते हुए इंटरमीडिएट ड्राफ्ट्स को स्ट्रीम करता है। टोकन‑दर‑टोकन टाइपिंग की बजाय, टेक्स्ट को जगह‑जगह फिर से लिखा और क्रमशः सुधारा जाता है।
वेरिफिकेशन पास क्यों शामिल करें?
वेरिफिकेशन चरण उसी साक्ष्य के विरुद्ध ड्राफ्ट का पुनर्मूल्यांकन करता है और असमर्थित दावों को हटाता है। केवल एक अतिरिक्त मॉडल कॉल से ग्राउंडिंग बेहतर होती है।
क्या DuckDuckGo सर्च इम्प्लीमेंटेशन प्रोडक्शन‑रेडी है?
नहीं। HTML स्क्रैपिंग तरीका सरलता के लिए उपयोग किया गया है और किसी API कुंजी की आवश्यकता नहीं, पर पेज लेआउट बदलने पर यह टूट सकता है और रेट‑लिमिटेड भी हो सकता है। प्रोडक्शन उपयोग के लिए इसे Bing Web Search, Brave Search, या SerpAPI जैसे स्थिर सर्च API से बदलें।
Mercury 2 की कीमत कितनी है?
Mercury 2 को हाई‑फ़्रीक्वेंसी वर्कलोड्स के लिए डिज़ाइन किया गया है, जिसमें इनपुट टोकन की लागत कम है और कैश्ड टोकन पर छूट है। नए उपयोगकर्ताओं को वर्तमान में साइन‑अप पर मुफ्त टोकन मिलते हैं, जो इस ट्यूटोरियल को चलाने और एजेंट के साथ प्रयोग करने के लिए पर्याप्त हैं।

मैं एमएल (Gen AI) में Google Developers Expert, Kaggle 3x Expert, और Women Techmakers एंबेसडर हूँ, तथा तकनीक क्षेत्र में 3+ वर्षों का अनुभव रखती हूँ। मैंने 2020 में एक हेल्थ-टेक स्टार्टअप की सह-स्थापना की और वर्तमान में Georgia Tech से कंप्यूटर विज्ञान में मास्टर कर रही हूँ, जिसमें मेरा विशेषज्ञता क्षेत्र मशीन लर्निंग है।
Mercury 2 को प्रोडक्शन रीजनिंग वर्कलोड्स के लिए बनाया गया है जिनमें सर्च, प्लानिंग और रिट्रीवल पाइपलाइंस जैसे एजेंट वर्कफ़्लो शामिल होते हैं, जहाँ पारंपरिक ऑटोरिग्रेसिव मॉडल अनुक्रमिक डिकोडिंग के कारण धीमे हो जाते हैं। इस ट्यूटोरियल में, हम Streamlit के साथ Mercury 2 का उपयोग कर एक रीयल‑टाइम मल्टी‑स्टेप रिसर्च एजेंट बनाएंगे।
ऐप में, उपयोगकर्ता एक जटिल प्रश्न पूछता है, फिर सिस्टम उसे कई केंद्रित सर्च क्वेरियों में विस्तार देता है, वेब परिणामों को समानांतर में प्राप्त करता है, उन्हें संरचित साक्ष्य में संपीड़ित करता है, और इनलाइन सिटेशन्स के साथ स्रोत-आधारित उत्तर तैयार करता है।
एक वैकल्पिक वेरिफिकेशन चरण ड्राफ्ट की साक्ष्य के साथ समीक्षा करता है और असमर्थित दावों को हटा देता है। इंटरफ़ेस Mercury के रनटाइम कंट्रोल्स भी दिखाता है, जिनमें रीजनिंग एफ़र्ट, स्ट्रीमिंग आउटपुट, और डिफ्यूज़न-स्टाइल स्ट्रीमिंग शामिल हैं, जो रीयल‑टाइम में उत्तर को परिष्कृत होते दिखाती है।
इस दौरान, आप सीखेंगे कि कैसे:
reasoning_effortऔर अन्य रीजनिंग सेटिंग्स से नियंत्रित करेंstreamingऔरdiffusingमोड सक्षम करेंअंतिम एप्लिकेशन एक सर्च प्लान, साक्ष्य स्रोत, और चरणवार लेटेंसी लौटाता है, जिससे सिस्टम तेज़ होने के साथ‑साथ जांचने योग्य भी बनता है।