

Programa
Fundamentos de agentes de IA
6 h
Pratique e programa seu progresso.
Continuar Com O GoogleO Mercury 2 é o modelo de raciocínio rápido da Inception Labs, criado para cargas de trabalho em produção nas quais a latência se acumula em loops de agentes, pipelines de recuperação e aplicações com alta concorrência.
Diferente dos LLMs autoregressivos padrão, que decodificam um token por vez, o Mercury 2 usa um processo de geração em estilo difusão que refina o texto em paralelo — o que explica sua altíssima vazão sob a configuração de serving adequada.
Entre os principais recursos do Mercury 2 estão:
O Mercury 2 expõe uma API compatível com OpenAI, o que permite usar as bibliotecas cliente existentes da OpenAI apenas alterando a URL base e o nome do modelo. Assim, ele se encaixa em aplicativos existentes, frameworks de agentes e pipelines de produção sem exigir mudanças de SDK ou arquitetura.
O modelo suporta uma janela de contexto de cerca de 128K tokens, ideal para fluxos que precisam passar grandes conjuntos de evidências, saídas de ferramentas em múltiplas etapas, histórico de conversas ou estado intermediário estruturado.
O Mercury 2 lida de forma confiável com JSON restrito por esquema e dá suporte a interações no estilo de ferramentas. Isso viabiliza casos como planejamento de consultas, geração de argumentos para ferramentas, passagem de estado estruturado entre etapas e pipelines de verificação em que a formatação determinística é essencial.
Diferente da maioria dos modelos de uso geral, o Mercury 2 expõe controles operacionais como reasoning_effort (de instantâneo a alto), resumos de raciocínio opcionais, saída em streaming e streaming em estilo difusão. Esses ajustes permitem equilibrar velocidade, profundidade e interatividade a cada chamada, conforme o estágio do pipeline.
A precificação é otimizada para workloads de alta frequência, com custos baixos por token de entrada e descontos significativos para tokens de entrada em cache. Isso beneficia loops de agentes e pipelines multi-etapas, nos quais prompts de sistema e contexto são reutilizados em várias chamadas.
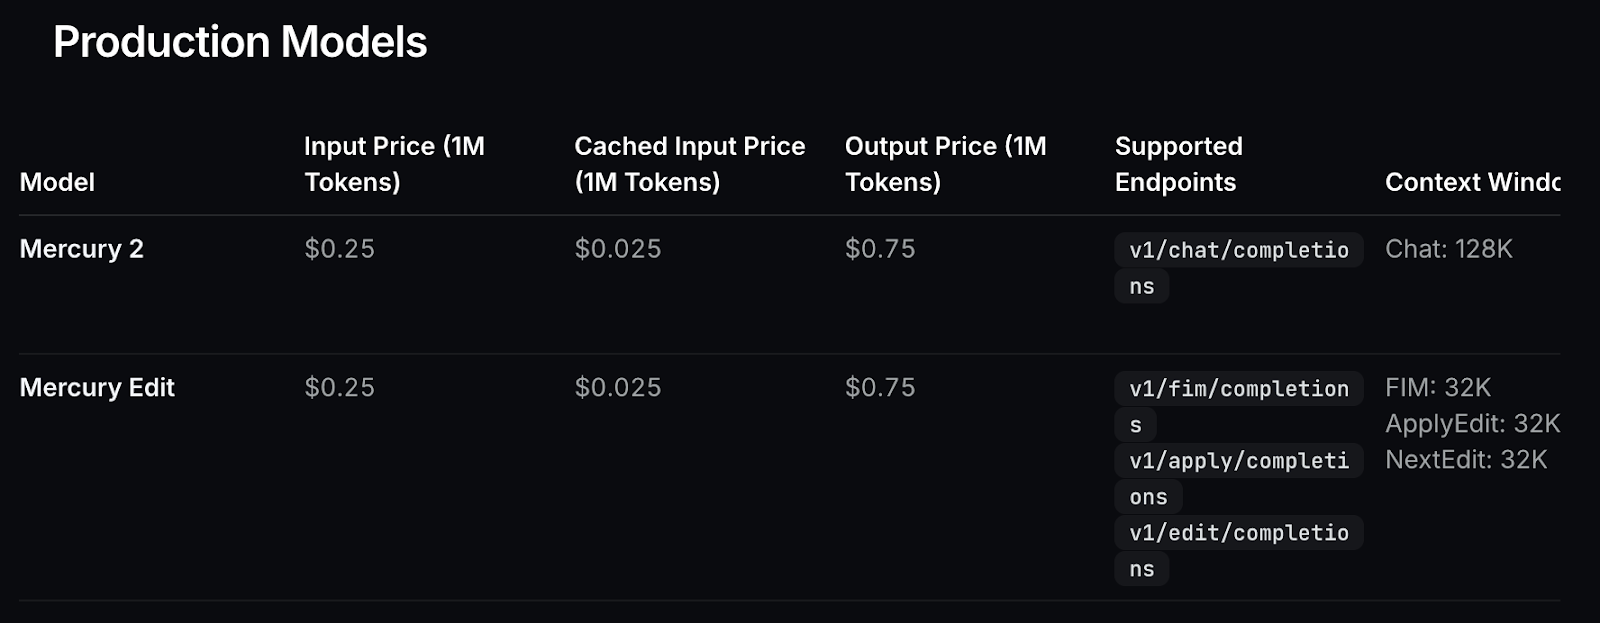
Figura: preços do modelo
LLMs tradicionais geram texto de forma autoregressiva, produzindo um token por vez em sequência.
token 1 - token 2 - token 3… Isso faz com que a latência seja fortemente acoplada ao tamanho da saída, já que cada token depende do anterior; assim, a latência cresce linearmente com o comprimento do texto. Isso vira gargalo em sistemas de agentes, onde você pode executar várias chamadas ao modelo por solicitação do usuário.
O Mercury 2 segue outro caminho. Em vez de decodificação sequencial, ele usa um processo de refinamento paralelo inspirado em difusão. O modelo gera um rascunho inicial e depois refina vários tokens simultaneamente em poucas etapas.
A geração se comporta mais como edição iterativa do que como digitação passo a passo, o que melhora a vazão e reduz a latência de ponta a ponta em pipelines com várias chamadas.
Esse processo de refinamento também habilita o modo diffusing, no qual rascunhos intermediários são transmitidos e aprimorados progressivamente na UI. Usuários podem assistir ao texto evoluir para a forma final em tempo real — ótimo para demos, apps interativos e interfaces de pesquisa ao vivo.
Essa arquitetura torna o Mercury 2 especialmente indicado para sistemas em que a latência se acumula ao longo de várias etapas de raciocínio, e não em prompts de disparo único.
Nesta seção, vamos construir um assistente de pesquisa em tempo real com o Mercury 2 que recebe uma pergunta complexa, busca na web, raciocina a partir de múltiplas fontes e retorna uma resposta fundamentada em poucos segundos. Em vez de uma interação única de prompt–resposta, o sistema executa um loop de agente rápido e multi-etapas, em que cada passo refina as informações necessárias para um resultado confiável.
Em alto nível, o aplicativo realiza cinco tarefas centrais:
[S1], [S2].O aplicativo produz duas saídas principais:
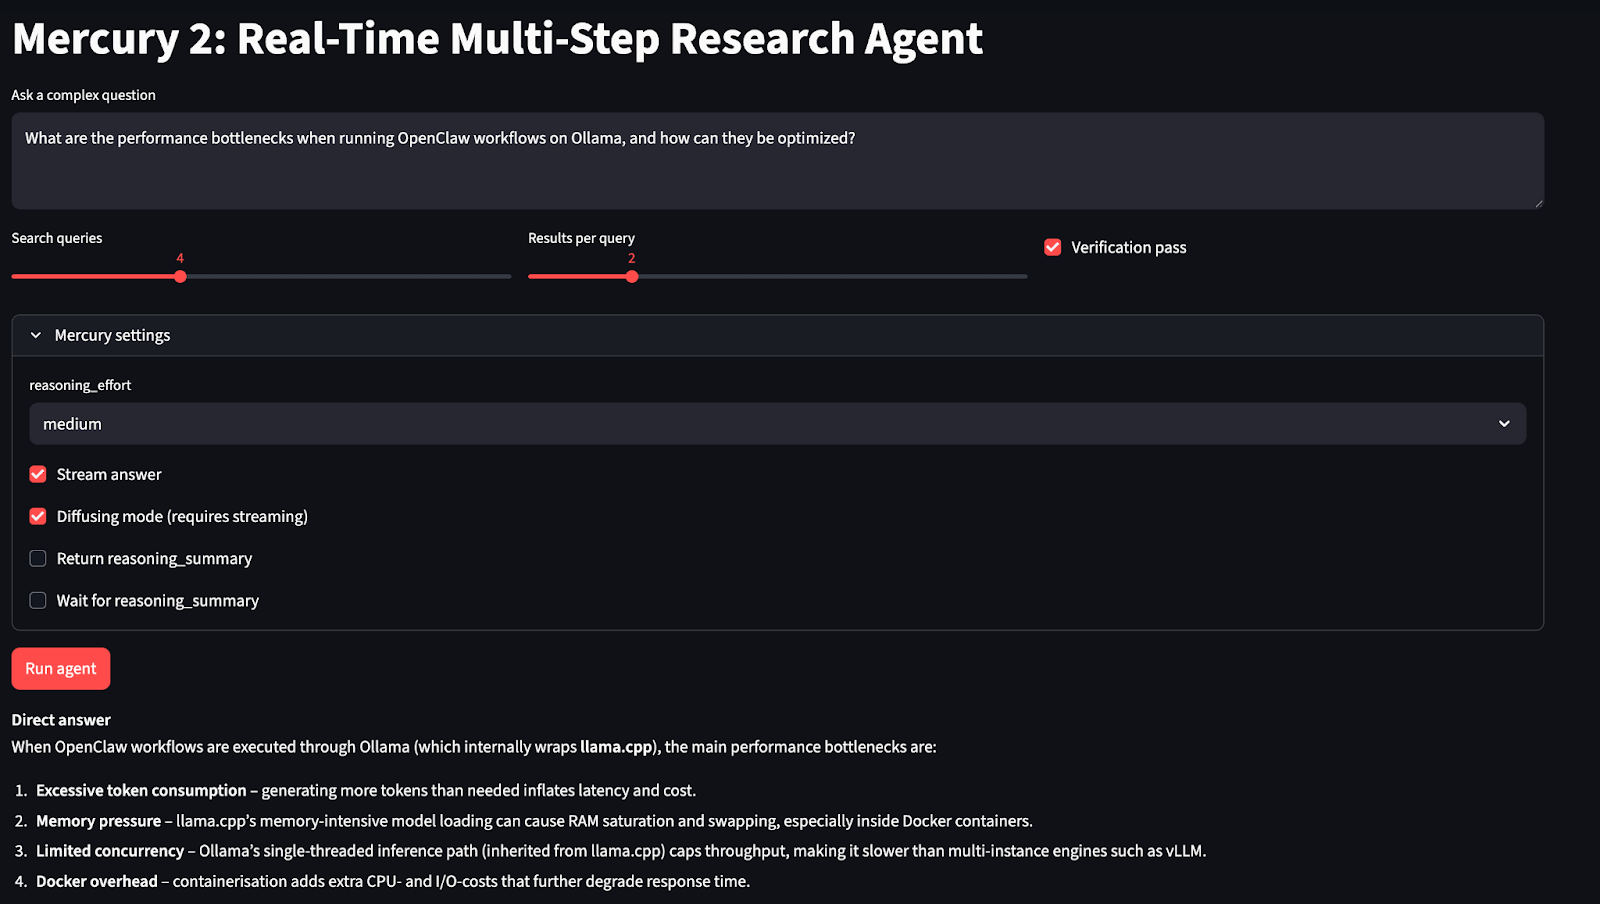
Antes de construirmos o agente de pesquisa, precisamos de acesso à API do Mercury 2. Como o Mercury 2 está disponível por acesso antecipado, este passo garante que você tenha as credenciais e a configuração de endpoint necessárias para fazer chamadas de inferência a partir do seu aplicativo.
Você pode solicitar acesso aqui: https://www.inceptionlabs.ai/early-access.
Depois que sua conta for aprovada:
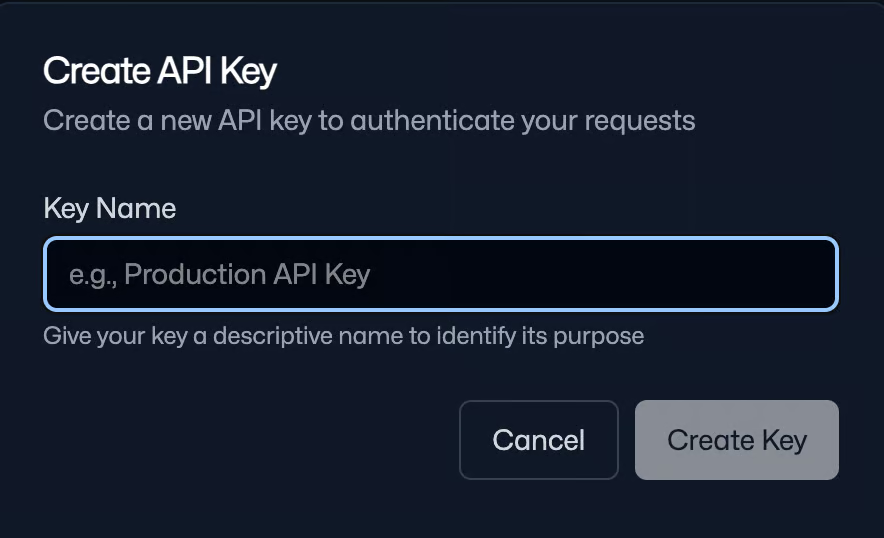
Guarde essa chave com segurança — você vai usá-la para autenticar todas as requisições à API.
Observação: você recebe 10.000.000 de tokens gratuitos no cadastro inicial — o suficiente para executar este experimento.
Com o acesso à API, o próximo passo é preparar o ambiente local para construir e executar o agente de pesquisa Mercury 2. Como a API da Inception é compatível com OpenAI, podemos usar o cliente Python padrão da OpenAI junto com bibliotecas para a interface web e o pipeline de busca. Também armazenamos nossa API key como variável de ambiente.
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”
Instalamos as dependências centrais para executar o agente de pesquisa Mercury 2 e configuramos o acesso seguro à API. Usamos o cliente padrão da OpenAI para chamadas de modelo, Streamlit para construir a interface interativa, aiohttp para executar buscas web em paralelo com baixa latência, e beautifulsoup4 com lxml para fazer o parsing dos resultados.
Depois de instalar os pacotes, defina sua INCEPTION_API_KEY como variável de ambiente para manter as credenciais seguras e permitir que o aplicativo se autentique automaticamente em runtime.
No próximo passo, vamos implementar o cliente Mercury e construir o pipeline central do agente multi-etapas.
Este passo conecta três pontos: importar as bibliotecas usadas no app, carregar a API key com segurança do ambiente e inicializar um cliente OpenAI apontado para a URL base da Inception.
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
    st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
    st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)
O trecho acima inicializa um cliente do Mercury 2 e importa a stack de suporte do aplicativo, incluindo Streamlit para a UI, aiohttp para requisições web assíncronas, BeautifulSoup para parsear resultados de busca e utilitários padrão de Python para JSON, temporização e estruturas de dados.
Em seguida, lemos a INCEPTION_API_KEY da variável de ambiente; a URL base da Inception é configurada para rotear as requisições corretamente, e o nome do modelo é definido como "mercury-2" para que todas as chamadas usem o modelo de raciocínio pretendido.
Por fim, o cliente OpenAI é inicializado com a URL base personalizada, permitindo chamar o Mercury 2 usando a interface padrão de chat.completions.
Agora precisamos de uma etapa de recuperação que busque informações atualizadas na web. Neste tutorial, vamos implementar uma ferramenta de busca usando o endpoint HTML do DuckDuckGo e fazer o parsing direto dos resultados, pois não exige chaves adicionais de API e é rápido o suficiente para prototipagem.
Em alto nível, implementamos três coisas:
SearchResultDDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceAs utilidades acima definem quatro componentes-chave:
ddg_search() consulta o endpoint HTML do DuckDuckGo usando aiohttp e faz o parsing da resposta com BeautifulSoup e lxml. Cada resultado é extraído em um formato estruturado, e a função para após max_results entradas para manter a latência baixa. Isso permite que várias buscas executem em paralelo de forma assíncrona.clean_text() remove espaços extras e artefatos de formatação para manter os trechos compactos e legíveis. Os resultados são armazenados com a dataclass SearchResult, que padroniza a saída e deixa as etapas seguintes independentes do HTML bruto.dedupe_results() remove duplicatas normalizando URLs, garantindo que o conjunto de evidências continue diverso e eficiente dentro da janela de contexto.pack_evidence() converte os resultados em uma estrutura JSON compacta com identificadores estáveis. Os trechos são limitados a ~320 caracteres para que o conjunto caiba no contexto do modelo e possa ser referenciado depois nas citações inline.Para uso em produção, substitua por uma Search API estável (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search etc.) e mantenha o restante do agente inalterado.
A seguir, vamos conectar essa camada de recuperação ao Mercury 2 para que o modelo gere consultas de busca, raciocine sobre as evidências coletadas e produza uma resposta fundamentada.
Neste passo, encapsulamos o Mercury 2 em uma interface pequena e reutilizável que suporta tanto saídas estruturadas estritas (para planejamento) quanto geração de texto em streaming (para síntese e o demo de diffusing).
A ideia é manter cada chamada ao modelo consistente, mas ainda expor os “ajustes de raciocínio” e modos de streaming do Mercury por meio de um único objeto de configurações.
def mercury_settings(
    reasoning_effort: str = "medium",
    reasoning_summary: bool = False,
    reasoning_summary_wait: bool = False,
    diffusing: bool = False,
) -> Dict[str, Any]:
    return {
        "reasoning_effort": reasoning_effort,
        "reasoning_summary": reasoning_summary,
        "reasoning_summary_wait": reasoning_summary_wait,
        "diffusing": diffusing,
    }

def mercury_json(
    system: str,
    user: str,
    max_tokens: int = 400,
    reasoning_effort: str = "medium",
) -> Dict[str, Any]:
    def _call(messages) -> str:
        resp = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            max_tokens=max_tokens,
            temperature=0.0,
            stream=False,
            extra_settings=mercury_settings(
                reasoning_effort=reasoning_effort,
                reasoning_summary=False,
                reasoning_summary_wait=False,
                diffusing=False,
            ),
        )
        return (resp.choices[0].message.content or "").strip()

    text = _call(
        [{"role": "system", "content": system}, {"role": "user", "content": user}]
    )
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        pass
    m = re.search(r"\{.*\}", text, flags=re.DOTALL)
    if m:
        try:
            return json.loads(m.group(0))
        except json.JSONDecodeError:
            pass
    repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
    repair_user = (
        "Fix the following so it is valid JSON and matches the required schema.\n\n"
        "REQUIRED SCHEMA:\n"
        "{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
        "BROKEN OUTPUT:\n"
        f"{text}"
    )
    fixed = _call(
        [{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
    )
    try:
        return json.loads(fixed)
    except json.JSONDecodeError:
        m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
        if not m2:
            raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
        return json.loads(m2.group(0))

def mercury_text(
    system: str,
    user: str,
    max_tokens: int = 950,
    temperature: float = 0.3,
    reasoning_effort: str = "medium",
    reasoning_summary: bool = False,
    reasoning_summary_wait: bool = False,
    stream: bool = False,
    diffusing: bool = False,
    stream_callback=None,
) -> str:
    if diffusing:
        stream = True
    extra_settings = mercury_settings(
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        diffusing=diffusing,
    )
    messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
    if not stream:
        resp = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            max_tokens=max_tokens,
            temperature=temperature,
            stream=False,
            extra_settings=extra_settings,
        )
        return (resp.choices[0].message.content or "").strip()
    full = ""
    stream_resp = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=max_tokens,
        temperature=temperature,
        stream=True,
        extra_settings=extra_settings,
    )
    for event in stream_resp:
        choices = getattr(event, "choices", None) or []
        if not choices:
            continue
        delta = getattr(choices[0], "delta", None)
        chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
        if not chunk:
            continue
        if diffusing:
            full = chunk
        else:
            full += chunk
        if stream_callback:
            stream_callback(full, {"delta": chunk})
    return full.strip()
Aqui, definimos funções auxiliares com três componentes principais:
mercury_settings() centraliza parâmetros específicos do Mercury, como reasoning_effort, reasoning_summary, reasoning_summary_wait e diffusing. Isso mantém o pipeline consistente e facilita conectar os toggles do Streamlit a cada chamada sem duplicar configuração.mercury_json() é usada quando o agente precisa de saídas estruturadas. Ela roda com temperature=0.0 e desativa streaming/diffusion para maximizar a estabilidade do formato. A função tenta fazer o parse direto do JSON, depois extrai um bloco via regex e, por fim, faz um passe de reparo que força o modelo a retornar JSON válido no esquema exigido.mercury_text() suporta modos sem e com streaming. Se diffusing=True, ela força stream=True e atualiza o texto exibido sobrescrevendo o buffer atual. No streaming normal, agrega deltas para formar a resposta final. O hook opcional stream_callback() permite que a UI renderize atualizações ao vivo.No próximo passo, vamos usar esses helpers para implementar a expansão estruturada de consultas e conectá-la à busca na web e ao empacotamento de evidências.
Agora conectamos o Mercury 2 e a busca na web em um loop de pesquisa de ponta a ponta. A ideia-chave é primeiro gerar um plano de busca estruturado e, depois, forçar que a resposta final seja fundamentada no pacote de evidências — tudo para mostrar os controles de raciocínio do Mercury e os modos de streaming/diffusing na UI.
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
    system = (
        "Return ONLY valid JSON. No markdown.\n"
        "Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
        "Rules:\n"
        f"- MUST produce at least {max(3, n_queries-2)} queries\n"
        "- queries <= 12 words, diverse\n"
        "- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
        "Output must start with '{' and end with '}'."
    )
    user = f"Question: {question}\nReturn {n_queries} queries."
    out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
    queries = (out.get("queries") or [])
    subqs = (out.get("subquestions") or [])
    must = (out.get("must_cover") or [])
    if len(queries) == 0:
        queries = [
            f"{question} benchmarks",
            "vLLM edge inference benchmarks",
            "llama.cpp edge inference benchmarks",
            "vLLM vs llama.cpp quantization",
            "llama.cpp Metal CUDA Vulkan performance",
            "vLLM KV cache paged attention memory",
        ][:n_queries]
    out["queries"] = queries[:n_queries]
    out["subquestions"] = subqs[: min(6, n_queries)]
    out["must_cover"] = must[:6]
    return out
def answer_with_citations(
    question: str,
    evidence: List[Dict[str, str]],
    *,
    reasoning_effort: str,
    reasoning_summary: bool,
    reasoning_summary_wait: bool,
    stream: bool,
    diffusing: bool,
    stream_callback=None,
) -> str:
    system = (
        "You are a fast research synthesizer.\n"
        "Use ONLY the provided evidence.\n"
        "Add inline citations like [S1], [S2] using evidence ids.\n"
        "If evidence is insufficient, say what's missing."
    )
    user = (
        f"Question:\n{question}\n\n"
        f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
        "Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
    )
    return mercury_text(
        system,
        user,
        max_tokens=950,
        temperature=0.3,
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        stream=stream,
        diffusing=diffusing,
        stream_callback=stream_callback,
    )
def verify_answer(
    question: str,
    evidence: List[Dict[str, str]],
    draft: str,
    *,
    reasoning_effort: str,
) -> str:
    system = (
        "You are a verifier.\n"
        "Remove/soften any claim not supported by evidence.\n"
        "Keep citations [S#]. Return revised answer."
    )
    user = (
        f"Question:\n{question}\n\n"
        f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
        f"Draft:\n{draft}"
    )
    return mercury_text(
        system,
        user,
        max_tokens=950,
        temperature=0.2,
        reasoning_effort=reasoning_effort,
        reasoning_summary=False,
        reasoning_summary_wait=False,
        stream=False,
        diffusing=False,
    )
async def run_agent(
    question: str,
    n_queries: int,
    max_results_per_query: int,
    do_verify: bool,
    *,
    reasoning_effort: str,
    stream_answer: bool,
    diffusing: bool,
    reasoning_summary: bool,
    reasoning_summary_wait: bool,
    stream_callback=None,
) -> Dict[str, Any]:
    t0 = time.perf_counter()
    plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
    t1 = time.perf_counter()
    queries = plan.get("queries", [])
    async with aiohttp.ClientSession() as session:
        tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
        lists = await asyncio.gather(*tasks)
    flat = dedupe_results([r for lst in lists for r in lst])
    evidence = pack_evidence(flat, max_items=18)
    t2 = time.perf_counter()
    draft = answer_with_citations(
        question,
        evidence,
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        stream=stream_answer,
        diffusing=diffusing,
        stream_callback=stream_callback,
    )
    t3 = time.perf_counter()
    final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
    t4 = time.perf_counter()
    return {
        "plan": plan,
        "evidence": evidence,
        "answer": final,
        "timings_sec": {
            "expand": round(t1 - t0, 3),
            "search_parallel": round(t2 - t1, 3),
            "synthesize": round(t3 - t2, 3),
            "verify": round(t4 - t3, 3),
            "total": round(t4 - t0, 3),
        },
    }
Este passo conecta quatro estágios centrais:
expand_query() gera um plano de pesquisa estruturado pedindo ao Mercury 2 que retorne JSON estrito contendo queries, subquestions e must_cover. A saída é parseada com mercury_json(), que inclui reparo automático de JSON, e há um conjunto de consultas fallback que garante a continuidade do agente mesmo se o modelo retornar um plano vazio.answer_with_citations() produz a resposta inicial usando apenas as evidências empacotadas na etapa de busca. O prompt restringe explicitamente o modelo às evidências fornecidas e exige citações inline. A saída inclui resposta direta, insights-chave e ressalvas, garantindo objetividade e rastreabilidade às fontes.verify_answer() implementa o padrão Gerar–Criticar–Corrigir. Ela reavalia o rascunho frente às mesmas evidências e remove ou suaviza afirmações sem suporte, preservando os marcadores de citação. Essa passagem adicional reduz generalizações e melhora o respaldo factual com impacto mínimo na latência.run_agent() coordena todo o fluxo: expande o plano de consulta, executa buscas paralelas no DuckDuckGo com aiohttp e asyncio.gather(), remove duplicatas e empacota os resultados em um JSON compacto de evidências, gera a resposta sintetizada e, opcionalmente, executa a verificação. Por fim, vamos conectar o runtime do agente (run_agent) a uma interface Streamlit para que usuários possam digitar uma pergunta, ajustar como o agente busca e inspecionar todo o rastro de execução — resposta final, tempos, plano de consultas gerado e o pacote de evidências.
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
    "Ask a complex question",
    height=120,
    placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
    n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
    max_results = st.slider("Results per query", 1, 6, 2)
with col3:
    do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
    reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
    stream_answer = st.checkbox("Stream answer", value=False)
    diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
    reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
    reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
    if diffusing and not stream_answer:
        st.info("Diffusing requires streaming. Enabling streaming automatically.")
        stream_answer = True
run = st.button("Run agent", type="primary")
if run:
    if not question.strip():
        st.warning("Enter a question.")
        st.stop()
    answer_placeholder = st.empty()
    status_placeholder = st.empty()
    def _stream_cb(text: str, meta: Dict[str, Any]):
        answer_placeholder.markdown(text)
    with st.spinner("Running…"):
        status_placeholder.caption("Planning → searching → synthesizing…")
        out = asyncio.run(
            run_agent(
                question.strip(),
                n_queries,
                max_results,
                do_verify,
                reasoning_effort=reasoning_effort,
                stream_answer=stream_answer,
                diffusing=diffusing,
                reasoning_summary=reasoning_summary,
                reasoning_summary_wait=reasoning_summary_wait,
                stream_callback=_stream_cb if stream_answer else None,
            )
        )
    status_placeholder.empty()
    st.subheader("Answer")
    st.write(out["answer"])
    st.subheader("Timings (sec)")
    st.json(out["timings_sec"])
    with st.expander("Plan (queries / subquestions)"):
        st.json(out["plan"])
    with st.expander("Evidence (search results)"):
        st.json(out["evidence"])
O código acima define como a camada Streamlit transforma a função run_agent() em um fluxo de pesquisa interativo. O usuário insere uma pergunta, controla a amplitude e a profundidade da busca e pode ativar uma verificação que remove alegações sem suporte.
Um painel adicional “Mercury settings” expõe ajustes do modelo como reasoning_effort, saída em streaming e modo diffusing (que exige streaming e atualiza o placeholder da resposta no lugar conforme chegam novos trechos).
Ao executar, o app valida a entrada, transmite a saída parcial em um placeholder e, depois, renderiza a resposta final junto com os tempos e visões de debug expansíveis para o plano gerado e o pacote de evidências.
Para testar, salve o código como app.py e inicie:
streamlit run app.pyNeste tutorial, construímos um agente de pesquisa com consciência de latência, movido pelo Mercury 2. O sistema gera um plano de busca estruturado para a pergunta do usuário, executa a recuperação web em paralelo, normaliza os resultados em um formato compacto de evidências e produz uma resposta fundamentada com citações.
Também adicionamos uma verificação opcional que reanalisa o rascunho com base nas mesmas evidências e suaviza afirmações sem suporte. Esse padrão simples de Gerar–Criticar–Corrigir melhora bastante o respaldo factual com latência mínima.
Além do pipeline central, o aplicativo expõe os controles de runtime do Mercury 2, incluindo esforço de raciocínio, saída em streaming, resumos de raciocínio e modo diffusing. Para estender o projeto, você pode:
Para continuar aprendendo a usar IA em tarefas de desenvolvimento, recomendo o curso AI-Assisted Coding for Developers.
Principais cursos da DataCamp
Programa
Curso
Pratique e programa seu progresso.
Continuar Com O Googleblog
blog
Adel Nehme
15 min
Tutorial
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
12 min
Tutorial
Kurtis Pykes
12 min






