Lernpfad
KI-Agent-Grundlagen
6 Std.
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleMercury 2 ist Inception Labs’ schnelles Reasoning-Modell für produktive Workloads, bei denen sich Latenzen in Agent-Loops, Retrieval-Pipelines und Anwendungen mit hoher Parallelität addieren.
Im Unterschied zu standardmäßigen autoregressiven LLMs, die Token nacheinander decodieren, nutzt Mercury 2 einen diffusionsartigen Generierungsprozess, der Text parallel verfeinert. Das ist der zentrale Grund, warum es bei passender Bereitstellung extrem hohen Durchsatz erreichen kann.
Zu den wichtigsten Fähigkeiten von Mercury 2 gehören:
Mercury 2 stellt eine OpenAI-kompatible API bereit. Du kannst also bestehende OpenAI-Clientbibliotheken verwenden, indem du nur die Basis-URL und den Modellnamen änderst. So lässt sich Mercury 2 ohne SDK- oder Architekturwechsel in bestehende Apps, Agent-Frameworks und Produktionspipelines integrieren.
Das Modell unterstützt ein Kontextfenster von etwa 128K Token und eignet sich damit für Workflows, die große Evidenzpakete, mehrschrittige Tool-Ausgaben, Gesprächsverläufe oder strukturierte Zwischenzustände übergeben müssen.
Mercury 2 verarbeitet schema-gebundenes JSON zuverlässig und unterstützt Tool-Interaktionen. Damit sind Use Cases wie Query-Planung, Tool-Argument-Generierung, strukturierter Zustandsübergang zwischen Schritten und Verifikationspipelines möglich, bei denen deterministisches Format wichtig ist.
Anders als die meisten General-Purpose-Modelle bietet Mercury 2 operationale Regler wie reasoning_effort (von „instant“ bis „high“), optionale Reasoning-Zusammenfassungen, Streaming-Ausgabe und diffusionartiges Streaming. Damit kannst du je nach Pipeline-Schritt das Verhältnis aus Tempo, Tiefe und Interaktivität pro Call steuern.
Die Preisstruktur ist für hochfrequente Workloads optimiert, mit niedrigen Input-Token-Kosten und deutlich rabattierten gecachten Input-Token. Das ist vorteilhaft für Agent-Loops und mehrschrittige Pipelines, in denen Systemprompts und Kontexte über mehrere Modellaufrufe hinweg wiederverwendet werden.
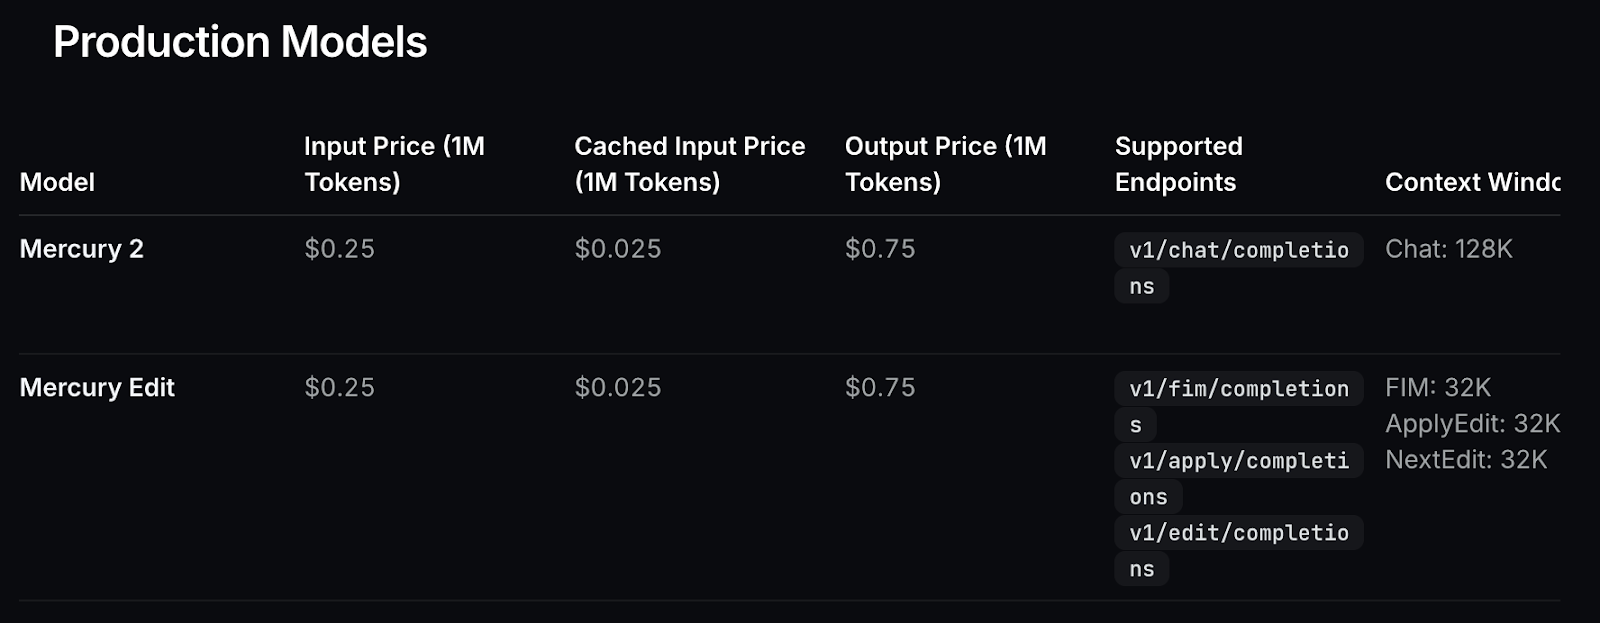
Abbildung: Modellpreise
Traditionelle LLMs generieren Text autoregressiv und produzieren Token der Reihe nach.
token 1 - token 2 - token 3… Damit ist die Latenz eng an die Ausgabelänge gekoppelt, da jeder Token vom vorherigen abhängt. Die Latenz wächst also linear mit der Ausgabelänge. In Agentensystemen, die pro Nutzeranfrage mehrere Modellaufrufe ausführen, wird das zum Flaschenhals.
Mercury 2 geht anders vor. Statt sequentiellem Decoding nutzt es einen diffusionsinspirierten, parallelen Verfeinerungsprozess. Das Modell erzeugt einen ersten Entwurf und verfeinert dann mehrere Token gleichzeitig über wenige Schritte.
Die Generierung ähnelt damit eher iterativem Editieren als Tippen Schritt für Schritt. Das erhöht den Durchsatz und reduziert die End-to-End-Latenz in Pipelines mit mehreren Aufrufen.
Dieser Verfeinerungsprozess ermöglicht auch den Diffusing-Modus, bei dem Zwischendrafts gestreamt und in der UI fortlaufend verbessert werden. Nutzer sehen in Echtzeit, wie sich der Text seiner finalen Form annähert – ideal für Demos, interaktive Anwendungen und Live-Research-Interfaces.
Diese Architektur macht Mercury 2 besonders geeignet für Systeme, in denen sich Latenzen über mehrere Reasoning-Phasen hinweg addieren – statt für One-Shot-Prompts.
In diesem Abschnitt entwickeln wir mit Mercury 2 einen Echtzeit-Research-Assistenten, der eine komplexe Frage aufnehmen, das Web durchsuchen, über mehrere Quellen hinweg schlussfolgern und innerhalb weniger Sekunden eine fundierte Antwort liefern kann. Statt einer einfachen Prompt-Response-Interaktion läuft ein schneller Agenten-Loop mit mehreren Schritten, in dem jede Stufe die Informationen weiter verfeinert, um ein verlässliches Ergebnis zu erzielen.
Auf hoher Ebene erledigt die Anwendung fünf Kernaufgaben:
[S1], [S2].Die Anwendung liefert zwei Hauptausgaben:
Bevor wir den Research-Agenten bauen, brauchen wir Zugriff auf die Mercury-2-API. Da Mercury 2 derzeit über Early Access verfügbar ist, stellst du damit sicher, dass du die nötigen Zugangsdaten und Endpunktkonfigurationen für Inferenzaufrufe aus deiner Anwendung hast.
Hier kannst du Zugang anfragen: https://www.inceptionlabs.ai/early-access.
Sobald dein Account freigeschaltet ist:
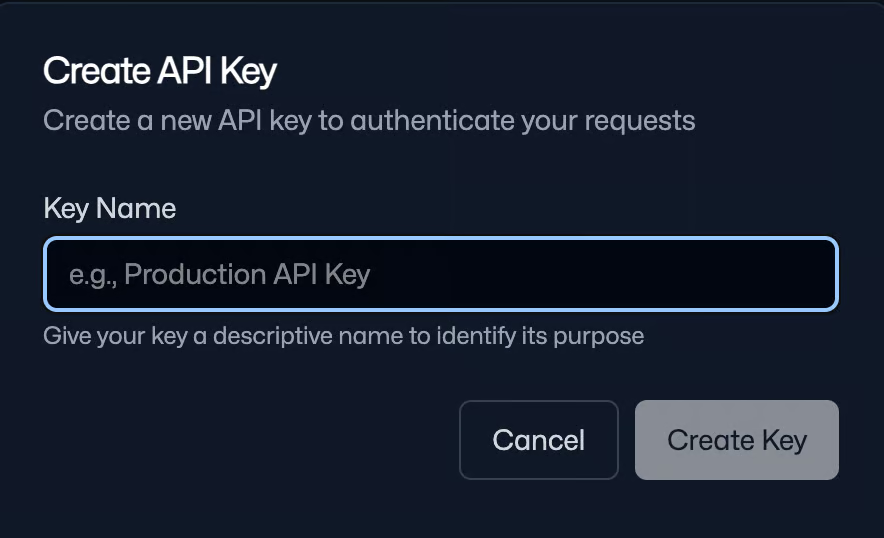
Speichere diesen Key sicher ab. Du nutzt ihn zur Authentifizierung aller API-Requests.
Hinweis: Du erhältst bei der erstmaligen Anmeldung 10.000.000 kostenlose Token – ausreichend für dieses Experiment.
Jetzt, da du API-Zugang hast, bereitest du die lokale Umgebung vor, um den Mercury-2-Research-Agenten zu entwickeln und auszuführen. Da die Inception-API OpenAI-kompatibel ist, können wir den Standard-OpenAI-Python-Client zusammen mit Bibliotheken für Weboberfläche und Suchpipeline nutzen. Außerdem speichern wir unseren API-Key als Umgebungsvariable.
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”
Wir installieren die Kernabhängigkeiten für den Mercury-2-Research-Agenten und konfigurieren den sicheren API-Zugang. Für Modellaufrufe nutzen wir den Standard-OpenAI-Client, Streamlit für die interaktive Oberfläche, aiohttp für parallele Websuche mit geringer Latenz und beautifulsoup4 mit lxml zum Parsen der Suchergebnisse.
Nach der Installation setzt du deinen INCEPTION_API_KEY als Umgebungsvariable, um Zugangsdaten zu schützen und der Anwendung die automatische Authentifizierung zur Laufzeit zu ermöglichen.
Im nächsten Schritt implementieren wir den Mercury-Client und bauen die zentrale Multi-Step-Agentenpipeline.
In diesem Schritt verdrahten wir drei Dinge: die zu verwendenden Bibliotheken importieren, den API-Key sicher aus der Umgebung laden und einen OpenAI-Client mit Inceptions Basis-URL initialisieren.
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
    st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
    st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)
Der obige Code initialisiert einen Mercury-2-Client und importiert den Supporting-Stack für die Anwendung, darunter Streamlit für die UI, aiohttp für asynchrone Webrequests, BeautifulSoup zum Parsen der Suchergebnisse sowie Standard-Python-Utilities für JSON, Timing und Datenstrukturen.
Anschließend lesen wir den INCEPTION_API_KEY aus der Umgebungsvariable. Die Inception-Basis-URL wird gesetzt, um Requests korrekt zu routen, und der Modellname auf "mercury-2", sodass alle folgenden Aufrufe das gewünschte Reasoning-Modell nutzen.
Zum Schluss initialisieren wir den OpenAI-Client mit der Custom-Base-URL, sodass Mercury 2 über die Standard-chat.completions-Schnittstelle angesprochen werden kann.
Als Nächstes brauchen wir einen Retrieval-Schritt, der frische Informationen aus dem Web holen kann. In diesem Tutorial implementieren wir ein Suchtool über DuckDuckGos HTML-Endpunkt und parsen die Ergebnisse direkt. Das erfordert keine zusätzlichen API-Keys und ist schnell genug fürs Prototyping.
Auf hoher Ebene implementieren wir drei Dinge:
SearchResult-Format parsenDDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceDie obigen Utilities definieren vier Schlüsselfunktionen:
ddg_search() fragt DuckDuckGos HTML-Endpunkt mit aiohttp ab und parst die Antwort mit BeautifulSoup und lxml. Jede Fundstelle wird strukturiert extrahiert, und nach max_results Einträgen wird gestoppt, um Latenz niedrig zu halten. So lassen sich mehrere Suchen parallel und asynchron ausführen.clean_text() entfernt überflüssige Whitespaces und Formatierungsartefakte, damit Snippets kompakt und lesbar bleiben. Ergebnisse werden mit der Dataklasse SearchResult gespeichert, um spätere Schritte von der Roh-HTML-Struktur zu entkoppeln.dedupe_results() entfernt Duplikate durch URL-Normalisierung, damit die Evidenz vielfältig bleibt und effizient ins Kontextfenster passt.pack_evidence() wandelt Ergebnisse in ein kompaktes JSON mit stabilen IDs um. Snippets werden auf ~320 Zeichen gekürzt, damit die kombinierte Evidenz in den Kontext des Modells passt und später über Inline-Zitate referenziert werden kann.Für eine produktionsreife Variante ersetze dies durch eine stabile Search-API (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search usw.) und lasse den Rest des Agenten unverändert.
Als Nächstes verbinden wir diese Retrieval-Schicht mit Mercury 2, damit das Modell Suchanfragen erzeugen, über die gesammelte Evidenz schlussfolgern und eine quellengestützte Antwort produzieren kann.
In diesem Schritt kapseln wir Mercury 2 hinter einer kleinen, wiederverwendbaren Schnittstelle, die sowohl strikt strukturierte Ausgaben (für Planung) als auch gestreamte Textgenerierung (für Synthese und das Diffusing-Demo) unterstützt.
Ziel ist, jeden Modellaufruf konsistent zu halten und zugleich Mercury’s „Reasoning-Regler“ und Streaming-Modi über ein einziges Settings-Objekt verfügbar zu machen.
def mercury_settings(
    reasoning_effort: str = "medium",
    reasoning_summary: bool = False,
    reasoning_summary_wait: bool = False,
    diffusing: bool = False,
) -> Dict[str, Any]:
    return {
        "reasoning_effort": reasoning_effort,
        "reasoning_summary": reasoning_summary,
        "reasoning_summary_wait": reasoning_summary_wait,
        "diffusing": diffusing,
    }

def mercury_json(
    system: str,
    user: str,
    max_tokens: int = 400,
    reasoning_effort: str = "medium",
) -> Dict[str, Any]:
    def _call(messages) -> str:
        resp = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            max_tokens=max_tokens,
            temperature=0.0,
            stream=False,
            extra_settings=mercury_settings(
                reasoning_effort=reasoning_effort,
                reasoning_summary=False,
                reasoning_summary_wait=False,
                diffusing=False,
            ),
        )
        return (resp.choices[0].message.content or "").strip()

    text = _call(
        [{"role": "system", "content": system}, {"role": "user", "content": user}]
    )
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        pass
    m = re.search(r"\{.*\}", text, flags=re.DOTALL)
    if m:
        try:
            return json.loads(m.group(0))
        except json.JSONDecodeError:
            pass
    repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
    repair_user = (
        "Fix the following so it is valid JSON and matches the required schema.\n\n"
        "REQUIRED SCHEMA:\n"
        "{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
        "BROKEN OUTPUT:\n"
        f"{text}"
    )
    fixed = _call(
        [{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
    )
    try:
        return json.loads(fixed)
    except json.JSONDecodeError:
        m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
        if not m2:
            raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
        return json.loads(m2.group(0))

def mercury_text(
    system: str,
    user: str,
    max_tokens: int = 950,
    temperature: float = 0.3,
    reasoning_effort: str = "medium",
    reasoning_summary: bool = False,
    reasoning_summary_wait: bool = False,
    stream: bool = False,
    diffusing: bool = False,
    stream_callback=None,
) -> str:
    if diffusing:
        stream = True
    extra_settings = mercury_settings(
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        diffusing=diffusing,
    )
    messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
    if not stream:
        resp = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            max_tokens=max_tokens,
            temperature=temperature,
            stream=False,
            extra_settings=extra_settings,
        )
        return (resp.choices[0].message.content or "").strip()
    full = ""
    stream_resp = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=max_tokens,
        temperature=temperature,
        stream=True,
        extra_settings=extra_settings,
    )
    for event in stream_resp:
        choices = getattr(event, "choices", None) or []
        if not choices:
            continue
        delta = getattr(choices[0], "delta", None)
        chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
        if not chunk:
            continue
        if diffusing:
            full = chunk
        else:
            full += chunk
        if stream_callback:
            stream_callback(full, {"delta": chunk})
    return full.strip()
Hier definieren wir Helper-Funktionen mit drei Kernkomponenten:
mercury_settings() bündelt Mercury-spezifische Parameter wie reasoning_effort, reasoning_summary, reasoning_summary_wait und diffusing. So bleibt die Pipeline konsistent, und Streamlit-Schalter lassen sich ohne doppelte Konfiguration in jeden Modellaufruf durchreichen.mercury_json() wird verwendet, wenn der Agent strukturierte Ausgaben braucht. Es läuft mit temperature=0.0 und deaktiviert Streaming/Diffusion für maximale Formatstabilität. Die Funktion versucht zuerst direktes JSON-Parsing, extrahiert bei Bedarf per Regex einen JSON-Block und fällt notfalls auf einen Reparaturdurchlauf zurück, der gültiges JSON im geforderten Schema erzwingt.mercury_text() unterstützt sowohl Non-Streaming- als auch Streaming-Modus. Bei diffusing=True wird stream=True erzwungen und der angezeigte Text durch Überschreiben des aktuellen Buffers aktualisiert. Im normalen Streaming werden Deltas angehängt. Der optionale stream_callback() erlaubt Live-Rendering in der UI.Im nächsten Schritt nutzen wir diese Helper, um die strukturierte Query-Erweiterung zu implementieren und sie mit der Websuche und dem Evidenz-Packing zu verbinden.
Jetzt verbinden wir Mercury 2 und Websuche zu einem End-to-End-Research-Loop. Die Kernidee: Zuerst einen strukturierten Suchplan erzeugen und dann die finale Antwort strikt an die Evidenz koppeln – so werden Mercurys Reasoning-Regler und Streaming/Diffusing-Modi in der UI sichtbar.
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
    system = (
        "Return ONLY valid JSON. No markdown.\n"
        "Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
        "Rules:\n"
        f"- MUST produce at least {max(3, n_queries-2)} queries\n"
        "- queries <= 12 words, diverse\n"
        "- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
        "Output must start with '{' and end with '}'."
    )
    user = f"Question: {question}\nReturn {n_queries} queries."
    out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
    queries = (out.get("queries") or [])
    subqs = (out.get("subquestions") or [])
    must = (out.get("must_cover") or [])
    if len(queries) == 0:
        queries = [
            f"{question} benchmarks",
            "vLLM edge inference benchmarks",
            "llama.cpp edge inference benchmarks",
            "vLLM vs llama.cpp quantization",
            "llama.cpp Metal CUDA Vulkan performance",
            "vLLM KV cache paged attention memory",
        ][:n_queries]
    out["queries"] = queries[:n_queries]
    out["subquestions"] = subqs[: min(6, n_queries)]
    out["must_cover"] = must[:6]
    return out
def answer_with_citations(
    question: str,
    evidence: List[Dict[str, str]],
    *,
    reasoning_effort: str,
    reasoning_summary: bool,
    reasoning_summary_wait: bool,
    stream: bool,
    diffusing: bool,
    stream_callback=None,
) -> str:
    system = (
        "You are a fast research synthesizer.\n"
        "Use ONLY the provided evidence.\n"
        "Add inline citations like [S1], [S2] using evidence ids.\n"
        "If evidence is insufficient, say what's missing."
    )
    user = (
        f"Question:\n{question}\n\n"
        f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
        "Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
    )
    return mercury_text(
        system,
        user,
        max_tokens=950,
        temperature=0.3,
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        stream=stream,
        diffusing=diffusing,
        stream_callback=stream_callback,
    )
def verify_answer(
    question: str,
    evidence: List[Dict[str, str]],
    draft: str,
    *,
    reasoning_effort: str,
) -> str:
    system = (
        "You are a verifier.\n"
        "Remove/soften any claim not supported by evidence.\n"
        "Keep citations [S#]. Return revised answer."
    )
    user = (
        f"Question:\n{question}\n\n"
        f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
        f"Draft:\n{draft}"
    )
    return mercury_text(
        system,
        user,
        max_tokens=950,
        temperature=0.2,
        reasoning_effort=reasoning_effort,
        reasoning_summary=False,
        reasoning_summary_wait=False,
        stream=False,
        diffusing=False,
    )
async def run_agent(
    question: str,
    n_queries: int,
    max_results_per_query: int,
    do_verify: bool,
    *,
    reasoning_effort: str,
    stream_answer: bool,
    diffusing: bool,
    reasoning_summary: bool,
    reasoning_summary_wait: bool,
    stream_callback=None,
) -> Dict[str, Any]:
    t0 = time.perf_counter()
    plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
    t1 = time.perf_counter()
    queries = plan.get("queries", [])
    async with aiohttp.ClientSession() as session:
        tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
        lists = await asyncio.gather(*tasks)
    flat = dedupe_results([r for lst in lists for r in lst])
    evidence = pack_evidence(flat, max_items=18)
    t2 = time.perf_counter()
    draft = answer_with_citations(
        question,
        evidence,
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        stream=stream_answer,
        diffusing=diffusing,
        stream_callback=stream_callback,
    )
    t3 = time.perf_counter()
    final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
    t4 = time.perf_counter()
    return {
        "plan": plan,
        "evidence": evidence,
        "answer": final,
        "timings_sec": {
            "expand": round(t1 - t0, 3),
            "search_parallel": round(t2 - t1, 3),
            "synthesize": round(t3 - t2, 3),
            "verify": round(t4 - t3, 3),
            "total": round(t4 - t0, 3),
        },
    }
Dieser Schritt verbindet vier Kernphasen:
expand_query() erzeugt einen strukturierten Research-Plan, indem Mercury 2 striktes JSON mit queries, subquestions und must_cover zurückgibt. Das Ergebnis wird mit mercury_json() geparst, inklusive automatischer JSON-Reparatur sowie eines Fallback-Query-Sets, damit der Agent weiterläuft, falls das Modell einen leeren Plan liefert.answer_with_citations() erzeugt die erste Antwort ausschließlich aus der gepackten Evidenz der Suchphase. Der Prompt beschränkt das Modell explizit auf die bereitgestellte Evidenz und verlangt Inline-Zitate. Die Ausgabe enthält eine direkte Antwort, Kern-Insights und Einschränkungen – knapp und auf Quellen rückführbar.verify_answer() implementiert das Generate–Critique–Fix-Muster. Es bewertet den Entwurf erneut gegen dieselbe Evidenz und entfernt oder relativiert ungestützte Aussagen – Zitatmarker bleiben erhalten. Dieser zusätzliche Schritt reduziert Überverallgemeinerung und verbessert Faktentreue bei minimalem Latenz-Overhead.run_agent() koordiniert den gesamten Ablauf: Query-Plan erweitern, parallele DuckDuckGo-Suchen mit aiohttp und asyncio.gather() ausführen, Ergebnisse deduplizieren und in kompaktes Evidence-JSON packen, die Antwort synthetisieren und optional verifizieren.Zum Schluss verbinden wir die Agenten-Laufzeit (run_agent) mit einer Streamlit-Oberfläche, damit Nutzer Fragen eingeben, die Agentsuche steuern und die gesamte Ausführung inspizieren können – finale Antwort, Timings, erzeugter Suchplan und Evidenzpaket.
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
    "Ask a complex question",
    height=120,
    placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
    n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
    max_results = st.slider("Results per query", 1, 6, 2)
with col3:
    do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
    reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
    stream_answer = st.checkbox("Stream answer", value=False)
    diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
    reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
    reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
    if diffusing and not stream_answer:
        st.info("Diffusing requires streaming. Enabling streaming automatically.")
        stream_answer = True
run = st.button("Run agent", type="primary")
if run:
    if not question.strip():
        st.warning("Enter a question.")
        st.stop()
    answer_placeholder = st.empty()
    status_placeholder = st.empty()
    def _stream_cb(text: str, meta: Dict[str, Any]):
        answer_placeholder.markdown(text)
    with st.spinner("Running…"):
        status_placeholder.caption("Planning → searching → synthesizing…")
        out = asyncio.run(
            run_agent(
                question.strip(),
                n_queries,
                max_results,
                do_verify,
                reasoning_effort=reasoning_effort,
                stream_answer=stream_answer,
                diffusing=diffusing,
                reasoning_summary=reasoning_summary,
                reasoning_summary_wait=reasoning_summary_wait,
                stream_callback=_stream_cb if stream_answer else None,
            )
        )
    status_placeholder.empty()
    st.subheader("Answer")
    st.write(out["answer"])
    st.subheader("Timings (sec)")
    st.json(out["timings_sec"])
    with st.expander("Plan (queries / subquestions)"):
        st.json(out["plan"])
    with st.expander("Evidence (search results)"):
        st.json(out["evidence"])
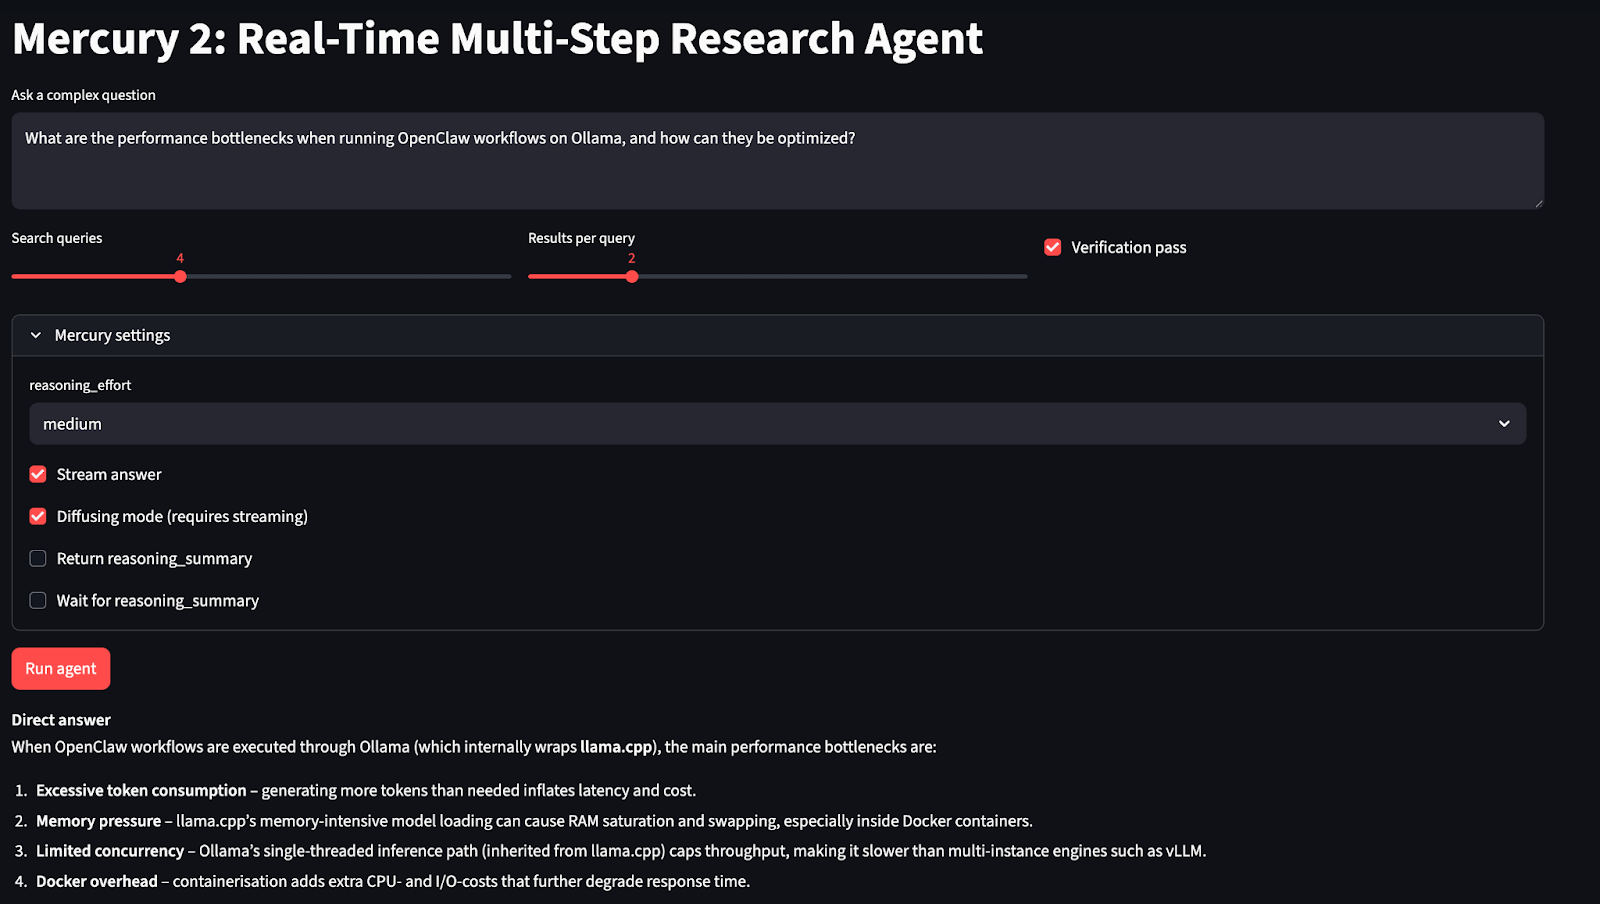
Der obige Code zeigt, wie die Streamlit-Schicht die Funktion run_agent() in einen interaktiven Research-Workflow verwandelt. Nutzer geben eine Frage ein, steuern Breite und Tiefe der Suche und können optional eine Verifikation aktivieren, die unbelegte Aussagen entfernt.
Ein zusätzliches Panel „Mercury settings“ exponiert Modellregler wie reasoning_effort, streaming-Ausgabe und diffusing-Modus. Letzterer setzt Streaming voraus und aktualisiert den Antwortplatzhalter in-place, sobald neue Chunks eintreffen.
Beim Start validiert die App die Eingabe, streamt Teilantworten in einen Platzhalter und rendert anschließend die finale Antwort samt Timings sowie aufklappbaren Debug-Ansichten für Plan und Evidenzpaket.
Um es selbst auszuprobieren, speichere den Code als app.py und starte:
streamlit run app.pyIn diesem Tutorial haben wir einen latenzbewussten Research-Agenten mit Mercury 2 gebaut. Das System erzeugt einen strukturierten Suchplan zu einer Nutzerfrage, führt parallele Webabfragen aus, normalisiert Ergebnisse in ein kompaktes Evidenzformat und produziert eine quellengestützte Antwort mit Zitaten.
Außerdem haben wir einen optionalen Verifikationsdurchlauf ergänzt, der den Entwurf gegen dieselbe Evidenz prüft und unbelegte Aussagen abschwächt. Dieses einfache Generate–Critique–Fix-Muster verbessert die Faktentreue deutlich – bei minimalem Latenzaufschlag.
Über die Kernpipeline hinaus macht die Anwendung die Laufzeitregler von Mercury 2 sichtbar – inklusive Reasoning-Tiefe, Streaming-Ausgabe, Reasoning-Zusammenfassungen und Diffusing-Modus. Um das Projekt weiter auszubauen, könntest du:
Wenn du weiter lernen willst, wie du KI für Entwicklungstätigkeiten nutzt, empfehle ich den Kurs AI-Assisted Coding for Developers.
Top DataCamp Courses
Lernpfad
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Allan Ouko
7 Min.