Programa
Fundamentos de agentes de IA
6 h
Practica y programa tu progreso.
Continuar Con GoogleMercury 2 es el modelo de razonamiento rápido de Inception Labs, pensado para cargas de trabajo en producción donde la latencia se acumula en bucles de agentes, canalizaciones de recuperación y aplicaciones con alta concurrencia.
A diferencia de los LLM autorregresivos estándar que decodifican un token cada vez, Mercury 2 utiliza un proceso de generación tipo difusión que refina el texto en paralelo, lo que explica que pueda lograr un rendimiento muy alto con la configuración adecuada de serving.
Las capacidades clave de Mercury 2 incluyen:
Mercury 2 expone una API compatible con OpenAI, lo que significa que puedes usar las librerías cliente existentes de OpenAI cambiando solo la URL base y el nombre del modelo. Así puede integrarse en aplicaciones, frameworks de agentes y canalizaciones de producción sin cambios de SDK ni de arquitectura.
El modelo admite una ventana de contexto de alrededor de 128K tokens, ideal para flujos que necesitan pasar grandes paquetes de evidencia, salidas de herramientas en múltiples pasos, trazas de conversación o estados intermedios estructurados.
Mercury 2 maneja JSON con restricciones de esquema de forma fiable y admite interacciones tipo herramienta. Esto habilita casos como planificación de consultas, generación de argumentos para herramientas, traspaso de estado estructurado entre pasos y canalizaciones de verificación donde el formato determinista importa.
A diferencia de la mayoría de modelos generalistas, Mercury 2 expone controles operativos como reasoning_effort (de instant a high), resúmenes de razonamiento opcionales, salida en streaming y streaming tipo difusión. Estos ajustes te permiten equilibrar velocidad, profundidad e interactividad en cada llamada según la etapa de la canalización.
La estructura de precios está optimizada para cargas de alta frecuencia, con costes bajos por tokens de entrada y descuentos significativos para tokens de entrada en caché. Es especialmente útil en bucles de agentes y canalizaciones multipaso donde se reutilizan prompts de sistema y contexto en varias llamadas al modelo.
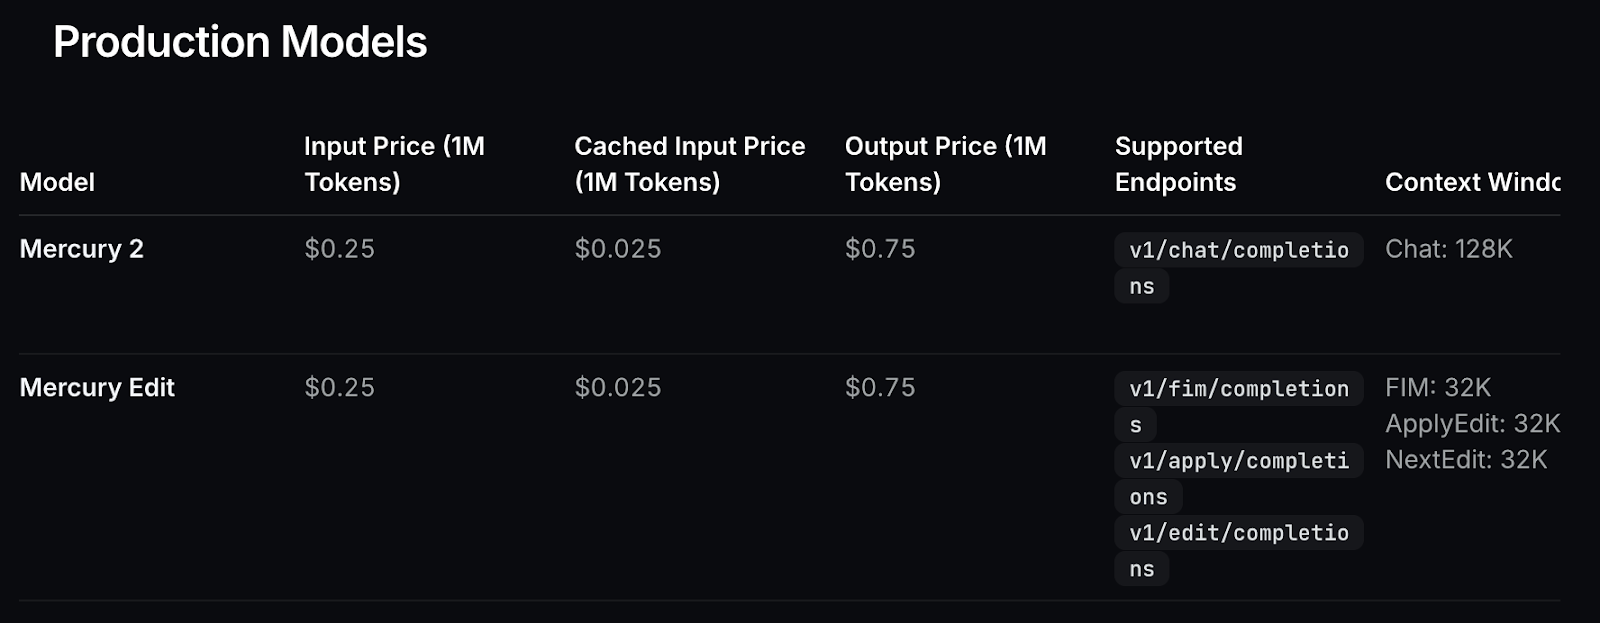
Figura: precios del modelo
Los LLM tradicionales generan texto de forma autorregresiva, produciendo un token cada vez en secuencia.
token 1 - token 2 - token 3… Esto acopla estrechamente la latencia a la longitud de la salida, ya que cada token depende del anterior, por lo que la latencia crece linealmente con la longitud. Se convierte en un cuello de botella en sistemas de agentes donde puedes ejecutar varias llamadas al modelo por petición de usuario.
Mercury 2 adopta otro enfoque. En lugar de decodificación secuencial, utiliza un proceso de refinamiento paralelo inspirado en difusión. El modelo genera un borrador inicial y después refina varios tokens simultáneamente en pocas iteraciones.
La generación se comporta más como una edición iterativa que como una escritura paso a paso, lo que mejora el rendimiento y reduce la latencia extremo a extremo en canalizaciones con múltiples llamadas.
Este proceso de refinamiento también habilita el modo diffusing, donde se emiten borradores intermedios y se mejoran progresivamente en la UI. Los usuarios pueden ver cómo el texto evoluciona hacia su forma final en tiempo real, muy útil para demos, apps interactivas e interfaces de investigación en vivo.
Esta arquitectura hace que Mercury 2 sea ideal para sistemas donde la latencia se acumula a lo largo de varias etapas de razonamiento, más que en prompts de una sola tirada.
En esta sección, crearemos un asistente de investigación en tiempo real con Mercury 2 capaz de tomar una pregunta compleja, buscar en la web, razonar a través de varias fuentes y devolver una respuesta fundamentada en pocos segundos. En lugar de una interacción de prompt-respuesta única, el sistema ejecuta un bucle de agente rápido y multipaso, donde cada etapa refina la información necesaria para obtener un resultado fiable.
A alto nivel, la aplicación realiza cinco tareas clave:
[S1], [S2].La aplicación produce dos salidas principales:
Antes de construir el agente de investigación, necesitamos acceso a la API de Mercury 2. Como Mercury 2 está disponible mediante acceso anticipado, este paso garantiza que tengas las credenciales y la configuración del endpoint para hacer inferencias desde tu aplicación.
Puedes solicitar acceso aquí: https://www.inceptionlabs.ai/early-access.
Una vez aprobado tu acceso:
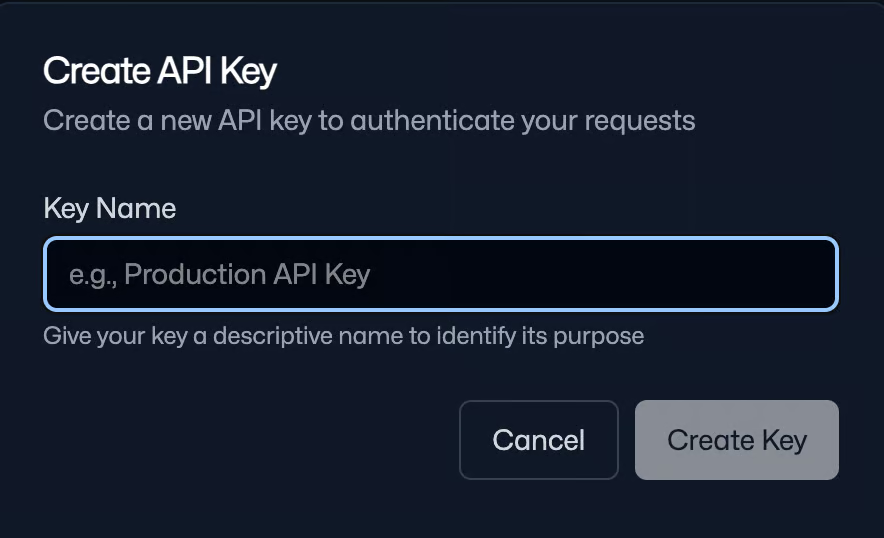
Guarda esta clave de forma segura: la usarás para autenticar todas las solicitudes a la API.
Nota: recibirás 10.000.000 de tokens gratis al registrarte, suficientes para este experimento.
Ahora que tienes acceso a la API, el siguiente paso es preparar el entorno local para crear y ejecutar el agente de investigación con Mercury 2. Como la API de Inception es compatible con OpenAI, podemos usar el cliente estándar de OpenAI en Python junto con un conjunto de librerías para la interfaz web y la canalización de búsqueda. También guardamos la clave de la API como variable de entorno.
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”
Instalamos las dependencias necesarias para ejecutar el agente de investigación con Mercury 2 y configuramos el acceso seguro a la API. Usamos el cliente estándar de OpenAI para las llamadas al modelo, Streamlit para construir la interfaz interactiva, aiohttp para ejecutar búsquedas web en paralelo con baja latencia, y beautifulsoup4 con lxml para parsear resultados de búsqueda.
Después de instalar los paquetes, define INCEPTION_API_KEY como variable de entorno para proteger las credenciales y permitir que la app se autentique automáticamente en tiempo de ejecución.
En el siguiente paso, implementaremos el cliente de Mercury y construiremos la canalización principal del agente multipaso.
Este paso conecta tres cosas: importar las librerías que usaremos en la app, cargar la clave de la API de forma segura desde el entorno e inicializar un cliente de OpenAI apuntando a la URL base de Inception.
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
    st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
    st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)
Este fragmento inicializa el cliente de Mercury 2 e importa el stack de soporte de la aplicación: Streamlit para la UI, aiohttp para peticiones web asíncronas, BeautifulSoup para parsear resultados y utilidades estándar de Python para manejar JSON, tiempos y estructuras de datos.
Leemos INCEPTION_API_KEY desde la variable de entorno, configuramos la URL base de Inception para enrutar bien las solicitudes y establecemos el nombre del modelo "mercury-2" para que todas las llamadas usen el modelo de razonamiento previsto.
Por último, el cliente de OpenAI se inicializa con la URL base personalizada, lo que permite llamar a Mercury 2 usando la interfaz estándar de chat.completions.
Ahora necesitamos un paso de recuperación que obtenga información actualizada de la web. En este tutorial, implementaremos una herramienta de búsqueda usando el endpoint HTML de DuckDuckGo y parsearemos los resultados directamente, porque no requiere claves de API adicionales y es lo suficientemente rápido para prototipos.
A alto nivel, implementamos tres cosas:
SearchResultDDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceEstas utilidades definen cuatro componentes clave:
ddg_search() consulta el endpoint HTML de DuckDuckGo con aiohttp y parsea la respuesta con BeautifulSoup y lxml. Cada resultado se extrae a un formato estructurado y la función se detiene tras max_results entradas para mantener baja la latencia. Esto permite ejecutar múltiples búsquedas en paralelo de forma asíncrona.clean_text() elimina espacios y artefactos para que los fragmentos queden compactos y legibles. Los resultados se almacenan con la dataclass SearchResult, que estandariza la salida y desacopla las etapas posteriores del HTML bruto.dedupe_results() quita duplicados normalizando URLs, para que el conjunto de evidencia sea diverso y eficiente dentro de la ventana de contexto.pack_evidence() convierte los resultados en un JSON compacto con identificadores estables. Los fragmentos se recortan a ~320 caracteres para que la evidencia combinada quepa en el contexto del modelo y pueda referenciarse con citas en línea.Si necesitas producción, sustituye esto por una Search API estable (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search, etc.) y deja el resto del agente sin cambios.
A continuación, conectaremos esta capa de recuperación con Mercury 2 para que el modelo genere consultas, razone sobre la evidencia recopilada y produzca una respuesta fundamentada en fuentes.
En este paso, encapsulamos Mercury 2 tras una pequeña interfaz reutilizable que admite salidas estrictamente estructuradas (para la planificación) y generación de texto en streaming (para la síntesis y la demo de difusión).
El objetivo es mantener consistentes todas las llamadas al modelo, a la vez que exponemos los “controles de razonamiento” y los modos de streaming de Mercury a través de un único objeto de configuración.
def mercury_settings(
    reasoning_effort: str = "medium",
    reasoning_summary: bool = False,
    reasoning_summary_wait: bool = False,
    diffusing: bool = False,
) -> Dict[str, Any]:
    return {
        "reasoning_effort": reasoning_effort,
        "reasoning_summary": reasoning_summary,
        "reasoning_summary_wait": reasoning_summary_wait,
        "diffusing": diffusing,
    }

def mercury_json(
    system: str,
    user: str,
    max_tokens: int = 400,
    reasoning_effort: str = "medium",
) -> Dict[str, Any]:
    def _call(messages) -> str:
        resp = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            max_tokens=max_tokens,
            temperature=0.0,
            stream=False,
            extra_settings=mercury_settings(
                reasoning_effort=reasoning_effort,
                reasoning_summary=False,
                reasoning_summary_wait=False,
                diffusing=False,
            ),
        )
        return (resp.choices[0].message.content or "").strip()

    text = _call(
        [{"role": "system", "content": system}, {"role": "user", "content": user}]
    )
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        pass
    m = re.search(r"\{.*\}", text, flags=re.DOTALL)
    if m:
        try:
            return json.loads(m.group(0))
        except json.JSONDecodeError:
            pass
    repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
    repair_user = (
        "Fix the following so it is valid JSON and matches the required schema.\n\n"
        "REQUIRED SCHEMA:\n"
        "{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
        "BROKEN OUTPUT:\n"
        f"{text}"
    )
    fixed = _call(
        [{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
    )
    try:
        return json.loads(fixed)
    except json.JSONDecodeError:
        m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
        if not m2:
            raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
        return json.loads(m2.group(0))

def mercury_text(
    system: str,
    user: str,
    max_tokens: int = 950,
    temperature: float = 0.3,
    reasoning_effort: str = "medium",
    reasoning_summary: bool = False,
    reasoning_summary_wait: bool = False,
    stream: bool = False,
    diffusing: bool = False,
    stream_callback=None,
) -> str:
    if diffusing:
        stream = True
    extra_settings = mercury_settings(
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        diffusing=diffusing,
    )
    messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
    if not stream:
        resp = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            max_tokens=max_tokens,
            temperature=temperature,
            stream=False,
            extra_settings=extra_settings,
        )
        return (resp.choices[0].message.content or "").strip()
    full = ""
    stream_resp = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=max_tokens,
        temperature=temperature,
        stream=True,
        extra_settings=extra_settings,
    )
    for event in stream_resp:
        choices = getattr(event, "choices", None) or []
        if not choices:
            continue
        delta = getattr(choices[0], "delta", None)
        chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
        if not chunk:
            continue
        if diffusing:
            full = chunk
        else:
            full += chunk
        if stream_callback:
            stream_callback(full, {"delta": chunk})
    return full.strip()
Aquí definimos funciones auxiliares con tres componentes clave:
mercury_settings() centraliza parámetros específicos de Mercury como reasoning_effort, reasoning_summary, reasoning_summary_wait y diffusing. Mantiene la canalización coherente y facilita conectar los toggles de Streamlit a cada llamada sin duplicar configuración.mercury_json() se usa cuando el agente necesita salidas estructuradas. Corre con temperature=0.0 y desactiva streaming/diffusion para maximizar la estabilidad del formato. Intenta parsear JSON directamente, luego extraer un bloque con regex y, si falla, realiza una pasada de reparación para forzar JSON válido con el esquema requerido.mercury_text() admite modos sin streaming y con streaming. Si diffusing=True, fuerza stream=True y actualiza el texto sobrescribiendo el buffer; en streaming normal, agrega deltas. El hook opcional stream_callback() permite a la UI renderizar actualizaciones en vivo.En el siguiente paso, usaremos estos helpers para implementar la expansión estructurada de consultas y conectarla con la búsqueda web y el empaquetado de evidencias.
Ahora conectamos Mercury 2 y la búsqueda web en un bucle de investigación de extremo a extremo. La idea clave es generar primero un plan de búsqueda estructurado y luego forzar que la respuesta final se base en el paquete de evidencias, para mostrar los controles de razonamiento de Mercury y los modos de streaming/diffusing en la UI.
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
    system = (
        "Return ONLY valid JSON. No markdown.\n"
        "Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
        "Rules:\n"
        f"- MUST produce at least {max(3, n_queries-2)} queries\n"
        "- queries <= 12 words, diverse\n"
        "- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
        "Output must start with '{' and end with '}'."
    )
    user = f"Question: {question}\nReturn {n_queries} queries."
    out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
    queries = (out.get("queries") or [])
    subqs = (out.get("subquestions") or [])
    must = (out.get("must_cover") or [])
    if len(queries) == 0:
        queries = [
            f"{question} benchmarks",
            "vLLM edge inference benchmarks",
            "llama.cpp edge inference benchmarks",
            "vLLM vs llama.cpp quantization",
            "llama.cpp Metal CUDA Vulkan performance",
            "vLLM KV cache paged attention memory",
        ][:n_queries]
    out["queries"] = queries[:n_queries]
    out["subquestions"] = subqs[: min(6, n_queries)]
    out["must_cover"] = must[:6]
    return out
def answer_with_citations(
    question: str,
    evidence: List[Dict[str, str]],
    *,
    reasoning_effort: str,
    reasoning_summary: bool,
    reasoning_summary_wait: bool,
    stream: bool,
    diffusing: bool,
    stream_callback=None,
) -> str:
    system = (
        "You are a fast research synthesizer.\n"
        "Use ONLY the provided evidence.\n"
        "Add inline citations like [S1], [S2] using evidence ids.\n"
        "If evidence is insufficient, say what's missing."
    )
    user = (
        f"Question:\n{question}\n\n"
        f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
        "Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
    )
    return mercury_text(
        system,
        user,
        max_tokens=950,
        temperature=0.3,
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        stream=stream,
        diffusing=diffusing,
        stream_callback=stream_callback,
    )
def verify_answer(
    question: str,
    evidence: List[Dict[str, str]],
    draft: str,
    *,
    reasoning_effort: str,
) -> str:
    system = (
        "You are a verifier.\n"
        "Remove/soften any claim not supported by evidence.\n"
        "Keep citations [S#]. Return revised answer."
    )
    user = (
        f"Question:\n{question}\n\n"
        f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
        f"Draft:\n{draft}"
    )
    return mercury_text(
        system,
        user,
        max_tokens=950,
        temperature=0.2,
        reasoning_effort=reasoning_effort,
        reasoning_summary=False,
        reasoning_summary_wait=False,
        stream=False,
        diffusing=False,
    )
async def run_agent(
    question: str,
    n_queries: int,
    max_results_per_query: int,
    do_verify: bool,
    *,
    reasoning_effort: str,
    stream_answer: bool,
    diffusing: bool,
    reasoning_summary: bool,
    reasoning_summary_wait: bool,
    stream_callback=None,
) -> Dict[str, Any]:
    t0 = time.perf_counter()
    plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
    t1 = time.perf_counter()
    queries = plan.get("queries", [])
    async with aiohttp.ClientSession() as session:
        tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
        lists = await asyncio.gather(*tasks)
    flat = dedupe_results([r for lst in lists for r in lst])
    evidence = pack_evidence(flat, max_items=18)
    t2 = time.perf_counter()
    draft = answer_with_citations(
        question,
        evidence,
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        stream=stream_answer,
        diffusing=diffusing,
        stream_callback=stream_callback,
    )
    t3 = time.perf_counter()
    final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
    t4 = time.perf_counter()
    return {
        "plan": plan,
        "evidence": evidence,
        "answer": final,
        "timings_sec": {
            "expand": round(t1 - t0, 3),
            "search_parallel": round(t2 - t1, 3),
            "synthesize": round(t3 - t2, 3),
            "verify": round(t4 - t3, 3),
            "total": round(t4 - t0, 3),
        },
    }
Este paso conecta cuatro etapas clave:
expand_query() genera un plan de investigación estructurado pidiendo a Mercury 2 un JSON estricto con queries, subquestions y must_cover. El resultado se parsea con mercury_json(), que incorpora reparación automática de JSON, y un conjunto de consultas de reserva por si el modelo devuelve un plan vacío.answer_with_citations() produce la respuesta inicial usando solo la evidencia empaquetada de la etapa de búsqueda. El prompt restringe explícitamente al modelo a la evidencia proporcionada y exige citas en línea. La salida incluye respuesta directa, ideas clave y limitaciones, garantizando concisión y trazabilidad a fuentes.verify_answer() implementa el patrón Generar–Criticar–Corregir. Reevalúa el borrador con la misma evidencia y elimina o matiza lo no sustentado, preservando las marcas de cita. Esta pasada adicional reduce generalizaciones y mejora el anclaje factual con una sobrecarga mínima de latencia.run_agent() coordina todo el flujo: expansión del plan, ejecución de búsquedas paralelas en DuckDuckGo con aiohttp y asyncio.gather(), eliminación de duplicados y empaquetado de resultados en un JSON de evidencias compacto, generación de la respuesta sintetizada y verificación opcional. Por último, conectaremos la ejecución del agente (run_agent) con una interfaz en Streamlit para que los usuarios introduzcan una pregunta, ajusten cómo busca el agente y examinen toda la traza de ejecución: respuesta final, tiempos, plan de consultas generado y paquete de evidencias.
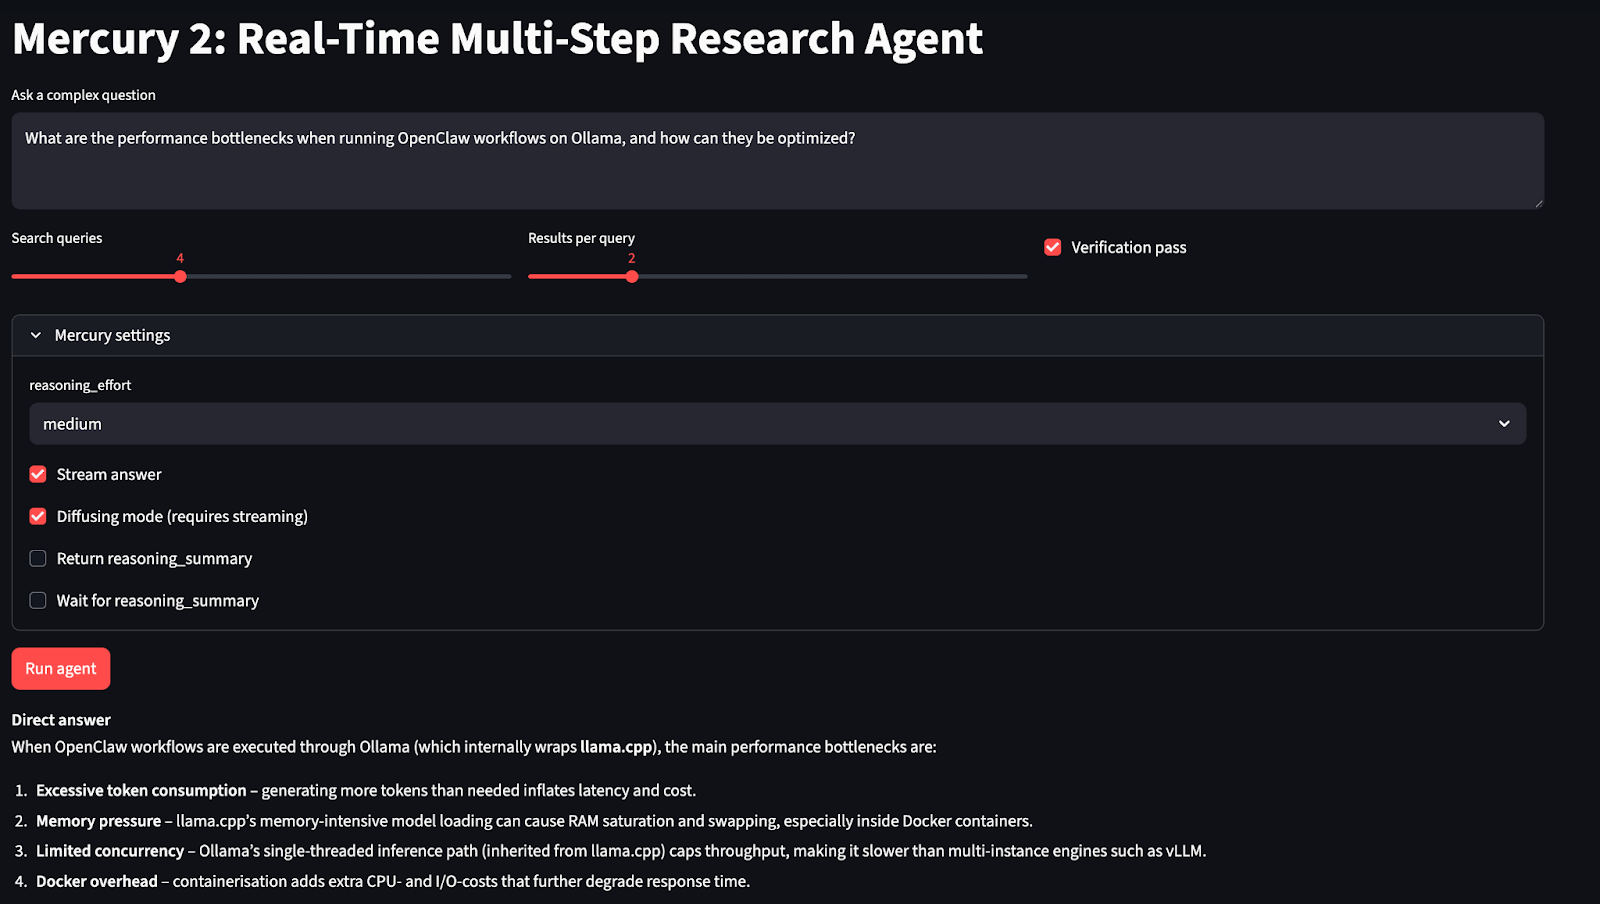
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
    "Ask a complex question",
    height=120,
    placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
    n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
    max_results = st.slider("Results per query", 1, 6, 2)
with col3:
    do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
    reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
    stream_answer = st.checkbox("Stream answer", value=False)
    diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
    reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
    reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
    if diffusing and not stream_answer:
        st.info("Diffusing requires streaming. Enabling streaming automatically.")
        stream_answer = True
run = st.button("Run agent", type="primary")
if run:
    if not question.strip():
        st.warning("Enter a question.")
        st.stop()
    answer_placeholder = st.empty()
    status_placeholder = st.empty()
    def _stream_cb(text: str, meta: Dict[str, Any]):
        answer_placeholder.markdown(text)
    with st.spinner("Running…"):
        status_placeholder.caption("Planning → searching → synthesizing…")
        out = asyncio.run(
            run_agent(
                question.strip(),
                n_queries,
                max_results,
                do_verify,
                reasoning_effort=reasoning_effort,
                stream_answer=stream_answer,
                diffusing=diffusing,
                reasoning_summary=reasoning_summary,
                reasoning_summary_wait=reasoning_summary_wait,
                stream_callback=_stream_cb if stream_answer else None,
            )
        )
    status_placeholder.empty()
    st.subheader("Answer")
    st.write(out["answer"])
    st.subheader("Timings (sec)")
    st.json(out["timings_sec"])
    with st.expander("Plan (queries / subquestions)"):
        st.json(out["plan"])
    with st.expander("Evidence (search results)"):
        st.json(out["evidence"])
Este código define cómo la capa de Streamlit convierte la función run_agent() en un flujo de trabajo de investigación interactivo. El usuario introduce una pregunta, controla el alcance y la profundidad de la búsqueda y, si quiere, activa una verificación que elimina afirmaciones sin respaldo.
Un panel adicional de “Mercury settings” expone controles del modelo como reasoning_effort, la salida en streaming y el modo diffusing, que requiere streaming y va actualizando el placeholder de la respuesta a medida que llegan nuevos fragmentos.
Al ejecutarse, la app valida la entrada, emite la salida parcial en un placeholder y luego muestra la respuesta final con los tiempos y vistas desplegables de depuración para el plan generado y el paquete de evidencias.
Para probarlo, guarda el código como app.py y lánzalo:
streamlit run app.pyEn este tutorial hemos creado un agente de investigación consciente de la latencia con Mercury 2. El sistema genera un plan de búsqueda estructurado para una consulta del usuario, ejecuta recuperación web en paralelo, normaliza los resultados en un formato de evidencias compacto y produce una respuesta fundamentada con citas.
También añadimos una verificación opcional que vuelve a comprobar el borrador con la misma evidencia y matiza las afirmaciones no respaldadas. Este patrón sencillo de Generar–Criticar–Corregir mejora notablemente el sustento factual con una latencia mínima añadida.
Más allá de la canalización central, la aplicación expone los controles en tiempo de ejecución de Mercury 2, incluido el esfuerzo de razonamiento, la salida en streaming, los resúmenes de razonamiento y el modo de difusión. Para ampliar este proyecto, podrías:
Si quieres seguir aprendiendo a usar la IA en tareas de desarrollo, te recomiendo el curso AI-Assisted Coding for Developers.
Los mejores cursos de DataCamp
Programa
Curso
Practica y programa tu progreso.
Continuar Con GoogleTutorial
Tutorial
Moez Ali
12 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Josep Ferrer
11 min