

Mercury 2 nedir?
Mercury 2, Inception Lab’in hızlı akıl yürütme modeli olup, gecikmenin aracı döngülerinde, geri getirme hatlarında ve yüksek eşzamanlı uygulamalarda katlandığı üretim iş yükleri için tasarlanmıştır.
Bir seferde bir token çözen standart otoregresif LLM’lerin aksine, Mercury 2, metni paralel olarak iyileştiren difüzyon tarzı bir üretim süreci kullanır; bu da doğru sunum kurulumunda son derece yüksek çıktı hızına ulaşabilmesinin temel nedenidir.
Mercury 2’nin temel yetenekleri şunlardır:
OpenAI ile uyumlu entegrasyon
Mercury 2, OpenAI ile uyumlu bir API sunar; bu da yalnızca temel URL’yi ve model adını değiştirerek mevcut OpenAI istemci kitaplıklarını kullanabileceğiniz anlamına gelir. Bu sayede, herhangi bir SDK veya mimari değişiklik gerektirmeden mevcut uygulamalara, aracı çerçevelerine ve üretim hatlarına kolayca entegre edilebilir.
Uzun bağlam desteği
Model yaklaşık 128K token’lık bir bağlam penceresini destekler; bu da büyük kanıt paketlerinin, çok adımlı araç çıktılarının, konuşma izlerinin veya yapılandırılmış ara durumun aktarılması gereken iş akışları için uygundur.
Yapılandırılmış çıktılar ve aracı hazır olma
Mercury 2, şema kısıtlı JSON’u güvenilir biçimde işler ve araç tarzı etkileşimleri destekler. Bu, sorgu planlama, araç argümanı üretimi, adımlar arasında yapılandırılmış durum aktarımı ve biçimlendirmenin belirleyici olduğu doğrulama hatları gibi kullanım senaryolarını mümkün kılar.
Çalışma zamanı akıl yürütme kontrolleri
Çoğu genel amaçlı modelin aksine, Mercury 2, reasoning_effort (anında ile yüksek arası), isteğe bağlı akıl yürütme özetleri, akışlı çıktı ve difüzyon tarzı akış gibi operasyonel kontroller sunar. Bu düğmeler, hattın aşamasına bağlı olarak hız, derinlik ve etkileşim arasında çağrı bazında denge kurmanıza olanak tanır.
Üretim odaklı maliyet modeli
Fiyatlandırma yapısı, düşük giriş token maliyetleri ve önemli ölçüde indirimli önbelleğe alınmış giriş token’ları ile yüksek frekanslı iş yükleri için optimize edilmiştir. Bu, sistem istemlerinin ve bağlamın birden çok model çağrısında yeniden kullanıldığı aracı döngüleri ve çok adımlı hatlar için faydalıdır.
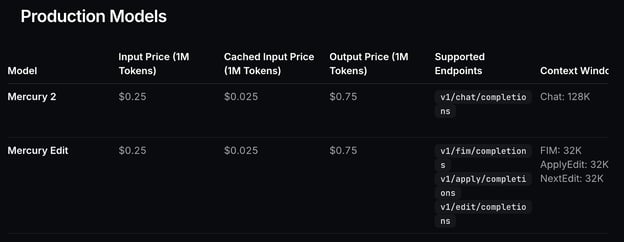
Şekil: Model fiyatlandırması
Mercury 2 Nasıl Çalışır?
Geleneksel LLM’ler metni otoregresif olarak üretir; yani metni sırayla, her seferinde bir token üretir.
token 1 - token 2 - token 3… Bu, gecikmenin çıktı uzunluğuna sıkı sıkıya bağlı olmasına neden olur; çünkü her token bir öncekine bağlıdır ve gecikme çıktı uzunluğuyla doğrusal olarak artar. Kullanıcı başına birden çok model çağrısının çalıştırıldığı aracı sistemlerinde bu bir darboğaza dönüşür.
Mercury 2 farklı bir yaklaşım benimser. Sıralı çözümleme yerine difüzyondan ilham alan paralel bir iyileştirme süreci kullanır. Model önce bir başlangıç taslağı üretir ve ardından birkaç adımda birden çok token’ı eşzamanlı olarak iyileştirir.
Üretim, adım adım yazmaktan ziyade yinelemeli düzenlemeye benzer şekilde davranır; bu da çoklu çağrı hatlarında verimi artırır ve uçtan uca gecikmeyi azaltır.
Bu iyileştirme süreci, ara taslakların akışla iletildiği ve arayüzde aşamalı olarak iyileştirildiği diffusing modunu da mümkün kılar. Kullanıcılar metnin gerçek zamanlı olarak nihai biçimine evrilişini izleyebilir; bu özellikle demolar, etkileşimli uygulamalar ve canlı araştırma arayüzleri için faydalıdır.
Bu mimari, Mercury 2’yi tek atımlık istemlerden ziyade birden çok akıl yürütme aşamasında gecikmenin katlandığı sistemler için en uygun hale getirir.
Mercury 2 Eğitimi: Gerçek Zamanlı Çok Adımlı Bir Araştırma Aracısı Oluşturun
Bu bölümde, Mercury 2 kullanarak, karmaşık bir soruyu alıp web’de arama yapabilen, birden çok kaynağı birlikte ele alabilen ve birkaç saniye içinde temellendirilmiş bir yanıt döndürebilen gerçek zamanlı bir araştırma asistanı oluşturacağız. Tek bir istem-yanıt etkileşimi yerine sistem, güvenilir bir sonuç üretmek için gereken bilgileri her adımda iyileştiren hızlı bir çok adımlı aracı döngüsü çalıştırır.
Üst düzeyde, uygulama beş temel görevi yerine getirir:
- Sorgu genişletme: Sorunun farklı yönlerini kapsamak için (yapılandırılmış JSON olarak) birden çok odaklı arama sorgusu üretiyoruz.
- Paralel web araması: Ardından, gecikmeyi en aza indirmek ve hızlıca çeşitli kaynaklar toplamak için tüm sorguları eşzamanlı yürütüyoruz.
- Kanıt normalleştirme: Arama sonuçlarını, modelin üzerinde akıl yürütebileceği kompakt bir kanıt JSON’una temizleyip sıkıştırıyoruz.
- Temellendirilmiş sentez: Ayrıca, yalnızca sağlanan kanıtı kullanarak,
[S1],[S2]gibi satır içi atıflarla yapılandırılmış bir yanıt üretiyoruz. - İsteğe bağlı doğrulama geçişi: Kullanıcı ayrıca, taslak yanıtı gözden geçiren ve kanıtla desteklenmeyen iddiaları kaldıran veya yumuşatan ikinci bir model çağrısı çalıştırabilir. Doğrulama aşaması, modelin kendi taslağını kanıtlara göre gözden geçirip daha güçlü olgusal temellendirme için revize ettiği hafif bir Üret–Eleştir–Düzelt desenini uygular.
Uygulama iki ana çıktı üretir:
- Web kanıtlarına bağlı satır içi atıflarla kaynak temelli içgörüler.
- Oluşturulan arama planı, getirilen kaynaklar ve adım bazlı gecikme dahil yürütme şeffaflığı.
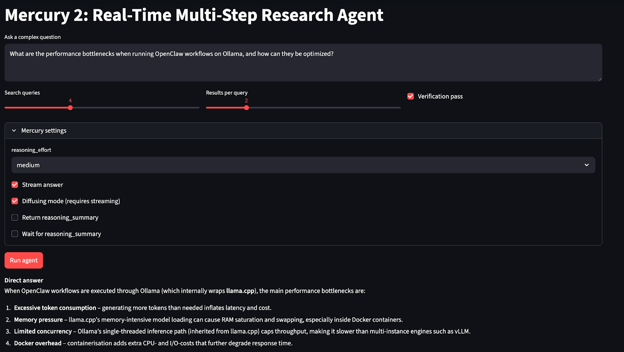
Adım 1: API erişimi alın
Araştırma aracısını oluşturmadan önce, öncelikle Mercury 2 API’sine erişmemiz gerekir. Mercury 2 şu anda erken erişimle sunulduğundan, bu adım uygulamanızdan çıkarım çağrıları yapmanız için gereken kimlik bilgileri ve uç nokta yapılandırmasına sahip olmanızı sağlar.
Buradan erişim isteyebilirsiniz: https://www.inceptionlabs.ai/early-access.
Hesabınız onaylandıktan sonra:
- Inception Platform’a giriş yapın
- API Keys bölümüne gidin
- Create API Key’e tıklayın
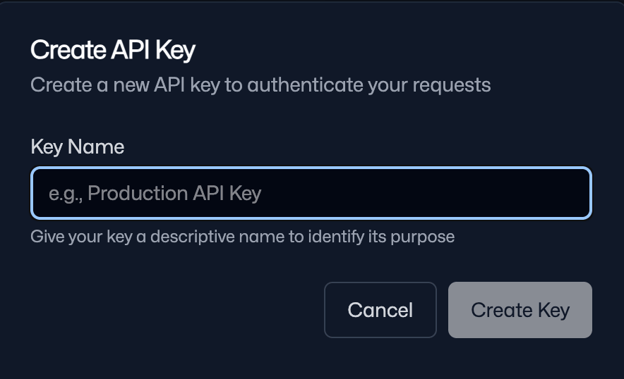
- Bir ad girin ve oluşturulan anahtarı kopyalayın
Bu anahtarı güvenli bir şekilde saklayın; tüm API isteklerini yetkilendirmek için bunu kullanacaksınız.
Not: İlk kayıtta 10.000.000 ücretsiz token alırsınız; bu, bu deneyi yürütmek için yeterlidir.
Adım 2: Ortam kurulumu
Artık API erişimine sahip olduğunuza göre, bir sonraki adım Mercury 2 araştırma aracısını oluşturmak ve çalıştırmak için yerel ortamı hazırlamaktır. Inception API’si OpenAI ile uyumlu olduğundan, standart OpenAI Python istemcisini web arayüzü ve arama hattı için bir dizi kitaplıkla birlikte kullanabiliriz. Ayrıca kaydedilmiş API anahtarımızı bir ortam değişkeni olarak tutarız.
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”Mercury 2 araştırma aracısını çalıştırmak için gerekli çekirdek bağımlılıkları kuruyor ve güvenli API erişimini yapılandırıyoruz. Model çağrıları için standart OpenAI istemcisini, etkileşimli arayüzü oluşturmak için Streamlit’i, düşük gecikmeli geri getirme için paralel web aramalarını yürütmek üzere aiohttp’yu ve arama sonuçlarını ayrıştırmak için beautifulsoup4 ile lxml’yi kullanıyoruz.
Paketleri yükledikten sonra, kimlik bilgilerini güvende tutmak ve uygulamanın çalışma zamanında otomatik olarak kimlik doğrulaması yapmasını sağlamak için INCEPTION_API_KEY değişkeninizi ortam değişkeni olarak ayarlayın.
Bir sonraki adımda, Mercury istemcisini uygulayacak ve temel çok adımlı aracı hattını oluşturacağız.
Adım 3: Mercury istemcisi
Bu adım üç şeyi bağlıyor: uygulama genelinde kullanacağımız kitaplıkları içe aktarmak, API anahtarını ortamdan güvenli şekilde yüklemek ve OpenAI istemcisini Inception’ın temel URL’sine yönlendirecek şekilde başlatmak.
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)Yukarıdaki kod parçacığı, bir Mercury 2 istemcisini başlatır ve uygulama için destekleyici yığını içe aktarır; arayüz için Streamlit, eşzamansız web istekleri için aiohttp, arama sonuçlarını ayrıştırmak için BeautifulSoup ve JSON işleme, zamanlama ve veri yapıları için standart Python yardımcıları dahildir.
Ardından INCEPTION_API_KEY’i ortam değişkeninden okur, Inception temel URL’sini istekleri doğru yönlendirecek şekilde yapılandırır ve model adını "mercury-2" olarak ayarlarız; böylece sonraki tüm çağrılar hedeflenen akıl yürütme modelini kullanır.
Son olarak, OpenAI istemcisi özel temel URL ile başlatılır; bu sayede Mercury 2’yi standart chat.completions arayüzünü kullanarak çağırabiliriz.
Adım 4: Web arama aracı
Sırada, web’den güncel bilgi getirebilecek bir geri getirme adımı var. Bu eğitimde, DuckDuckGo’nun HTML uç noktasını kullanarak bir arama aracı uygulayacak ve sonuçları doğrudan ayrıştıracağız; çünkü ek API anahtarlarına ihtiyaç duymaz ve prototipleme için yeterince hızlıdır.
Üst düzeyde üç şeyi uygularız:
- DuckDuckGo’nun HTML sonuç sayfasına karşı bir sorgu çalıştırmak
- En üstteki sonuçları yapılandırılmış
SearchResultbiçimine ayrıştırmak - Yinelenenleri kaldırmak ve sonuçları Mercury’nin daha sonra atıf yapabileceği kompakt bir JSON’a paketlemek
DDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceYukarıdaki yardımcılar dört ana bileşeni tanımlar:
- Eşzamansız web geri getirme:
ddg_search()işlevi,aiohttpkullanarak DuckDuckGo’nun HTML uç noktasını sorgular ve yanıtı BeautifulSoup ve lxml ile ayrıştırır. Her sonuç yapılandırılmış bir biçime çıkarılır ve işlev, gecikmeyi düşük tutmak içinmax_resultsgirdisinden sonra durur. Bu, birden çok aramanın eşzamanlı olarak yürütülmesine olanak tanır. - Metin normalleştirme:
clean_text()yardımcı işlevi, kesitlerin kompakt ve okunaklı kalması için fazladan boşluk ve biçimleme artıklarını kaldırır. Sonuçlar ardından, çıktıyı standartlaştıran ve sonraki aşamaları ham HTML yapısından bağımsız tutanSearchResultveri sınıfı kullanılarak depolanır. - Sorgular arasında yinelenenleri giderme: Aracı birden çok arama sorgusu çalıştırdığında, aynı sayfalar sık sık tekrar eder.
dedupe_results()işlevi, URL’leri normalleştirerek yinelenenleri kaldırır; böylece kanıt kümesi, bağlam penceresi içinde çeşitli ve verimli kalır. - Model akıl yürütmesi için kanıt paketleme:
pack_evidence()işlevi, sonuçları kararlı tanımlayıcılara sahip kompakt bir JSON yapısına dönüştürür. Kesitler, birleşik kanıt modelin bağlamına sığsın ve daha sonra satır içi atıflarla referans verilebilsin diye ~320 karaktere kırpılır.
Okuyucular için not:
Bu DuckDuckGo HTML yaklaşımı prototip dostudur çünkü ek API anahtarlarına ihtiyaç duymaz; ancak üretim düzeyi bir arama değildir:
- HTML düzenleri değişebilir ve seçicileri bozabilir
- Oran sınırlandırma/bot koruması kazımayı engelleyebilir
- Sonuç kalitesi ve sıralaması değişken olabilir
Üretime hazır bir sürüm isterseniz, bunu kararlı bir Arama API’siyle (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search vb.) değiştirin ve aracının geri kalanını olduğu gibi bırakın.
Sırada, getirilen kanıtlar üzerinden akıl yürütebilmesi ve kaynak temelli bir yanıt üretebilmesi için bu geri getirme katmanını Mercury 2’ye bağlayacağız.
Adım 5: Mercury çağrıları
Bu adımda, Mercury 2’yi hem katı yapılandırılmış çıktıları (planlama için) hem de akışlı metin üretimini (sentez ve diffusing demosu için) destekleyen küçük, yeniden kullanılabilir bir arayüzün arkasına alıyoruz.
Amaç, her model çağrısını tutarlı tutmak; ancak tek bir ayar nesnesi üzerinden Mercury’nin “akıl yürütme düğmelerini” ve akış modlarını da açığa çıkarmaktır.
def mercury_settings(
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
diffusing: bool = False,
) -> Dict[str, Any]:
return {
"reasoning_effort": reasoning_effort,
"reasoning_summary": reasoning_summary,
"reasoning_summary_wait": reasoning_summary_wait,
"diffusing": diffusing,
}
def mercury_json(
system: str,
user: str,
max_tokens: int = 400,
reasoning_effort: str = "medium",
) -> Dict[str, Any]:
def _call(messages) -> str:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=0.0,
stream=False,
extra_settings=mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
diffusing=False,
),
)
return (resp.choices[0].message.content or "").strip()
text = _call(
[{"role": "system", "content": system}, {"role": "user", "content": user}]
)
try:
return json.loads(text)
except json.JSONDecodeError:
pass
m = re.search(r"\{.*\}", text, flags=re.DOTALL)
if m:
try:
return json.loads(m.group(0))
except json.JSONDecodeError:
pass
repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
repair_user = (
"Fix the following so it is valid JSON and matches the required schema.\n\n"
"REQUIRED SCHEMA:\n"
"{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
"BROKEN OUTPUT:\n"
f"{text}"
)
fixed = _call(
[{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
)
try:
return json.loads(fixed)
except json.JSONDecodeError:
m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
if not m2:
raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
return json.loads(m2.group(0))
def mercury_text(
system: str,
user: str,
max_tokens: int = 950,
temperature: float = 0.3,
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
stream: bool = False,
diffusing: bool = False,
stream_callback=None,
) -> str:
if diffusing:
stream = True
extra_settings = mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
diffusing=diffusing,
)
messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
if not stream:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=False,
extra_settings=extra_settings,
)
return (resp.choices[0].message.content or "").strip()
full = ""
stream_resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=True,
extra_settings=extra_settings,
)
for event in stream_resp:
choices = getattr(event, "choices", None) or []
if not choices:
continue
delta = getattr(choices[0], "delta", None)
chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
if not chunk:
continue
if diffusing:
full = chunk
else:
full += chunk
if stream_callback:
stream_callback(full, {"delta": chunk})
return full.strip()Bu adımda, üç ana bileşene sahip yardımcı işlevleri tanımlıyoruz:
- Akıl yürütme düğmeleri ayarları:
mercury_settings()işlevi,reasoning_effort,reasoning_summary,reasoning_summary_waitvediffusinggibi Mercury’ye özgü parametreleri merkezileştirir. Bu, hattı tutarlı tutar ve Streamlit anahtarlarını her model çağrısına yapılandırmayı kopyalamadan doğrudan bağlamayı kolaylaştırır. - Şemayla hizalı JSON üretimi:
mercury_json(), aracının yapılandırılmış çıkışlara ihtiyaç duyduğu durumlarda kullanılır. Biçim kararlılığını en üst düzeye çıkarmak içintemperature=0.0ile çalışır ve akış/difüzyonu devre dışı bırakır. İşlev önce JSON’u doğrudan ayrıştırmayı dener, ardından regex ile bir JSON bloğu çıkarmaya çalışır ve son olarak, modelin gerekli şemayla eşleşen geçerli JSON döndürmesini zorlayan bir onarım geçişine başvurur. - İsteğe bağlı akış ve difüzyonla metin üretimi:
mercury_text()işlevi, hem akışsız hem de akışlı modları destekler.diffusing=Trueise otomatik olarakstream=True’yu zorlar ve görüntülenen metni geçerli arabellek üzerine yazarak günceller. Normal akış modunda, nihai yanıtı oluşturmak için deltaları ekler. İsteğe bağlıstream_callback()kancası, arayüzün canlı güncellemeleri işlemesine olanak tanır.
Bir sonraki adımda, bu yardımcıları kullanarak yapılandırılmış sorgu genişletmesini uygulayacak ve bunları web araması ve kanıt paketleme hattına bağlayacağız.
Adım 6: Yapılandırılmış sorgu genişletme
Şimdi Mercury 2 ve web aramasını uçtan uca bir araştırma döngüsünde birleştiriyoruz. Temel fikir, önce yapılandırılmış bir arama planı üretmek, ardından nihai yanıtı kanıt yüküne dayalı hale zorlamak; böylece arayüzde Mercury’nin akıl yürütme kontrollerini ve akış/difüzyon modlarını sergilemektir.
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
system = (
"Return ONLY valid JSON. No markdown.\n"
"Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
"Rules:\n"
f"- MUST produce at least {max(3, n_queries-2)} queries\n"
"- queries <= 12 words, diverse\n"
"- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
"Output must start with '{' and end with '}'."
)
user = f"Question: {question}\nReturn {n_queries} queries."
out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
queries = (out.get("queries") or [])
subqs = (out.get("subquestions") or [])
must = (out.get("must_cover") or [])
if len(queries) == 0:
queries = [
f"{question} benchmarks",
"vLLM edge inference benchmarks",
"llama.cpp edge inference benchmarks",
"vLLM vs llama.cpp quantization",
"llama.cpp Metal CUDA Vulkan performance",
"vLLM KV cache paged attention memory",
][:n_queries]
out["queries"] = queries[:n_queries]
out["subquestions"] = subqs[: min(6, n_queries)]
out["must_cover"] = must[:6]
return out
def answer_with_citations(
question: str,
evidence: List[Dict[str, str]],
*,
reasoning_effort: str,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream: bool,
diffusing: bool,
stream_callback=None,
) -> str:
system = (
"You are a fast research synthesizer.\n"
"Use ONLY the provided evidence.\n"
"Add inline citations like [S1], [S2] using evidence ids.\n"
"If evidence is insufficient, say what's missing."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
"Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.3,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream,
diffusing=diffusing,
stream_callback=stream_callback,
)
def verify_answer(
question: str,
evidence: List[Dict[str, str]],
draft: str,
*,
reasoning_effort: str,
) -> str:
system = (
"You are a verifier.\n"
"Remove/soften any claim not supported by evidence.\n"
"Keep citations [S#]. Return revised answer."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
f"Draft:\n{draft}"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.2,
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
stream=False,
diffusing=False,
)
async def run_agent(
question: str,
n_queries: int,
max_results_per_query: int,
do_verify: bool,
*,
reasoning_effort: str,
stream_answer: bool,
diffusing: bool,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream_callback=None,
) -> Dict[str, Any]:
t0 = time.perf_counter()
plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
t1 = time.perf_counter()
queries = plan.get("queries", [])
async with aiohttp.ClientSession() as session:
tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
lists = await asyncio.gather(*tasks)
flat = dedupe_results([r for lst in lists for r in lst])
evidence = pack_evidence(flat, max_items=18)
t2 = time.perf_counter()
draft = answer_with_citations(
question,
evidence,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream_answer,
diffusing=diffusing,
stream_callback=stream_callback,
)
t3 = time.perf_counter()
final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
t4 = time.perf_counter()
return {
"plan": plan,
"evidence": evidence,
"answer": final,
"timings_sec": {
"expand": round(t1 - t0, 3),
"search_parallel": round(t2 - t1, 3),
"synthesize": round(t3 - t2, 3),
"verify": round(t4 - t3, 3),
"total": round(t4 - t0, 3),
},
}Bu adım, dört çekirdek aşamayı birbirine bağlar:
- Yapılandırılmış sorgu planlama:
expand_query()işlevi, Mercury 2’denqueries,subquestionsvemust_coveriçeren katı JSON döndürmesini isteyerek yapılandırılmış bir araştırma planı üretir. Çıktı, otomatik JSON onarımını içerenmercury_json()kullanılarak ayrıştırılır; ayrıca model boş bir plan döndürse bile aracının devam etmesini sağlayan bir geri dönüş sorgu kümesi bulunur. - Atıflarla kanıta dayalı sentez:
answer_with_citations()işlevi, yalnızca arama aşamasından gelen paketlenmiş kanıtı kullanarak ilk yanıtı üretir. İstem, modeli açıkça sağlanan kanıtla sınırlar ve satır içi atıfları zorunlu kılar. Çıktı; doğrudan yanıt, temel içgörüler ve uyarıları içerir; yanıtın özlü kalmasını ve kaynaklara izlenebilir olmasını sağlar. - Temellendirme için isteğe bağlı doğrulama:
verify_answer()işlevi Üret–Eleştir–Düzelt desenini uygular. Taslak yanıtı aynı kanıtlara karşı yeniden değerlendirir ve desteklenmeyen iddiaları kaldırır veya yumuşatır; atıf işaretlerini korur. Bu ek geçiş, asılsız genellemeleri azaltır ve en az gecikme yüküyle olgusal temellendirmeyi iyileştirir. - Performans takibiyle orkestrasyon:
run_agent()işlevi, sorgu planını genişletmek,aiohttpveasyncio.gather()kullanarak paralel DuckDuckGo aramalarını yürütmek, sonuçları yinelenenden arındırıp kompakt kanıt JSON’una paketlemek, sentezlenmiş yanıtı üretmek ve isteğe bağlı olarak doğrulamayı çalıştırmak dâhil tüm iş akışını koordine eder.
Adım 7: Streamlit arayüzü
Son olarak, kullanıcıların soru girmesine, aracının nasıl arama yaptığını ayarlamasına ve tam yürütme izini — nihai yanıt, zamanlamalar, oluşturulan sorgu planı ve kanıt paketi — incelemesine olanak tanımak için aracı çalışma zamanını (run_agent) bir Streamlit arayüzüne bağlayacağız.
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
"Ask a complex question",
height=120,
placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
max_results = st.slider("Results per query", 1, 6, 2)
with col3:
do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
stream_answer = st.checkbox("Stream answer", value=False)
diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
if diffusing and not stream_answer:
st.info("Diffusing requires streaming. Enabling streaming automatically.")
stream_answer = True
run = st.button("Run agent", type="primary")
if run:
if not question.strip():
st.warning("Enter a question.")
st.stop()
answer_placeholder = st.empty()
status_placeholder = st.empty()
def _stream_cb(text: str, meta: Dict[str, Any]):
answer_placeholder.markdown(text)
with st.spinner("Running…"):
status_placeholder.caption("Planning → searching → synthesizing…")
out = asyncio.run(
run_agent(
question.strip(),
n_queries,
max_results,
do_verify,
reasoning_effort=reasoning_effort,
stream_answer=stream_answer,
diffusing=diffusing,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream_callback=_stream_cb if stream_answer else None,
)
)
status_placeholder.empty()
st.subheader("Answer")
st.write(out["answer"])
st.subheader("Timings (sec)")
st.json(out["timings_sec"])
with st.expander("Plan (queries / subquestions)"):
st.json(out["plan"])
with st.expander("Evidence (search results)"):
st.json(out["evidence"])Yukarıdaki kod, Streamlit katmanının run_agent() işlevini etkileşimli bir araştırma iş akışına nasıl dönüştürdüğünü tanımlar. Kullanıcı bir soru girer, aramanın genişliğini ve derinliğini kontrol eder ve isteğe bağlı olarak kanıtla desteklenmeyen iddiaları kaldıran bir doğrulama geçişini etkinleştirir.
Ek bir “Mercury ayarları” paneli, reasoning_effort, streaming çıktı ve diffusing modu gibi model düğmelerini açığa çıkarır; bu mod akış gerektirir ve yeni parçalar geldikçe yanıt yer tutucusunu yerinde günceller.
Çalıştırıldığında uygulama, girdiyi doğrular, kısmi çıktıyı bir yer tutucuya akıtır ve ardından oluşturulan plan ve kanıt paketi için genişletilebilir hata ayıklama görünümleriyle birlikte nihai yanıtı ve zamanlamaları oluşturur.
Kendiniz denemek için kodu app.py olarak kaydedin ve şunu başlatın:
streamlit run app.pySonuç
Bu eğitimde, Mercury 2 tarafından desteklenen, gecikme farkında bir araştırma aracısı oluşturduk. Sistem, bir kullanıcı sorgusu için yapılandırılmış bir arama planı üretir, ardından paralel web geri getirmeyi yürütür, sonuçları kompakt bir kanıt biçimine normalleştirir ve atıflarla temellendirilmiş bir yanıt üretir.
Ayrıca, taslağı aynı kanıtlara göre yeniden kontrol eden ve desteklenmeyen iddiaları yumuşatan isteğe bağlı bir doğrulama geçişi ekledik. Bu basit Üret–Eleştir–Düzelt deseni, çok az gecikme eklerken olgusal temellendirmeyi önemli ölçüde iyileştirir.
Çekirdek hattın ötesinde, uygulama Mercury 2’nin çalışma zamanı kontrollerini — akıl yürütme çabası, akışlı çıktı, akıl yürütme özetleri ve diffusing modu — açığa çıkarır. Bu projeyi daha da genişletmek için şunları yapabilirsiniz:
- DuckDuckGo kazıyıcısını üretim arama API’siyle (Bing, SerpAPI, Brave) değiştirin
- Yinelenen gecikmeyi azaltmak için arama sonuçlarını veya ara planları önbelleğe alın
- Oturum belleği veya çok turlu araştırma için kanıtı kalıcı hâle getirin
- Daha yüksek kaliteli kanıt seçimi için bir özetleme katmanı ekleyin
Geliştirme görevlerinde yapay zekâ kullanımı hakkında öğrenmeye devam etmek için AI-Assisted Coding for Developers kursunu öneririm.
Mercury 2 SSS
Mercury 2’yi geleneksel LLM’lerden farklı kılan nedir?
Mercury 2, bir taslak üreten ve bunu birkaç adımda iyileştiren, difüzyon tarzı paralel bir iyileştirme süreci kullanır. Bu, gecikmenin biriktiği çoklu çağrı hatlarında daha yüksek çıktı ve daha iyi performans sağlar.
Mercury 2 diffusing modu nedir?
Diffusing modu, model çıktısını iyileştirirken ara taslakları akışla iletir. Token token yazmak yerine metin, yerinde aşamalı olarak yeniden yazılır ve geliştirilir.
Neden bir doğrulama geçişi ekleniyor?
Doğrulama adımı, taslağı aynı kanıtlara göre yeniden değerlendirir ve desteklenmeyen iddiaları kaldırır. Bu, yalnızca bir ek model çağrısıyla temellendirmeyi iyileştirir.
DuckDuckGo arama uygulaması üretime hazır mı?
Hayır. HTML kazıma yaklaşımı basitlik için ve API anahtarı gerektirmediğinden kullanılır; ancak sayfa düzenleri değişirse bozulabilir ve oran sınırlamasına takılabilir. Üretim kullanımı için bunu Bing Web Search, Brave Search veya SerpAPI gibi kararlı bir arama API’siyle değiştirin.
Mercury 2’nin maliyeti ne kadar?
Mercury 2, düşük giriş token maliyetleri ve indirimli önbelleklenmiş token’larla yüksek frekanslı iş yükleri için tasarlanmıştır. Yeni kullanıcılar şu anda kayıt sırasında ücretsiz token almaktadır; bu da bu eğitimi çalıştırmak ve araçla denemeler yapmak için yeterlidir.

ML (Üretken Yapay Zekâ) alanında Google Developers Uzmanıyım, Kaggle 3x Expert unvanına sahibim ve 3+ yıllık teknoloji deneyimiyle Women Techmakers Elçisiyim. 2020'de bir sağlık teknolojileri girişiminin kurucu ortağı oldum ve Georgia Tech'te makine öğrenmesi alanında uzmanlaşarak bilgisayar bilimleri yüksek lisansı yapıyorum.






Mercury 2, arama, planlama ve geri getirme (retrieval) hatları gibi aracılı iş akışlarını içeren üretim akıl yürütme iş yükleri için tasarlanmıştır; bu tür durumlarda, geleneksel otoregresif modeller, sıralı çözümleme nedeniyle yavaşlar. Bu eğitimde, Mercury 2’yi kullanarak Streamlit ile gerçek zamanlı, çok adımlı bir araştırma aracısı oluşturacağız.
Uygulamada bir kullanıcı karmaşık bir soru sorar; sistem bunu, sorunun farklı yönlerini kapsayan birden çok odaklı arama sorgusuna genişletir, web sonuçlarını paralel olarak getirir, bunları yapılandırılmış kanıta sıkıştırır ve satır içi atıflarla kaynak temelli bir yanıt üretir.
İsteğe bağlı bir doğrulama adımı, taslağı kanıtlara göre gözden geçirir ve desteklenmeyen iddiaları kaldırır. Arayüz ayrıca Mercury’nin çalışma zamanı kontrollerini de sunar; buna akıl yürütme çabası, akışlı çıktı ve yanıtın gerçek zamanlı olarak iyileştirildiğini gösteren difüzyon tarzı akış dahildir.
Bu süreçte şunları öğreneceksiniz:
reasoning_effortve diğer akıl yürütme düğmeleriyle çalışma zamanı davranışını kontrol etmekstreamingvediffusingmodunu etkinleştirmekNihai uygulama, arama planını, kanıt kaynaklarını ve adım bazlı gecikmeyi döndürür; sistemi hem hızlı hem de incelenebilir kılar.