Cursus
Principes fondamentaux des agents IA
6 h
S'entraîner et cursus vos progrès.
Continuer Avec GoogleMercury 2 est le modèle de raisonnement rapide d’Inception Labs, conçu pour des charges de production où la latence s’accumule dans les boucles d’agents, les pipelines de recherche d’information et les applications à forte concurrence d’accès.
Contrairement aux LLM auto-régressifs standards qui décodent un jeton à la fois, Mercury 2 utilise un processus de génération de type diffusion qui affine le texte en parallèle, ce qui lui permet d’atteindre un débit très élevé avec une infrastructure adaptée.
Parmi ses principales capacités :
Mercury 2 expose une API compatible OpenAI, ce qui vous permet d’utiliser les bibliothèques clientes OpenAI existantes en ne changeant que l’URL de base et le nom du modèle. Il s’intègre ainsi facilement dans des applications, frameworks d’agents et pipelines de production sans modification d’SDK ni de l’architecture.
Le modèle gère une fenêtre de contexte d’environ 128 000 jetons, idéale pour transmettre de gros ensembles de preuves, des sorties d’outils multi-étapes, des historiques de conversation ou des états intermédiaires structurés.
Mercury 2 gère de manière fiable le JSON contraint par schéma et prend en charge les interactions de type outil. Cela permet des cas d’usage tels que la planification de requêtes, la génération d’arguments d’outils, le passage d’états structurés entre étapes et des pipelines de vérification où le formatage déterministe est essentiel.
Contrairement à la plupart des modèles généralistes, Mercury 2 expose des contrôles opérationnels comme reasoning_effort (instant à élevé), des résumés de raisonnement optionnels, le streaming de sortie et le streaming de type diffusion. Ces réglages vous permettent d’arbitrer entre vitesse, profondeur et interactivité à chaque appel selon l’étape du pipeline.
La tarification est optimisée pour des charges à haute fréquence, avec un coût faible par jeton en entrée et des jetons d’entrée mis en cache fortement remisés. C’est idéal pour les boucles d’agents et les pipelines multi-étapes où les prompts système et le contexte sont réutilisés sur plusieurs appels.
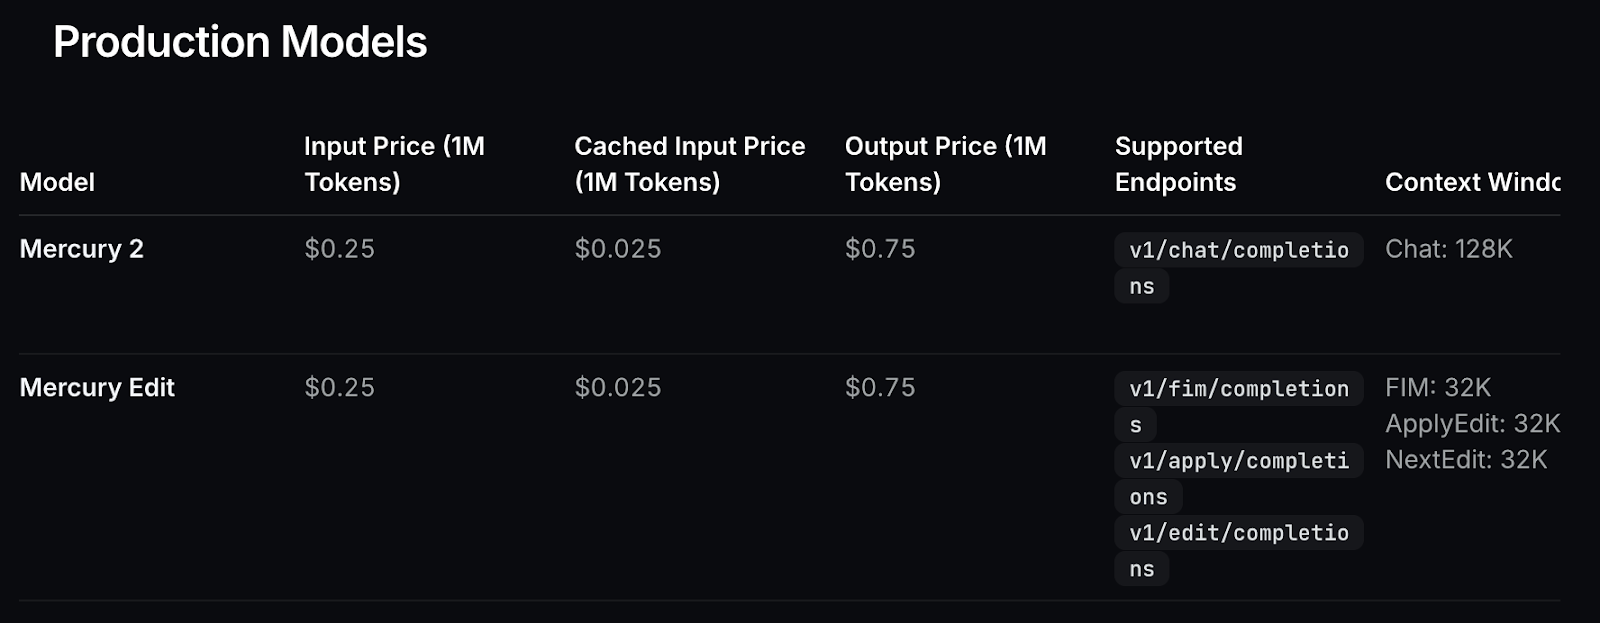
Figure : Tarification du modèle
Les LLM traditionnels génèrent du texte de manière auto-régressive, un jeton à la fois et en séquence.
token 1 - token 2 - token 3… La latence est alors étroitement liée à la longueur de sortie puisque chaque jeton dépend du précédent : elle croît linéairement avec la longueur de sortie. Cela devient un goulot d’étranglement dans les systèmes d’agents où plusieurs appels modèle peuvent être effectués par requête utilisateur.
Mercury 2 adopte une autre approche. Au lieu d’un décodage séquentiel, il utilise un processus de raffinement parallèle inspiré de la diffusion. Le modèle génère un brouillon initial puis affine simultanément plusieurs jetons en quelques étapes.
La génération s’apparente ainsi à une édition itérative plutôt qu’à une saisie pas à pas, ce qui améliore le débit et réduit la latence de bout en bout dans les pipelines comportant plusieurs appels.
Ce processus de raffinement permet aussi le mode diffusing, où des brouillons intermédiaires sont diffusés et améliorés progressivement dans l’interface. Les utilisateurs voient le texte évoluer vers sa forme finale en temps réel : idéal pour des démos, applications interactives et interfaces de recherche en direct.
Cette architecture rend Mercury 2 particulièrement adapté aux systèmes où la latence s’additionne à travers plusieurs étapes de raisonnement plutôt que pour des prompts à tir unique.
Dans cette partie, nous allons construire un assistant de recherche en temps réel avec Mercury 2 capable de prendre une question complexe, de chercher sur le web, de raisonner à partir de multiples sources et de renvoyer une réponse sourcée en quelques secondes. Plutôt qu’une interaction prompt→réponse unique, le système exécute une boucle d’agent rapide et multi-étapes, chaque étape affinant les informations nécessaires pour produire un résultat fiable.
Globalement, l’application effectue cinq tâches clés :
[S1], [S2].L’application produit deux sorties principales :
Avant de construire l’agent de recherche, il faut d’abord accéder à l’API Mercury 2. Comme Mercury 2 est actuellement disponible en accès anticipé, cette étape garantit que vous disposez des identifiants et de la configuration d’endpoint nécessaires pour effectuer des appels d’inférence depuis votre application.
Vous pouvez demander l’accès ici : https://www.inceptionlabs.ai/early-access.
Une fois votre compte approuvé :
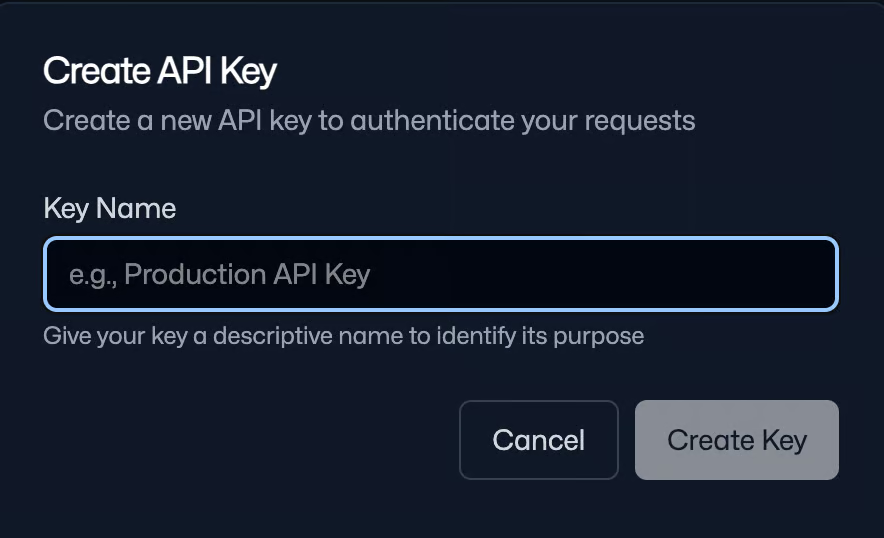
Conservez cette clé en lieu sûr : vous l’utiliserez pour authentifier toutes vos requêtes API.
Remarque : Vous recevez 10 000 000 de jetons gratuits lors de l’inscription, suffisant pour réaliser cette expérience.
Maintenant que vous avez l’accès API, préparons l’environnement local pour construire et exécuter l’agent de recherche Mercury 2. Comme l’API Inception est compatible OpenAI, nous pouvons utiliser le client Python OpenAI standard ainsi qu’un ensemble de bibliothèques pour l’interface web et la recherche. Nous stockons également la clé API comme variable d’environnement.
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”"
Nous installons les dépendances nécessaires pour exécuter l’agent Mercury 2 et configurons un accès API sécurisé. Nous utilisons le client OpenAI standard pour les appels au modèle, Streamlit pour créer l’interface interactive, aiohttp pour lancer des recherches web en parallèle et réduire la latence, et beautifulsoup4 avec lxml pour parser les résultats de recherche.
Après l’installation, définissez votre INCEPTION_API_KEY en variable d’environnement afin de garder les identifiants sûrisés et de permettre l’authentification automatique à l’exécution.
Dans l’étape suivante, nous implémenterons le client Mercury et le cœur du pipeline d’agent multi-étapes.
Cette étape relie trois éléments : l’import des bibliothèques utilisées dans l’app, le chargement sécurisé de la clé API depuis l’environnement, et l’initialisation d’un client OpenAI pointant sur l’URL de base d’Inception.
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
    st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
    st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)
Ce code initialise un client Mercury 2 et importe la pile nécessaire à l’application : Streamlit pour l’UI, aiohttp pour les requêtes web asynchrones, BeautifulSoup pour parser les résultats, et des utilitaires Python pour le JSON, le timing et les structures de données.
Nous lisons ensuite la variable d’environnement INCEPTION_API_KEY, nous configurons l’URL de base Inception pour router correctement les requêtes, et définissons le nom du modèle "mercury-2" afin que tous les appels ultérieurs utilisent le bon modèle de raisonnement.
Enfin, le client OpenAI est initialisé avec l’URL de base personnalisée, ce qui permet d’appeler Mercury 2 via l’interface standard chat.completions.
Nous avons besoin d’une étape de recherche d’information capable de récupérer des contenus à jour. Dans ce tutoriel, nous implémentons un outil de recherche via l’endpoint HTML de DuckDuckGo et analysons les résultats directement : pas de clés API supplémentaires, et suffisamment rapide pour prototyper.
Nous implémentons trois éléments :
SearchResultDDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceCes utilitaires définissent quatre composants clés :
ddg_search() interroge l’endpoint HTML de DuckDuckGo avec aiohttp et parse la réponse avec BeautifulSoup et lxml. Chaque résultat est extrait dans un format structuré et la fonction s’arrête après max_results entrées pour maintenir une faible latence. Plusieurs recherches peuvent s’exécuter en parallèle de manière asynchrone.clean_text() supprime les espaces superflus et artefacts de formatage afin de garder des extraits concis et lisibles. Les résultats sont stockés via la dataclass SearchResult, ce qui standardise la sortie et découple les étapes suivantes du HTML brut.dedupe_results() supprime les doublons en normalisant les URL, afin que l’ensemble de preuves reste divers et efficace dans la fenêtre de contexte.pack_evidence() convertit les résultats en un JSON compact avec des identifiants stables. Les extraits sont tronqués à ∞320 caractères pour que l’ensemble de preuves tienne dans le contexte et puisse être cité via des références en ligne.Pour un usage en production, remplacez-le par une Search API stable (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search, etc.) et gardez le reste de l’agent inchangé.
Ensuite, nous relierons cette couche de recherche à Mercury 2 pour générer des requêtes, raisonner sur les preuves collectées et produire une réponse sourcée.
Ici, nous encapsulons Mercury 2 derrière une petite interface réutilisable qui gère à la fois des sorties strictement structurées (pour la planification) et la génération de texte diffusée (pour la synthèse et la démo diffusing).
L’objectif est de garder chaque appel modèle cohérent tout en exposant, via un seul objet de paramètres, les « leviers de raisonnement » et modes de streaming de Mercury.
def mercury_settings(
    reasoning_effort: str = "medium",
    reasoning_summary: bool = False,
    reasoning_summary_wait: bool = False,
    diffusing: bool = False,
) -> Dict[str, Any]:
    return {
        "reasoning_effort": reasoning_effort,
        "reasoning_summary": reasoning_summary,
        "reasoning_summary_wait": reasoning_summary_wait,
        "diffusing": diffusing,
    }

def mercury_json(
    system: str,
    user: str,
    max_tokens: int = 400,
    reasoning_effort: str = "medium",
) -> Dict[str, Any]:
    def _call(messages) -> str:
        resp = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            max_tokens=max_tokens,
            temperature=0.0,
            stream=False,
            extra_settings=mercury_settings(
                reasoning_effort=reasoning_effort,
                reasoning_summary=False,
                reasoning_summary_wait=False,
                diffusing=False,
            ),
        )
        return (resp.choices[0].message.content or "").strip()

    text = _call(
        [{"role": "system", "content": system}, {"role": "user", "content": user}]
    )
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        pass
    m = re.search(r"\{.*\}", text, flags=re.DOTALL)
    if m:
        try:
            return json.loads(m.group(0))
        except json.JSONDecodeError:
            pass
    repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
    repair_user = (
        "Fix the following so it is valid JSON and matches the required schema.\n\n"
        "REQUIRED SCHEMA:\n"
        "{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
        "BROKEN OUTPUT:\n"
        f"{text}"
    )
    fixed = _call(
        [{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
    )
    try:
        return json.loads(fixed)
    except json.JSONDecodeError:
        m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
        if not m2:
            raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
        return json.loads(m2.group(0))

def mercury_text(
    system: str,
    user: str,
    max_tokens: int = 950,
    temperature: float = 0.3,
    reasoning_effort: str = "medium",
    reasoning_summary: bool = False,
    reasoning_summary_wait: bool = False,
    stream: bool = False,
    diffusing: bool = False,
    stream_callback=None,
) -> str:
    if diffusing:
        stream = True
    extra_settings = mercury_settings(
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        diffusing=diffusing,
    )
    messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
    if not stream:
        resp = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            max_tokens=max_tokens,
            temperature=temperature,
            stream=False,
            extra_settings=extra_settings,
        )
        return (resp.choices[0].message.content or "").strip()
    full = ""
    stream_resp = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=max_tokens,
        temperature=temperature,
        stream=True,
        extra_settings=extra_settings,
    )
    for event in stream_resp:
        choices = getattr(event, "choices", None) or []
        if not choices:
            continue
        delta = getattr(choices[0], "delta", None)
        chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
        if not chunk:
            continue
        if diffusing:
            full = chunk
        else:
            full += chunk
        if stream_callback:
            stream_callback(full, {"delta": chunk})
    return full.strip()
Nous définissons des fonctions d’aide autour de trois éléments :
mercury_settings() centralise les paramètres spécifiques à Mercury (reasoning_effort, reasoning_summary, reasoning_summary_wait, diffusing). Le pipeline reste cohérent et les interrupteurs Streamlit se branchent facilement sur chaque appel modèle sans dupliquer la configuration.mercury_json() s’emploie lorsque l’agent a besoin de sorties structurées. Il fonctionne avec temperature=0.0 et sans streaming/diffusion pour maximiser la stabilité du format. Il tente de parser le JSON directement, puis d’extraire un bloc JSON via regex, et enfin passe par une réparation forcée pour obtenir un JSON valide conforme au schéma requis.mercury_text() gère les modes non diffusé et diffusé. Si diffusing=True, il force stream=True et met à jour le texte en écrasant le tampon courant. En streaming normal, il concatène les deltas. Le hook optionnel stream_callback() permet à l’UI d’afficher les mises à jour en direct.Dans l’étape suivante, nous utiliserons ces outils pour implémenter l’expansion structurée des requêtes et la relierons à la recherche web et à l’empaquetage des preuves.
Nous relions à présent Mercury 2 et la recherche web dans une boucle de recherche de bout en bout. L’idée clé est de commencer par générer un plan de recherche structuré, puis de forcer la réponse finale à s’ancrer dans les preuves, afin de mettre en valeur les contrôles de raisonnement de Mercury et ses modes streaming/diffusing dans l’UI.
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
    system = (
        "Return ONLY valid JSON. No markdown.\n"
        "Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
        "Rules:\n"
        f"- MUST produce at least {max(3, n_queries-2)} queries\n"
        "- queries <= 12 words, diverse\n"
        "- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
        "Output must start with '{' and end with '}'."
    )
    user = f"Question: {question}\nReturn {n_queries} queries."
    out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
    queries = (out.get("queries") or [])
    subqs = (out.get("subquestions") or [])
    must = (out.get("must_cover") or [])
    if len(queries) == 0:
        queries = [
            f"{question} benchmarks",
            "vLLM edge inference benchmarks",
            "llama.cpp edge inference benchmarks",
            "vLLM vs llama.cpp quantization",
            "llama.cpp Metal CUDA Vulkan performance",
            "vLLM KV cache paged attention memory",
        ][:n_queries]
    out["queries"] = queries[:n_queries]
    out["subquestions"] = subqs[: min(6, n_queries)]
    out["must_cover"] = must[:6]
    return out
def answer_with_citations(
    question: str,
    evidence: List[Dict[str, str]],
    *,
    reasoning_effort: str,
    reasoning_summary: bool,
    reasoning_summary_wait: bool,
    stream: bool,
    diffusing: bool,
    stream_callback=None,
) -> str:
    system = (
        "You are a fast research synthesizer.\n"
        "Use ONLY the provided evidence.\n"
        "Add inline citations like [S1], [S2] using evidence ids.\n"
        "If evidence is insufficient, say what's missing."
    )
    user = (
        f"Question:\n{question}\n\n"
        f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
        "Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
    )
    return mercury_text(
        system,
        user,
        max_tokens=950,
        temperature=0.3,
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        stream=stream,
        diffusing=diffusing,
        stream_callback=stream_callback,
    )
def verify_answer(
    question: str,
    evidence: List[Dict[str, str]],
    draft: str,
    *,
    reasoning_effort: str,
) -> str:
    system = (
        "You are a verifier.\n"
        "Remove/soften any claim not supported by evidence.\n"
        "Keep citations [S#]. Return revised answer."
    )
    user = (
        f"Question:\n{question}\n\n"
        f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
        f"Draft:\n{draft}"
    )
    return mercury_text(
        system,
        user,
        max_tokens=950,
        temperature=0.2,
        reasoning_effort=reasoning_effort,
        reasoning_summary=False,
        reasoning_summary_wait=False,
        stream=False,
        diffusing=False,
    )
async def run_agent(
    question: str,
    n_queries: int,
    max_results_per_query: int,
    do_verify: bool,
    *,
    reasoning_effort: str,
    stream_answer: bool,
    diffusing: bool,
    reasoning_summary: bool,
    reasoning_summary_wait: bool,
    stream_callback=None,
) -> Dict[str, Any]:
    t0 = time.perf_counter()
    plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
    t1 = time.perf_counter()
    queries = plan.get("queries", [])
    async with aiohttp.ClientSession() as session:
        tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
        lists = await asyncio.gather(*tasks)
    flat = dedupe_results([r for lst in lists for r in lst])
    evidence = pack_evidence(flat, max_items=18)
    t2 = time.perf_counter()
    draft = answer_with_citations(
        question,
        evidence,
        reasoning_effort=reasoning_effort,
        reasoning_summary=reasoning_summary,
        reasoning_summary_wait=reasoning_summary_wait,
        stream=stream_answer,
        diffusing=diffusing,
        stream_callback=stream_callback,
    )
    t3 = time.perf_counter()
    final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
    t4 = time.perf_counter()
    return {
        "plan": plan,
        "evidence": evidence,
        "answer": final,
        "timings_sec": {
            "expand": round(t1 - t0, 3),
            "search_parallel": round(t2 - t1, 3),
            "synthesize": round(t3 - t2, 3),
            "verify": round(t4 - t3, 3),
            "total": round(t4 - t0, 3),
        },
    }
Cette étape relie quatre phases essentielles :
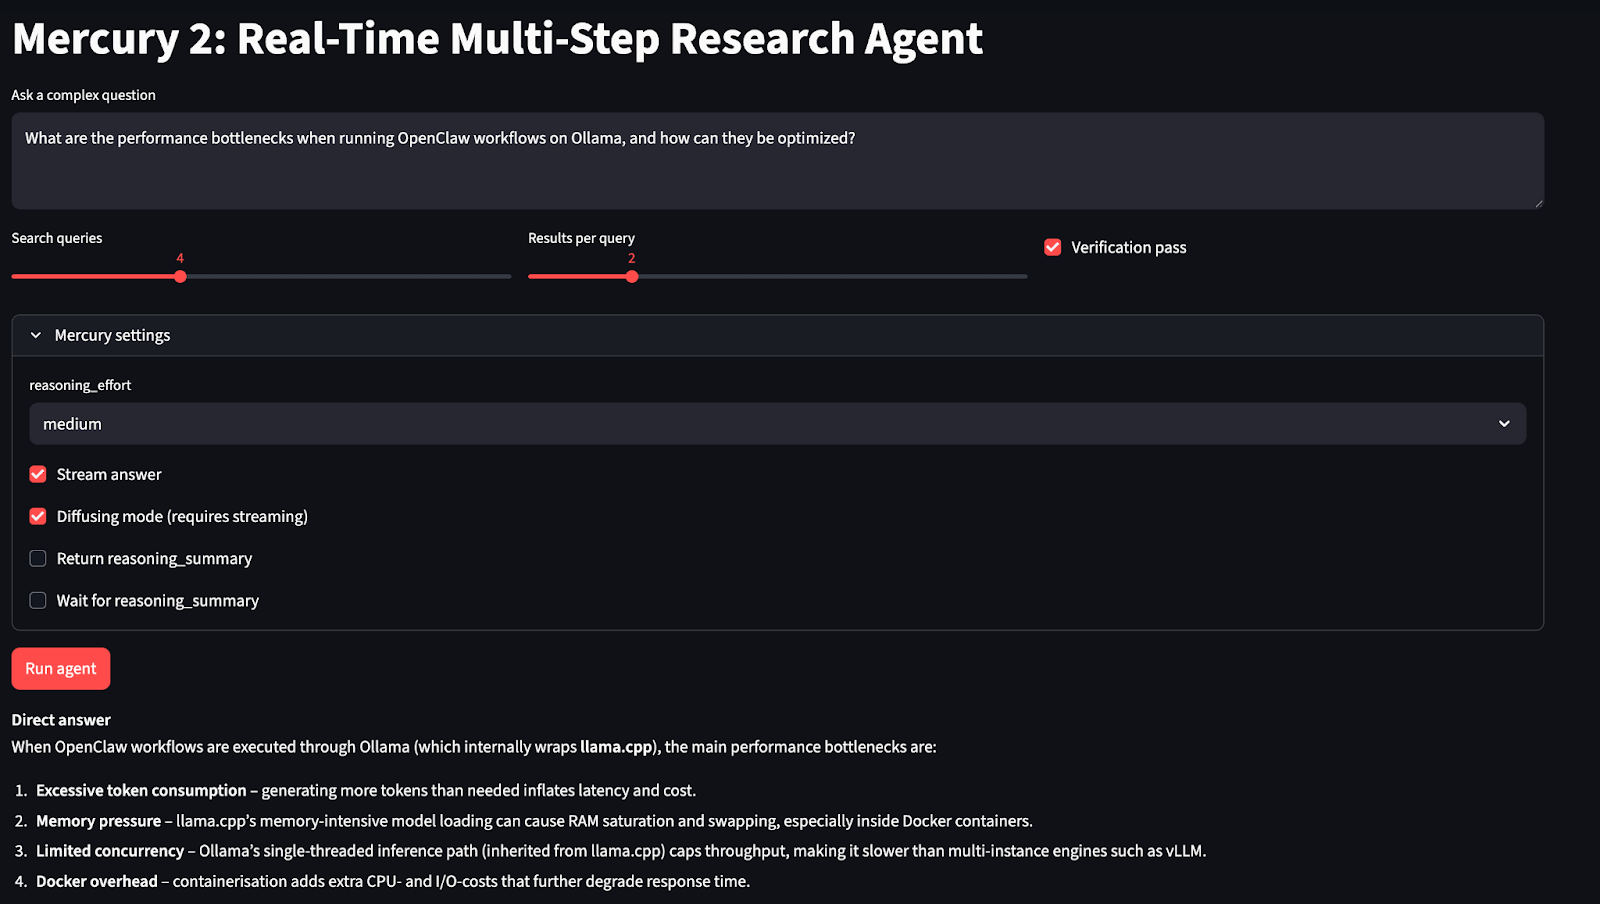
expand_query() génère un plan de recherche structuré en demandant à Mercury 2 un JSON strict contenant queries, subquestions et must_cover. La sortie est parsée via mercury_json() (réparation JSON automatique) avec un jeu de secours assurant la poursuite même si le plan est vide.answer_with_citations() produit la réponse initiale à partir du seul paquet de preuves issu de la recherche. Le prompt restreint explicitement le modèle aux preuves fournies et exige des citations en ligne. La sortie inclut réponse directe, points clés et limites.verify_answer() implémente le schéma Générer–Critiquer–Corriger. Il ré-évalue le brouillon vis-à-vis des mêmes preuves et supprime/atténue les affirmations non étayées tout en conservant les repères de citation. Cette passe réduit la surféralisation et améliore l’ancrage factuel pour une latence minime.run_agent() coordonne l’ensemble du flux : expansion du plan, exécution de recherches DuckDuckGo en parallèle avec aiohttp et asyncio.gather(), déduplication et empaquetage en JSON de preuves, génération de la réponse, et vérification optionnelle.Enfin, nous relions l’exécution de l’agent (run_agent) à une interface Streamlit pour permettre à l’utilisateur de saisir une question, régler la façon dont l’agent cherche et inspecter toute la trace d’exécution : réponse finale, temps d’exécution, plan de requêtes généré et paquet de preuves.
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
    "Ask a complex question",
    height=120,
    placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
    n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
    max_results = st.slider("Results per query", 1, 6, 2)
with col3:
    do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
    reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
    stream_answer = st.checkbox("Stream answer", value=False)
    diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
    reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
    reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
    if diffusing and not stream_answer:
        st.info("Diffusing requires streaming. Enabling streaming automatically.")
        stream_answer = True
run = st.button("Run agent", type="primary")
if run:
    if not question.strip():
        st.warning("Enter a question.")
        st.stop()
    answer_placeholder = st.empty()
    status_placeholder = st.empty()
    def _stream_cb(text: str, meta: Dict[str, Any]):
        answer_placeholder.markdown(text)
    with st.spinner("Running…"):
        status_placeholder.caption("Planning → searching → synthesizing…")
        out = asyncio.run(
            run_agent(
                question.strip(),
                n_queries,
                max_results,
                do_verify,
                reasoning_effort=reasoning_effort,
                stream_answer=stream_answer,
                diffusing=diffusing,
                reasoning_summary=reasoning_summary,
                reasoning_summary_wait=reasoning_summary_wait,
                stream_callback=_stream_cb if stream_answer else None,
            )
        )
    status_placeholder.empty()
    st.subheader("Answer")
    st.write(out["answer"])
    st.subheader("Timings (sec)")
    st.json(out["timings_sec"])
    with st.expander("Plan (queries / subquestions)"):
        st.json(out["plan"])
    with st.expander("Evidence (search results)"):
        st.json(out["evidence"])
Ce code montre comment la couche Streamlit transforme la fonction run_agent() en un workflow de recherche interactif. L’utilisateur saisit une question, contrôle l’ampleur et la profondeur de la recherche, et peut activer une passe de vérification pour retirer les affirmations non étayées.
Un panneau « Mercury settings » expose les réglages du modèle : reasoning_effort, sortie en streaming et mode diffusing (qui nécessite le streaming et met à jour la réponse sur place à mesure que les fragments arrivent).
Au lancement, l’app valide la saisie, diffuse la sortie partielle dans un espace réservé, puis affiche la réponse finale avec les temps et des vues déroulantes pour le plan et le paquet de preuves.
Pour essayer, enregistrez le code sous app.py et lancez :
streamlit run app.pyDans ce tutoriel, nous avons construit un agent de recherche optimisé pour la latence, alimenté par Mercury 2. Le système génère un plan de recherche structuré pour une question, exécute une récupération web en parallèle, normalise les résultats en un format de preuves compact et produit une réponse sourcée avec citations.
Nous avons également ajouté une passe de vérification optionnelle qui recontrôle le brouillon à partir des mêmes preuves et atténue les affirmations non étayées. Ce schéma simple Générer–Critiquer–Corriger améliore nettement l’ancrage factuel pour un surcoût de latence minimal.
Au-delà du pipeline cœur, l’application expose les contrôles d’exécution de Mercury 2 : effort de raisonnement, streaming, résumés de raisonnement et mode diffusing. Pour aller plus loin, vous pourriez :
Pour continuer à apprendre à utiliser l’IA dans vos tâches de développement, nous vous recommandons le cours AI-Assisted Coding for Developers.
Meilleurs cours DataCamp
Cursus
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
blog
Lynn Heidmann
Tutoriel
Tutoriel
Josef Waples
8 min