

Che cos'è Mercury 2?
Mercury 2 è il modello di ragionamento veloce di Inception Labs pensato per carichi di lavoro in produzione in cui la latenza si accumula nei loop agentici, nelle pipeline di retrieval e nelle applicazioni ad alta concorrenza.
A differenza degli LLM autoregressivi standard che decodificano un token alla volta, Mercury 2 usa un processo di generazione in stile diffusione che perfeziona il testo in parallelo, motivo per cui può raggiungere throughput molto elevati con il giusto setup di serving.
Le principali capacità di Mercury 2 includono:
Integrazione compatibile con OpenAI
Mercury 2 espone un'API compatibile con OpenAI, il che significa che puoi usare le librerie client OpenAI esistenti semplicemente cambiando la base URL e il nome del modello. Questo gli consente di inserirsi in applicazioni, framework agentici e pipeline di produzione esistenti senza richiedere modifiche all'SDK o all'architettura.
Supporto per contesti lunghi
Il modello supporta una finestra di contesto di circa 128K token, rendendolo adatto a workflow che devono passare grandi insiemi di evidenze, output di strumenti multi-step, tracce di conversazione o stati intermedi strutturati.
Output strutturati e prontezza per agenti
Mercury 2 gestisce in modo affidabile JSON vincolati da schema e supporta interazioni in stile strumenti. Questo abilita casi d'uso come pianificazione di query, generazione di argomenti per strumenti, passaggio di stato strutturato tra passaggi e pipeline di verifica in cui il formato deterministico è importante.
Controlli di ragionamento a runtime
A differenza della maggior parte dei modelli generici, Mercury 2 espone controlli operativi come reasoning_effort (da instant a high), riepiloghi di ragionamento opzionali, output in streaming e streaming in stile diffusione. Questi controlli ti permettono di calibrare il compromesso tra velocità, profondità e interattività per singola chiamata a seconda della fase della pipeline.
Modello di costo orientato alla produzione
La struttura dei prezzi è ottimizzata per carichi di lavoro ad alta frequenza, con bassi costi per token in input e sconti significativi per i token in input in cache. Questo è vantaggioso per loop agentici e pipeline multi-step in cui i prompt di sistema e il contesto vengono riutilizzati in più chiamate al modello.
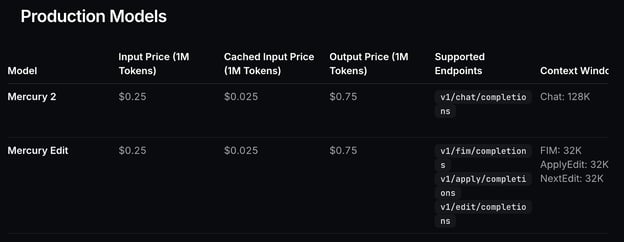
Figura: Prezzi del modello
Come funziona Mercury 2?
Gli LLM tradizionali generano testo in modo autoregressivo, producendo un token alla volta in sequenza.
token 1 - token 2 - token 3… Questo rende la latenza strettamente legata alla lunghezza dell'output, poiché ogni token dipende dal precedente, e la latenza cresce linearmente con la lunghezza dell'output. Diventa un collo di bottiglia nei sistemi agentici in cui potresti eseguire più chiamate al modello per ogni richiesta utente.
Mercury 2 adotta un approccio diverso. Invece del decoding sequenziale, usa un processo di perfezionamento parallelo ispirato alla diffusione. Il modello genera una bozza iniziale e poi perfeziona più token simultaneamente in un numero ridotto di passaggi.
La generazione si comporta più come un editing iterativo che come una digitazione passo dopo passo, il che migliora il throughput e riduce la latenza end-to-end nelle pipeline con più chiamate.
Questo processo di perfezionamento abilita anche la modalità diffusing, in cui le bozze intermedie vengono trasmesse in streaming e migliorate progressivamente nell'interfaccia. Gli utenti possono vedere il testo evolvere verso la sua forma finale in tempo reale, utile soprattutto per demo, applicazioni interattive e interfacce di ricerca live.
Questa architettura rende Mercury 2 particolarmente adatto a sistemi in cui la latenza si accumula su più fasi di ragionamento, piuttosto che su prompt one-shot.
Tutorial su Mercury 2: crea un agente di ricerca multi-step in tempo reale
In questa sezione costruiremo un assistente di ricerca in tempo reale con Mercury 2 che può prendere una domanda complessa, cercare sul web, ragionare su più fonti e restituire una risposta fondata in pochi secondi. Invece di una singola interazione prompt-risposta, il sistema esegue un loop agentico rapido e multi-step, in cui ogni passaggio perfeziona le informazioni necessarie per produrre un risultato affidabile.
A grandi linee, l'applicazione esegue cinque compiti principali:
- Espansione della query: generiamo più query di ricerca mirate (in JSON strutturato) per coprire diversi aspetti della domanda.
- Ricerca web parallela: poi eseguiamo tutte le query in contemporanea per minimizzare la latenza e raccogliere rapidamente fonti diverse.
- Normalizzazione delle evidenze: puliamo e comprimiamo i risultati di ricerca in un JSON di evidenze compatto su cui il modello può ragionare.
- Sintesi basata su fonti: produciamo anche una risposta strutturata usando solo le evidenze fornite, con citazioni in linea come
[S1],[S2]. - Passaggio di verifica opzionale: l'utente può anche eseguire una seconda chiamata al modello che rivede la risposta in bozza e rimuove o attenua eventuali affermazioni non supportate dalle evidenze. La verifica applica un pattern leggero Generate-Critique-Fix, in cui il modello rivede la propria bozza rispetto alle evidenze e la corregge per una base fattuale più solida.
L'applicazione produce due output principali:
- Approfondimenti fondati sulle fonti con citazioni in linea collegate alle evidenze web.
- Trasparenza di esecuzione, incluso il piano di ricerca generato, le fonti recuperate e la latenza per passaggio.
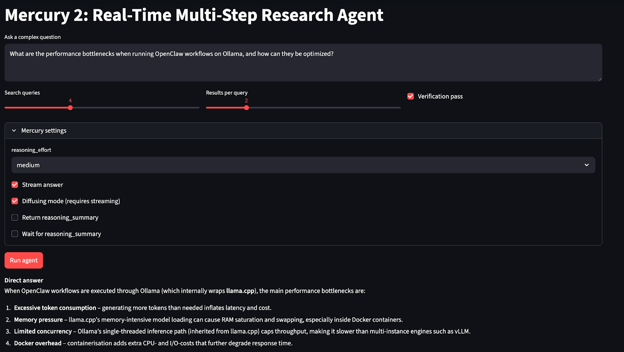
Passaggio 1: ottieni l'accesso all'API
Prima di costruire l'agente di ricerca, dobbiamo ottenere l'accesso all'API di Mercury 2. Poiché Mercury 2 è attualmente disponibile tramite early access, questo passaggio assicura che tu abbia le credenziali e la configurazione dell'endpoint necessarie per effettuare chiamate di inferenza dalla tua applicazione.
Puoi richiedere l'accesso qui: https://www.inceptionlabs.ai/early-access.
Una volta approvato l'account:
- Accedi alla Inception Platform
- Vai a API Keys
- Fai clic su Create API Key
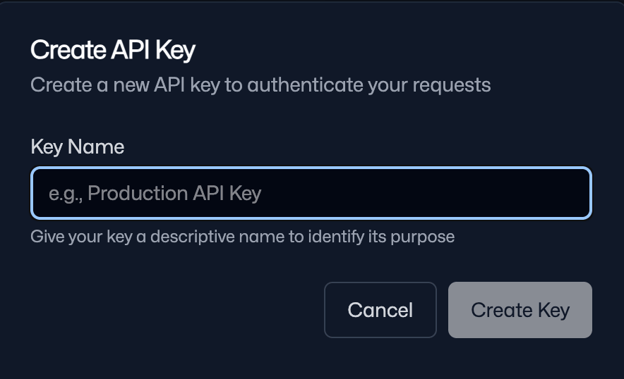
- Assegna un nome e copia la chiave generata
Salva questa chiave in modo sicuro: la userai per autenticare tutte le richieste API.
Nota: alla prima registrazione ottieni 10.000.000 di token gratuiti, sufficienti per eseguire questo esperimento.
Passaggio 2: setup dell'ambiente
Ora che hai accesso all'API, il prossimo passo è preparare l'ambiente locale per costruire ed eseguire l'agente di ricerca con Mercury 2. Poiché l'API Inception è compatibile con OpenAI, possiamo usare il client Python standard di OpenAI insieme a una serie di librerie per l'interfaccia web e la pipeline di ricerca. Salviamo anche la nostra API key come variabile d'ambiente.
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”Installiamo le dipendenze essenziali per eseguire l'agente di ricerca con Mercury 2 e configuriamo un accesso API sicuro. Usiamo il client OpenAI standard per le chiamate al modello, Streamlit per costruire l'interfaccia interattiva, aiohttp per eseguire ricerche web in parallelo a bassa latenza e beautifulsoup4 con lxml per il parsing dei risultati di ricerca.
Dopo l'installazione, imposta INCEPTION_API_KEY come variabile d'ambiente per mantenere sicure le credenziali e permettere all'applicazione di autenticarsi automaticamente a runtime.
Nel prossimo passaggio implementeremo il client Mercury e costruiremo la pipeline agentica multi-step di base.
Passaggio 3: client Mercury
Questo passaggio collega tre elementi: importare le librerie che useremo nell'app, caricare in sicurezza la chiave API dall'ambiente e inizializzare un client OpenAI puntato sulla base URL di Inception.
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)Il frammento di codice sopra inizializza un client Mercury 2 e importa lo stack di supporto per l'applicazione, inclusi Streamlit per la UI, aiohttp per le richieste web asincrone, BeautifulSoup per il parsing dei risultati di ricerca e le utility standard di Python per la gestione JSON, il timing e le strutture dati.
Quindi leggiamo INCEPTION_API_KEY dalla variabile d'ambiente, configuriamo la base URL di Inception per indirizzare correttamente le richieste e impostiamo il nome del modello su "mercury-2" affinché tutte le chiamate successive usino il modello di ragionamento previsto.
Infine, il client OpenAI viene inizializzato con la base URL personalizzata, permettendo di chiamare Mercury 2 usando l'interfaccia standard chat.completions.
Passaggio 4: strumento di ricerca web
Ora ci serve uno step di retrieval che possa recuperare informazioni aggiornate dal web. In questo tutorial implementeremo uno strumento di ricerca usando l'endpoint HTML di DuckDuckGo e analizzeremo direttamente i risultati perché non richiede chiavi API aggiuntive ed è abbastanza veloce per il prototyping.
A grandi linee, implementiamo tre cose:
- Eseguire una query sulla pagina dei risultati HTML di DuckDuckGo
- Analizzare i risultati principali in un formato strutturato
SearchResult - Deduplicare e impacchettare i risultati in un JSON compatto che Mercury possa citare in seguito
DDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceLe utility sopra definiscono quattro componenti chiave:
- Recupero web asincrono: la funzione
ddg_search()interroga l'endpoint HTML di DuckDuckGo usandoaiohttpe analizza la risposta con BeautifulSoup e lxml. Ogni risultato viene estratto in un formato strutturato e la funzione si ferma dopomax_resultsvoci per mantenere bassa la latenza. Questo consente di eseguire più ricerche in parallelo in modo asincrono. - Normalizzazione del testo: l'helper
clean_text()rimuove spaziature extra e artefatti di formattazione per mantenere i frammenti compatti e leggibili. I risultati vengono poi memorizzati usando la dataclassSearchResult, che standardizza l'output e rende le fasi successive indipendenti dalla struttura HTML grezza. - Deduplicazione tra query: quando l'agente esegue più query di ricerca, spesso compaiono ripetutamente le stesse pagine. La funzione
dedupe_results()rimuove i duplicati normalizzando gli URL, assicurando che l'insieme di evidenze resti vario ed efficiente nella finestra di contesto. - Packaging delle evidenze per il ragionamento del modello: la funzione
pack_evidence()converte i risultati in una struttura JSON compatta con identificatori stabili. I frammenti sono tagliati a ~320 caratteri affinché le evidenze combinate rientrino nel contesto del modello e possano essere referenziate dopo con citazioni in linea.
Nota per chi legge:
Questo approccio HTML con DuckDuckGo è adatto al prototyping perché non richiede chiavi API aggiuntive, ma non è una ricerca di livello production:
- I layout HTML possono cambiare e rompere i selettori
- Limitazioni di frequenza/protezioni anti-bot possono bloccare lo scraping
- La qualità e il ranking dei risultati possono variare
Per una versione production-ready, sostituiscilo con una Search API stabile (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search, ecc.) e lascia invariato il resto dell'agente.
Nel prossimo passaggio collegheremo questo livello di retrieval a Mercury 2 affinché il modello possa generare query di ricerca, ragionare sulle evidenze raccolte e produrre una risposta basata sulle fonti.
Passaggio 5: chiamate a Mercury
In questo passaggio incapsuliamo Mercury 2 dietro una piccola interfaccia riutilizzabile che supporta sia output strutturati rigorosi (per la pianificazione) sia generazione di testo in streaming (per la sintesi e la demo di diffusione).
L'obiettivo è mantenere ogni chiamata al modello coerente, esponendo comunque le “manopole di ragionamento” di Mercury e le modalità di streaming tramite un unico oggetto di impostazioni.
def mercury_settings(
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
diffusing: bool = False,
) -> Dict[str, Any]:
return {
"reasoning_effort": reasoning_effort,
"reasoning_summary": reasoning_summary,
"reasoning_summary_wait": reasoning_summary_wait,
"diffusing": diffusing,
}
def mercury_json(
system: str,
user: str,
max_tokens: int = 400,
reasoning_effort: str = "medium",
) -> Dict[str, Any]:
def _call(messages) -> str:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=0.0,
stream=False,
extra_settings=mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
diffusing=False,
),
)
return (resp.choices[0].message.content or "").strip()
text = _call(
[{"role": "system", "content": system}, {"role": "user", "content": user}]
)
try:
return json.loads(text)
except json.JSONDecodeError:
pass
m = re.search(r"\{.*\}", text, flags=re.DOTALL)
if m:
try:
return json.loads(m.group(0))
except json.JSONDecodeError:
pass
repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
repair_user = (
"Fix the following so it is valid JSON and matches the required schema.\n\n"
"REQUIRED SCHEMA:\n"
"{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
"BROKEN OUTPUT:\n"
f"{text}"
)
fixed = _call(
[{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
)
try:
return json.loads(fixed)
except json.JSONDecodeError:
m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
if not m2:
raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
return json.loads(m2.group(0))
def mercury_text(
system: str,
user: str,
max_tokens: int = 950,
temperature: float = 0.3,
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
stream: bool = False,
diffusing: bool = False,
stream_callback=None,
) -> str:
if diffusing:
stream = True
extra_settings = mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
diffusing=diffusing,
)
messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
if not stream:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=False,
extra_settings=extra_settings,
)
return (resp.choices[0].message.content or "").strip()
full = ""
stream_resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=True,
extra_settings=extra_settings,
)
for event in stream_resp:
choices = getattr(event, "choices", None) or []
if not choices:
continue
delta = getattr(choices[0], "delta", None)
chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
if not chunk:
continue
if diffusing:
full = chunk
else:
full += chunk
if stream_callback:
stream_callback(full, {"delta": chunk})
return full.strip()In questo passaggio definiamo funzioni helper con tre componenti chiave:
- Impostazioni delle manopole di ragionamento: la funzione
mercury_settings()centralizza i parametri specifici di Mercury comereasoning_effort,reasoning_summary,reasoning_summary_waitediffusing. Questo mantiene coerente la pipeline e rende semplice collegare gli switch di Streamlit a ogni chiamata al modello senza duplicare la configurazione. - Generazione di JSON allineato allo schema:
mercury_json()si usa quando l'agente ha bisogno di output strutturati. Esegue contemperature=0.0e disabilita streaming/diffusione per massimizzare la stabilità del formato. La funzione prova a fare il parsing del JSON direttamente, poi tenta di estrarre un blocco JSON via regex e infine esegue un passaggio di riparazione che forza il modello a restituire JSON valido che rispetta lo schema richiesto. - Generazione di testo con streaming e diffusione opzionali: la funzione
mercury_text()supporta sia la modalità non in streaming sia quella in streaming. Sediffusing=True, forza automaticamentestream=Truee aggiorna il testo mostrato sovrascrivendo il buffer corrente. Nella modalità di streaming normale, aggiunge i delta per costruire la risposta finale. L'hook opzionalestream_callback()consente alla UI di renderizzare aggiornamenti in tempo reale.
Nel prossimo passaggio useremo questi helper per implementare l'espansione strutturata delle query e collegarli alla pipeline di ricerca web e packaging delle evidenze.
Passaggio 6: espansione strutturata delle query
Ora colleghiamo Mercury 2 e la ricerca web in un ciclo di ricerca end-to-end. L'idea chiave è generare prima un piano di ricerca strutturato, poi forzare la risposta finale a essere fondata sul payload di evidenze, in modo da mettere in mostra i controlli di ragionamento di Mercury e le modalità di streaming/diffusione nella UI.
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
system = (
"Return ONLY valid JSON. No markdown.\n"
"Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
"Rules:\n"
f"- MUST produce at least {max(3, n_queries-2)} queries\n"
"- queries <= 12 words, diverse\n"
"- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
"Output must start with '{' and end with '}'."
)
user = f"Question: {question}\nReturn {n_queries} queries."
out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
queries = (out.get("queries") or [])
subqs = (out.get("subquestions") or [])
must = (out.get("must_cover") or [])
if len(queries) == 0:
queries = [
f"{question} benchmarks",
"vLLM edge inference benchmarks",
"llama.cpp edge inference benchmarks",
"vLLM vs llama.cpp quantization",
"llama.cpp Metal CUDA Vulkan performance",
"vLLM KV cache paged attention memory",
][:n_queries]
out["queries"] = queries[:n_queries]
out["subquestions"] = subqs[: min(6, n_queries)]
out["must_cover"] = must[:6]
return out
def answer_with_citations(
question: str,
evidence: List[Dict[str, str]],
*,
reasoning_effort: str,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream: bool,
diffusing: bool,
stream_callback=None,
) -> str:
system = (
"You are a fast research synthesizer.\n"
"Use ONLY the provided evidence.\n"
"Add inline citations like [S1], [S2] using evidence ids.\n"
"If evidence is insufficient, say what's missing."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
"Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.3,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream,
diffusing=diffusing,
stream_callback=stream_callback,
)
def verify_answer(
question: str,
evidence: List[Dict[str, str]],
draft: str,
*,
reasoning_effort: str,
) -> str:
system = (
"You are a verifier.\n"
"Remove/soften any claim not supported by evidence.\n"
"Keep citations [S#]. Return revised answer."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
f"Draft:\n{draft}"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.2,
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
stream=False,
diffusing=False,
)
async def run_agent(
question: str,
n_queries: int,
max_results_per_query: int,
do_verify: bool,
*,
reasoning_effort: str,
stream_answer: bool,
diffusing: bool,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream_callback=None,
) -> Dict[str, Any]:
t0 = time.perf_counter()
plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
t1 = time.perf_counter()
queries = plan.get("queries", [])
async with aiohttp.ClientSession() as session:
tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
lists = await asyncio.gather(*tasks)
flat = dedupe_results([r for lst in lists for r in lst])
evidence = pack_evidence(flat, max_items=18)
t2 = time.perf_counter()
draft = answer_with_citations(
question,
evidence,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream_answer,
diffusing=diffusing,
stream_callback=stream_callback,
)
t3 = time.perf_counter()
final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
t4 = time.perf_counter()
return {
"plan": plan,
"evidence": evidence,
"answer": final,
"timings_sec": {
"expand": round(t1 - t0, 3),
"search_parallel": round(t2 - t1, 3),
"synthesize": round(t3 - t2, 3),
"verify": round(t4 - t3, 3),
"total": round(t4 - t0, 3),
},
}Questo passaggio collega quattro fasi centrali:
- Pianificazione strutturata delle query: la funzione
expand_query()genera un piano di ricerca strutturato chiedendo a Mercury 2 di restituire JSON rigoroso contenentequeries,subquestionsemust_cover. L'output viene analizzato conmercury_json(), che include la riparazione automatica del JSON, e un set di query di fallback che assicura la continuità dell'agente anche se il modello restituisce un piano vuoto. - Sintesi basata su evidenze con citazioni: la funzione
answer_with_citations()produce la risposta iniziale usando solo le evidenze impacchettate dalla fase di ricerca. Il prompt limita esplicitamente il modello alle sole evidenze fornite e richiede citazioni in linea. L'output include una risposta diretta, i punti chiave e i caveat, mantenendo la risposta concisa e tracciabile alle fonti. - Verifica opzionale per il grounding: la funzione
verify_answer()implementa il pattern Generate-Critique-Fix. Rivaluta la bozza rispetto alle stesse evidenze e rimuove o attenua affermazioni non supportate, preservando i marcatori di citazione. Questo passaggio aggiuntivo riduce le generalizzazioni e migliora la base fattuale con un sovraccarico minimo di latenza. - Orchestrazione con tracciamento delle prestazioni: la funzione
run_agent()coordina l'intero workflow, includendo l'espansione del piano di query, l'esecuzione di ricerche DuckDuckGo in parallelo conaiohttpeasyncio.gather(), la deduplicazione e l'impacchettamento dei risultati in un JSON di evidenze compatto, la generazione della risposta sintetizzata e, opzionalmente, l'esecuzione della verifica.
Passaggio 7: UI in Streamlit
Infine collegheremo il runtime dell'agente (run_agent) a un'interfaccia Streamlit in modo che gli utenti possano inserire una domanda, regolare come l'agente cerca e ispezionare l'intera traccia di esecuzione—risposta finale, tempi, piano di query generato e pacchetto di evidenze.
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
"Ask a complex question",
height=120,
placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
max_results = st.slider("Results per query", 1, 6, 2)
with col3:
do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
stream_answer = st.checkbox("Stream answer", value=False)
diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
if diffusing and not stream_answer:
st.info("Diffusing requires streaming. Enabling streaming automatically.")
stream_answer = True
run = st.button("Run agent", type="primary")
if run:
if not question.strip():
st.warning("Enter a question.")
st.stop()
answer_placeholder = st.empty()
status_placeholder = st.empty()
def _stream_cb(text: str, meta: Dict[str, Any]):
answer_placeholder.markdown(text)
with st.spinner("Running…"):
status_placeholder.caption("Planning → searching → synthesizing…")
out = asyncio.run(
run_agent(
question.strip(),
n_queries,
max_results,
do_verify,
reasoning_effort=reasoning_effort,
stream_answer=stream_answer,
diffusing=diffusing,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream_callback=_stream_cb if stream_answer else None,
)
)
status_placeholder.empty()
st.subheader("Answer")
st.write(out["answer"])
st.subheader("Timings (sec)")
st.json(out["timings_sec"])
with st.expander("Plan (queries / subquestions)"):
st.json(out["plan"])
with st.expander("Evidence (search results)"):
st.json(out["evidence"])Il codice sopra definisce come il livello Streamlit trasformi la funzione run_agent() in un workflow di ricerca interattivo. L'utente inserisce una domanda, controlla l'ampiezza e la profondità della ricerca ed eventualmente abilita un passaggio di verifica che rimuove le affermazioni non supportate.
Un pannello aggiuntivo “Mercury settings” espone le manopole del modello come reasoning_effort, l'output streaming e la modalità diffusing, che richiede lo streaming e aggiorna il placeholder della risposta in-place man mano che arrivano nuovi chunk.
All'avvio, l'app convalida l'input, trasmette in streaming l'output parziale in un placeholder, quindi mostra la risposta finale insieme ai tempi e a viste di debug espandibili per il piano generato e il pacchetto di evidenze.
Per provarlo tu stesso, salva il codice come app.py e avvia:
streamlit run app.pyConclusione
In questo tutorial abbiamo costruito un agente di ricerca attento alla latenza basato su Mercury 2. Il sistema genera un piano di ricerca strutturato per una query dell'utente, quindi esegue il recupero web in parallelo, normalizza i risultati in un formato di evidenze compatto e produce una risposta fondata con citazioni.
Abbiamo anche aggiunto un passaggio di verifica opzionale che ricontrolla la bozza rispetto alle stesse evidenze e attenua le affermazioni non supportate. Questo semplice pattern Generate–Critique–Fix migliora significativamente il grounding fattuale aggiungendo una latenza minima.
Oltre alla pipeline core, l'applicazione espone i controlli runtime di Mercury 2, inclusi l'impegno di ragionamento, l'output in streaming, i riepiloghi di ragionamento e la modalità diffusing. Per estendere ulteriormente il progetto, potresti:
- Sostituire lo scraper DuckDuckGo con una Search API di produzione (Bing, SerpAPI, Brave)
- Mettere in cache risultati di ricerca o piani intermedi per ridurre la latenza ripetuta
- Conservare le evidenze per memoria di sessione o ricerche multi-turn
- Aggiungere un livello di sintesi per una selezione delle evidenze di qualità superiore
Per continuare a imparare come usare l'AI per compiti di sviluppo, ti consiglio il corso AI-Assisted Coding for Developers.
FAQ su Mercury 2
Cosa rende Mercury 2 diverso dagli LLM tradizionali?
Mercury 2 usa un processo di perfezionamento parallelo in stile diffusione, producendo una bozza e migliorandola in più passaggi. Questo consente un throughput più elevato e prestazioni migliori nelle pipeline con più chiamate, dove la latenza si accumula.
Che cos'è la modalità diffusing di Mercury 2?
La modalità diffusing trasmette in streaming le bozze intermedie mentre il modello perfeziona il suo output. Invece di scrivere token per token, il testo viene riscritto e migliorato progressivamente in-place.
Perché includere un passaggio di verifica?
Il passaggio di verifica rivaluta la bozza rispetto alle stesse evidenze e rimuove le affermazioni non supportate. Migliora il grounding con una sola chiamata aggiuntiva al modello.
L'implementazione della ricerca DuckDuckGo è pronta per la produzione?
No. L'approccio di scraping HTML è usato per semplicità e non richiede chiavi API, ma può rompersi se i layout delle pagine cambiano e può subire rate limiting. Per l'uso in produzione, sostituiscilo con una Search API stabile come Bing Web Search, Brave Search o SerpAPI.
Quanto costa Mercury 2?
Mercury 2 è progettato per carichi di lavoro ad alta frequenza, con bassi costi per token in input e sconti per i token in cache. I nuovi utenti attualmente ricevono token gratuiti alla registrazione, sufficienti per seguire questo tutorial e sperimentare con l'agente.

Sono una Google Developers Expert in ML (Gen AI), una Kaggle 3x Expert e una Women Techmakers Ambassador con oltre 3 anni di esperienza nel tech. Ho co-fondato una startup health-tech nel 2020 e sto conseguendo un master in informatica al Georgia Tech, con specializzazione in machine learning.





Mercury 2 è progettato per carichi di lavoro di ragionamento in produzione che coinvolgono workflow agentici come ricerca, pianificazione e pipeline di retrieval, dove i modelli autoregressivi tradizionali diventano lenti a causa del decoding sequenziale. In questo tutorial useremo Mercury 2 per costruire con Streamlit un agente di ricerca multi-step in tempo reale.
Nell'app, l'utente pone una domanda complessa; il sistema la espande in più query di ricerca mirate, recupera i risultati web in parallelo, li comprime in evidenze strutturate e genera una risposta fondata sulle fonti con citazioni in linea.
Un passaggio di verifica opzionale rivede la bozza rispetto alle evidenze e rimuove le affermazioni non supportate. L'interfaccia espone anche i controlli runtime di Mercury, inclusi l'impegno di ragionamento, l'output in streaming e lo streaming in stile diffusione che mostra la risposta mentre viene perfezionata in tempo reale.
Lungo il percorso imparerai a:
reasoning_efforte altri parametri di ragionamentostreamingediffusingper visualizzare il perfezionamento iterativo in tempo realeL'applicazione finale restituisce un piano di ricerca, le fonti delle evidenze e la latenza per passaggio, rendendo il sistema sia veloce sia ispezionabile.