

Mercury 2 là gì?
Mercury 2 là mô hình của Inception Lab về suy luận nhanh, được thiết kế cho khối lượng công việc sản xuất nơi độ trễ cộng dồn trong vòng lặp agent, chuỗi truy xuất và các ứng dụng đồng thời cao.
Không giống các LLM autoregressive tiêu chuẩn giải mã từng token một, Mercury 2 dùng quy trình sinh kiểu khuếch tán (diffusion) để tinh chỉnh văn bản song song, là lý do cốt lõi giúp nó đạt thông lượng cực cao với thiết lập phục vụ phù hợp.
Các khả năng chính của Mercury 2 gồm:
Tích hợp tương thích OpenAI
Mercury 2 cung cấp API tương thích OpenAI, nghĩa là bạn có thể dùng các thư viện client hiện có của OpenAI chỉ bằng cách đổi base URL và tên model. Điều này cho phép tích hợp vào ứng dụng, khung agent và pipeline sản xuất hiện có mà không cần thay đổi SDK hay kiến trúc.
Hỗ trợ ngữ cảnh dài
Mô hình hỗ trợ cửa sổ ngữ cảnh khoảng 128K token, phù hợp cho quy trình cần truyền gói bằng chứng lớn, đầu ra công cụ nhiều bước, lịch sử hội thoại, hoặc trạng thái trung gian có cấu trúc.
Đầu ra có cấu trúc và sẵn sàng cho agent
Mercury 2 xử lý JSON bị ràng buộc theo schema một cách đáng tin cậy và hỗ trợ tương tác kiểu công cụ. Điều này cho phép các trường hợp như lập kế hoạch truy vấn, tạo tham số cho công cụ, truyền trạng thái có cấu trúc giữa các bước và chuỗi xác minh nơi định dạng quyết định.
Điều khiển suy luận trong runtime
Khác với hầu hết các mô hình mục đích chung, Mercury 2 cung cấp các điều khiển vận hành như reasoning_effort (tức thì đến cao), tóm tắt suy luận tùy chọn, xuất dạng streaming và streaming kiểu diffusion. Những núm điều chỉnh này cho phép bạn cân bằng tốc độ, độ sâu và tính tương tác theo từng lần gọi tùy giai đoạn pipeline.
Mô hình chi phí hướng sản xuất
Cấu trúc giá được tối ưu cho khối lượng công việc tần suất cao, với chi phí token đầu vào thấp và giảm giá mạnh cho token đầu vào được cache. Điều này có lợi cho vòng lặp agent và pipeline nhiều bước, nơi prompt hệ thống và ngữ cảnh được tái sử dụng qua nhiều lần gọi mô hình.
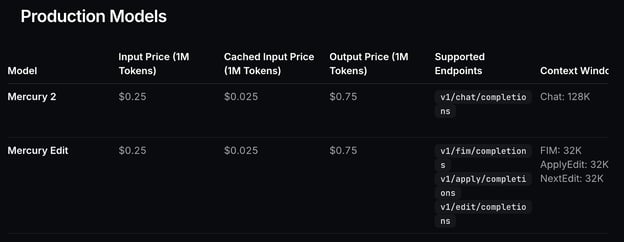
Hình: Giá mô hình
Mercury 2 hoạt động như thế nào?
Các LLM truyền thống sinh văn bản theo cách autoregressive, tạo ra từng token nối tiếp nhau.
token 1 - token 2 - token 3… Điều này khiến độ trễ gắn chặt với độ dài đầu ra vì mỗi token phụ thuộc token trước đó, nên độ trễ tăng tuyến tính theo độ dài. Đây trở thành nút thắt cổ chai trong hệ thống agent, nơi bạn có thể chạy nhiều lần gọi mô hình cho mỗi yêu cầu người dùng.
Mercury 2 tiếp cận khác đi. Thay vì giải mã tuần tự, nó dùng quy trình tinh chỉnh song song lấy cảm hứng từ diffusion. Mô hình tạo một bản nháp ban đầu rồi tinh chỉnh nhiều token đồng thời qua một số ít bước.
Việc sinh giống như chỉnh sửa lặp hơn là gõ từng bước, giúp cải thiện thông lượng và giảm độ trễ đầu-cuối trong các pipeline nhiều lần gọi.
Quy trình tinh chỉnh này cũng cho phép chế độ diffusing, trong đó các bản nháp trung gian được stream và cải thiện dần trong UI. Người dùng có thể quan sát văn bản tiến hóa đến dạng cuối cùng theo thời gian thực, đặc biệt hữu ích cho demo, ứng dụng tương tác và giao diện nghiên cứu trực tiếp.
Kiến trúc này khiến Mercury 2 phù hợp nhất cho các hệ thống nơi độ trễ cộng dồn qua nhiều giai đoạn suy luận hơn là các prompt đơn lẻ.
Hướng dẫn Mercury 2: Xây dựng Agent Nghiên cứu Nhiều Bước Thời Gian Thực
Trong phần này, chúng ta sẽ xây dựng một trợ lý nghiên cứu thời gian thực bằng Mercury 2 có thể nhận câu hỏi phức tạp, tìm kiếm web, suy luận qua nhiều nguồn và trả về câu trả lời có căn cứ trong vài giây. Thay vì một tương tác prompt-phản hồi đơn lẻ, hệ thống chạy vòng lặp agent nhiều bước nhanh, nơi mỗi bước tinh chỉnh thông tin cần thiết để tạo kết quả đáng tin cậy.
Ở mức cao, ứng dụng thực hiện năm nhiệm vụ cốt lõi:
- Mở rộng truy vấn: Chúng tôi tạo nhiều truy vấn tìm kiếm tập trung (ở dạng JSON có cấu trúc) để bao quát các khía cạnh khác nhau của câu hỏi.
- Tìm kiếm web song song: Sau đó, chúng tôi thực thi tất cả truy vấn đồng thời để giảm thiểu độ trễ và nhanh chóng thu thập nguồn đa dạng.
- Chuẩn hóa bằng chứng: Chúng tôi làm sạch và nén kết quả tìm kiếm thành JSON bằng chứng gọn nhẹ để mô hình có thể suy luận.
- Tổng hợp có căn cứ: Chúng tôi cũng tạo câu trả lời có cấu trúc chỉ sử dụng bằng chứng được cung cấp, với trích dẫn nội tuyến như
[S1],[S2]. - Bước xác minh tùy chọn: Người dùng cũng có thể chạy lần gọi mô hình thứ hai để rà soát bản nháp câu trả lời và loại bỏ hoặc làm mềm các khẳng định không được bằng chứng hỗ trợ. Giai đoạn xác minh áp dụng mẫu Generate–Critique–Fix gọn nhẹ, nơi mô hình tự rà soát bản nháp so với bằng chứng và chỉnh sửa để tăng độ vững chắc về mặt thực tế.
Ứng dụng tạo ra hai đầu ra chính:
- Nhận định dựa trên nguồn với trích dẫn nội tuyến liên kết tới bằng chứng web.
- Tính minh bạch thực thi, bao gồm kế hoạch tìm kiếm đã tạo, nguồn đã truy xuất và độ trễ theo từng bước.
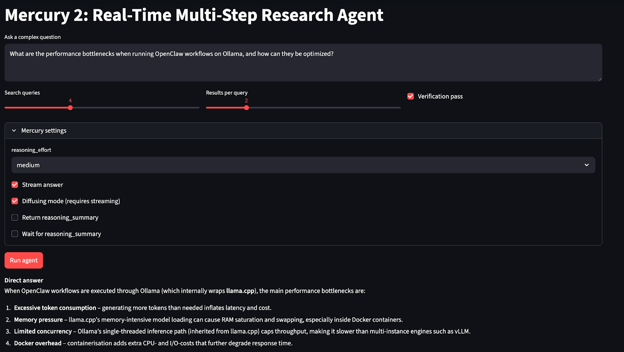
Bước 1: Lấy quyền truy cập API
Trước khi xây dựng agent nghiên cứu, trước hết chúng ta cần quyền truy cập API của Mercury 2. Vì Mercury 2 hiện có qua chương trình truy cập sớm, bước này đảm bảo bạn có thông tin xác thực và cấu hình endpoint để thực hiện các lệnh suy luận từ ứng dụng của mình.
Bạn có thể yêu cầu truy cập tại đây: https://www.inceptionlabs.ai/early-access.
Khi tài khoản của bạn được duyệt:
- Đăng nhập vào Inception Platform
- Đi tới API Keys
- Nhấp Create API Key
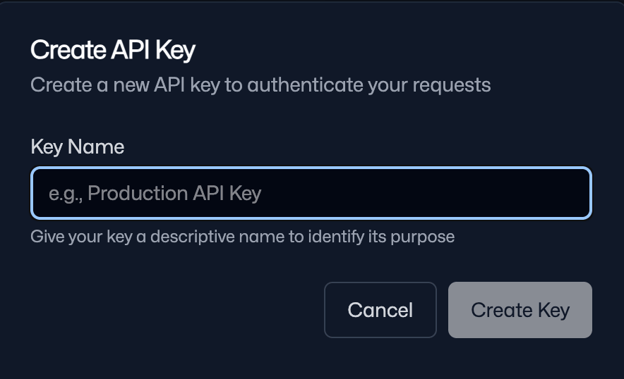
- Đặt tên và sao chép khóa đã tạo
Lưu khóa này an toàn vì bạn sẽ dùng nó để xác thực mọi yêu cầu API.
Lưu ý: Bạn nhận được 10.000.000 token miễn phí khi đăng ký ban đầu, đủ để chạy thử nghiệm này.
Bước 2: Thiết lập môi trường
Giờ bạn đã có quyền API, bước tiếp theo là chuẩn bị môi trường cục bộ để xây dựng và chạy agent nghiên cứu Mercury 2. Vì Inception API tương thích OpenAI, ta có thể dùng client Python OpenAI tiêu chuẩn cùng bộ thư viện cho giao diện web và chuỗi tìm kiếm. Chúng ta cũng lưu API key đã cấp vào biến môi trường.
pip install streamlit openai aiohttp beautifulsoup4 lxml
export INCEPTION_API_KEY="Your_API_Key”Chúng ta cài các phụ thuộc cốt lõi để chạy agent nghiên cứu Mercury 2 và cấu hình truy cập API an toàn. Ta dùng client OpenAI tiêu chuẩn để gọi mô hình, Streamlit để xây dựng giao diện tương tác, aiohttp để chạy tìm kiếm web song song cho truy xuất độ trễ thấp, và beautifulsoup4 với lxml để phân tích kết quả tìm kiếm.
Sau khi cài gói, hãy đặt INCEPTION_API_KEY làm biến môi trường để giữ an toàn thông tin xác thực và cho phép ứng dụng tự động xác thực khi chạy.
Ở bước tiếp theo, chúng ta sẽ hiện thực client Mercury và xây dựng pipeline agent nhiều bước cốt lõi.
Bước 3: Client Mercury
Bước này kết nối ba phần: nhập các thư viện dùng xuyên suốt ứng dụng, tải API key an toàn từ môi trường và khởi tạo client OpenAI trỏ tới base URL của Inception.
import os
import json
import asyncio
import time
import re
from dataclasses import dataclass
from typing import List, Dict, Any
import aiohttp
from bs4 import BeautifulSoup
import streamlit as st
from openai import OpenAI
INCEPTION_API_KEY = os.environ.get("INCEPTION_API_KEY", "").strip()
INCEPTION_BASE_URL = "https://api.inceptionlabs.ai/v1"
MODEL = "mercury-2"
if not INCEPTION_API_KEY:
st.error("Missing INCEPTION_API_KEY. Set it in your shell: export INCEPTION_API_KEY='...'.")
st.stop()
client = OpenAI(api_key=INCEPTION_API_KEY, base_url=INCEPTION_BASE_URL)Đoạn mã trên khởi tạo client Mercury 2 và nhập ngăn xếp hỗ trợ cho ứng dụng, gồm Streamlit cho UI, aiohttp cho yêu cầu web bất đồng bộ, BeautifulSoup để phân tích kết quả tìm kiếm, cùng các tiện ích Python chuẩn cho xử lý JSON, đo thời gian và cấu trúc dữ liệu.
Sau đó, ta đọc INCEPTION_API_KEY từ biến môi trường và cấu hình base URL của Inception để định tuyến yêu cầu chính xác, đồng thời đặt tên mô hình là "mercury-2" để mọi lần gọi sau sử dụng đúng mô hình suy luận dự định.
Cuối cùng, client OpenAI được khởi tạo với base URL tùy chỉnh, cho phép gọi Mercury 2 bằng giao diện chat.completions tiêu chuẩn.
Bước 4: Công cụ tìm kiếm web
Tiếp theo, chúng ta cần bước truy xuất có thể lấy thông tin mới từ web. Trong hướng dẫn này, ta sẽ hiện thực công cụ tìm kiếm dùng endpoint HTML của DuckDuckGo và phân tích trực tiếp kết quả vì không cần thêm API key và đủ nhanh cho việc dựng mẫu.
Ở mức cao, chúng ta hiện thực ba phần:
- Chạy truy vấn với trang kết quả HTML của DuckDuckGo
- Phân tích các kết quả hàng đầu thành định dạng
SearchResultcó cấu trúc - Khử trùng lặp và đóng gói kết quả thành JSON gọn để Mercury có thể trích dẫn sau
DDG_HTML = "https://duckduckgo.com/html/"
@dataclass
class SearchResult:
title: str
url: str
snippet: str
def clean_text(s: str) -> str:
return re.sub(r"\s+", " ", s or "").strip()
async def ddg_search(session: aiohttp.ClientSession, query: str, max_results: int = 4) -> List[SearchResult]:
headers = {"User-Agent": "Mozilla/5.0 (compatible; MercuryResearchAgent/1.0)"}
async with session.get(DDG_HTML, params={"q": query}, headers=headers, timeout=10) as resp:
html = await resp.text()
soup = BeautifulSoup(html, "lxml")
out: List[SearchResult] = []
for res in soup.select("div.result"):
a = res.select_one("a.result__a")
snippet = res.select_one("a.result__snippet") or res.select_one("div.result__snippet")
if not a:
continue
title = clean_text(a.get_text())
url = a.get("href", "")
snip = clean_text(snippet.get_text() if snippet else "")
if title and url:
out.append(SearchResult(title=title, url=url, snippet=snip))
if len(out) >= max_results:
break
return out
def dedupe_results(results: List[SearchResult]) -> List[SearchResult]:
seen = set()
uniq = []
for r in results:
key = r.url.split("#")[0].rstrip("/")
if key in seen:
continue
seen.add(key)
uniq.append(r)
return uniq
def pack_evidence(results: List[SearchResult], max_items: int = 18) -> List[Dict[str, str]]:
evidence = []
for i, r in enumerate(results[:max_items], start=1):
evidence.append({"id": f"S{i}", "title": r.title, "url": r.url, "snippet": r.snippet[:320]})
return evidenceCác tiện ích trên định nghĩa bốn thành phần chủ chốt:
- Truy xuất web bất đồng bộ: Hàm
ddg_search()truy vấn endpoint HTML của DuckDuckGo bằngaiohttpvà phân tích phản hồi với BeautifulSoup và lxml. Mỗi kết quả được trích ra theo định dạng có cấu trúc, và hàm dừng saumax_resultsmục để giữ độ trễ thấp. Điều này cho phép nhiều tìm kiếm chạy song song bất đồng bộ. - Chuẩn hóa văn bản: Trợ giúp
clean_text()loại bỏ khoảng trắng thừa và lỗi định dạng để đoạn trích gọn gàng, dễ đọc. Kết quả được lưu bằng dataclassSearchResult, giúp tiêu chuẩn hóa đầu ra và tách các bước sau khỏi cấu trúc HTML thô. - Khử trùng lặp giữa các truy vấn: Khi agent chạy nhiều truy vấn, cùng trang có thể xuất hiện lặp lại. Hàm
dedupe_results()loại bỏ trùng lặp bằng cách chuẩn hóa URL, đảm bảo bộ bằng chứng đa dạng và hiệu quả trong cửa sổ ngữ cảnh. - Đóng gói bằng chứng cho suy luận mô hình: Hàm
pack_evidence()chuyển kết quả thành cấu trúc JSON gọn với định danh ổn định. Các đoạn trích được cắt xuống ~320 ký tự để tổng bằng chứng vừa với ngữ cảnh mô hình và có thể tham chiếu bằng trích dẫn nội tuyến.
Lưu ý cho người đọc:
Cách dùng HTML DuckDuckGo này thân thiện cho dựng mẫu vì không cần API key bổ sung, nhưng không phải tìm kiếm đạt chuẩn sản xuất:
- Bố cục HTML có thể thay đổi và làm hỏng bộ chọn
- Giới hạn tốc độ/bảo vệ bot có thể chặn việc scraping
- Chất lượng và xếp hạng kết quả có thể biến động
Nếu muốn phiên bản sản xuất, hãy thay bằng Search API ổn định (SerpAPI, Bing Web Search, Google Programmable Search, Brave Search, v.v.) và giữ nguyên phần còn lại của agent.
Tiếp theo, chúng ta sẽ kết nối lớp truy xuất này với Mercury 2 để mô hình có thể tạo truy vấn tìm kiếm, suy luận trên bằng chứng đã thu thập và tạo câu trả lời dựa trên nguồn.
Bước 5: Gọi Mercury
Trong bước này, chúng ta bọc Mercury 2 phía sau một giao diện nhỏ, có thể tái sử dụng, hỗ trợ cả đầu ra có cấu trúc nghiêm ngặt (cho lập kế hoạch) và sinh văn bản dạng stream (cho tổng hợp và demo diffusing).
Mục tiêu là giữ mọi lần gọi mô hình nhất quán, đồng thời vẫn phơi bày các “núm suy luận” và chế độ streaming của Mercury thông qua một đối tượng cài đặt duy nhất.
def mercury_settings(
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
diffusing: bool = False,
) -> Dict[str, Any]:
return {
"reasoning_effort": reasoning_effort,
"reasoning_summary": reasoning_summary,
"reasoning_summary_wait": reasoning_summary_wait,
"diffusing": diffusing,
}
def mercury_json(
system: str,
user: str,
max_tokens: int = 400,
reasoning_effort: str = "medium",
) -> Dict[str, Any]:
def _call(messages) -> str:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=0.0,
stream=False,
extra_settings=mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
diffusing=False,
),
)
return (resp.choices[0].message.content or "").strip()
text = _call(
[{"role": "system", "content": system}, {"role": "user", "content": user}]
)
try:
return json.loads(text)
except json.JSONDecodeError:
pass
m = re.search(r"\{.*\}", text, flags=re.DOTALL)
if m:
try:
return json.loads(m.group(0))
except json.JSONDecodeError:
pass
repair_system = "You are a JSON repair tool. Return ONLY valid JSON. No markdown, no commentary."
repair_user = (
"Fix the following so it is valid JSON and matches the required schema.\n\n"
"REQUIRED SCHEMA:\n"
"{\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n\n"
"BROKEN OUTPUT:\n"
f"{text}"
)
fixed = _call(
[{"role": "system", "content": repair_system}, {"role": "user", "content": repair_user}]
)
try:
return json.loads(fixed)
except json.JSONDecodeError:
m2 = re.search(r"\{.*\}", fixed, flags=re.DOTALL)
if not m2:
raise ValueError(f"Non-JSON from model even after repair:\n{fixed[:1000]}")
return json.loads(m2.group(0))
def mercury_text(
system: str,
user: str,
max_tokens: int = 950,
temperature: float = 0.3,
reasoning_effort: str = "medium",
reasoning_summary: bool = False,
reasoning_summary_wait: bool = False,
stream: bool = False,
diffusing: bool = False,
stream_callback=None,
) -> str:
if diffusing:
stream = True
extra_settings = mercury_settings(
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
diffusing=diffusing,
)
messages = [{"role": "system", "content": system}, {"role": "user", "content": user}]
if not stream:
resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=False,
extra_settings=extra_settings,
)
return (resp.choices[0].message.content or "").strip()
full = ""
stream_resp = client.chat.completions.create(
model=MODEL,
messages=messages,
max_tokens=max_tokens,
temperature=temperature,
stream=True,
extra_settings=extra_settings,
)
for event in stream_resp:
choices = getattr(event, "choices", None) or []
if not choices:
continue
delta = getattr(choices[0], "delta", None)
chunk = (getattr(delta, "content", None) or "") if delta is not None else ""
if not chunk:
continue
if diffusing:
full = chunk
else:
full += chunk
if stream_callback:
stream_callback(full, {"delta": chunk})
return full.strip()Trong bước này, chúng ta định nghĩa các hàm trợ giúp với ba thành phần chính:
- Cài đặt núm suy luận: Hàm
mercury_settings()tập trung các tham số đặc thù Mercury nhưreasoning_effort,reasoning_summary,reasoning_summary_waitvàdiffusing. Điều này giữ pipeline nhất quán và giúp nối trực tiếp các công tắc của Streamlit vào mọi lần gọi mô hình mà không lặp cấu hình. - Sinh JSON bám schema:
mercury_json()dùng khi agent cần đầu ra có cấu trúc. Hàm chạy vớitemperature=0.0và tắt streaming/diffusion để tối đa ổn định định dạng. Hàm cố gắng parse JSON trực tiếp, rồi thử trích khối JSON qua regex, cuối cùng rơi về bước sửa chữa buộc mô hình trả JSON hợp lệ khớp schema yêu cầu. - Sinh văn bản với streaming và diffusion tùy chọn: Hàm
mercury_text()hỗ trợ cả chế độ không stream và stream. Nếudiffusing=True, hàm tự động bậtstream=Truevà cập nhật văn bản hiển thị bằng cách ghi đè bộ đệm hiện tại. Ở chế độ streaming bình thường, hàm nối delta để tạo phản hồi cuối. Hook tùy chọnstream_callback()cho phép UI hiển thị cập nhật trực tiếp.
Ở bước tiếp theo, ta sẽ dùng các trợ giúp này để hiện thực mở rộng truy vấn có cấu trúc và kết nối với chuỗi tìm kiếm web và đóng gói bằng chứng.
Bước 6: Mở rộng truy vấn có cấu trúc
Giờ chúng ta kết nối Mercury 2 và tìm kiếm web thành vòng lặp nghiên cứu đầu-cuối. Ý tưởng chính là trước hết tạo kế hoạch tìm kiếm có cấu trúc, sau đó buộc câu trả lời cuối bám vào gói bằng chứng, nhằm trình diễn các điều khiển suy luận và chế độ streaming/diffusing của Mercury trong UI.
def expand_query(question: str, n_queries: int = 6, reasoning_effort: str = "medium") -> Dict[str, Any]:
system = (
"Return ONLY valid JSON. No markdown.\n"
"Schema: {\"queries\": [string], \"subquestions\": [string], \"must_cover\": [string]}\n"
"Rules:\n"
f"- MUST produce at least {max(3, n_queries-2)} queries\n"
"- queries <= 12 words, diverse\n"
"- include: definitions, official docs, benchmarks, edge deployment, counterarguments\n"
"Output must start with '{' and end with '}'."
)
user = f"Question: {question}\nReturn {n_queries} queries."
out = mercury_json(system, user, max_tokens=320, reasoning_effort=reasoning_effort)
queries = (out.get("queries") or [])
subqs = (out.get("subquestions") or [])
must = (out.get("must_cover") or [])
if len(queries) == 0:
queries = [
f"{question} benchmarks",
"vLLM edge inference benchmarks",
"llama.cpp edge inference benchmarks",
"vLLM vs llama.cpp quantization",
"llama.cpp Metal CUDA Vulkan performance",
"vLLM KV cache paged attention memory",
][:n_queries]
out["queries"] = queries[:n_queries]
out["subquestions"] = subqs[: min(6, n_queries)]
out["must_cover"] = must[:6]
return out
def answer_with_citations(
question: str,
evidence: List[Dict[str, str]],
*,
reasoning_effort: str,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream: bool,
diffusing: bool,
stream_callback=None,
) -> str:
system = (
"You are a fast research synthesizer.\n"
"Use ONLY the provided evidence.\n"
"Add inline citations like [S1], [S2] using evidence ids.\n"
"If evidence is insufficient, say what's missing."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
"Deliver:\n1) Direct answer\n2) Key insights (3-6 bullets)\n3) Caveats/unknowns"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.3,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream,
diffusing=diffusing,
stream_callback=stream_callback,
)
def verify_answer(
question: str,
evidence: List[Dict[str, str]],
draft: str,
*,
reasoning_effort: str,
) -> str:
system = (
"You are a verifier.\n"
"Remove/soften any claim not supported by evidence.\n"
"Keep citations [S#]. Return revised answer."
)
user = (
f"Question:\n{question}\n\n"
f"Evidence JSON:\n{json.dumps(evidence, ensure_ascii=False)}\n\n"
f"Draft:\n{draft}"
)
return mercury_text(
system,
user,
max_tokens=950,
temperature=0.2,
reasoning_effort=reasoning_effort,
reasoning_summary=False,
reasoning_summary_wait=False,
stream=False,
diffusing=False,
)
async def run_agent(
question: str,
n_queries: int,
max_results_per_query: int,
do_verify: bool,
*,
reasoning_effort: str,
stream_answer: bool,
diffusing: bool,
reasoning_summary: bool,
reasoning_summary_wait: bool,
stream_callback=None,
) -> Dict[str, Any]:
t0 = time.perf_counter()
plan = expand_query(question, n_queries=n_queries, reasoning_effort=reasoning_effort)
t1 = time.perf_counter()
queries = plan.get("queries", [])
async with aiohttp.ClientSession() as session:
tasks = [ddg_search(session, q, max_results=max_results_per_query) for q in queries]
lists = await asyncio.gather(*tasks)
flat = dedupe_results([r for lst in lists for r in lst])
evidence = pack_evidence(flat, max_items=18)
t2 = time.perf_counter()
draft = answer_with_citations(
question,
evidence,
reasoning_effort=reasoning_effort,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream=stream_answer,
diffusing=diffusing,
stream_callback=stream_callback,
)
t3 = time.perf_counter()
final = verify_answer(question, evidence, draft, reasoning_effort=reasoning_effort) if do_verify else draft
t4 = time.perf_counter()
return {
"plan": plan,
"evidence": evidence,
"answer": final,
"timings_sec": {
"expand": round(t1 - t0, 3),
"search_parallel": round(t2 - t1, 3),
"synthesize": round(t3 - t2, 3),
"verify": round(t4 - t3, 3),
"total": round(t4 - t0, 3),
},
}Bước này kết nối bốn giai đoạn cốt lõi:
- Lập kế hoạch truy vấn có cấu trúc: Hàm
expand_query()tạo kế hoạch nghiên cứu có cấu trúc bằng cách yêu cầu Mercury 2 trả JSON nghiêm ngặt chứaqueries,subquestionsvàmust_cover. Đầu ra được phân tích bằngmercury_json(), gồm sửa JSON tự động, và tập truy vấn dự phòng đảm bảo agent tiếp tục ngay cả khi mô hình trả kế hoạch rỗng. - Tổng hợp dựa trên bằng chứng kèm trích dẫn: Hàm
answer_with_citations()tạo phản hồi ban đầu chỉ dùng bộ bằng chứng đã đóng gói từ bước tìm kiếm. Prompt hạn chế rõ mô hình chỉ dùng bằng chứng được cung cấp và yêu cầu trích dẫn nội tuyến. Đầu ra gồm câu trả lời trực tiếp, các insight chính và lưu ý, đảm bảo phản hồi cô đọng và truy nguyên tới nguồn. - Xác minh tùy chọn để tăng căn cứ: Hàm
verify_answer()hiện thực mẫu Generate–Critique–Fix. Nó đánh giá lại bản nháp so với cùng bằng chứng và loại bỏ hoặc làm mềm các khẳng định không được hỗ trợ, đồng thời giữ dấu trích dẫn. Bước bổ sung này giảm khái quát hóa quá mức và cải thiện tính bám sự thật với chi phí độ trễ tối thiểu. - Điều phối kèm theo theo dõi hiệu năng: Hàm
run_agent()điều phối toàn bộ luồng, gồm mở rộng kế hoạch truy vấn, thực thi tìm kiếm DuckDuckGo song song bằngaiohttpvàasyncio.gather(), khử trùng lặp và đóng gói kết quả thành JSON bằng chứng gọn, tạo câu trả lời tổng hợp và tùy chọn chạy bước xác minh.
Bước 7: Giao diện Streamlit
Cuối cùng, chúng ta sẽ kết nối runtime của agent (run_agent) với giao diện Streamlit để người dùng nhập câu hỏi, tinh chỉnh cách agent tìm kiếm và kiểm tra toàn bộ vết thực thi—câu trả lời cuối, thời gian, kế hoạch truy vấn đã tạo và gói bằng chứng.
st.set_page_config(page_title="Mercury 2 Research Agent", layout="wide")
st.title("Mercury 2: Real-Time Multi-Step Research Agent")
question = st.text_area(
"Ask a complex question",
height=120,
placeholder="e.g., Compare vLLM vs llama.cpp for edge inference...",
)
col1, col2, col3 = st.columns(3)
with col1:
n_queries = st.slider("Search queries", 2, 8, 4)
with col2:
max_results = st.slider("Results per query", 1, 6, 2)
with col3:
do_verify = st.checkbox("Verification pass", value=False)
with st.expander("Mercury settings", expanded=False):
reasoning_effort = st.selectbox("reasoning_effort", ["instant", "low", "medium", "high"], index=2)
stream_answer = st.checkbox("Stream answer", value=False)
diffusing = st.checkbox("Diffusing mode (requires streaming)", value=False)
reasoning_summary = st.checkbox("Return reasoning_summary", value=False)
reasoning_summary_wait = st.checkbox("Wait for reasoning_summary", value=False)
if diffusing and not stream_answer:
st.info("Diffusing requires streaming. Enabling streaming automatically.")
stream_answer = True
run = st.button("Run agent", type="primary")
if run:
if not question.strip():
st.warning("Enter a question.")
st.stop()
answer_placeholder = st.empty()
status_placeholder = st.empty()
def _stream_cb(text: str, meta: Dict[str, Any]):
answer_placeholder.markdown(text)
with st.spinner("Running…"):
status_placeholder.caption("Planning → searching → synthesizing…")
out = asyncio.run(
run_agent(
question.strip(),
n_queries,
max_results,
do_verify,
reasoning_effort=reasoning_effort,
stream_answer=stream_answer,
diffusing=diffusing,
reasoning_summary=reasoning_summary,
reasoning_summary_wait=reasoning_summary_wait,
stream_callback=_stream_cb if stream_answer else None,
)
)
status_placeholder.empty()
st.subheader("Answer")
st.write(out["answer"])
st.subheader("Timings (sec)")
st.json(out["timings_sec"])
with st.expander("Plan (queries / subquestions)"):
st.json(out["plan"])
with st.expander("Evidence (search results)"):
st.json(out["evidence"])Đoạn mã trên định nghĩa cách lớp Streamlit biến hàm run_agent() thành luồng nghiên cứu tương tác. Người dùng nhập câu hỏi, điều khiển bề rộng và chiều sâu tìm kiếm, và tùy chọn bật bước xác minh để loại bỏ các khẳng định không được hỗ trợ.
Bảng “Mercury settings” bổ sung phơi bày các núm mô hình như reasoning_effort, xuất streaming và chế độ diffusing, chế độ này yêu cầu streaming và cập nhật vùng chứa câu trả lời tại chỗ khi các phần mới đến.
Khi chạy, ứng dụng kiểm tra hợp lệ đầu vào, stream đầu ra từng phần vào vùng giữ chỗ, sau đó hiển thị câu trả lời cuối cùng cùng thời gian và các khung xem gỡ lỗi có thể mở rộng cho kế hoạch đã tạo và gói bằng chứng.
Để tự thử, lưu mã thành app.py và khởi chạy:
streamlit run app.pyKết luận
Trong hướng dẫn này, chúng ta đã xây dựng một agent nghiên cứu nhận thức độ trễ chạy bằng Mercury 2. Hệ thống tạo kế hoạch tìm kiếm có cấu trúc cho truy vấn người dùng, sau đó thực thi truy xuất web song song, chuẩn hóa kết quả thành định dạng bằng chứng gọn và tạo câu trả lời có căn cứ kèm trích dẫn.
Chúng ta cũng thêm bước xác minh tùy chọn để rà soát bản nháp so với cùng bằng chứng và làm mềm các khẳng định không được hỗ trợ. Mẫu Generate–Critique–Fix đơn giản này cải thiện đáng kể tính bám sự thật trong khi chỉ tăng độ trễ tối thiểu.
Ngoài pipeline cốt lõi, ứng dụng còn phơi bày các điều khiển runtime của Mercury 2, bao gồm nỗ lực suy luận, xuất dạng streaming, tóm tắt suy luận và chế độ diffusing. Để mở rộng dự án này, bạn có thể:
- Thay trình trích HTML DuckDuckGo bằng Search API sản xuất (Bing, SerpAPI, Brave)
- Cache kết quả tìm kiếm hoặc kế hoạch trung gian để giảm độ trễ lặp lại
- Lưu trữ bằng chứng cho bộ nhớ phiên hoặc nghiên cứu nhiều lượt
- Thêm lớp tóm tắt để chọn bằng chứng chất lượng cao hơn
Để tiếp tục học về việc dùng AI cho các tác vụ phát triển, tôi gợi ý khóa học AI-Assisted Coding for Developers.
Câu hỏi thường gặp về Mercury 2
Điều gì khiến Mercury 2 khác với các LLM truyền thống?
Mercury 2 sử dụng quy trình tinh chỉnh song song kiểu khuếch tán, tạo một bản nháp và cải thiện nó qua vài bước. Điều này cho phép thông lượng cao hơn và hiệu năng tốt hơn trong các pipeline nhiều lần gọi nơi độ trễ tích lũy.
Chế độ diffusing của Mercury 2 là gì?
Chế độ diffusing stream các bản nháp trung gian khi mô hình tinh chỉnh đầu ra. Thay vì gõ từng token, văn bản được viết lại và cải thiện dần ngay tại chỗ.
Tại sao cần thêm bước xác minh?
Bước xác minh đánh giá lại bản nháp so với cùng bằng chứng và loại bỏ các khẳng định không được hỗ trợ. Điều này cải thiện tính căn cứ chỉ với một lần gọi mô hình bổ sung.
Triển khai tìm kiếm DuckDuckGo đã sẵn sàng cho sản xuất chưa?
Không. Cách scraping HTML được dùng vì đơn giản và không cần API key, nhưng có thể hỏng nếu bố cục trang thay đổi và có thể bị giới hạn tốc độ. Cho môi trường sản xuất, hãy thay bằng Search API ổn định như Bing Web Search, Brave Search hoặc SerpAPI.
Mercury 2 có giá bao nhiêu?
Mercury 2 được thiết kế cho khối lượng công việc tần suất cao với chi phí token đầu vào thấp và token được cache được giảm giá. Hiện người dùng mới nhận token miễn phí khi đăng ký, đủ để chạy hướng dẫn này và thử nghiệm với agent.

Tôi là Chuyên gia Google Developers trong lĩnh vực ML (Gen AI), Chuyên gia Kaggle 3x và Đại sứ Women Techmakers với hơn 3 năm kinh nghiệm trong ngành công nghệ. Tôi đồng sáng lập một startup công nghệ y tế vào năm 2020 và hiện đang theo học thạc sĩ khoa học máy tính tại Georgia Tech, chuyên sâu về học máy.


Mercury 2 được thiết kế cho khối lượng công việc suy luận trong sản xuất, liên quan đến các quy trình agent như tìm kiếm, lập kế hoạch và chuỗi truy xuất, nơi các mô hình autoregressive truyền thống trở nên chậm do giải mã tuần tự. Trong hướng dẫn này, chúng ta sẽ dùng Mercury 2 để xây dựng một agent nghiên cứu nhiều bước thời gian thực với Streamlit.
Trong ứng dụng, người dùng đặt một câu hỏi phức tạp, sau đó hệ thống mở rộng nó thành nhiều truy vấn tìm kiếm tập trung, truy xuất kết quả web song song, nén chúng thành bằng chứng có cấu trúc và tạo ra câu trả lời dựa trên nguồn kèm trích dẫn nội tuyến.
Một bước xác minh tùy chọn sẽ rà soát bản nháp so với bằng chứng và loại bỏ các khẳng định không được hỗ trợ. Giao diện cũng cung cấp các điều khiển runtime của Mercury, bao gồm nỗ lực suy luận, xuất dữ liệu dạng streaming và chế độ khuếch tán kiểu diffusion hiển thị phản hồi được tinh chỉnh theo thời gian thực.
Trong quá trình thực hiện, bạn sẽ học cách:
reasoning_effortvà các núm suy luận khácstreamingvàdiffusingđể trực quan hóa việc tinh chỉnh lặp lại theo thời gian thựcỨng dụng cuối cùng trả về kế hoạch tìm kiếm, nguồn bằng chứng và độ trễ theo từng bước, giúp hệ thống vừa nhanh vừa dễ kiểm tra.