
कोर्स
बिज़नेस के लिए मशीन लर्निंग
2 घंटा
47.7K
मशीन लर्निंग में एक सामान्य चुनौती श्रेणीबद्ध वेरिएबल्स (जैसे रंग, उत्पाद प्रकार, या स्थान) से निपटना है, क्योंकि एल्गोरिद्म आमतौर पर संख्यात्मक इनपुट मांगते हैं। इस समस्या का एक समाधान है वन-हॉट एनकोडिंग।
वन-हॉट एनकोडिंग श्रेणीबद्ध डेटा को संख्यात्मक वेक्टर के रूप में दर्शाने की तकनीक है, जिसमें प्रत्येक अद्वितीय श्रेणी को एक बाइनरी कॉलम द्वारा दर्शाया जाता है—1 उसकी उपस्थिति और 0 उसकी अनुपस्थिति को दर्शाता है।
इस लेख में, हम वन-हॉट एनकोडिंग की अवधारणा, इसके लाभ, और Python में Pandas तथा Scikit-learn जैसी लाइब्रेरी की मदद से इसके व्यावहारिक कार्यान्वयन की पड़ताल करेंगे।
यदि आप मशीन लर्निंग पर एक क्यूरेटेड पाठ्यक्रम खोज रहे हैं, तो इस चार-कोर्स ट्रैक को देखें: Machine Learning Fundamentals With Python।
वन-हॉट एनकोडिंग श्रेणीबद्ध वेरिएबल्स को ऐसे फ़ॉर्मेट में बदलने की विधि है जिसे मशीन लर्निंग एल्गोरिद्म को भविष्यवाणी बेहतर करने के लिए दिया जा सके। इसमें किसी फ़ीचर की हर अद्वितीय श्रेणी के लिए नए बाइनरी कॉलम बनाए जाते हैं। प्रत्येक कॉलम एक अद्वितीय श्रेणी का प्रतिनिधित्व करता है, और 1 या 0 उस श्रेणी की उपस्थिति या अनुपस्थिति को दर्शाता है।
आइए एक उदाहरण से समझते हैं कि वन-हॉट एनकोडिंग कैसे काम करती है। मान लीजिए हमारे पास एक डेटासेट है जिसमें एक ही श्रेणीबद्ध फीचर Color है, जो तीन मान ले सकता है: Red, Green, और Blue। वन-हॉट एनकोडिंग का उपयोग करके, हम इस फीचर को इस प्रकार रूपांतरित कर सकते हैं:
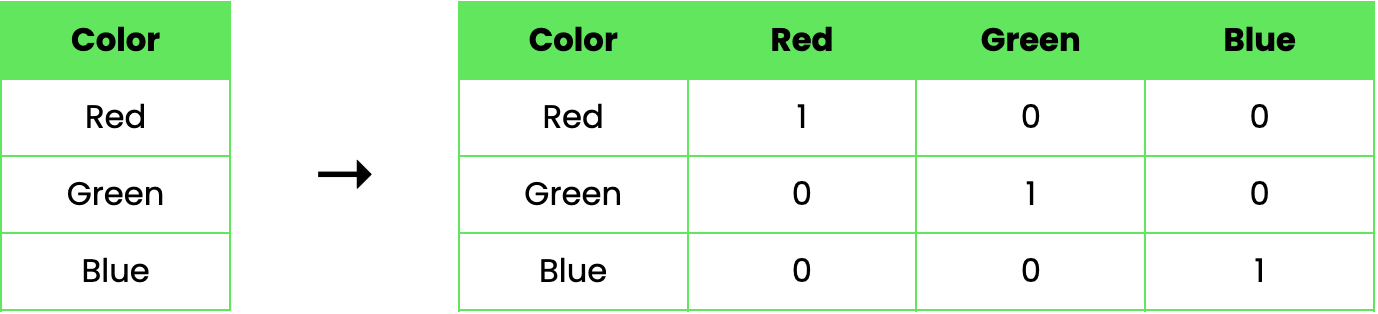
इस उदाहरण में, मूल "Color" कॉलम को तीन नए बाइनरी कॉलम से बदल दिया गया है, जिनमें से प्रत्येक एक रंग का प्रतिनिधित्व करता है। मान 1 उस पंक्ति में उस रंग की उपस्थिति को दर्शाता है, जबकि 0 उसकी अनुपस्थिति को।
कई कारणों से डेटा प्रीप्रोसेसिंग में वन-हॉट एनकोडिंग एक आवश्यक तकनीक है। यह श्रेणीबद्ध डेटा को ऐसे फ़ॉर्मेट में बदलती है जिसे मशीन लर्निंग मॉडल आसानी से समझ और उपयोग कर सकें। यह रूपांतरण प्रत्येक श्रेणी को स्वतंत्र रूप से ट्रीट करने देता है, बिना उनके बीच किसी कृत्रिम संबंध का संकेत दिए।
इसके अलावा, कई डेटा प्रोसेसिंग और मशीन लर्निंग लाइब्रेरी वन-हॉट एनकोडिंग को सपोर्ट करती हैं। यह डेटा प्रीप्रोसेसिंग वर्कफ़्लो में सहजता से फिट बैठती है, जिससे विभिन्न एल्गोरिद्म के लिए डेटासेट तैयार करना आसान हो जाता है।
अधिकांश मशीन लर्निंग एल्गोरिद्म गणनाएँ करने के लिए संख्यात्मक इनपुट मांगते हैं। इसलिए, श्रेणीबद्ध डेटा को संख्यात्मक फ़ॉर्मेट में बदला जाना चाहिए ताकि ये एल्गोरिद्म उसे प्रभावी ढंग से उपयोग कर सकें। वन-हॉट एनकोडिंग यह रूपांतरण करने का सीधा तरीका देती है, जिससे श्रेणीबद्ध वेरिएबल्स को मॉडल में एकीकृत किया जा सके।
लेबल एनकोडिंग श्रेणीबद्ध डेटा को संख्यात्मक मानों में बदलने की एक और विधि है, जहाँ प्रत्येक श्रेणी को एक अद्वितीय नंबर दिया जाता है। हालाँकि, यह तरीका समस्या पैदा कर सकता है क्योंकि इससे श्रेणियों के बीच ऐसा क्रम या रैंकिंग सुझ सकती है जो वास्तव में मौजूद नहीं है।
उदाहरण के लिए, Red को 1, Green को 2, और Blue को 3 असाइन करने से मॉडल यह समझ सकता है कि Green Red से बड़ा है और Blue दोनों से बड़ा है। यह गलतफहमी मॉडल के प्रदर्शन को नकारात्मक रूप से प्रभावित कर सकती है।
वन-हॉट एनकोडिंग इस समस्या को प्रत्येक श्रेणी के लिए अलग बाइनरी कॉलम बनाकर हल करती है। इस तरह, मॉडल यह देख सकता है कि प्रत्येक श्रेणी स्वतंत्र है और अन्य से असंबद्ध है।
जब श्रेणीबद्ध डेटा में अंतर्निहित क्रमबद्ध संबंध हो—अर्थात श्रेणियों का एक सार्थक क्रम या रैंकिंग हो—तो लेबल एनकोडिंग उपयोगी होती है। ऐसे मामलों में, लेबल एनकोडिंग द्वारा दिए गए संख्यात्मक मान इस क्रम का प्रभावी रूप से प्रतिनिधित्व कर सकते हैं, जिससे यह उपयुक्त विकल्प बनता है।
एक डेटासेट पर विचार करें जिसमें शिक्षा स्तर को दर्शाने वाला फीचर हो। श्रेणियाँ हैं:
High SchoolBachelor's DegreeMaster's DegreePhDइन श्रेणियों का स्पष्ट क्रम है, जहाँ PhD Master's Degree से उच्च स्तर का प्रतिनिधित्व करता है, जो बदले में Bachelor's Degree से ऊपर है, और इसी प्रकार। इस स्थिति में, लेबल एनकोडिंग डेटा की क्रमबद्ध प्रकृति को प्रभावी रूप से कैप्चर कर सकती है:
इस उदाहरण में, संख्यात्मक मान शिक्षा स्तरों की प्रगति को दर्शाते हैं, जिससे लेबल एनकोडिंग उपयुक्त विकल्प बन जाती है। मॉडल इन मानों की सही व्याख्या कर सकता है, यह समझते हुए कि बड़े नंबर उच्च शिक्षा स्तर के अनुरूप हैं।
अब जब हम समझ गए हैं कि वन-हॉट एनकोडिंग क्या है और यह क्यों महत्वपूर्ण है, तो आइए देखें कि इसे Python में कैसे लागू किया जाए।
Python में Pandas और Scikit-learn जैसी शक्तिशाली लाइब्रेरी उपलब्ध हैं, जो वन-हॉट एनकोडिंग करने के सुविधाजनक और कुशल तरीके देती हैं।
इस खंड में, हम इन लाइब्रेरी का उपयोग करके वन-हॉट एनकोडिंग लागू करने की चरण-दर-चरण प्रक्रिया से गुजरेंगे। हम Pandas के get_dummies() फ़ंक्शन से शुरुआत करेंगे, जो सीधे-सादे एनकोडिंग कार्यों के लिए तेज़ और आसान है। फिर हम Scikit-learn के OneHotEncoder की खोज करेंगे, जो अधिक लचीलापन और नियंत्रण देता है—विशेषकर जटिल एनकोडिंग आवश्यकताओं के लिए उपयोगी।
get_dummies() का उपयोगPandas एक बहुत ही सुविधाजनक फ़ंक्शन get_dummies() देता है, जो सीधे DataFrame से वन-हॉट एनकोडेड कॉलम बना देता है।
इसे इस तरह उपयोग कर सकते हैं (हम नीचे कोड को चरण-दर-चरण समझाएँगे):
import pandas as pd

# Sample data
data = {'Color': ['Red', 'Green', 'Blue', 'Red']}
df = pd.DataFrame(data)

# Applying one-hot encoding
df_encoded = pd.get_dummies(df, dtype=int)

# Displaying the encoded DataFrame
print(df_encoded)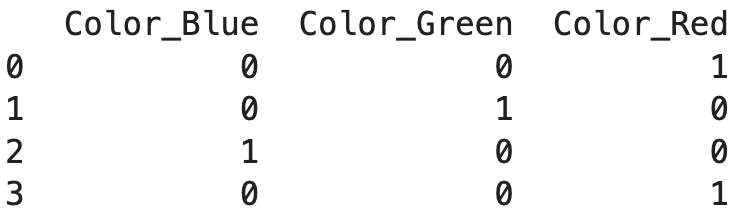
पहले, हम Pandas लाइब्रेरी इम्पोर्ट करते हैं। फिर, हम data नाम की एक डिक्शनरी बनाते हैं जिसमें एक ही कुंजी 'Color' है और मान के रूप में रंगों की सूची है। इसके बाद हम इस डिक्शनरी को Pandas DataFrame df में बदलते हैं। DataFrame इस प्रकार दिखता है:
   Color

0    Red

1  Green

2   Blue

3    Red
हम pd.get_dummies() फ़ंक्शन का उपयोग करके DataFrame df पर वन-हॉट एनकोडिंग लागू करते हैं। यह फ़ंक्शन स्वतः श्रेणीबद्ध कॉलम(ों) का पता लगाता है और प्रत्येक अद्वितीय श्रेणी के लिए नए बाइनरी कॉलम बनाता है। dtype=int आर्ग्युमेंट सुनिश्चित करता है कि एनकोडिंग डिफ़ॉल्ट बूलियन के बजाय 1 और 0 के साथ हो। परिणामी DataFrame df_encoded इस प्रकार दिखता है:
       Color_Blue  Color_Green  Color_Red

0           0            0          1

1           0            1          0

2           1            0          0

3 0 0 1OneHotEncoder का उपयोगएनकोडिंग प्रक्रिया पर अधिक लचीलापन और नियंत्रण के लिए, Scikit-learn OneHotEncoder क्लास प्रदान करता है। यह क्लास उन्नत विकल्प देता है, जैसे अज्ञात श्रेणियों को हैंडल करना और ट्रेनिंग डेटा पर एन्कोडर को फिट करना।
from sklearn.preprocessing import OneHotEncoder
import numpy as np

# Creating the encoder
enc = OneHotEncoder(handle_unknown='ignore')

# Sample data
X = [['Red'], ['Green'], ['Blue']]

# Fitting the encoder to the data
enc.fit(X)

# Transforming new data
result = enc.transform([['Red']]).toarray()

# Displaying the encoded result
print(result)
[[1. 0. 0.]]हम sklearn.preprocessing से OneHotEncoder क्लास और numpy इम्पोर्ट करते हैं। इसके बाद OneHotEncoder का एक इंस्टेंस बनाते हैं। handle_unknown='ignore' पैरामीटर एन्कोडर को निर्देश देता है कि ट्रांसफॉर्मेशन के दौरान अज्ञात श्रेणियों (जो फिटिंग के समय नहीं देखी गई थीं) को नज़रअंदाज़ किया जाए। फिर हम सूचियों की सूची X बनाते हैं, जहाँ हर अंदरूनी सूची में एक रंग है—इसी डेटा पर हम एन्कोडर को फिट करेंगे।
हम एन्कोडर को नमूना डेटा X पर फिट करते हैं। इस चरण में, एन्कोडर डेटा में मौजूद अद्वितीय श्रेणियाँ सीखता है। फिर हम फिट किए गए एन्कोडर का उपयोग नए डेटा को ट्रांसफ़ॉर्म करने के लिए करते हैं। यहाँ हम एक ही रंग 'Red' को ट्रांसफ़ॉर्म करते हैं। .transform() मेथड एक स्पार्स मैट्रिक्स लौटाती है, जिसे हम .toarray() द्वारा डेंस एरे में बदलते हैं।
परिणाम [[1. 0. 0.]] दर्शाता है कि 'Red' उपस्थित है (1) और 'Green' तथा 'Blue' अनुपस्थित हैं (0)।
वन-हॉट एनकोडिंग की एक बड़ी चुनौती है "आयामों का अभिशाप"। यह तब होता है जब किसी श्रेणीबद्ध फीचर में बहुत अधिक अद्वितीय मान होते हैं, जिससे कॉलमों की संख्या तेजी से बढ़ जाती है। इससे डेटासेट स्पार्स हो सकता है और प्रोसेसिंग कम्प्यूटेशनली महंगी हो जाती है। आइए देखें, इसे हल करने के लिए कौन-सी तकनीकें लागू की जा सकती हैं।
फ़ीचर हैशिंग, जिसे हैशिंग ट्रिक भी कहते हैं, श्रेणियों को एक निश्चित संख्या के कॉलम में हैश करके आयाम घटाने में मदद करता है। यह तरीका फ़ीचर्स की संख्या को नियंत्रित करते हुए दक्षता बनाए रखता है। यहाँ इसका उदाहरण है:
from sklearn.feature_extraction import FeatureHasher
import pandas as pd

# Sample data
data = {'Color': ['Red', 'Green', 'Blue', 'Red', 'Yellow']}
df = pd.DataFrame(data)

# Initialize FeatureHasher
hasher = FeatureHasher(n_features=3, input_type='string')

# Apply feature hashing
hashed_features = hasher.transform(df['Color'])
hashed_df = pd.DataFrame(hashed_features.toarray(), columns=['Feature1', 'Feature2', 'Feature3'])

# Display the hashed features DataFrame
print("Hashed Features DataFrame:")
print(hashed_df)
हम आवश्यक लाइब्रेरी इम्पोर्ट करते हैं, जिनमें sklearn.feature_extraction से FeatureHasher और pandas शामिल हैं। फिर हम 'Color' नामक श्रेणीबद्ध फीचर वाला DataFrame बनाते हैं।
हम FeatureHasher को इच्छित आउटपुट फ़ीचर्स की संख्या (n_features=3) के साथ प्रारंभ करते हैं और इनपुट प्रकार 'string' निर्दिष्ट करते हैं। इसके बाद, हम 'Color' कॉलम पर transform मेथड लागू करते हैं और प्राप्त स्पार्स मैट्रिक्स को डेंस एरे में बदलकर एक DataFrame में रूपांतरित करते हैं। अंत में, हम हैश्ड फ़ीचर्स वाला DataFrame प्रिंट करते हैं।
वन-हॉट एनकोडिंग के बाद, Principal Component Analysis (PCA) जैसी तकनीकें लागू की जा सकती हैं ताकि डेटासेट की आवश्यक जानकारी को सुरक्षित रखते हुए आयामों की संख्या घटाई जा सके।
PCA उच्च-आयामी डेटा को कम आयामी स्पेस में समेटने में मदद कर सकता है, जिससे वह मशीन लर्निंग एल्गोरिद्म के लिए अधिक प्रबंधनीय हो जाता है।
from sklearn.preprocessing import OneHotEncoder
from sklearn.decomposition import PCA
import pandas as pd

# Sample data
data = {'Color': ['Red', 'Green', 'Blue', 'Red', 'Yellow']}
df = pd.DataFrame(data)

# Applying one-hot encoding
encoder = OneHotEncoder(sparse=False)
one_hot_encoded = encoder.fit_transform(df[['Color']])

# Creating a DataFrame with one-hot encoded columns
# Check if get_feature_names_out is available
if hasattr(encoder, 'get_feature_names_out'):
    feature_names = encoder.get_feature_names_out(['Color'])
else:
    feature_names = [f'Color_{cat}' for cat in encoder.categories_[0]]
df_encoded = pd.DataFrame(one_hot_encoded, columns=feature_names)

# Initialize PCA
pca = PCA(n_components=2)  # Adjust the number of components based on your needs

# Apply PCA
pca_transformed = pca.fit_transform(df_encoded)

# Creating a DataFrame with PCA components
df_pca = pd.DataFrame(pca_transformed, columns=['PCA1', 'PCA2'])

# Display the PCA-transformed DataFrame
print("PCA-Transformed DataFrame:")
print(df_pca)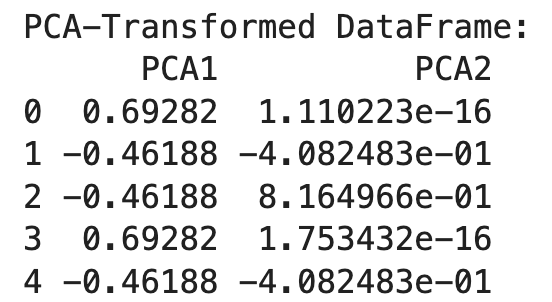
हम OneHotEncoder का उपयोग श्रेणीबद्ध फीचर को वन-हॉट एनकोडेड फ़ॉर्मेट में बदलने के लिए करते हैं। परिणामस्वरूप प्रत्येक श्रेणी के लिए बाइनरी कॉलम वाला DataFrame मिलता है।
इसके बाद, हम इच्छित कंपोनेंट्स की संख्या (n_components=2) के साथ PCA प्रारंभ करते हैं और इसे वन-हॉट एनकोडेड डेटा पर लागू करते हैं। परिणामस्वरूप दो प्रिंसिपल कंपोनेंट वाला एक ट्रांसफ़ॉर्म्ड DataFrame मिलता है।
PCA वन-हॉट एनकोडेड डेटा के आयामों को घटाने में मदद करता है, जिससे आवश्यक जानकारी सुरक्षित रखते हुए उसे अधिक प्रबंधनीय बनाया जा सके। यह तरीका खासकर तब उपयोगी है जब वन-हॉट एनकोडिंग से उच्च-आयामी डेटा बनता है।
हालाँकि वन-हॉट एनकोडिंग एक शक्तिशाली टूल है, गलत कार्यान्वयन से मल्टिकॉलीनियरिटी या नए डेटा को हैंडल करने में अक्षम्यता जैसी समस्याएँ आ सकती हैं। आइए कुछ श्रेष्ठ अभ्यासों और विचारों पर नज़र डालें।
मशीन लर्निंग मॉडल डिप्लॉय करते समय, टेस्ट सेट में ऐसी श्रेणियाँ मिलना आम है जो ट्रेनिंग सेट में मौजूद नहीं थीं। Scikit-learn का OneHotEncoder अज्ञात श्रेणियों को नज़रअंदाज़ करके या उन्हें एक समर्पित कॉलम में असाइन करके संभाल सकता है, जिससे मॉडल नए डेटा को भी प्रभावी ढंग से प्रोसेस कर सके।
यह उदाहरण दर्शाता है कि एन्कोडर को ट्रेनिंग डेटा पर कैसे फिट किया जाए और फिर ट्रेनिंग व टेस्ट दोनों डेटा को कैसे ट्रांसफ़ॉर्म किया जाए—इसमें वे श्रेणियाँ भी शामिल हैं जो ट्रेनिंग सेट में मौजूद नहीं थीं।
from sklearn.preprocessing import OneHotEncoder
import numpy as np

# Training data
X_train = [['Red'], ['Green'], ['Blue']]

# Creating the encoder with handle_unknown='ignore'
enc = OneHotEncoder(handle_unknown='ignore')

# Fitting the encoder to the training data
enc.fit(X_train)

# Transforming the training data
X_train_encoded = enc.transform(X_train).toarray()
print("Encoded training data:")
print(X_train_encoded)

# Test data with an unknown category 'Yellow'
X_test = [['Red'], ['Yellow'], ['Blue']]

# Transforming the test data
X_test_encoded = enc.transform(X_test).toarray()
print("Encoded test data:")
print(X_test_encoded)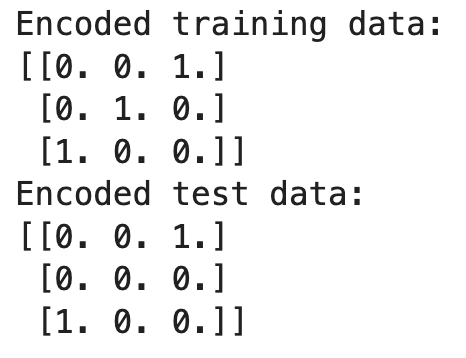
इस उदाहरण में, एन्कोडर को ट्रेनिंग डेटा पर फिट किया गया है, जहाँ उसने 'Red', 'Green', और 'Blue' श्रेणियाँ सीखी हैं। जब टेस्ट डेटा ट्रांसफ़ॉर्म होता है, तो उसे 'Yellow' मिलता है, जो ट्रेनिंग के दौरान नहीं देखा गया था। क्योंकि हमने handle_unknown='ignore' सेट किया है, एन्कोडर 'Yellow' के लिए ज़ीरो की एक पंक्ति देता है, यानी अज्ञात श्रेणी को वस्तुतः नज़रअंदाज़ करता है।
अज्ञात श्रेणियों को इस तरह हैंडल करके, हम सुनिश्चित कर सकते हैं कि आपका मॉडल नए डेटा को भी प्रभावी ढंग से प्रोसेस कर सके, भले ही उसमें पहले न देखी गई श्रेणियाँ हों।
वन-हॉट एनकोडिंग लागू करने के बाद, मूल श्रेणीबद्ध कॉलम को डेटासेट से हटाना महत्वपूर्ण है। मूल कॉलम को बनाए रखना मल्टिकॉलीनियरिटी पैदा कर सकता है, जहाँ अनावश्यक जानकारी मॉडल के प्रदर्शन को प्रभावित करती है। सुनिश्चित करें कि प्रत्येक श्रेणी डेटासेट में केवल एक बार प्रस्तुत हो।
यहाँ बताया गया है कि वन-हॉट एनकोडिंग लागू करने के बाद मूल श्रेणीबद्ध कॉलम को कैसे हटाएँ ताकि मल्टिकॉलीनियरिटी से बचा जा सके और प्रत्येक श्रेणी केवल एक बार ही प्रस्तुत हो।
import pandas as pd

# Sample data
data = {'Color': ['Red', 'Green', 'Blue', 'Red']}
df = pd.DataFrame(data)

# Applying one-hot encoding
df_encoded = pd.get_dummies(df, columns=['Color'])

# Displaying the encoded DataFrame
print("Encoded DataFrame:")
print(df_encoded)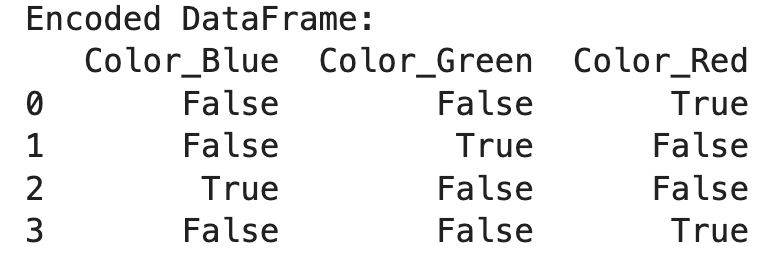
इस उदाहरण में, हम 'Color' नामक श्रेणीबद्ध कॉलम वाला DataFrame लेते हैं। हम pd.get_dummies() का उपयोग 'Color' कॉलम पर वन-हॉट एनकोडिंग लागू करने के लिए करते हैं, और columns=['Color'] देकर बताते हैं कि किस कॉलम को एनकोड करना है। यह स्वतः मूल 'Color' कॉलम को हटा देता है और उसकी जगह वन-हॉट एनकोडेड कॉलम रख देता है। परिणामी DataFrame df_encoded में अब प्रत्येक अद्वितीय श्रेणी के बाइनरी कॉलम शामिल हैं, जिससे प्रत्येक श्रेणी केवल एक बार दर्शायी जाती है और मल्टिकॉलीनियरिटी का जोखिम समाप्त होता है।
मूल श्रेणीबद्ध कॉलम हटाने से हम डेटासेट की अखंडता बनाए रखते हैं और मशीन लर्निंग मॉडल के प्रदर्शन में सुधार करते हैं।
OneHotEncoder बनाम get_dummies()Pandas के get_dummies() और Scikit-learn के OneHotEncoder में से चुनना आपकी आवश्यकताओं पर निर्भर करता है। तेज़ और सीधे-सादे एनकोडिंग के लिए get_dummies() सुविधाजनक और आसान है। अधिक जटिल परिदृश्यों में, जहाँ अधिक नियंत्रण और लचीलापन चाहिए—जैसे अज्ञात श्रेणियों को संभालना या एन्कोडर को विशिष्ट डेटा पर फिट करना—OneHotEncoder बेहतर विकल्प है।
वन-हॉट एनकोडिंग श्रेणीबद्ध डेटा को ऐसे संख्यात्मक फ़ॉर्मेट में बदलने की एक शक्तिशाली और आवश्यक तकनीक है जो मशीन लर्निंग एल्गोरिद्म के लिए उपयुक्त हो। यह क्रमबद्धता के झंझटों से बचाकर और श्रेणीबद्ध डेटा के उपयोग को सहज बनाकर मॉडलों की सटीकता और दक्षता बढ़ाती है।
Python में वन-हॉट एनकोडिंग लागू करना Pandas के get_dummies() और Scikit-learn के OneHotEncoder जैसे टूल्स से सीधा-सादा है। अपने डेटा के आयामों पर विचार करें और अज्ञात श्रेणियों को प्रभावी ढंग से हैंडल करना न भूलें।
यदि आप इस विषय के बारे में और सीखना चाहते हैं, तो Machine Learning in Python के लिए Preprocessing पर यह कोर्स देखें।
इन कोर्सेज़ के साथ मशीन लर्निंग सीखें!
कोर्स
कोर्स
कोर्स