在对大型数据集进行操作和筛选之后,您可能得到了所需的精确 DataFrame。然而,该 DataFrame 会保留原始索引,可能并非连续。在这种情况下,您需要重置 DataFrame 的索引。
本教程将讨论 pandas 的 reset_index() 方法,用于重置 DataFrame 的索引。我们将探索该方法可用的不同选项。此外,还将介绍如何为普通和多级索引的 DataFrame 重置索引。
为了练习重置 DataFrame 索引,我们将使用一个 航空公司数据集。我们将使用 Datacamp 的 Datalab,这是一款专为Python 数据分析设计的交互式环境,非常适合跟随本教程学习。
什么是 reset_index?
Pandas 中的 reset_index 方法可将 DataFrame 的索引重置为默认索引。在经过筛选、拼接或合并等操作后,索引可能不再连续。此方法有助于恢复干净、连续的索引。如果 DataFrame 具有 MultiIndex,还可以移除一个或多个层级。
基本语法:
df.reset_index(level=None, drop=False, inplace=False, col_level=0, col_fill="")技术支持
参数:
- level: 在多级索引的 DataFrame 中,接受需要从索引中移除的行索引层级名或位置。默认移除所有层级。
- drop: 布尔标志。True —— 当前行索引不会作为新列添加到 DataFrame 中。False(默认) —— 当前行索引会作为新列添加到 DataFrame 中。
- inplace: 指定返回新 DataFrame 还是更新现有 DataFrame。布尔标志,默认 False。
- col_level: 如果列有多个层级,决定将标签插入到哪个层级。默认插入到第一个层级。
- col_fill: 如果列有多个层级,决定其他层级如何命名。若为 None,则重复索引名称。
返回值:
返回带有新索引的 DataFrame;如果 inplace=True,则返回 None。
如何使用 reset_index
如果您使用 pandas 的 read_csv() 方法读取 CSV 文件而未指定索引,生成的 DataFrame 将具有默认的整数索引,从 0 开始,每行加 1。
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df技术支持
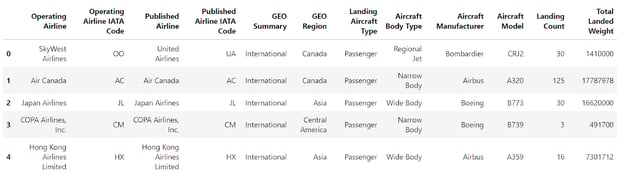
在某些情况下,您可能更喜欢更具描述性的行标签。为此,您可以将 DataFrame 的某一列设置为其索引(行标签)。当使用 read_csv() 从 CSV 文件加载数据时,通过 index_col 参数指定所需的索引列。
import pandas as pd
df = pd.read_csv("airlines_dataset.csv", index_col="Operating Airline IATA Code").head()
df技术支持
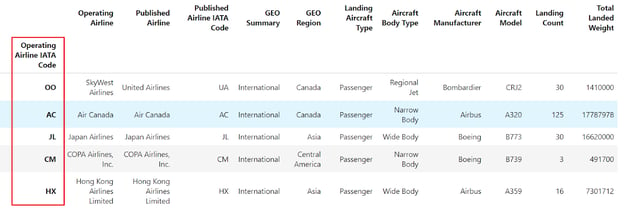
或者,您可以使用 set_index() 方法将 DataFrame 的任意列设置为索引:
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df.set_index("Operating Airline IATA Code", inplace=True)
df技术支持
请注意,该代码片段会对原始 DataFrame 进行更改。
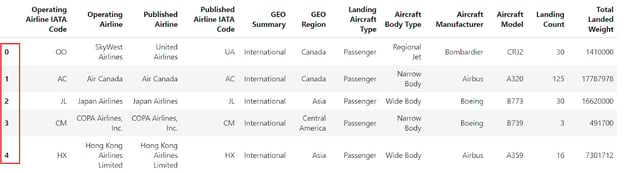
如果需要恢复默认的数字索引,该怎么办?这时就要用到 pandas 的 reset_index() 方法。
df.reset_index()技术支持
该示例显示,在将“Operating Airline IATA Code”列设为索引后,使用 reset_index 可将 DataFrame 还原为默认的整数索引。
reset_index 的实践应用
pandas 中的 reset_index() 是在处理筛选后的数据集、拼接的 DataFrame,或多级索引时重新组织 DataFrame 索引的强大工具。
进一步学习如何重塑 DataFrame 从宽表到长表、如何 stack 与 unstack 行与列,以及如何在我们的在线课程中整理多级索引的 DataFrame。
筛选后重置
当您筛选一个 DataFrame 时,会保留原始索引。使用 reset_index 可以为筛选后的 DataFrame 重新编号。
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")技术支持
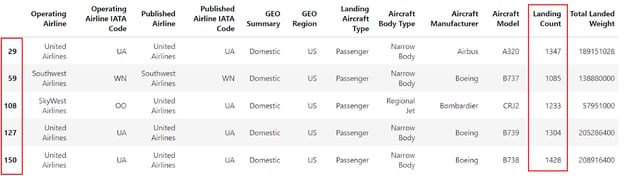
让我们筛选出“landing count”大于 1000 的行。筛选后,索引可能不连续。然后,您可以使用 reset_index 方法重置筛选后 DataFrame 的索引。
filtered_df = df[df["Landing Count"] > 1000].head()
filtered_df技术支持
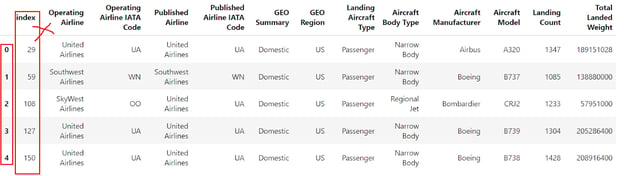
上图显示数据框已按条件筛选,但索引不连续。现在,让我们使用 reset_index 为筛选后的 DataFrame 重新索引,确保索引连续。您可以这样做:
filtered_df_reset = filtered_df.reset_index()
filtered_df_reset技术支持
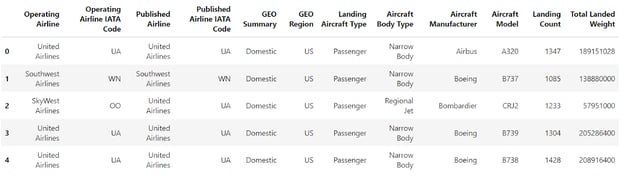
该方法的默认行为包括:用默认的整数索引替换现有索引,并将旧索引转为同名的新列(若未命名则为“index”)。
因此,可以使用参数 drop=True,确保旧索引不会作为新列添加。
filtered_df_reset = filtered_df.reset_index(drop=True)
filtered_df_reset技术支持
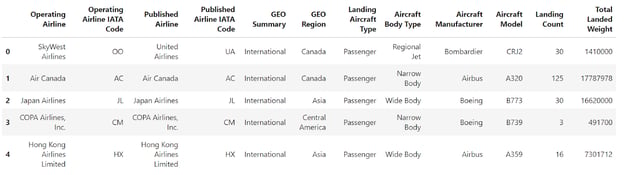
很好!索引现已重置为默认整数索引(0、1、2、…),干净且连续。
拼接或合并
当组合多个 DataFrame 时,结果 DataFrame 可能包含重复或不连续的索引。重置索引可以创建干净、连续的索引。
假设您有两个 DataFrame,并希望将它们拼接。为演示起见,我从航空公司数据集中创建了两个 DataFrame。
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
split_index = int(df.shape[0] / 2)
df1 = df[:split_index].head()
df2 = df[split_index:].head()技术支持
这是 df1:
这是 df2:
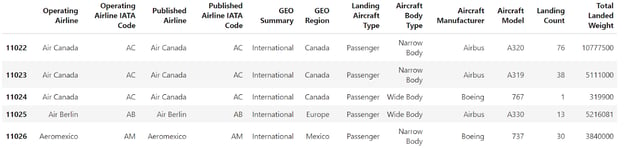
让我们拼接 DataFrame df1 和 df2。
df_concat = pd.concat([df1, df2])技术支持
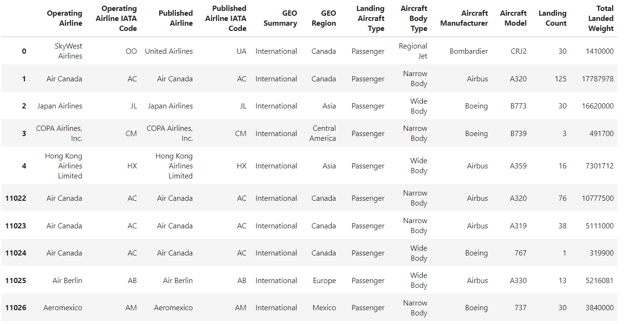
数据呈现出不连续的索引。我们需要重置拼接后 DataFrame 的索引,使其连续。
让我们使用 pandas 的 reset_index() 方法来重置 DataFrame 的索引。
df_concat.reset_index()技术支持
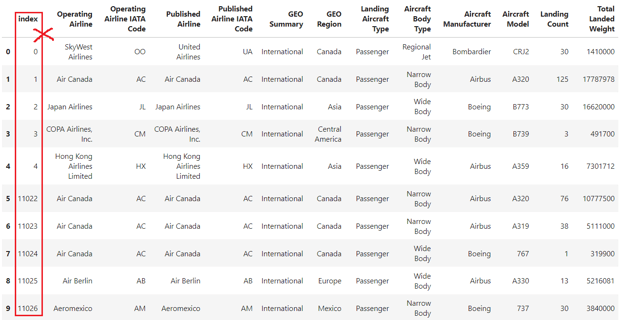
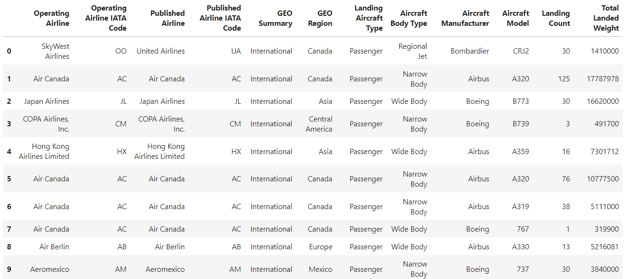
这是重置 DataFrame 索引后的结果。reset_index 方法会将旧索引转换为新列。要移除这列,需要使用 drop=True 参数。
df_concat.reset_index(drop=True)技术支持
处理多级索引
对于具有层级(多级)索引的 DataFrame,reset_index 可通过将多级索引转换回普通列来简化 DataFrame。
来看一个具有多级索引的 DataFrame 示例。
import pandas as pd
df = pd.read_csv(
    "airlines_dataset.csv", index_col=["Aircraft Model", "Operating Airline IATA Code"]
).head()技术支持
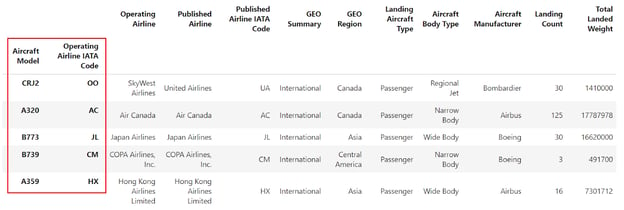
如果您检查其索引,会发现它不是普通的 DataFrame 索引,而是一个 MultiIndex 对象。
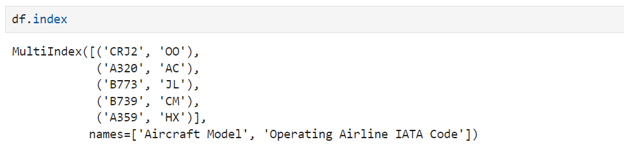
现在,让我们使用 pandas 的 reset_index() 方法,它会移除 MultiIndex 的所有层级:
df.reset_index()技术支持
您可以看到,多级索引的两个层级都被转换为普通的 DataFrame 列,同时索引被重置为默认的整数索引。
您还可以使用 level 参数从 DataFrame 索引中移除选定层级。它会将所选层级转换为普通 DataFrame 列,除非您选择使用 drop 参数将这些信息从 DataFrame 中完全丢弃。如下所示:
df.reset_index(level=["Aircraft Model"])技术支持
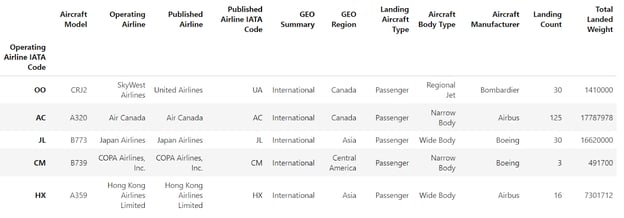
上图显示“Aircraft Model”现已成为 DataFrame 的普通列。仅“Operating Airline IATA Code”保留为索引。
现在,如果您不希望列表中描述的索引变为普通列,可以结合使用 drop 和 level 参数,将其从 DataFrame 中删除。
df.reset_index(level=["Aircraft Model"], drop=True)技术支持
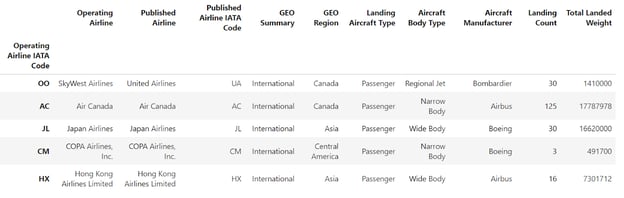
索引“Aircraft Model”已从索引及 DataFrame 中移除。另一个索引“Operating Airline IATA Code”被保留为当前 DataFrame 的索引。
高级用法与提示
保留或舍弃索引
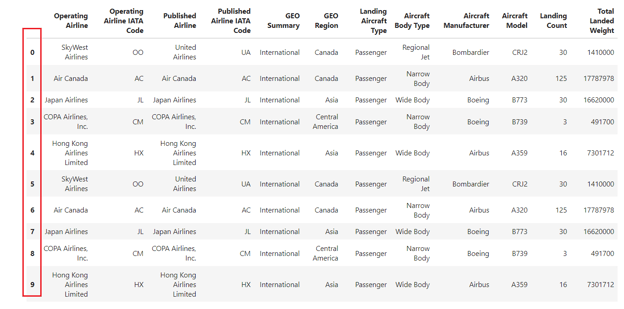
假设您合并了两个 DataFrame;合并后的 DataFrame 将不再具有连续索引,如下所示。
让我们使用 pandas 的 reset_index() 方法重置 DataFrame 的索引。
df.reset_index()技术支持
参数 drop 用于决定在重置索引后是否将旧索引保留为 DataFrame 的一列,还是彻底删除。默认(drop=False)会保留旧索引,这在之前所有示例中都有体现。相反,将 drop=True 可在重置后从 DataFrame 中移除旧索引。
df.reset_index(drop=True)技术支持
原地操作
通过 inplace 参数就地修改 DataFrame,避免创建新 DataFrame。
假设您有如下 DataFrame:
将 inplace 参数设为 True 可确保更改直接应用于原始 DataFrame,避免创建单独的 DataFrame。
df_concat.reset_index(drop=True, inplace=True)
df_concat技术支持
处理重复值
通过适当的重置和重新编号来管理重复索引。
假设您的数据存在重复索引。
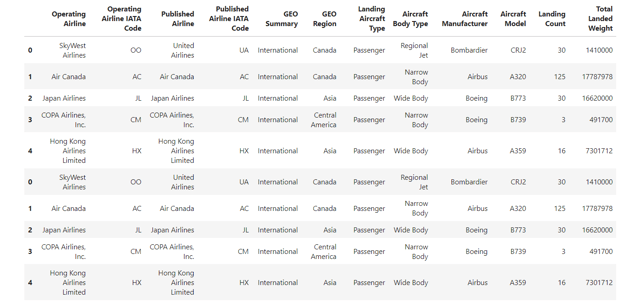
将 reset_index() 与 drop=True 和 inplace=True 一起使用,可确保结果 DataFrame 拥有连续索引,从 0 开始依次递增。
df.reset_index(drop=True, inplace=True)技术支持
Pandas reset_index 常见陷阱与排错
- 索引未被重置: 如果您期望修改原始 DataFrame,请确保未使用
inplace=False 参数。若 inplace 设为 False,将返回一个新 DataFrame,原始 DataFrame 保持不变。
- 数据丢失: 使用
drop 参数时需谨慎,避免无意的数据丢失。丢弃索引会永久移除当前索引值。
reset_index 动手示例
让我们应用所学的 DataFrame 索引重置方法,看看在删除缺失值时,重置 DataFrame 索引如何发挥作用。
我们的航空公司数据集没有缺失值,因此改用 Netflix 电影与剧集 数据集。它包含缺失值,非常适合演示 reset_index()。
import pandas as pd
df = pd.read_csv("netflix_shows.csv")
df.head()技术支持
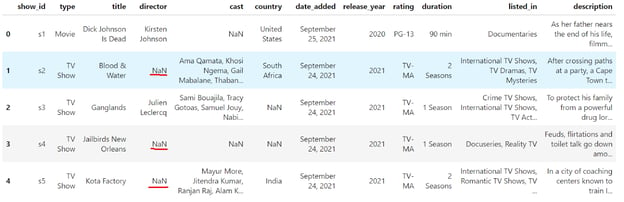
您可以看到 DataFrame 存在缺失值。使用 dropna() 方法删除包含缺失值的行。
df.dropna(inplace=True)
df.head()技术支持
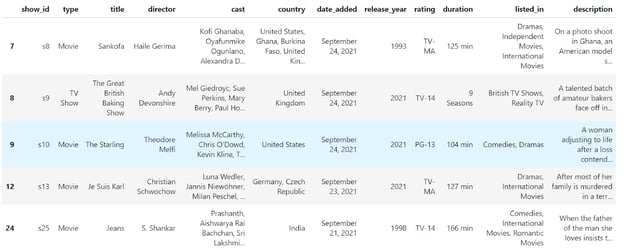
包含 NaN 的行已从 DataFrame 中移除。但索引不再连续(0、1、2、4)。让我们重置它:
df.reset_index()技术支持
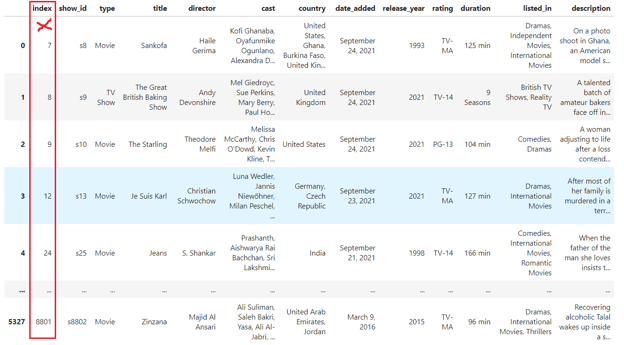
现在索引已经连续;不过由于我们未显式传入 drop 参数,旧索引被转换为默认名为 index 的一列。让我们将旧索引从 DataFrame 中完全移除:
df.reset_index(drop=True)技术支持
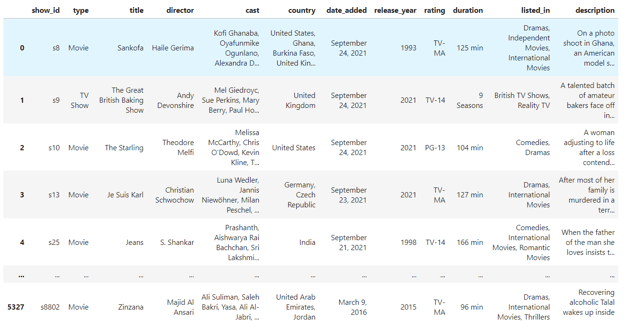
我们已彻底移除了无意义的旧索引,当前索引已连续。最后一步是使用 inplace 参数将这些修改保存到原始 DataFrame:
df.reset_index(drop=True, inplace=True)技术支持
结论
您已经了解了 reset_index 函数如何在Pandas 中高效管理 DataFrame 索引。无论是处理筛选后的数据、拼接的 DataFrame,还是复杂的多级索引,reset_index 都能确保 DataFrame 干净有序。其参数有助于在数据处理任务中应对多样的索引场景。
继续学习与 reset_index 类似的函数,请查看 DataCamp 的 Python 数据分析师职业路径。如果您在使用列表并想了解 index() 函数在列表中的用法,也可以阅读我们的 Python 列表 index() 教程。


在对大型数据集进行操作和筛选之后,您可能得到了所需的精确 DataFrame。然而,该 DataFrame 会保留原始索引,可能并非连续。在这种情况下,您需要重置 DataFrame 的索引。
本教程将讨论 pandas 的
reset_index()方法,用于重置 DataFrame 的索引。我们将探索该方法可用的不同选项。此外,还将介绍如何为普通和多级索引的 DataFrame 重置索引。为了练习重置 DataFrame 索引,我们将使用一个 航空公司数据集。我们将使用 Datacamp 的 Datalab,这是一款专为Python 数据分析设计的交互式环境,非常适合跟随本教程学习。
什么是 reset_index?
Pandas 中的
reset_index方法可将 DataFrame 的索引重置为默认索引。在经过筛选、拼接或合并等操作后,索引可能不再连续。此方法有助于恢复干净、连续的索引。如果 DataFrame 具有 MultiIndex,还可以移除一个或多个层级。基本语法:
参数:
返回值:
返回带有新索引的 DataFrame;如果
inplace=True,则返回 None。如何使用 reset_index
如果您使用 pandas 的
read_csv()方法读取 CSV 文件而未指定索引,生成的 DataFrame 将具有默认的整数索引,从 0 开始,每行加 1。在某些情况下,您可能更喜欢更具描述性的行标签。为此,您可以将 DataFrame 的某一列设置为其索引(行标签)。当使用
read_csv()从 CSV 文件加载数据时,通过index_col参数指定所需的索引列。或者,您可以使用
set_index()方法将 DataFrame 的任意列设置为索引:请注意,该代码片段会对原始 DataFrame 进行更改。
如果需要恢复默认的数字索引,该怎么办?这时就要用到 pandas 的
reset_index()方法。该示例显示,在将“Operating Airline IATA Code”列设为索引后,使用
reset_index可将 DataFrame 还原为默认的整数索引。reset_index 的实践应用
pandas 中的
reset_index()是在处理筛选后的数据集、拼接的 DataFrame,或多级索引时重新组织 DataFrame 索引的强大工具。进一步学习如何重塑 DataFrame 从宽表到长表、如何 stack 与 unstack 行与列,以及如何在我们的在线课程中整理多级索引的 DataFrame。
筛选后重置
当您筛选一个 DataFrame 时,会保留原始索引。使用 reset_index 可以为筛选后的 DataFrame 重新编号。
让我们筛选出“landing count”大于 1000 的行。筛选后,索引可能不连续。然后,您可以使用
reset_index方法重置筛选后 DataFrame 的索引。上图显示数据框已按条件筛选,但索引不连续。现在,让我们使用
reset_index为筛选后的 DataFrame 重新索引,确保索引连续。您可以这样做:该方法的默认行为包括:用默认的整数索引替换现有索引,并将旧索引转为同名的新列(若未命名则为“index”)。
因此,可以使用参数
drop=True,确保旧索引不会作为新列添加。很好!索引现已重置为默认整数索引(0、1、2、…),干净且连续。
拼接或合并
当组合多个 DataFrame 时,结果 DataFrame 可能包含重复或不连续的索引。重置索引可以创建干净、连续的索引。
假设您有两个 DataFrame,并希望将它们拼接。为演示起见,我从航空公司数据集中创建了两个 DataFrame。
这是 df1:
这是 df2:
让我们拼接 DataFrame df1 和 df2。
数据呈现出不连续的索引。我们需要重置拼接后 DataFrame 的索引,使其连续。
让我们使用 pandas 的
reset_index()方法来重置 DataFrame 的索引。这是重置 DataFrame 索引后的结果。
reset_index方法会将旧索引转换为新列。要移除这列,需要使用drop=True参数。处理多级索引
对于具有层级(多级)索引的 DataFrame,
reset_index可通过将多级索引转换回普通列来简化 DataFrame。来看一个具有多级索引的 DataFrame 示例。
如果您检查其索引,会发现它不是普通的 DataFrame 索引,而是一个 MultiIndex 对象。
现在,让我们使用 pandas 的
reset_index()方法,它会移除 MultiIndex 的所有层级:您可以看到,多级索引的两个层级都被转换为普通的 DataFrame 列,同时索引被重置为默认的整数索引。
您还可以使用
level参数从 DataFrame 索引中移除选定层级。它会将所选层级转换为普通 DataFrame 列,除非您选择使用drop参数将这些信息从 DataFrame 中完全丢弃。如下所示:上图显示“Aircraft Model”现已成为 DataFrame 的普通列。仅“Operating Airline IATA Code”保留为索引。
现在,如果您不希望列表中描述的索引变为普通列,可以结合使用 drop 和 level 参数,将其从 DataFrame 中删除。
索引“Aircraft Model”已从索引及 DataFrame 中移除。另一个索引“Operating Airline IATA Code”被保留为当前 DataFrame 的索引。
高级用法与提示
保留或舍弃索引
假设您合并了两个 DataFrame;合并后的 DataFrame 将不再具有连续索引,如下所示。
让我们使用 pandas 的
reset_index()方法重置 DataFrame 的索引。参数 drop 用于决定在重置索引后是否将旧索引保留为 DataFrame 的一列,还是彻底删除。默认(
drop=False)会保留旧索引,这在之前所有示例中都有体现。相反,将drop=True可在重置后从 DataFrame 中移除旧索引。原地操作
通过
inplace参数就地修改 DataFrame,避免创建新 DataFrame。假设您有如下 DataFrame:
将
inplace参数设为True可确保更改直接应用于原始 DataFrame,避免创建单独的 DataFrame。处理重复值
通过适当的重置和重新编号来管理重复索引。
假设您的数据存在重复索引。
将
reset_index()与drop=True和inplace=True一起使用,可确保结果 DataFrame 拥有连续索引,从 0 开始依次递增。Pandas reset_index 常见陷阱与排错
inplace=False参数。若inplace设为False,将返回一个新 DataFrame,原始 DataFrame 保持不变。drop参数时需谨慎,避免无意的数据丢失。丢弃索引会永久移除当前索引值。reset_index 动手示例
让我们应用所学的 DataFrame 索引重置方法,看看在删除缺失值时,重置 DataFrame 索引如何发挥作用。
我们的航空公司数据集没有缺失值,因此改用 Netflix 电影与剧集 数据集。它包含缺失值,非常适合演示
reset_index()。您可以看到 DataFrame 存在缺失值。使用
dropna()方法删除包含缺失值的行。包含 NaN 的行已从 DataFrame 中移除。但索引不再连续(0、1、2、4)。让我们重置它:
现在索引已经连续;不过由于我们未显式传入
drop参数,旧索引被转换为默认名为index的一列。让我们将旧索引从 DataFrame 中完全移除:我们已彻底移除了无意义的旧索引,当前索引已连续。最后一步是使用
inplace参数将这些修改保存到原始 DataFrame:结论
您已经了解了
reset_index函数如何在Pandas 中高效管理 DataFrame 索引。无论是处理筛选后的数据、拼接的 DataFrame,还是复杂的多级索引,reset_index都能确保 DataFrame 干净有序。其参数有助于在数据处理任务中应对多样的索引场景。继续学习与
reset_index类似的函数,请查看 DataCamp 的 Python 数据分析师职业路径。如果您在使用列表并想了解index()函数在列表中的用法,也可以阅读我们的 Python 列表 index() 教程。