कोर्स
pandas के साथ Data Manipulation
4 घंटा
567.9K
किसी बड़े डेटासेट को बदलने-घुमाने और फ़िल्टर करने के बाद, आपके पास ठीक वैसा DataFrame हो सकता है जैसा चाहिए। लेकिन यह DataFrame मूल इंडेक्स बनाए रखता है, जो गैर-अनुक्रमिक हो सकता है। ऐसी स्थिति में, आपको DataFrame का इंडेक्स रीसेट करने की आवश्यकता होती है।
इस ट्यूटोरियल में, हम pandas की reset_index() मेथड पर चर्चा करेंगे, जिसका उपयोग DataFrame का इंडेक्स डिफ़ॉल्ट पर रीसेट करने के लिए किया जाता है। हम इस मेथड के साथ उपलब्ध विभिन्न विकल्पों का पता लगाएंगे। साथ ही, हम यह भी कवर करेंगे कि सरल और मल्टी-लेवल DataFrame का इंडेक्स कैसे रीसेट करें।
DataFrame इंडेक्स रीसेटिंग का अभ्यास करने के लिए, हम एक एयरलाइन डेटासेट का उपयोग करेंगे। हम Datacamp का Datalab इस्तेमाल करेंगे, जो Python में डेटा विश्लेषण के लिए विशेष रूप से बनाया गया एक इंटरैक्टिव वातावरण है, जो इस ट्यूटोरियल के साथ चलने के लिए बिल्कुल उपयुक्त है।
Pandas में reset_index मेथड DataFrame के इंडेक्स को डिफ़ॉल्ट पर रीसेट करती है। फ़िल्टरिंग, कंसकैटिनेशन या मर्जिंग जैसी कार्रवाइयों के बाद इंडेक्स अनुक्रमिक नहीं रह सकता। यह मेथड साफ-सुथरा, क्रमिक इंडेक्स फिर स्थापित करने में मदद करती है। यदि DataFrame में MultiIndex है, तो यह एक या अधिक लेवल हटा सकती है।
बेसिक सिंटैक्स:
df.reset_index(level=None, drop=False, inplace=False, col_level=0, col_fill="")पैरामीटर:
रिटर्न:
नए इंडेक्स वाला DataFrame, या यदि inplace=True है तो None।
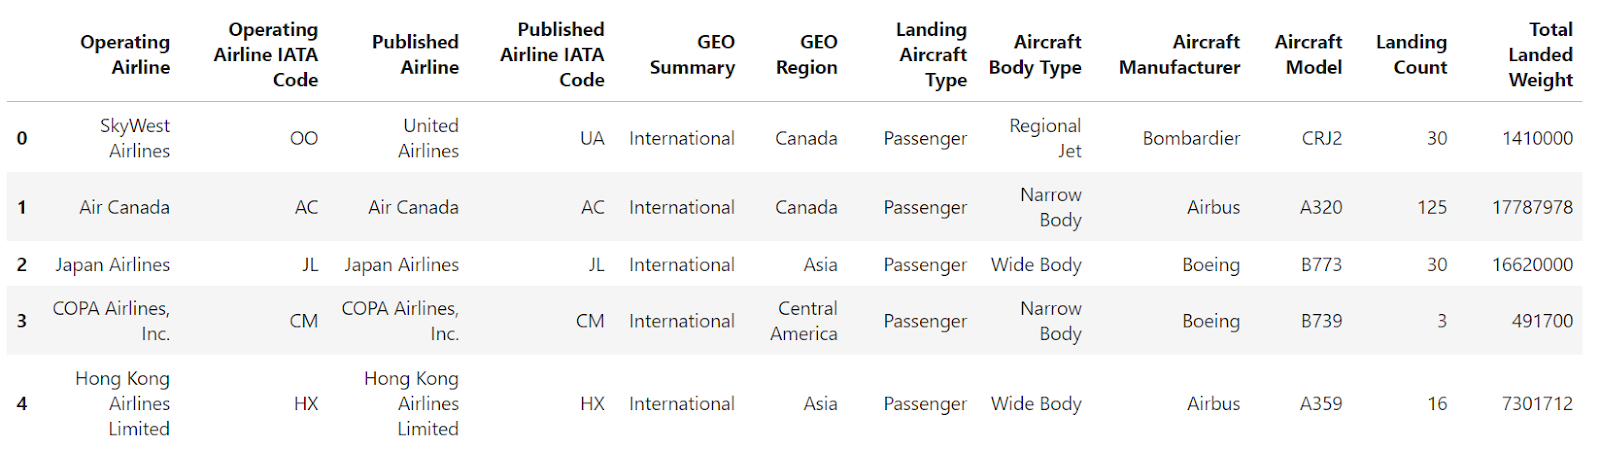
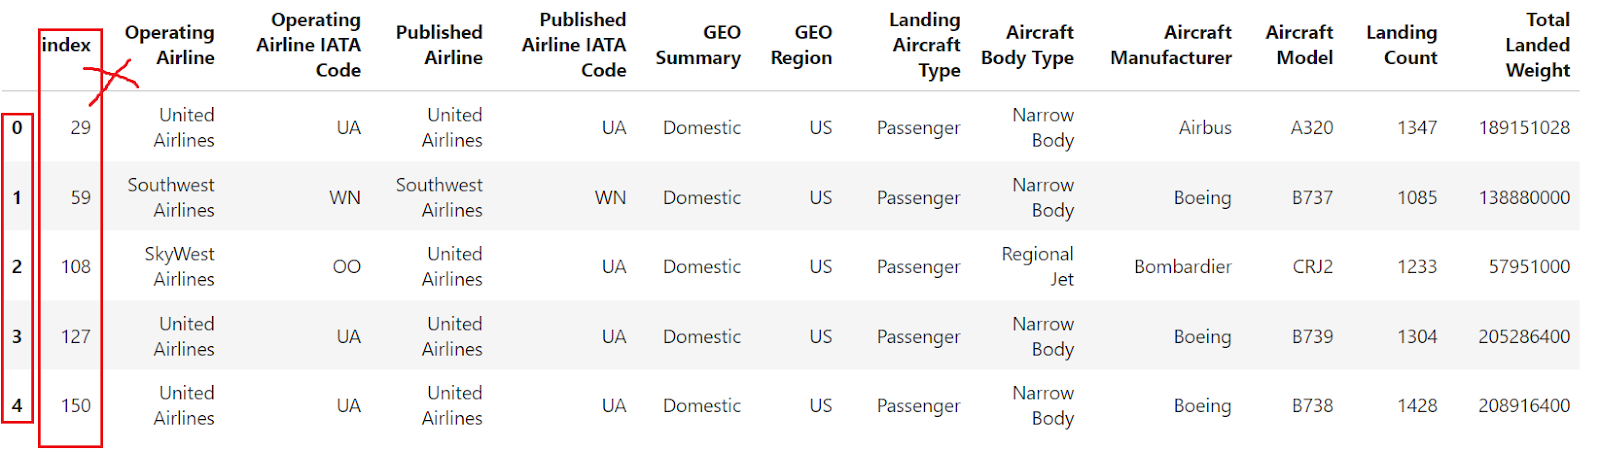
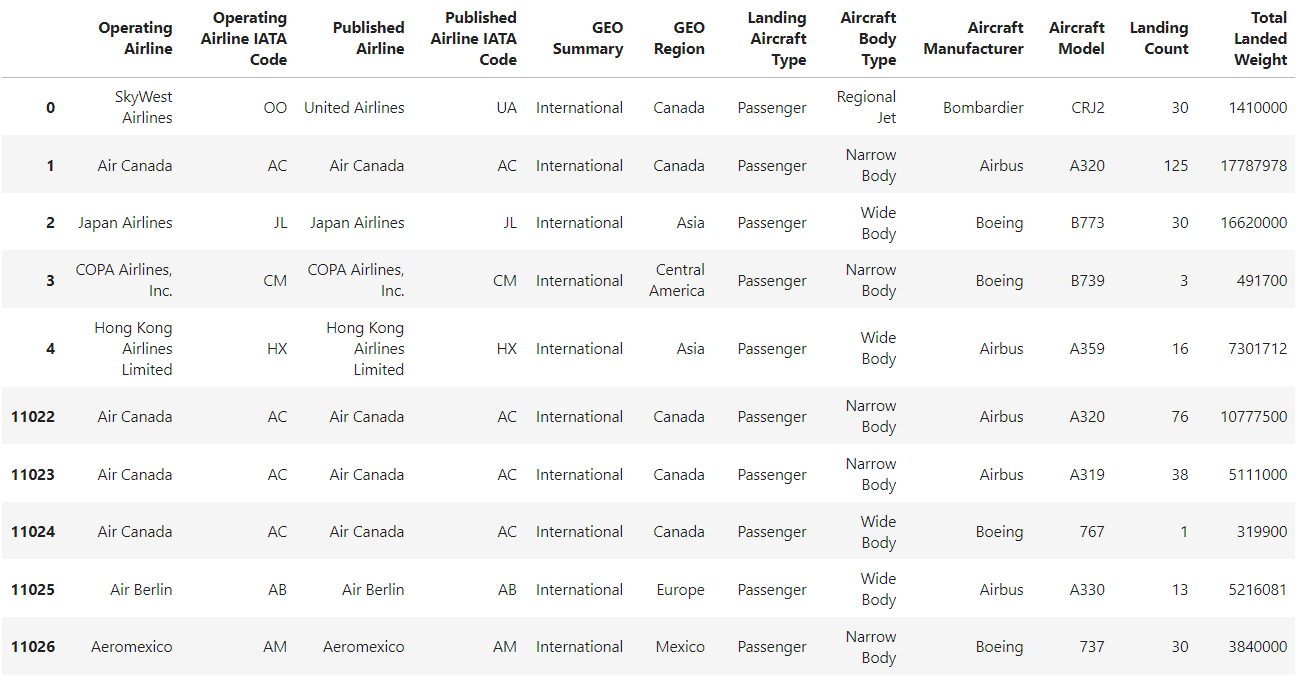
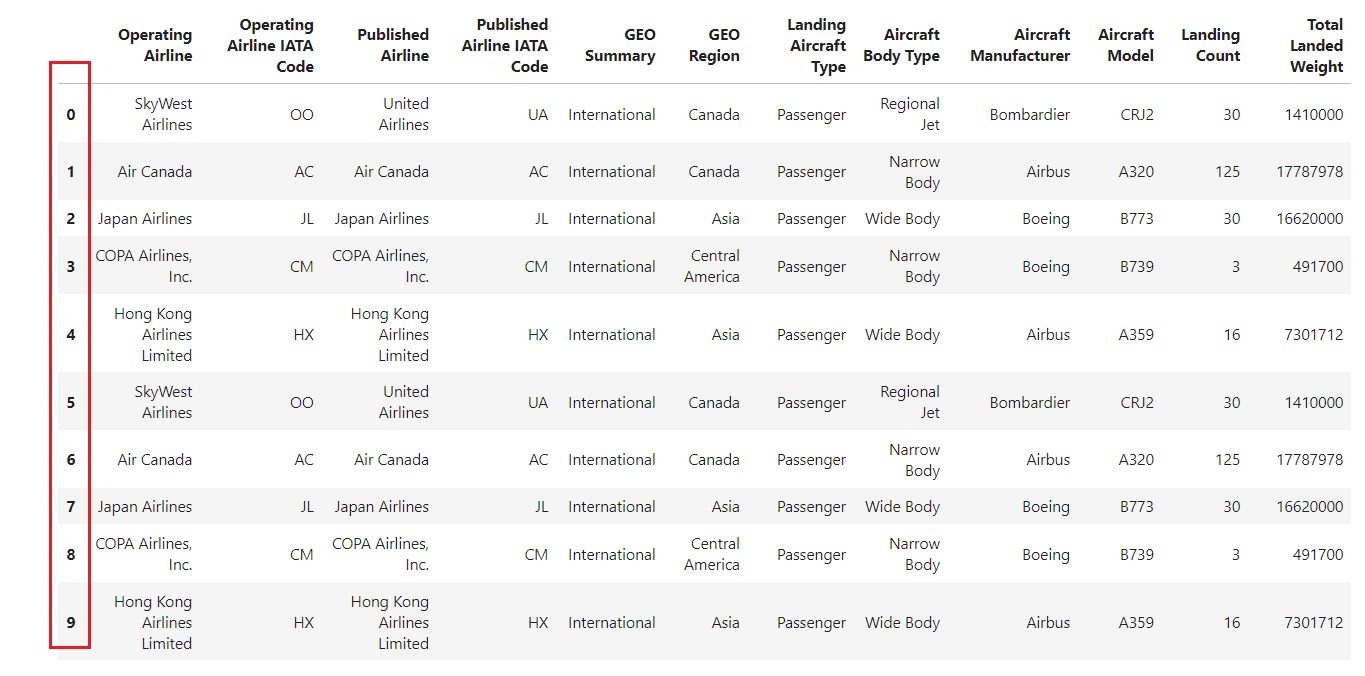
यदि आप pandas की read_csv() मेथड से बिना कोई इंडेक्स निर्दिष्ट किए CSV फ़ाइल पढ़ते हैं, तो प्राप्त DataFrame में डिफ़ॉल्ट पूर्णांक-आधारित इंडेक्स होगा जो 0 से शुरू होता है और हर अगली रो के लिए 1 से बढ़ता है।
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df
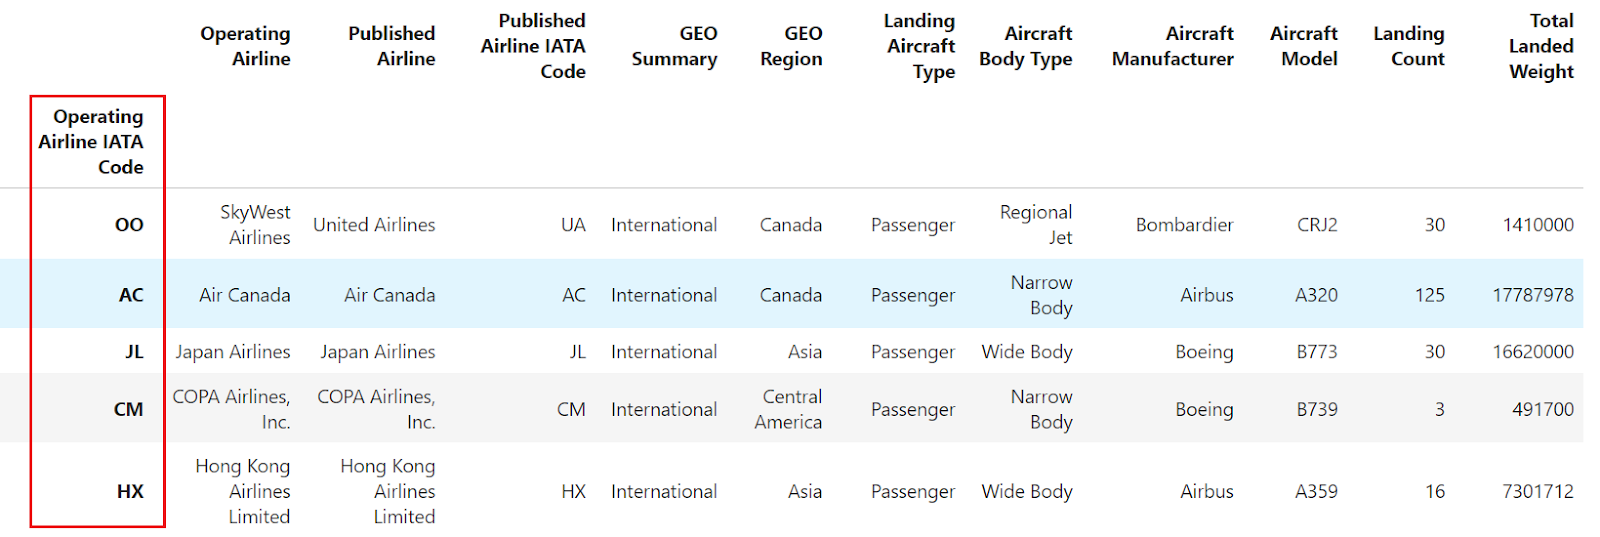
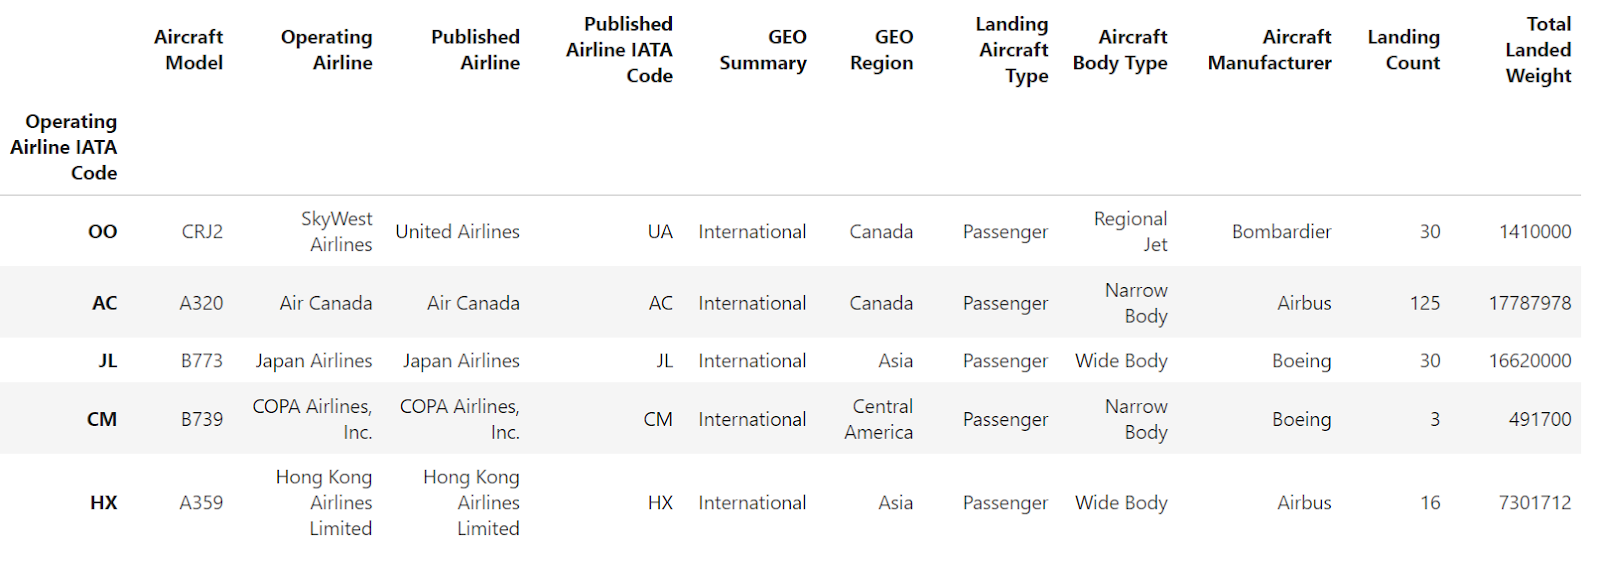
कुछ मामलों में, आप अधिक वर्णनात्मक रो लेबल पसंद कर सकते हैं। इसके लिए आप DataFrame के किसी एक कॉलम को उसका इंडेक्स (रो लेबल) बना सकते हैं। जब आप read_csv() से CSV फ़ाइल से डेटा लोड करते हैं, तो index_col पैरामीटर का उपयोग करके इंडेक्स के लिए इच्छित कॉलम निर्दिष्ट करें।
import pandas as pd
df = pd.read_csv("airlines_dataset.csv", index_col="Operating Airline IATA Code").head()
df
वैकल्पिक रूप से, आप set_index() मेथड का उपयोग करके DataFrame के किसी भी कॉलम को इंडेक्स बना सकते हैं:
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
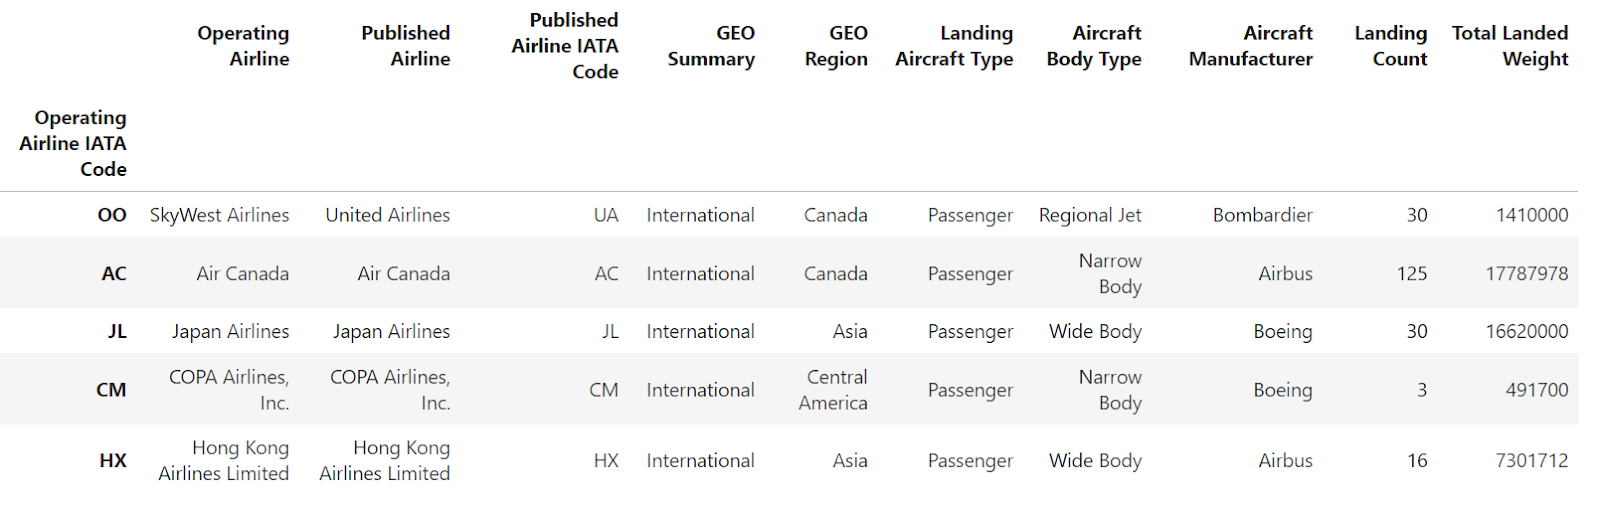
df.set_index("Operating Airline IATA Code", inplace=True)
df
ध्यान दें कि यह कोड स्निपेट मूल DataFrame में परिवर्तन करेगा।
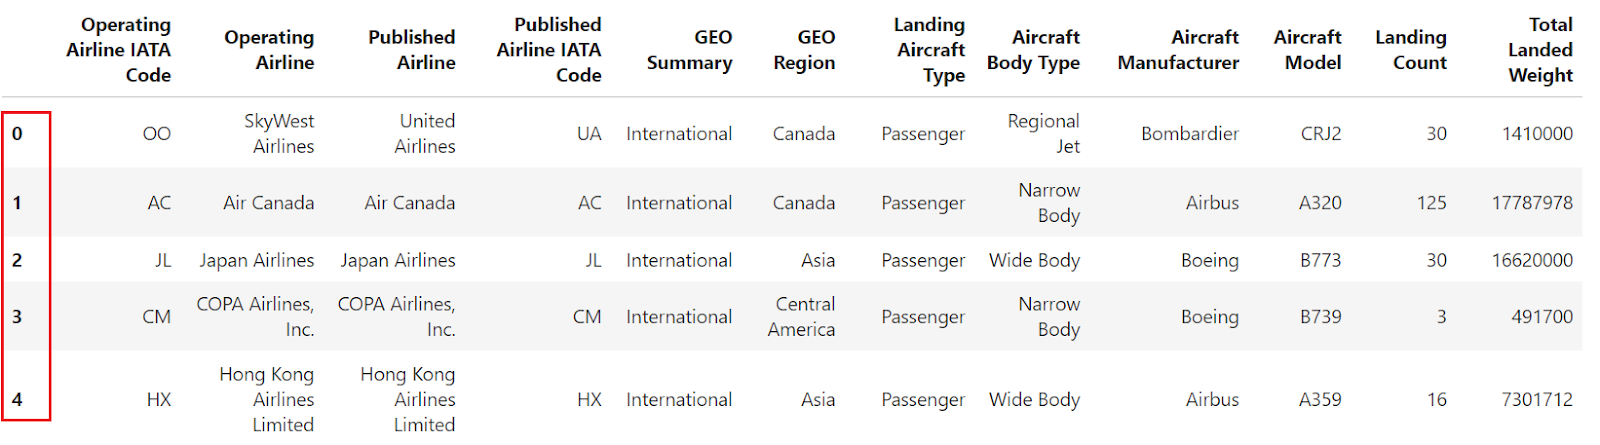
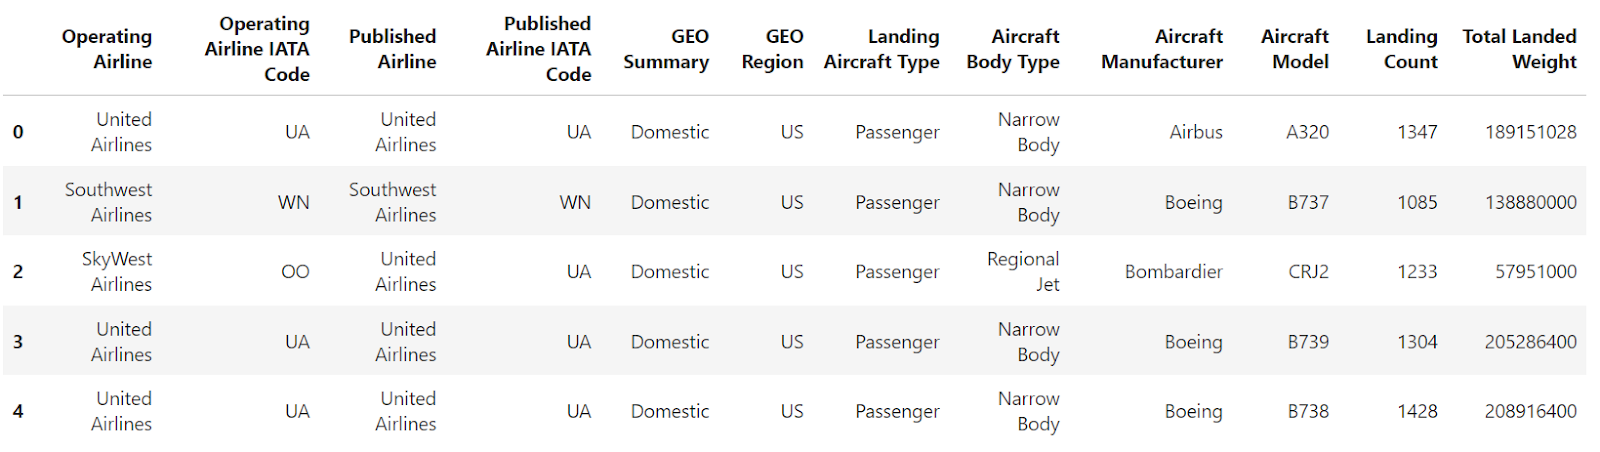
यदि आपको डिफ़ॉल्ट संख्यात्मक इंडेक्स पुनर्स्थापित करना हो तो क्या करें? यहीं pandas की reset_index() मेथड काम आती है।
df.reset_index()
उदाहरण से पता चलता है कि कॉलम 'Operating Airline IATA Code' को इंडेक्स बनाने के बाद, reset_index का उपयोग DataFrame को उसके डिफ़ॉल्ट पूर्णांक इंडेक्स पर लौटाने के लिए किया जाता है।
Pandas में reset_index() मेथड फ़िल्टर किए गए डेटासेट, कंसकैट किए गए DataFrame, या मल्टी-लेवल इंडेक्स के साथ काम करते समय DataFrame इंडेक्स को पुनर्गठित करने का शक्तिशाली साधन है।
और जानें कि DataFrame को रीशेप करके वाइड से लॉन्ग फॉर्मेट में कैसे लाएं, रो और कॉलम को स्टैक/अनस्टैक कैसे करें, और हमारे ऑनलाइन कोर्स में मल्टी-इंडेक्स DataFrame को कैसे सँभालें।
जब आप किसी DataFrame को फ़िल्टर करते हैं, तो मूल इंडेक्स यथावत रहता है। reset_index का उपयोग करके आप फ़िल्टर किए गए DataFrame को फिर से रीइंडेक्स कर सकते हैं।
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
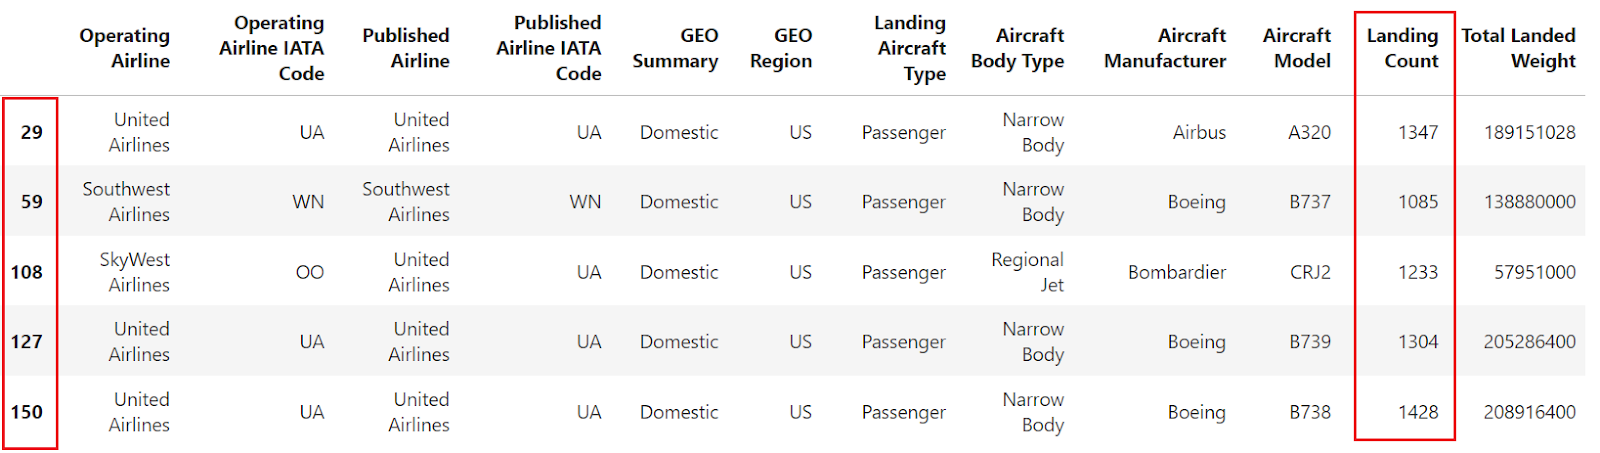
चलिए डेटा को फ़िल्टर करते हैं ताकि केवल वही रो चुनी जाएँ जहाँ "landing count" 1000 से अधिक है। फ़िल्टरिंग के बाद इंडेक्स अनुक्रमिक नहीं रह सकते। फिर आप reset_index मेथड का उपयोग करके फ़िल्टर किए गए DataFrame का इंडेक्स रीसेट कर सकते हैं।
filtered_df = df[df["Landing Count"] > 1000].head()
filtered_df
ऊपर की छवि दिखाती है कि डेटा फ्रेम लागू शर्त के आधार पर फ़िल्टर किया गया है, लेकिन इंडेक्स अनुक्रमिक नहीं हैं। अब, reset_index का उपयोग करके फ़िल्टर किए गए DataFrame को दोबारा रीइंडेक्स करें और इंडेक्स को अनुक्रमिक बनाएं। ऐसा आप इस तरह कर सकते हैं:
filtered_df_reset = filtered_df.reset_index()
filtered_df_reset
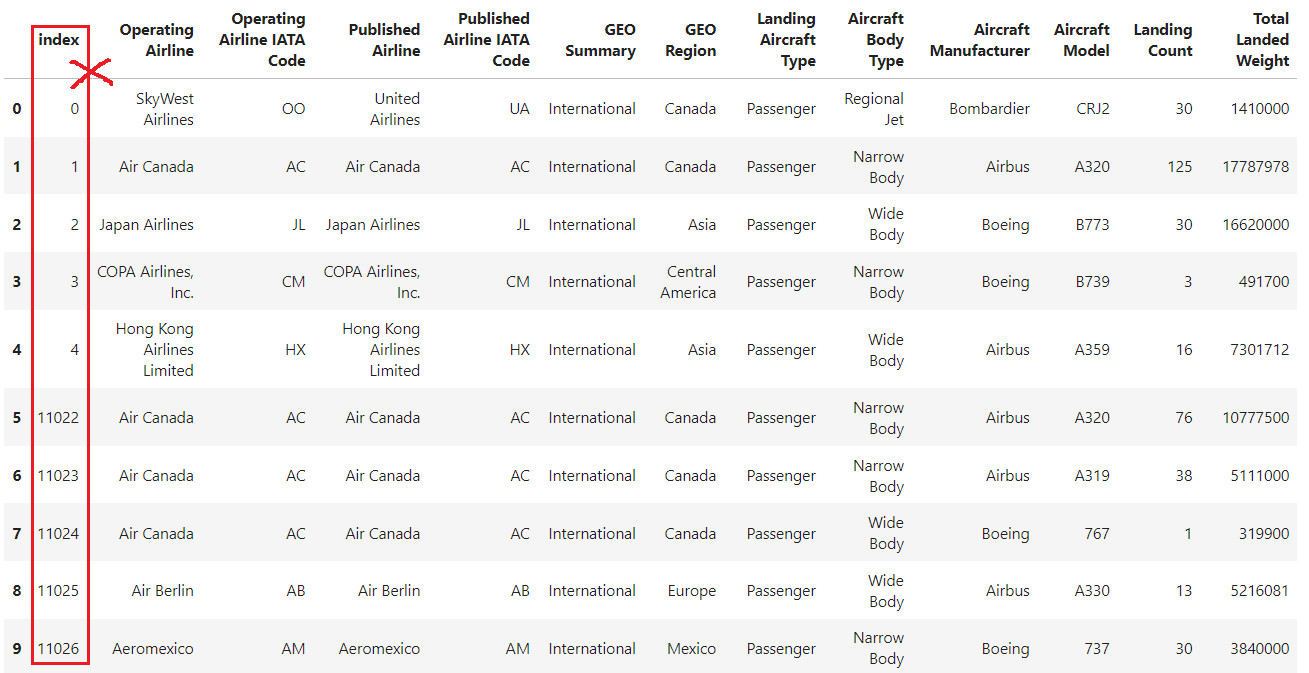
इस मेथड का डिफ़ॉल्ट व्यवहार मौजूदा DataFrame इंडेक्स को डिफ़ॉल्ट पूर्णांक-आधारित इंडेक्स से बदल देता है और पुराने इंडेक्स को उसी नाम वाली नई कॉलम (या यदि नाम नहीं था तो "index") में बदल देता है।
इसलिए, पैरामीटर drop=True का उपयोग करें, जो सुनिश्चित करता है कि पुराना इंडेक्स नई कॉलम के रूप में न जोड़ा जाए।
filtered_df_reset = filtered_df.reset_index(drop=True)
filtered_df_reset
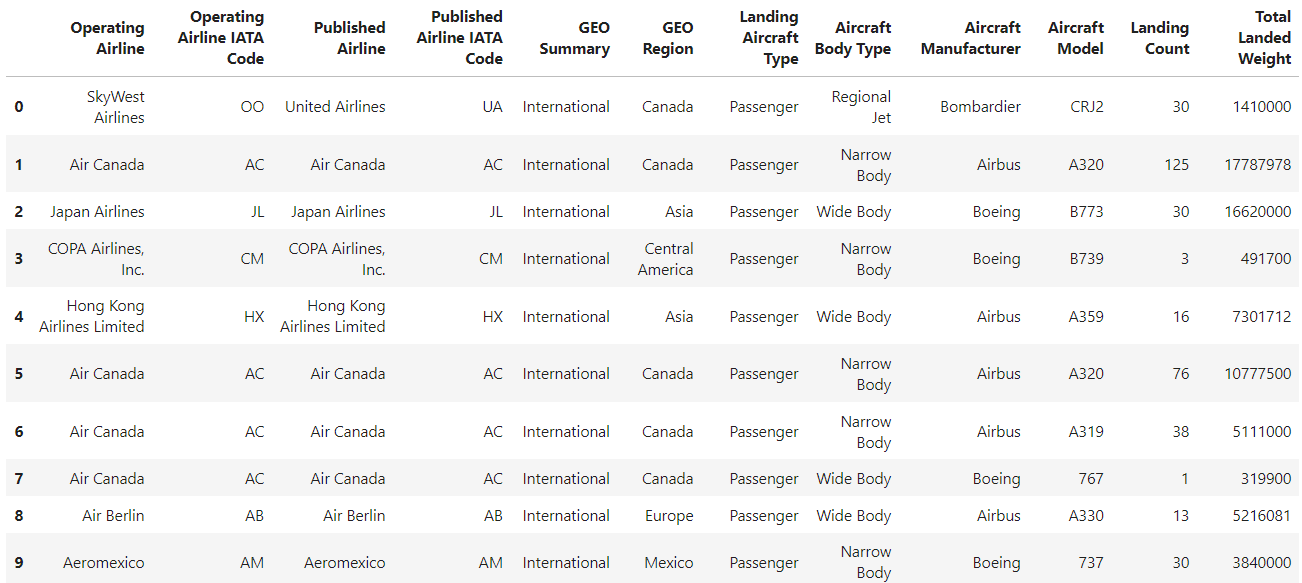
उत्कृष्ट! अब इंडेक्स डिफ़ॉल्ट पूर्णांक इंडेक्स (0, 1, 2, …) पर रीसेट हो गए हैं, जो एक साफ और क्रमिक इंडेक्स प्रदान करता है।
जब आप DataFrame को जोड़ते हैं, तो परिणामी DataFrame में डुप्लिकेट या गैर-अनुक्रमिक इंडेक्स हो सकते हैं। इंडेक्स को रीसेट करने से एक साफ और क्रमिक इंडेक्स बनता है।
मान लीजिए आपके पास दो DataFrame हैं और आप उन्हें कंसकैट करना चाहते हैं। प्रदर्शन हेतु मैंने एयरलाइंस डेटासेट से दो DataFrame बनाए हैं।
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
split_index = int(df.shape[0] / 2)
df1 = df[:split_index].head()
df2 = df[split_index:].head()
यह रहा df1:
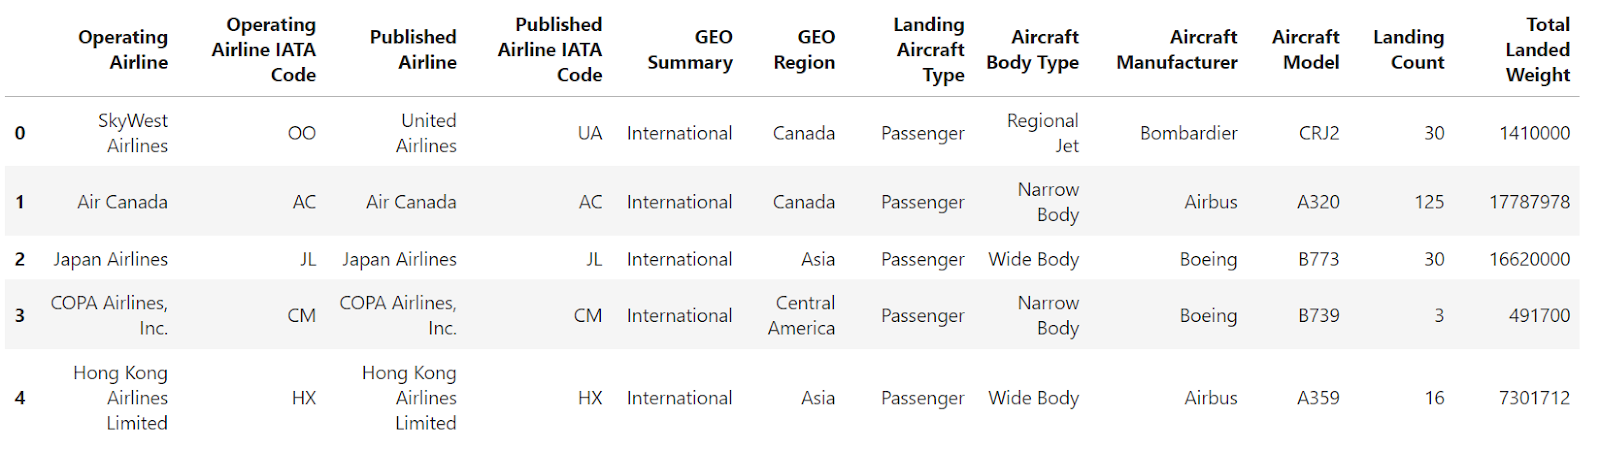
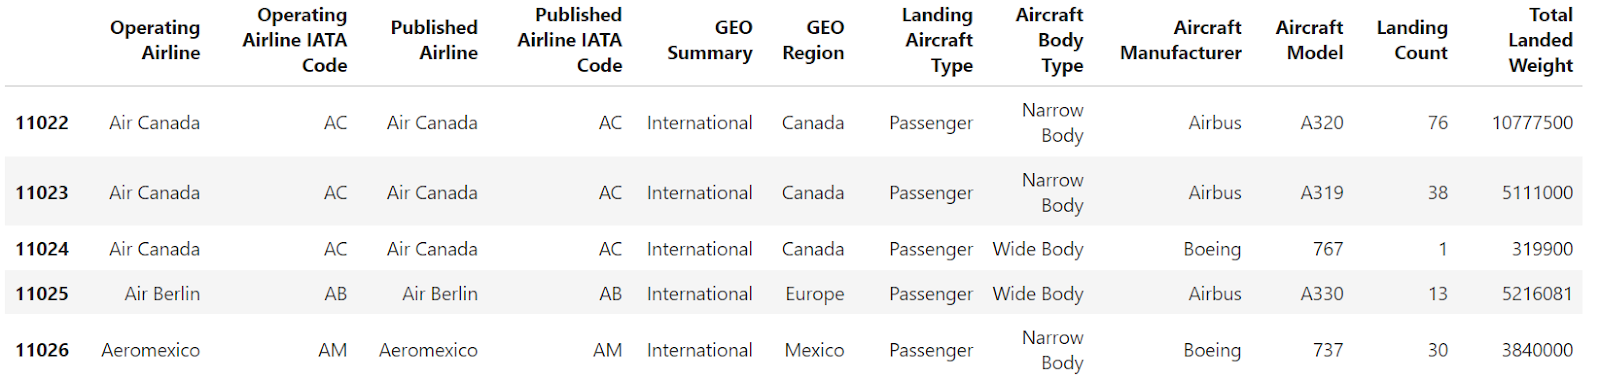
यह रहा df2:
आइए DataFrame df1 और df2 को कंसकैट करते हैं।
df_concat = pd.concat([df1, df2])
डेटा गैर-अनुक्रमिक इंडेक्स दिखाता है। हमें कंसकैट किए गए DataFrame का इंडेक्स रीसेट करके इसे अनुक्रमिक बनाना है।
आइए pandas में reset_index() मेथड का उपयोग करके DataFrame का इंडेक्स रीसेट करें।
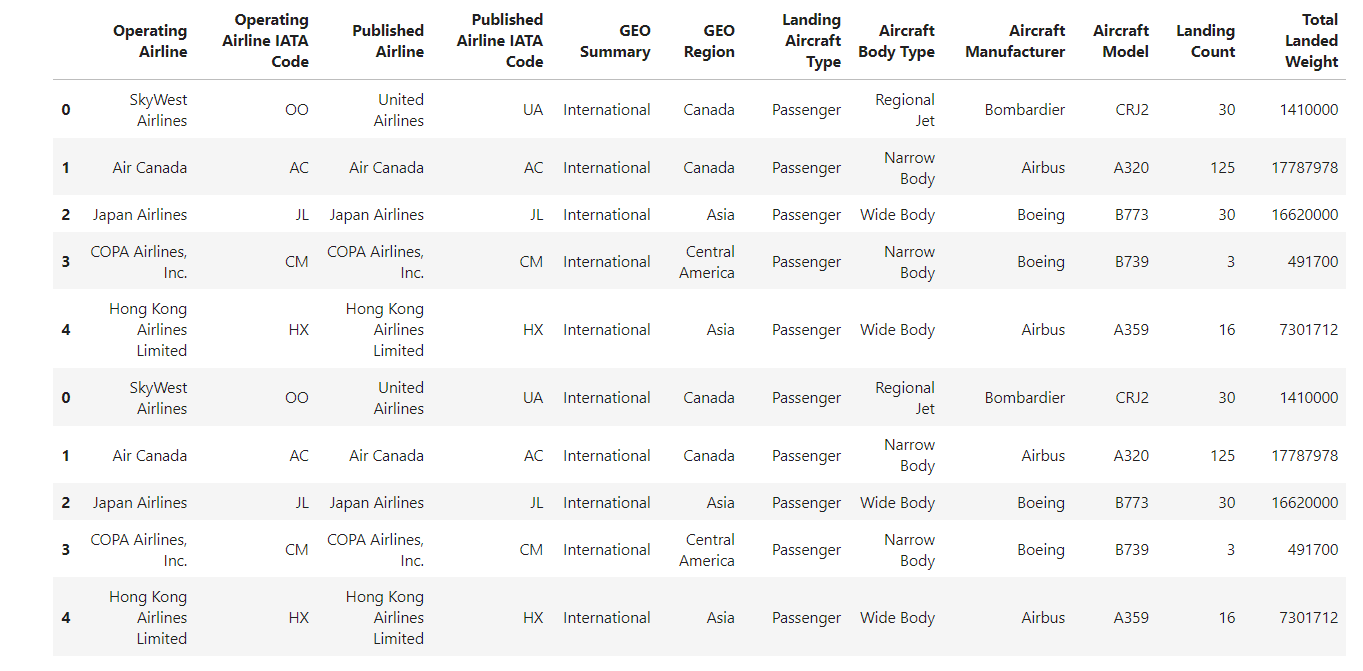
df_concat.reset_index()
यह रहा परिणाम, जब DataFrame का इंडेक्स रीसेट किया गया। reset_index मेथड पुराने इंडेक्स को नई कॉलम में बदल देती है। इस अतिरिक्त कॉलम को हटाने के लिए, आपको drop=True पैरामीटर का उपयोग करना होगा।
df_concat.reset_index(drop=True)
हाइरार्किकल (मल्टी-लेवल) इंडेक्सिंग वाले DataFrame के लिए, reset_index का उपयोग मल्टी-लेवल इंडेक्स को कॉलम में बदलकर DataFrame को सरल बनाने के लिए किया जा सकता है।
आइए मल्टी-लेवल इंडेक्स वाले एक DataFrame का उदाहरण देखते हैं।
import pandas as pd
df = pd.read_csv(
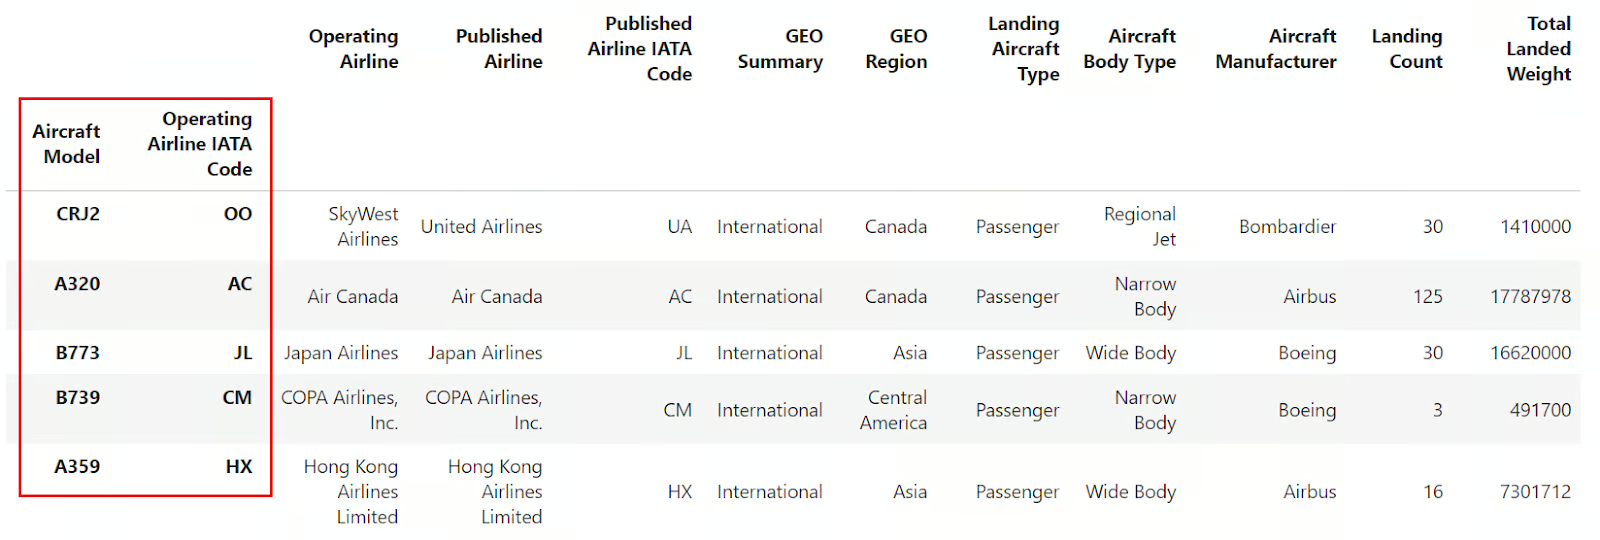
    "airlines_dataset.csv", index_col=["Aircraft Model", "Operating Airline IATA Code"]
).head()
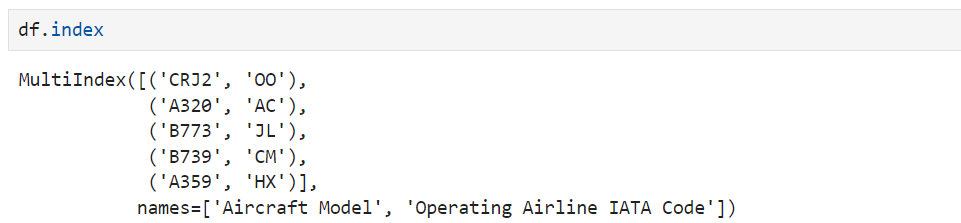
यदि आप इसका इंडेक्स देखें, तो पाएंगे कि यह सामान्य DataFrame इंडेक्स नहीं है बल्कि एक MultiIndex ऑब्जेक्ट है।
अब, pandas की reset_index() मेथड का उपयोग करते हैं, जो MultiIndex के सभी लेवल हटा देती है:
df.reset_index()
आप देख सकते हैं कि MultiIndex के दोनों लेवल सामान्य DataFrame कॉलम में बदल गए हैं और इंडेक्स डिफ़ॉल्ट पूर्णांक-आधारित पर रीसेट हो गया है।
आप level पैरामीटर का उपयोग करके DataFrame इंडेक्स से चुने हुए लेवल भी हटा सकते हैं। यह चुने हुए लेवल को सामान्य DataFrame कॉलम में बदल देता है, जब तक कि आप drop पैरामीटर का उपयोग करके इस जानकारी को DataFrame से पूरी तरह हटाने का चुनाव न करें। आइए इसे देखें:
df.reset_index(level=["Aircraft Model"])
ऊपर की छवि दिखाती है कि "Aircraft Model" अब DataFrame में एक सामान्य कॉलम है। केवल "Operating Airline IATA Code" इंडेक्स के रूप में बना रहता है।
अब, यदि आप नहीं चाहते कि सूची में वर्णित इंडेक्स एक सामान्य कॉलम बन जाए, तो आप drop और level पैरामीटर को मिलाकर उसे DataFrame से हटा सकते हैं।
df.reset_index(level=["Aircraft Model"], drop=True)
इंडेक्स 'Aircraft Model' को इंडेक्स और DataFrame दोनों से हटा दिया गया है। दूसरा इंडेक्स, 'Operating Airline IATA Code', DataFrame का वर्तमान इंडेक्स बना रहा।
मान लीजिए आप दो DataFrame को मर्ज करते हैं; परिणामी मर्ज किया गया DataFrame अब क्रमिक इंडेक्स नहीं रखेगा, जैसा कि नीचे दिए DataFrame में दिखाया गया है।
आइए pandas की reset_index() मेथड का उपयोग करके DataFrame का इंडेक्स रीसेट करें।
df.reset_index()
यहाँ drop निर्धारित करता है कि इंडेक्स रीसेट करने के बाद पुराने इंडेक्स को DataFrame में एक कॉलम के रूप में रखा जाए या उसे पूरी तरह हटा दिया जाए। डिफ़ॉल्ट रूप से (drop=False) पुराना इंडेक्स रखा जाता है, जैसा कि पिछले सभी उदाहरणों में दिखाया गया है। वैकल्पिक रूप से, drop=True सेट करने से रीसेट करने के बाद पुराने इंडेक्स को DataFrame से हटा दिया जाता है।
df.reset_index(drop=True)
नया DataFrame बनाए बिना परिवर्तन करने के लिए inplace पैरामीटर का उपयोग कर DataFrame को उसी जगह संशोधित करें।
मान लीजिए आपके पास नीचे दिया गया DataFrame है:
जब आप inplace पैरामीटर को True पर सेट करते हैं, तो परिवर्तन सीधे मूल DataFrame पर लागू होते हैं और अलग DataFrame बनने से बचा जा सकता है।
df_concat.reset_index(drop=True, inplace=True)
df_concat
डुप्लिकेट इंडेक्स को उचित रीसेटिंग और रिइंडेक्सिंग से प्रबंधित करें।
मान लीजिए आपके पास डुप्लिकेट इंडेक्स वाला डेटा है।
यहाँ reset_index() को drop=True और inplace=True के साथ उपयोग करने से सुनिश्चित होता है कि परिणामी DataFrame में 0 से शुरू होकर क्रमिक इंडेक्स होंगे।
df.reset_index(drop=True, inplace=True)
inplace=False पैरामीटर का उपयोग नहीं कर रहे हैं। यदि inplace को False पर सेट किया गया है, तो नया DataFrame रिटर्न होता है और मूल DataFrame अपरिवर्तित रहता है।drop पैरामीटर का सावधानी से उपयोग करें। इंडेक्स को ड्रॉप करने से वर्तमान इंडेक्स मान स्थायी रूप से हट जाते हैं।आइए जानें कि DataFrame का इंडेक्स रीसेट करना कैसे काम आता है और इसे मिसिंग वैल्यूज़ हटाते समय कैसे उपयोगी बनाया जा सकता है।
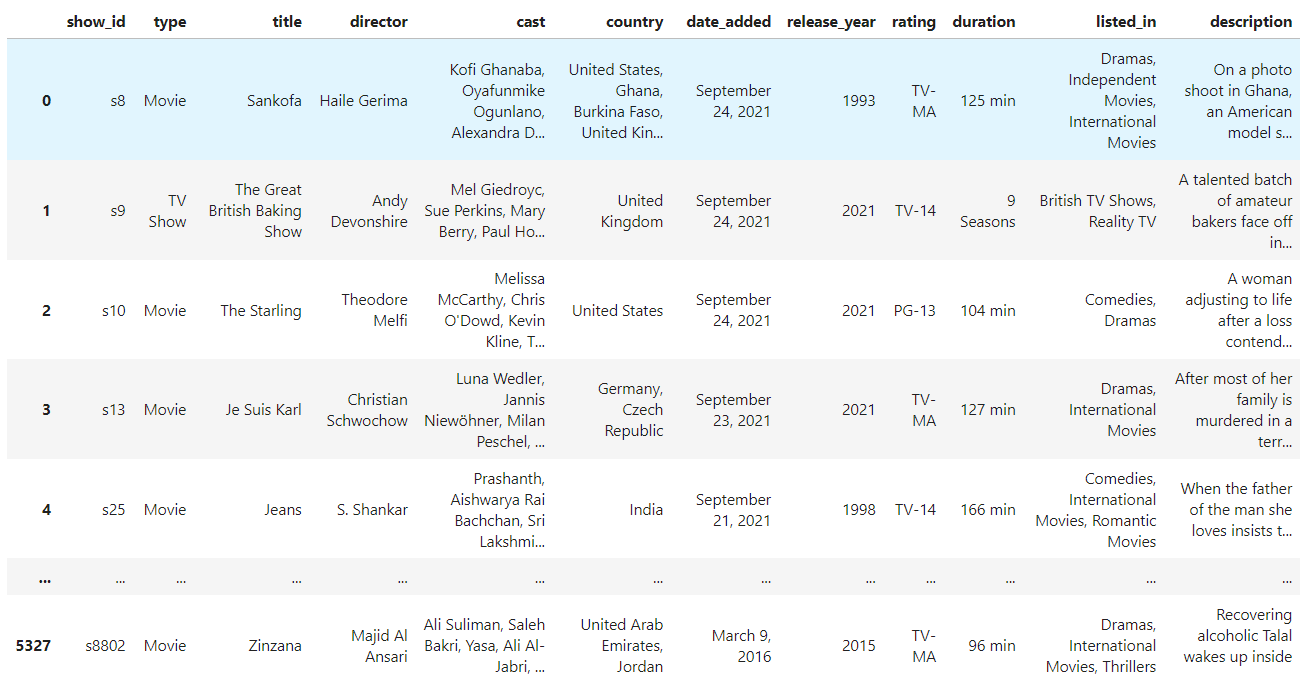
हमारे एयरलाइन डेटासेट में मिसिंग वैल्यूज़ नहीं हैं, इसलिए इसकी जगह Netflix Movies and TV shows डेटासेट का उपयोग करें। इसमें मिसिंग वैल्यूज़ हैं, जो reset_index() दिखाने के लिए उपयुक्त है।
import pandas as pd
df = pd.read_csv("netflix_shows.csv")
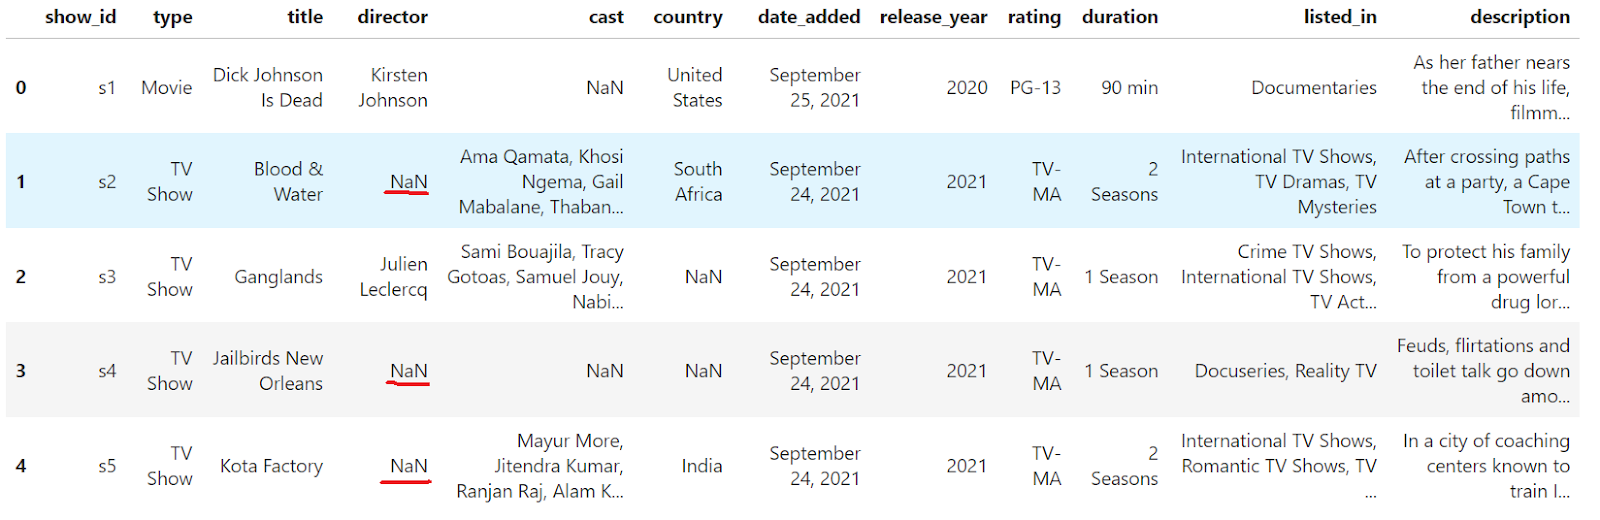
df.head()
आप देख सकते हैं कि DataFrame में मिसिंग वैल्यूज़ मौजूद हैं। dropna() मेथड का उपयोग कर मिसिंग वैल्यू वाली पंक्तियाँ हटा दें।
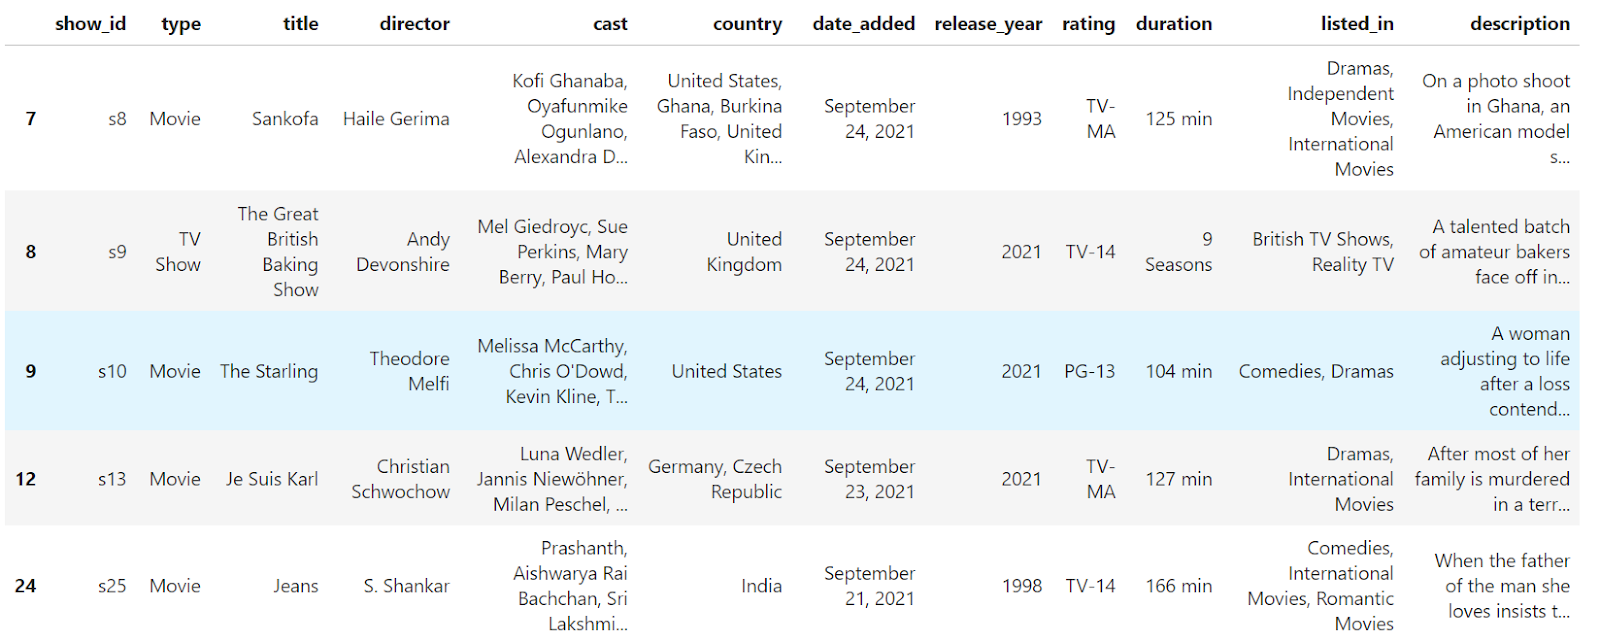
df.dropna(inplace=True)
df.head()
NaN मानों वाली पंक्तियाँ DataFrame से हटा दी गई हैं। हालाँकि, इंडेक्स अब निरंतर नहीं है (0, 1, 2, 4)। आइए इसे रीसेट करें:
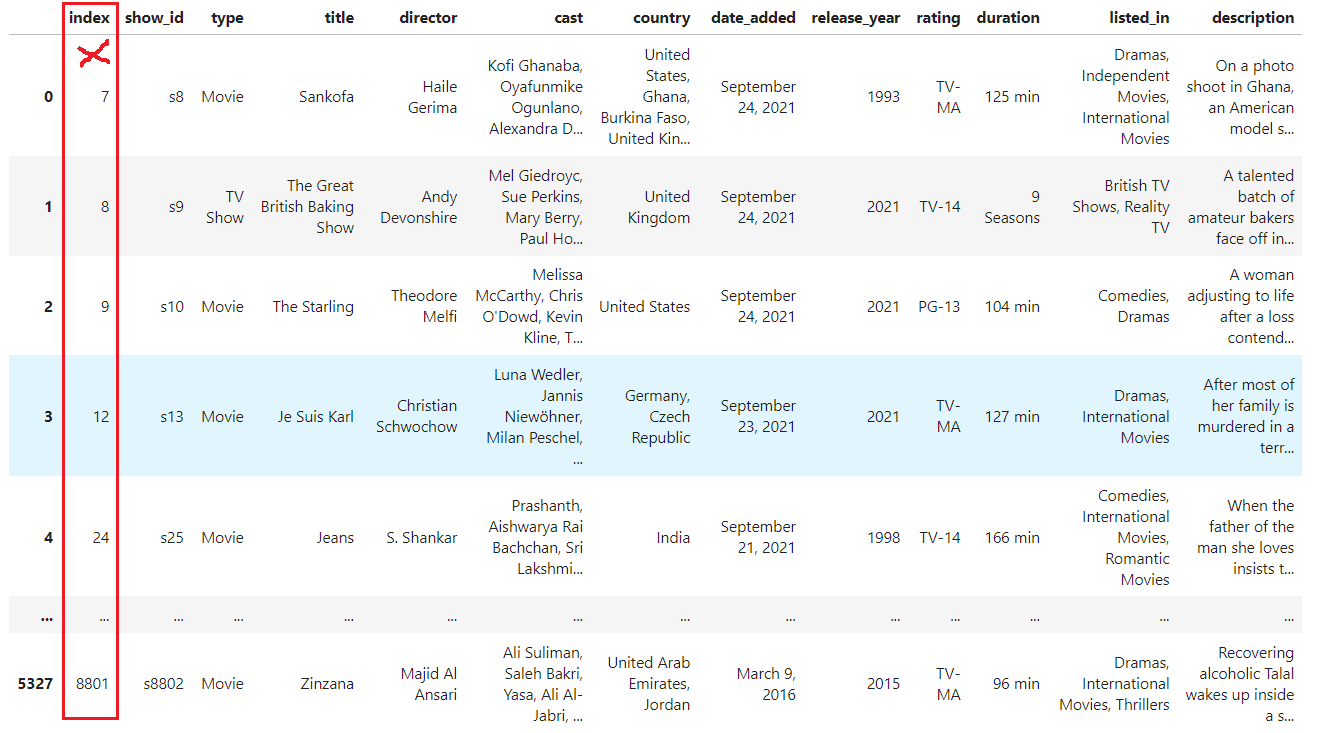
df.reset_index()
अब इंडेक्स निरंतर है; लेकिन चूँकि हमने स्पष्ट रूप से drop पैरामीटर पास नहीं किया, इसलिए पुराने इंडेक्स को डिफ़ॉल्ट नाम index के साथ एक कॉलम में बदल दिया गया। आइए पुराने इंडेक्स को DataFrame से पूरी तरह हटा दें:
df.reset_index(drop=True)
हमने पुराने, अर्थहीन इंडेक्स को पूरी तरह हटा दिया है और वर्तमान इंडेक्स अब निरंतर है। अंतिम चरण है इन संशोधनों को हमारे मूल DataFrame में सहेजना, इसके लिए inplace पैरामीटर का उपयोग करें:
df.reset_index(drop=True, inplace=True)आपने सीखा कि reset_index फ़ंक्शन Pandas में कितनी कुशलता से DataFrame इंडेक्स प्रबंधित करता है। चाहे आप फ़िल्टर किए गए डेटा, संयोजित DataFrame, या जटिल मल्टी-लेवल इंडेक्सिंग से निपट रहे हों, reset_index एक साफ़-सुथरा और व्यवस्थित DataFrame सुनिश्चित करता है। इसके पैरामीटर डेटा मैनिपुलेशन कार्यों में विविध इंडेक्सिंग परिदृश्यों को प्रबंधित करने में मदद करते हैं।
इसी तरह के फ़ंक्शन का उपयोग करना सीखते रहें, जो reset_index जैसे हैं, DataCamp के Data Analyst with Python career track के साथ। यदि आप लिस्ट्स के साथ काम कर रहे हैं और लिस्ट पर लागू होने वाले index() फ़ंक्शन के बारे में सीखना चाहते हैं, तो हमारा Python List Index() Tutorial भी पढ़ सकते हैं।
Top pandas Courses
कोर्स
कोर्स
कोर्स