Cursus
Datamanipulatie met pandas
4 uur
567.9K
Na het manipuleren en filteren van een grote dataset kun je precies het DataFrame overhouden dat je nodig hebt. Dit DataFrame behoudt echter de oorspronkelijke index, die niet-sequentieel kan zijn. In zulke gevallen moet je de index van het DataFrame resetten.
In deze tutorial bespreken we de pandas-methode reset_index(), die wordt gebruikt om de index van een DataFrame te resetten. We verkennen de verschillende opties die bij deze methode beschikbaar zijn. Daarnaast behandelen we hoe je de index reset voor een eenvoudig en een meerlagig (MultiIndex) DataFrame.
Om het resetten van DataFrame-indexen te oefenen, gebruiken we een airline-dataset. We gebruiken Datalab van Datacamp, een interactieve omgeving die speciaal is ontworpen voor data-analyse in Python, waardoor het een perfect hulpmiddel is om deze tutorial te volgen.
De methode reset_index in Pandas zet de index van een DataFrame terug naar de standaardindex. Na operaties zoals filteren, concatenatie of mergen is de index mogelijk niet meer sequentieel. Deze methode helpt om weer een nette, oplopende index in te stellen. Als het DataFrame een MultiIndex heeft, kan het een of meer niveaus verwijderen.
Basissyntax:
df.reset_index(level=None, drop=False, inplace=False, col_level=0, col_fill="")Parameters:
Retourneert:
DataFrame met de nieuwe index of None als inplace=True is.
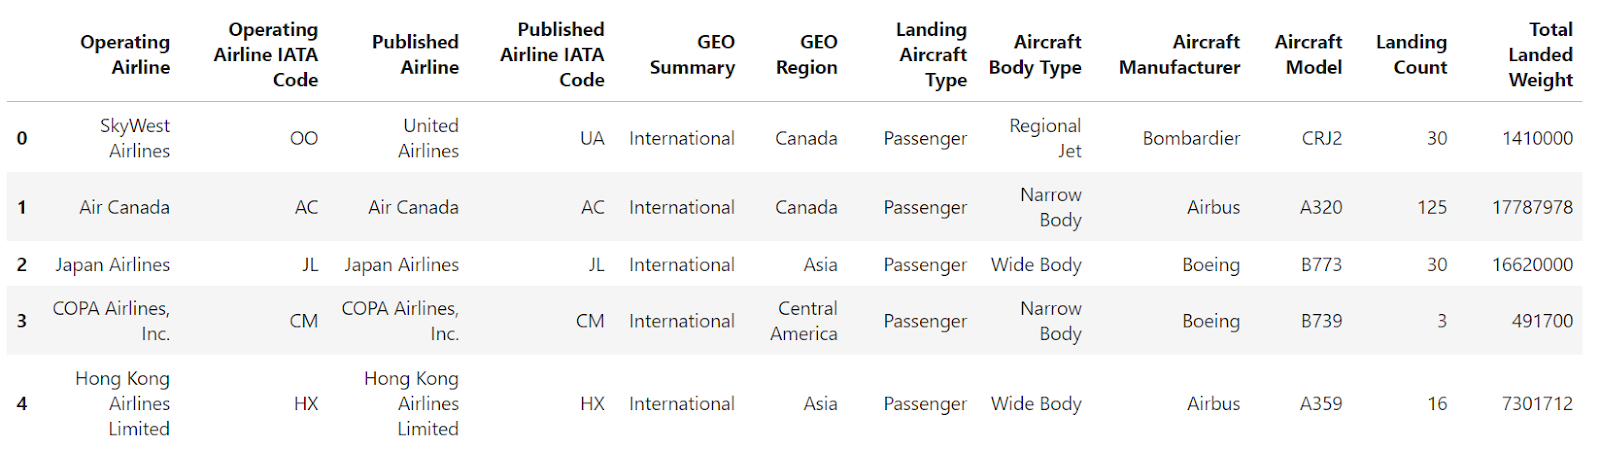
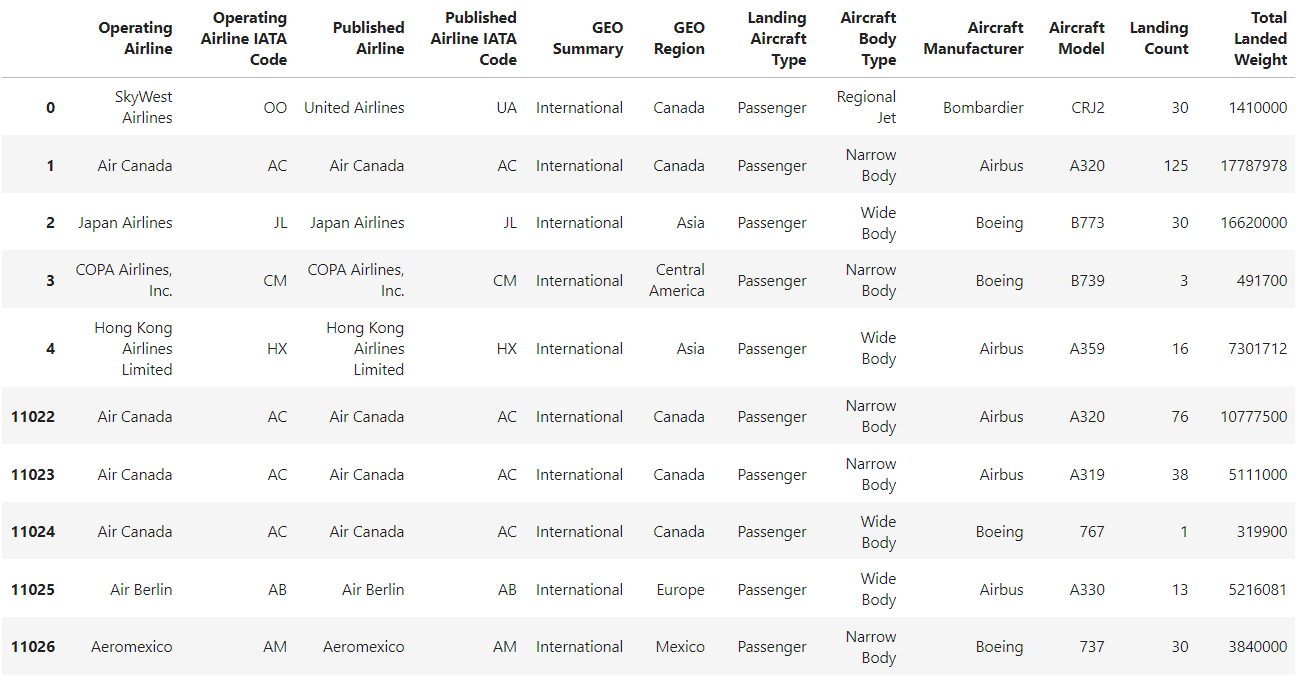
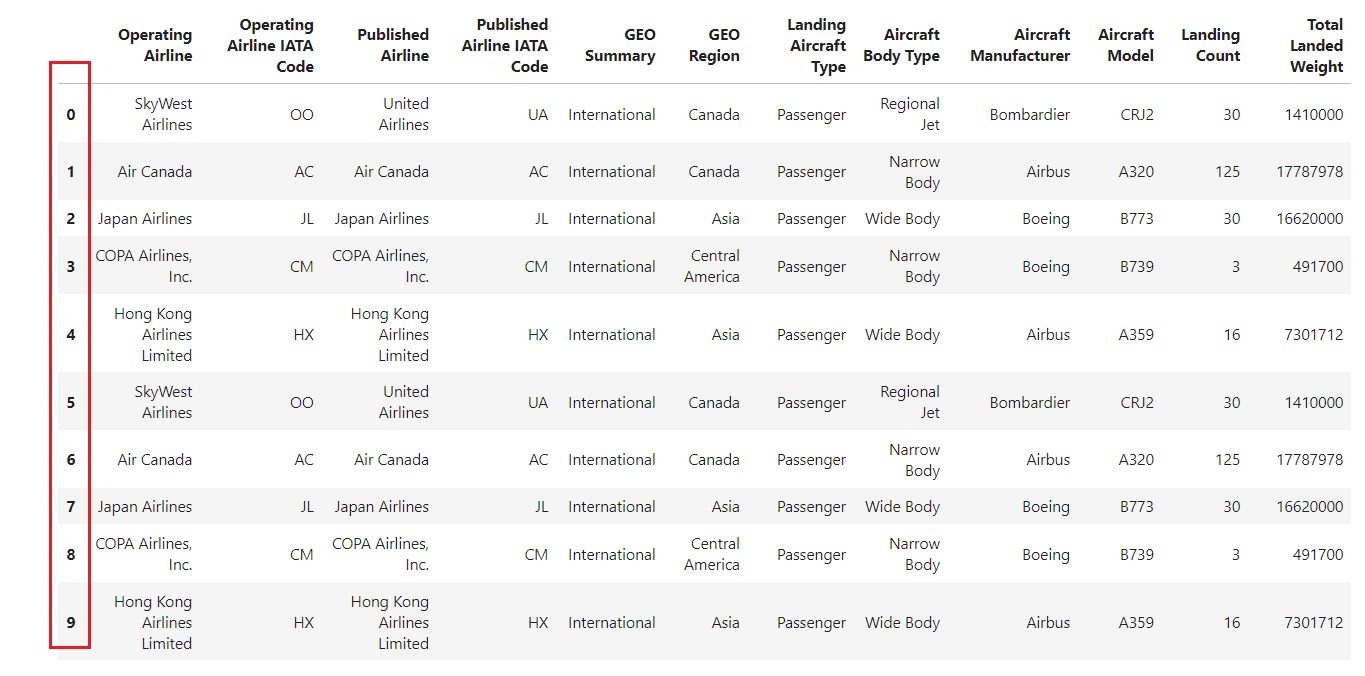
Als je een CSV-bestand inleest met de pandas-methode read_csv() zonder een index op te geven, krijgt het resulterende DataFrame een standaard, op gehele getallen gebaseerde index die begint bij 0 en voor elke volgende rij met 1 toeneemt.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df
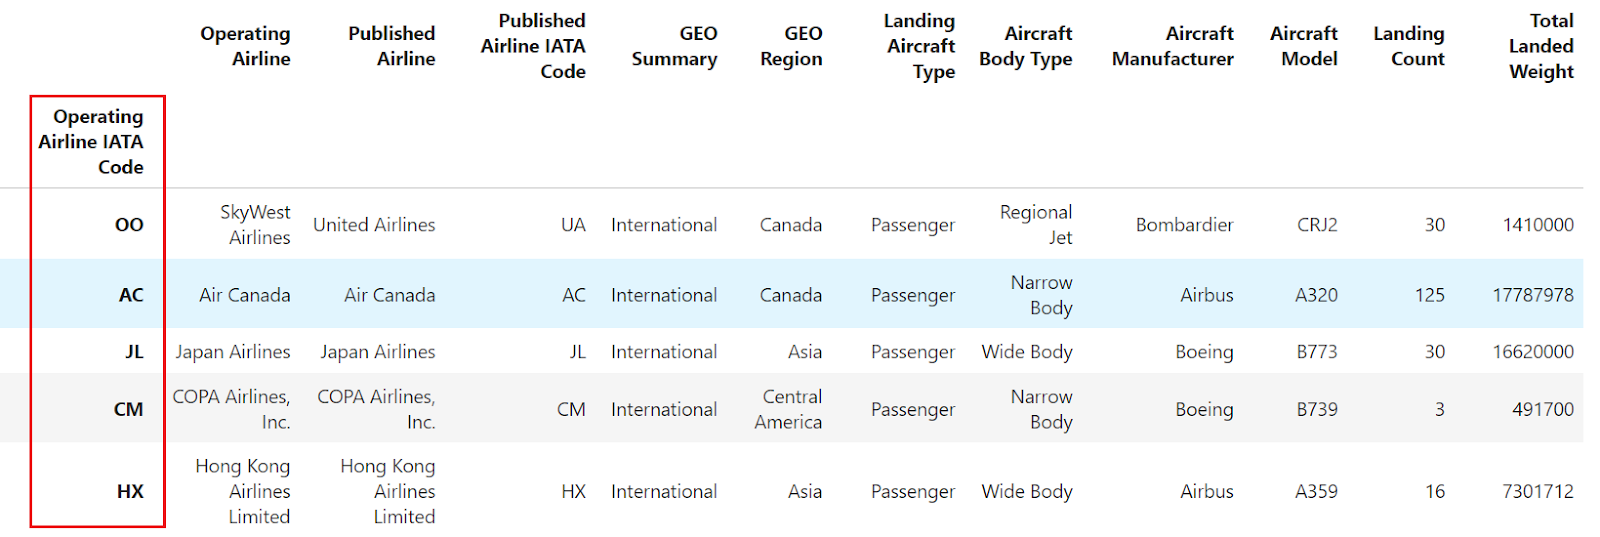
In sommige gevallen wil je liever meer beschrijvende rijenlabels. Je kunt hiervoor een van de kolommen van het DataFrame als index (rijlabels) instellen. Wanneer je de methode read_csv() gebruikt om data uit een CSV te laden, kun je de gewenste kolom als index opgeven met de parameter index_col.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv", index_col="Operating Airline IATA Code").head()
df
Je kunt ook de methode set_index() gebruiken om een willekeurige kolom van een DataFrame als index in te stellen:
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df.set_index("Operating Airline IATA Code", inplace=True)
df
Merk op dat dit codefragment wijzigingen aanbrengt in het oorspronkelijke DataFrame.
Wat als je de standaard numerieke index wilt herstellen? Dan komt de pandas-methode reset_index() in beeld.
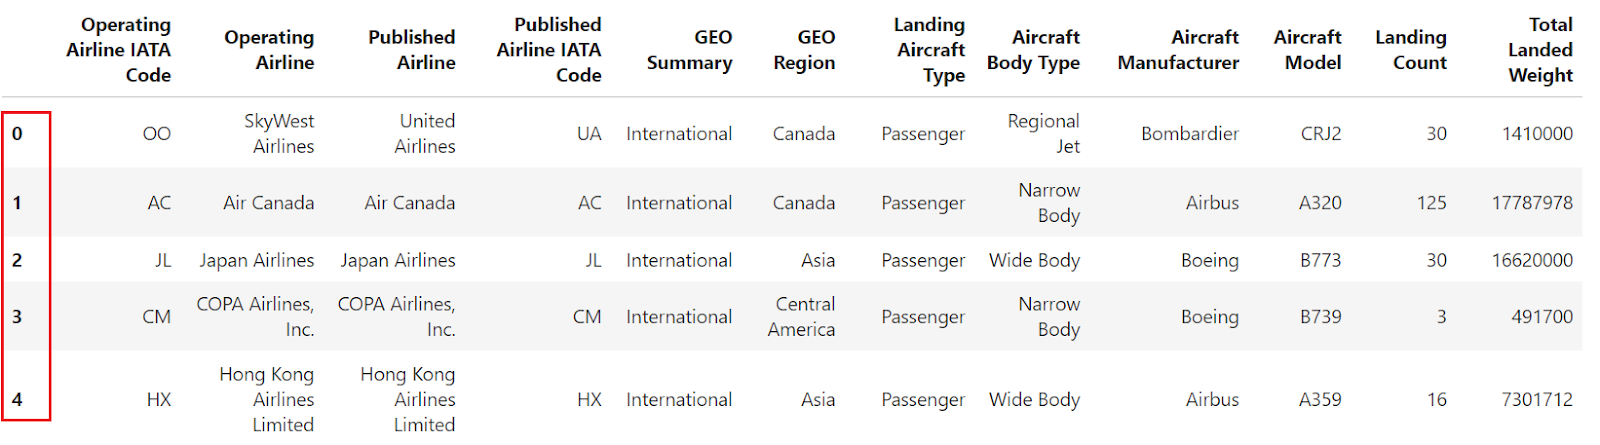
df.reset_index()
Het voorbeeld laat zien dat, nadat de kolom 'Operating Airline IATA Code' als index is ingesteld, reset_index wordt gebruikt om het DataFrame terug te zetten naar de standaard, op gehele getallen gebaseerde index.
De methode reset_index() in Pandas is een krachtig hulpmiddel om DataFrame-indexen te herorganiseren wanneer je werkt met gefilterde datasets, geconcateneerde DataFrames of meerlagige indexen.
Leer meer over het herschikken van DataFrames van breed naar lang formaat, hoe je rijen en kolommen stackt en unstackt, en hoe je met multi-index DataFrames werkt in onze online cursus.
Wanneer je een DataFrame filtert, blijft de oorspronkelijke index behouden. Met reset_index kun je het gefilterde DataFrame herindexeren.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
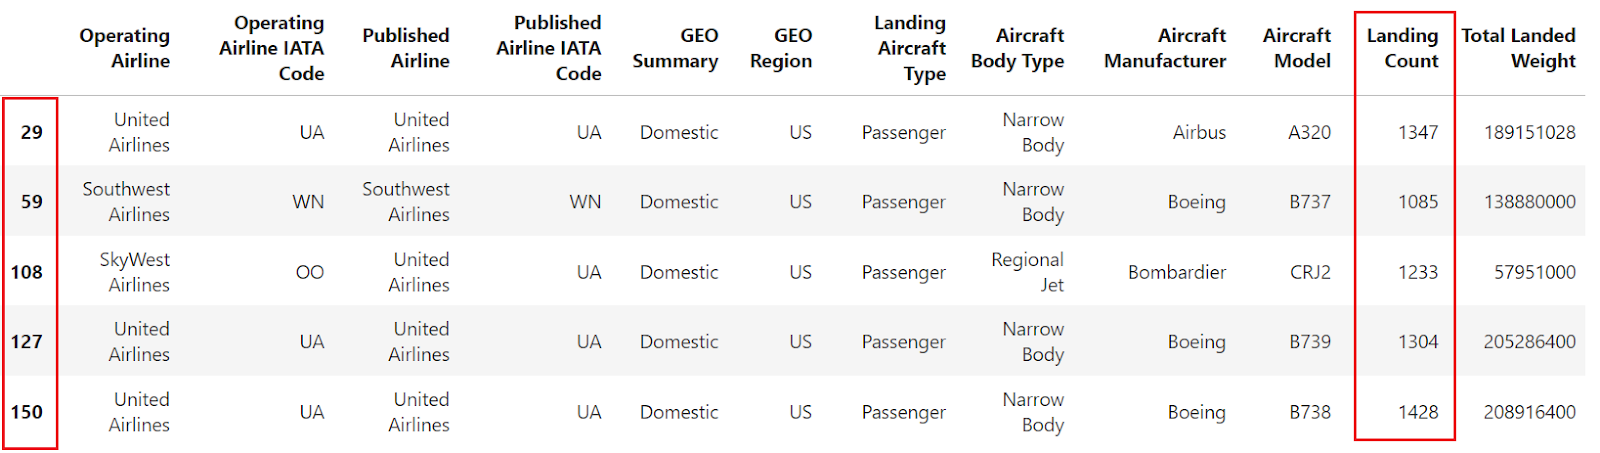
Laten we de data filteren zodat alleen de rijen overblijven waar de "landing count" groter is dan 1000. Na het filteren zijn de indexen mogelijk niet sequentieel. Vervolgens kun je de methode reset_index gebruiken om de index van het gefilterde DataFrame te resetten.
filtered_df = df[df["Landing Count"] > 1000].head()
filtered_df
De bovenstaande afbeelding laat zien dat het dataframe is gefilterd op basis van de toegepaste voorwaarde, maar de index is niet sequentieel. Laten we nu reset_index gebruiken om het gefilterde DataFrame te herindexeren en te zorgen voor een sequentiële index. Zo doe je dat:
filtered_df_reset = filtered_df.reset_index()
filtered_df_reset
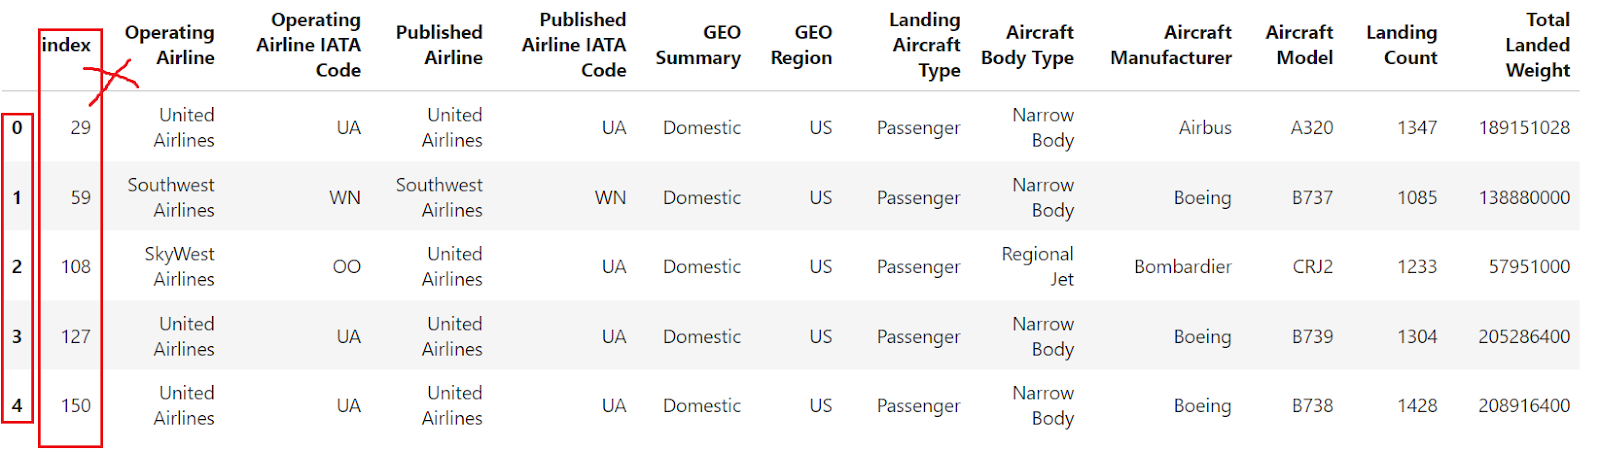
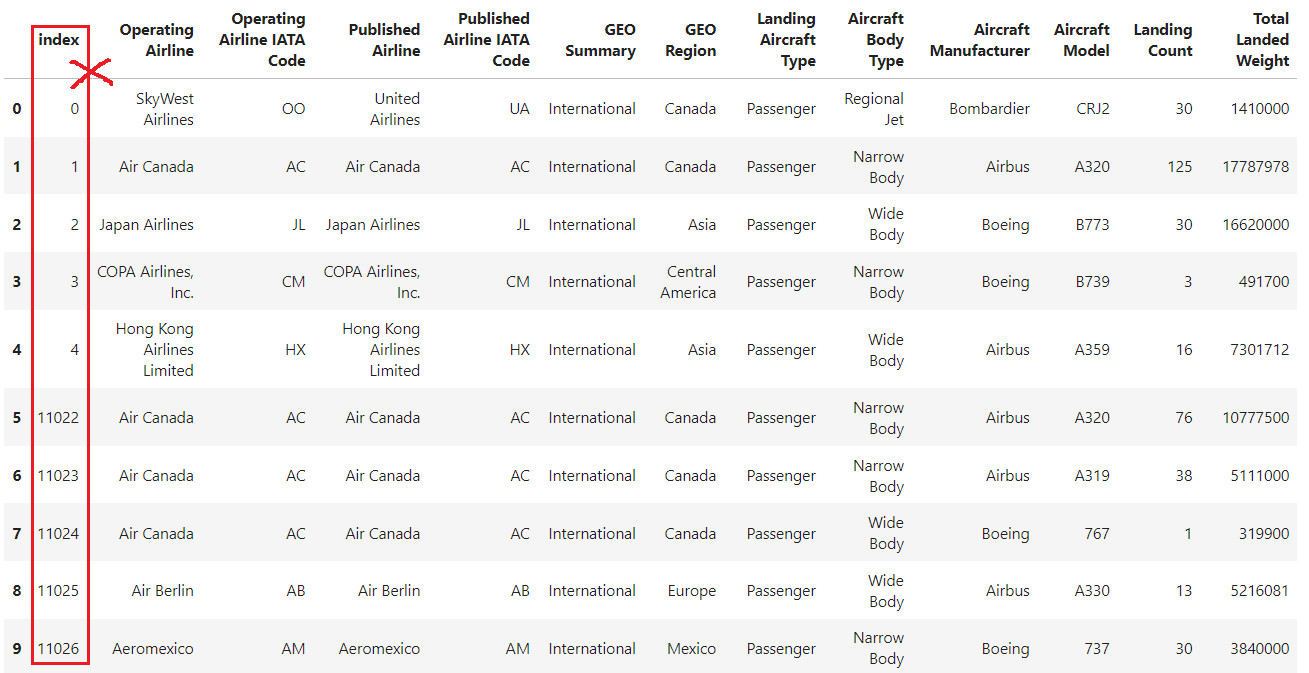
Het standaardgedrag van deze methode omvat het vervangen van de bestaande DataFrame-index door een standaard, op gehele getallen gebaseerde index en het omzetten van de oude index in een nieuwe kolom met dezelfde naam (of "index" als die geen naam had).
Gebruik daarom de parameter drop=True, zodat de oude index niet als nieuwe kolom wordt toegevoegd.
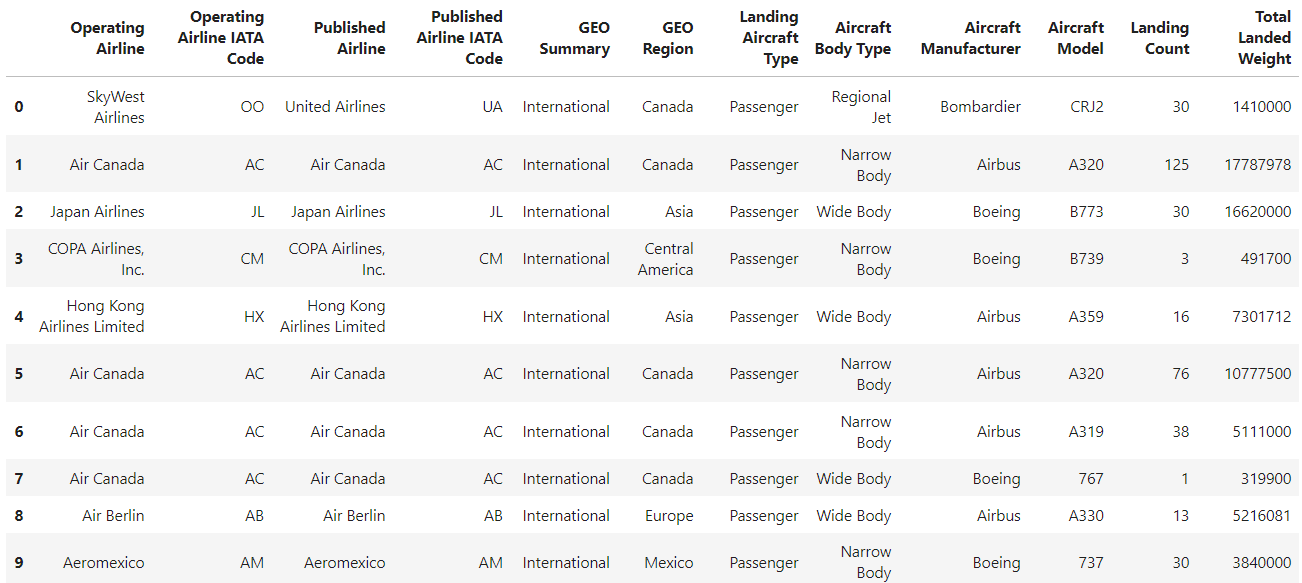
filtered_df_reset = filtered_df.reset_index(drop=True)
filtered_df_reset
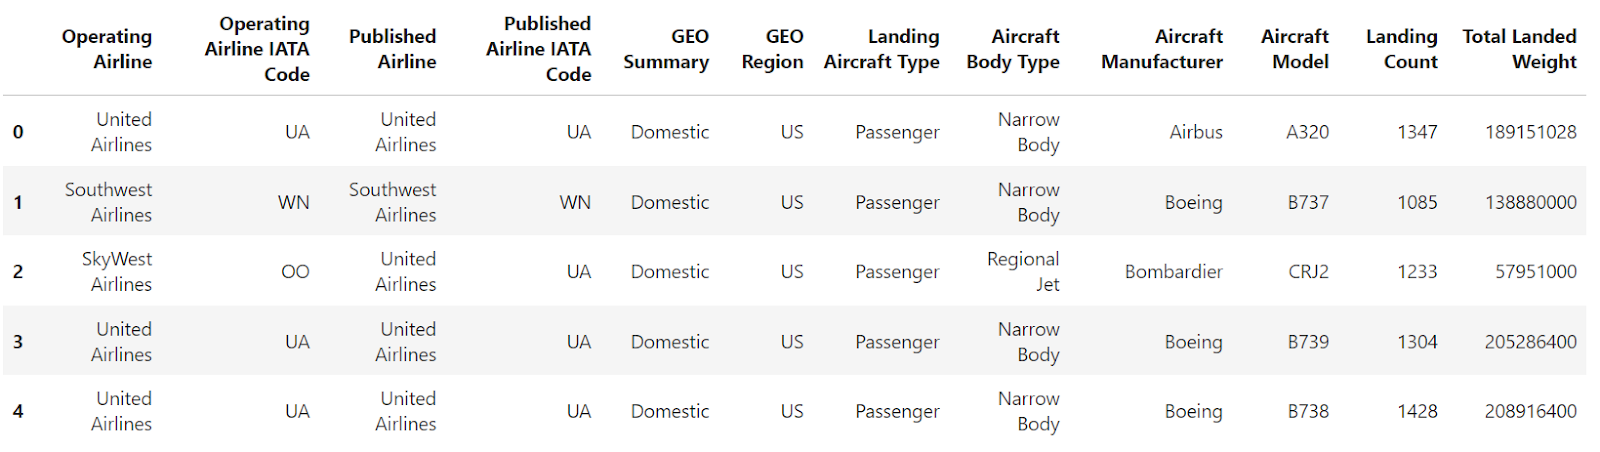
Top! De indexen zijn nu teruggezet naar de standaard integer-index (0, 1, 2, …), wat zorgt voor een schone en sequentiële index.
Bij het combineren van DataFrames kan het resulterende DataFrame dubbele of niet-sequentiële indexen bevatten. Door de index te resetten creëer je een nette, sequentiële index.
Stel, je hebt twee DataFrames die je wilt concatenëren. Voor demodoeleinden heb ik twee DataFrames uit de airlines-dataset gemaakt.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
split_index = int(df.shape[0] / 2)
df1 = df[:split_index].head()
df2 = df[split_index:].head()
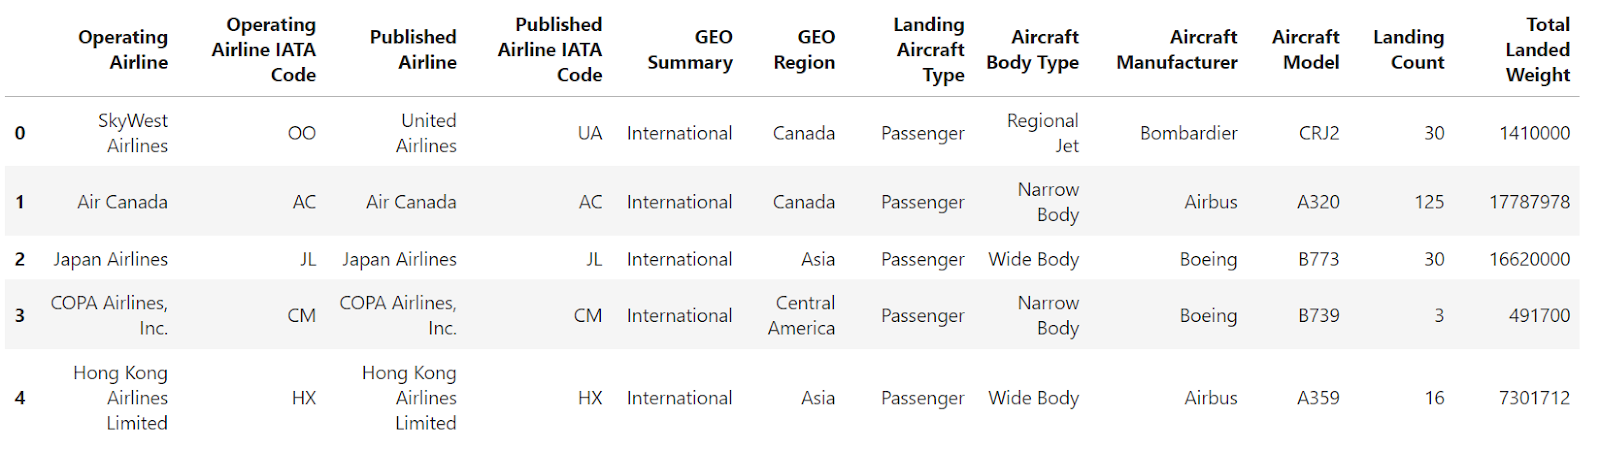
Dit is df1:
Dit is df2:
Laten we de DataFrames df1 en df2 samenvoegen.
df_concat = pd.concat([df1, df2])
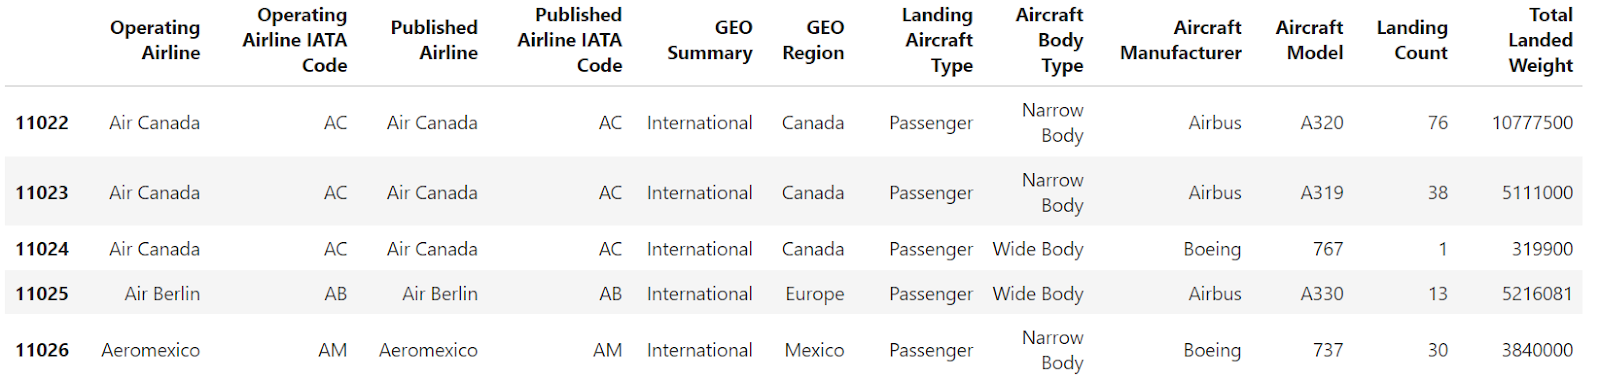
De data laat niet-sequentiële indexen zien. We moeten de index van het geconcateneerde DataFrame resetten om deze sequentieel te maken.
Laten we de index van het DataFrame resetten met de pandas-methode reset_index().
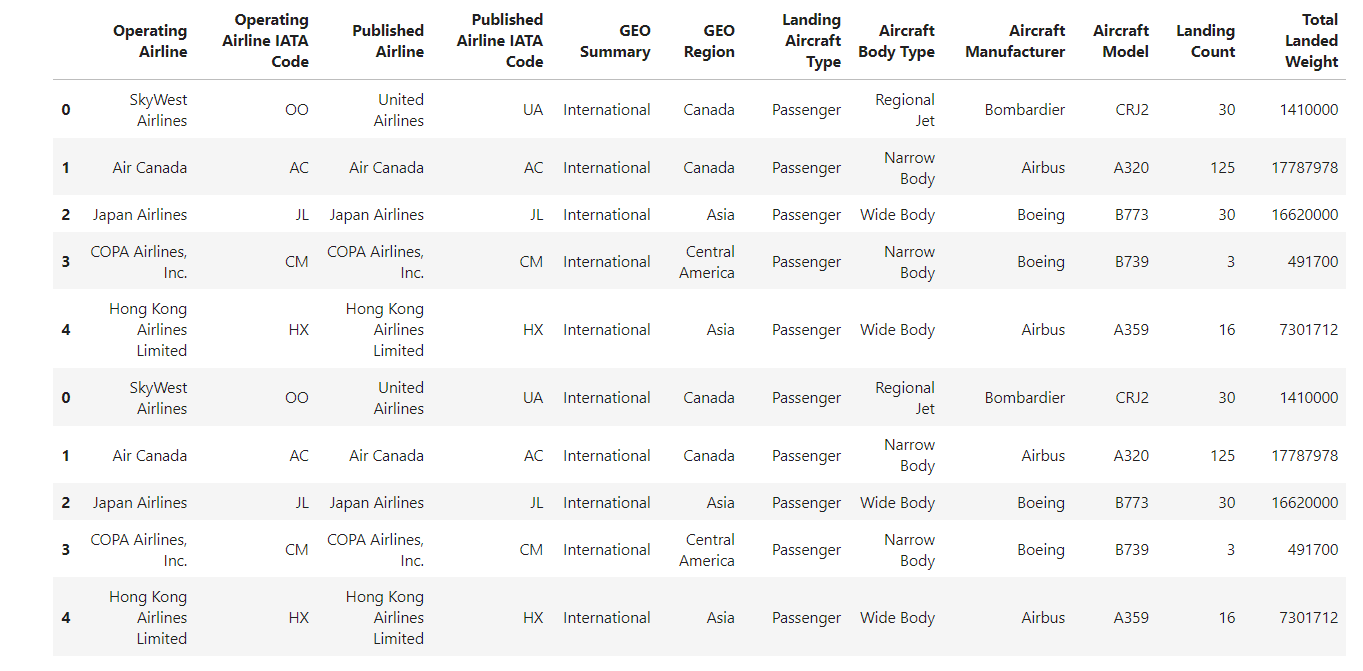
df_concat.reset_index()
Zo ziet het resultaat eruit na het resetten van de index van het DataFrame. De methode reset_index zet de oude index om in een nieuwe kolom. Om deze extra kolom te verwijderen, gebruik je de parameter drop=True.
df_concat.reset_index(drop=True)
Voor DataFrames met hiërarchische (meerlagige) indexen kan reset_index worden gebruikt om het DataFrame te vereenvoudigen door de multi-index weer om te zetten naar kolommen.
Laten we kijken naar een voorbeeld van een DataFrame met een meerlagige index.
import pandas as pd
df = pd.read_csv(
    "airlines_dataset.csv", index_col=["Aircraft Model", "Operating Airline IATA Code"]
).head()
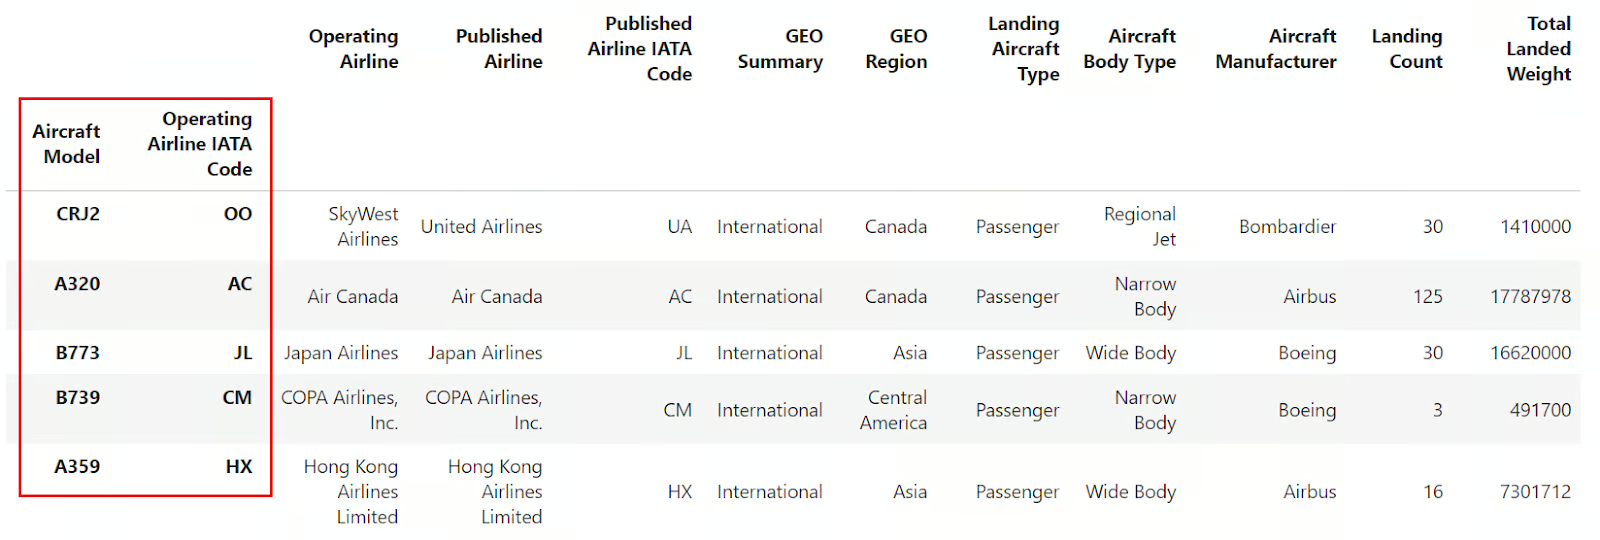
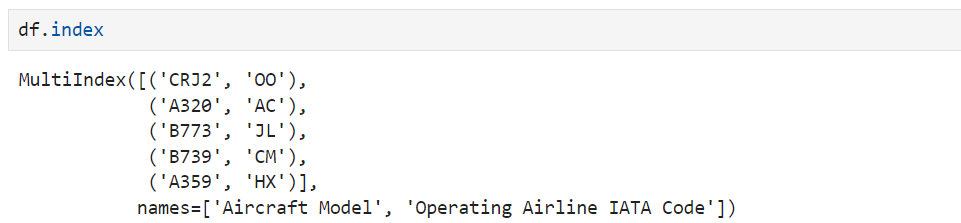
Als je de index bekijkt, zie je dat het geen gewone DataFrame-index is maar een MultiIndex-object
Laten we nu de pandas-methode reset_index() gebruiken, die alle niveaus van een MultiIndex verwijdert:
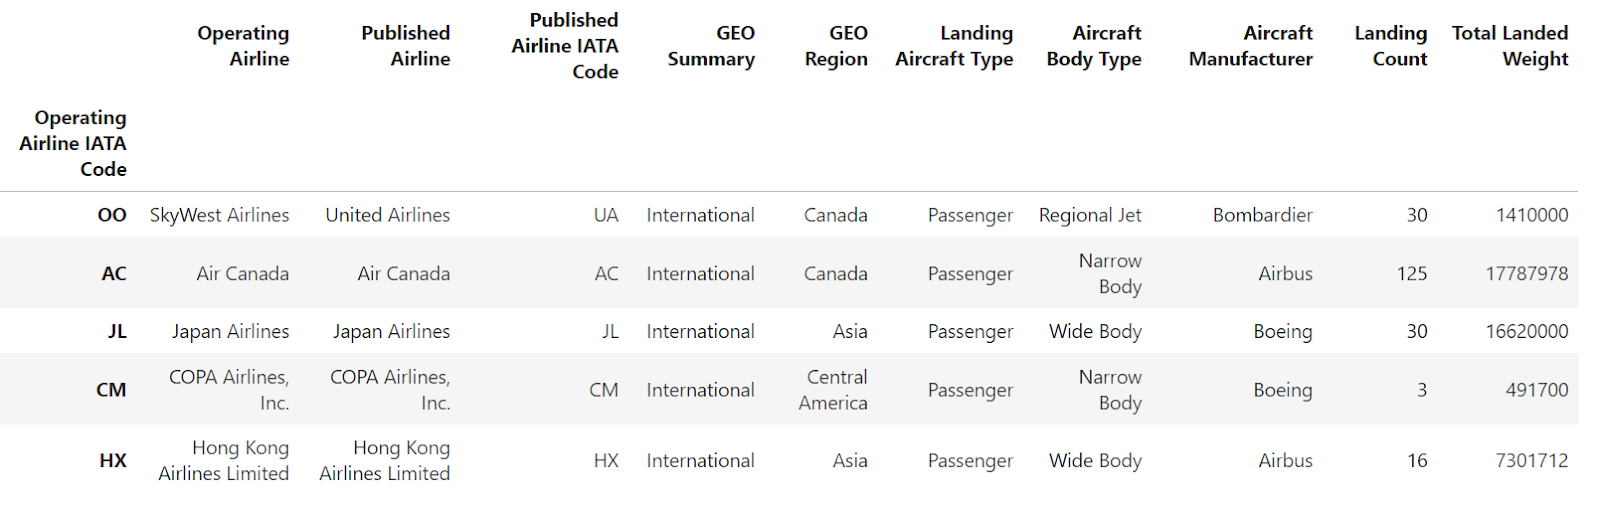
df.reset_index()
Je ziet dat beide niveaus van de MultiIndex zijn omgezet naar gewone DataFrame-kolommen, terwijl de index is teruggezet naar de standaard, op gehele getallen gebaseerde index.
Je kunt ook de parameter level gebruiken om geselecteerde niveaus uit de DataFrame-index te verwijderen. Het zet de geselecteerde niveaus om naar gewone DataFrame-kolommen, tenzij je ervoor kiest deze informatie volledig uit het DataFrame te verwijderen met de parameter drop. Laten we dit bekijken:
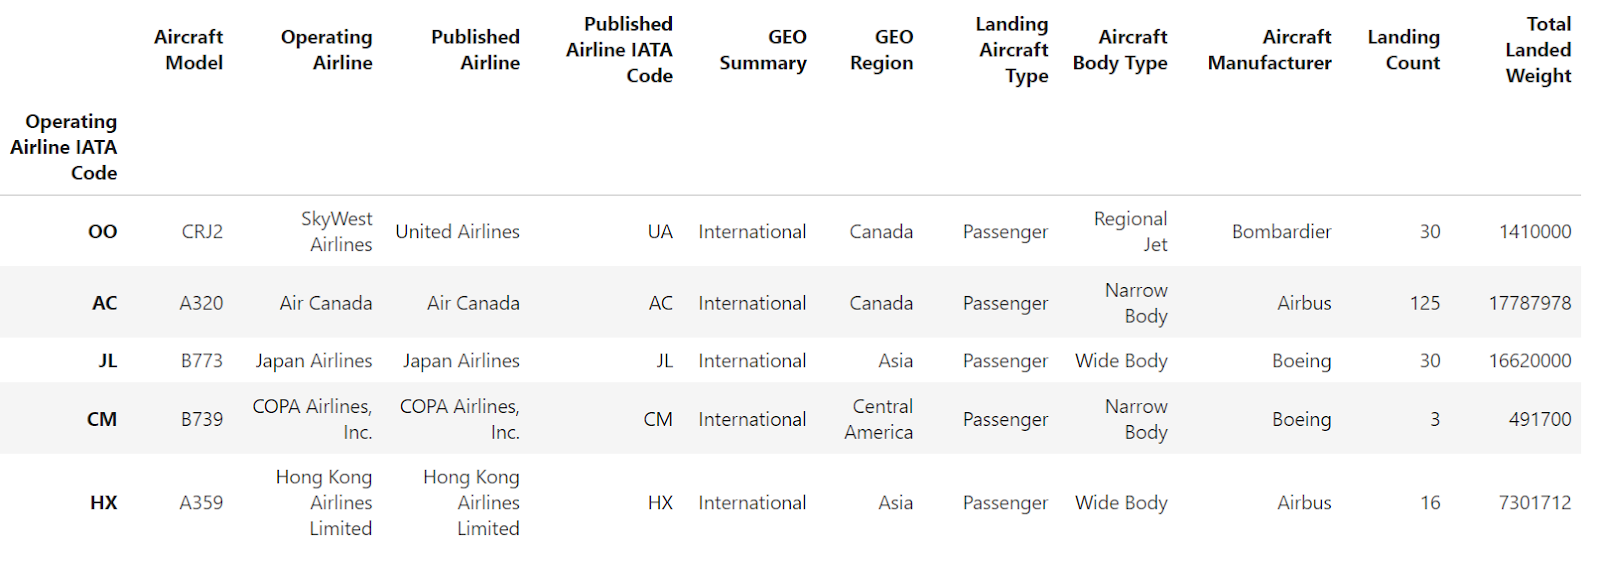
df.reset_index(level=["Aircraft Model"])
De bovenstaande afbeelding laat zien dat "Aircraft Model" nu een gewone kolom is in het DataFrame. Alleen "Operating Airline IATA Code" blijft als index over.
Als je niet wilt dat de in de lijst beschreven index een gewone kolom wordt, kun je de parameters drop en level combineren om deze uit het DataFrame te verwijderen.
df.reset_index(level=["Aircraft Model"], drop=True)
De index 'Aircraft Model' is uit de index en het DataFrame verwijderd. De andere index, 'Operating Airline IATA Code', is behouden als de huidige index van het DataFrame.
Stel dat je twee DataFrames merge’t; het resulterende samengevoegde DataFrame heeft dan geen sequentiële indexen meer, zoals in het onderstaande DataFrame te zien is.
Laten we de index van het DataFrame resetten met de pandas-methode reset_index().
df.reset_index()
De parameter drop bepaalt of je de oude index na het resetten als kolom in het DataFrame behoudt of volledig verwijdert. Standaard (drop=False) blijft de oude index behouden, zoals in alle vorige voorbeelden is gedemonstreerd. Als je daarentegen drop=True instelt, wordt de oude index na het resetten uit het DataFrame verwijderd.
df.reset_index(drop=True)
Wijzig het DataFrame in place met de parameter inplace om te voorkomen dat er een nieuw DataFrame wordt aangemaakt.
Stel dat je het onderstaande DataFrame hebt:
Door de parameter inplace op True te zetten, worden de wijzigingen direct op het oorspronkelijke DataFrame toegepast, waardoor het aanmaken van een apart DataFrame wordt vermeden.
df_concat.reset_index(drop=True, inplace=True)
df_concat
Beheer dubbele indexen door correct te resetten en te herindexeren.
Stel dat je data hebt met dubbele indexen.
Door reset_index() te gebruiken met drop=True en inplace=True zorg je ervoor dat het resulterende DataFrame doorlopende indexen heeft, beginnend bij 0 en sequentieel oplopend.
df.reset_index(drop=True, inplace=True)
inplace=False gebruikt als je verwacht dat het oorspronkelijke DataFrame wordt aangepast. Als inplace is ingesteld op False, wordt een nieuw DataFrame geretourneerd en blijft het oorspronkelijke DataFrame ongewijzigd.drop om onbedoeld gegevensverlies te voorkomen. Het droppen van de index verwijdert de huidige indexwaarden permanent.Laten we toepassen wat we hebben geleerd over het resetten van de DataFrame-index en bekijken hoe dit nuttig kan zijn bij het droppen van missende waarden.
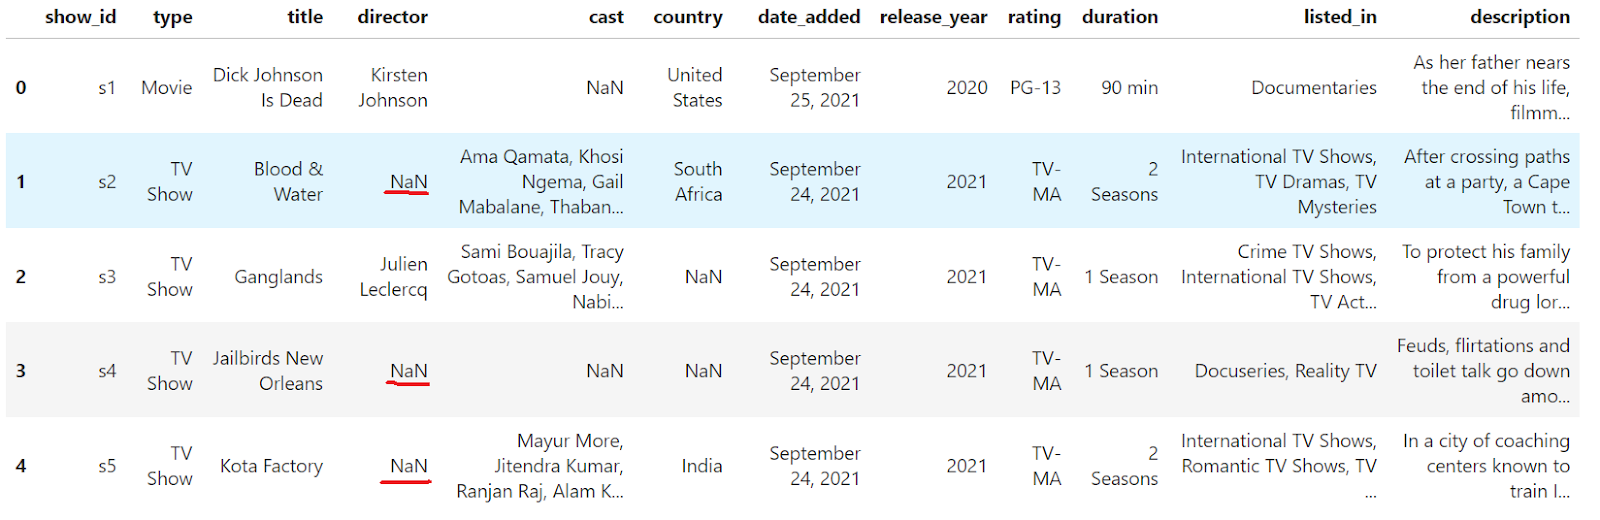
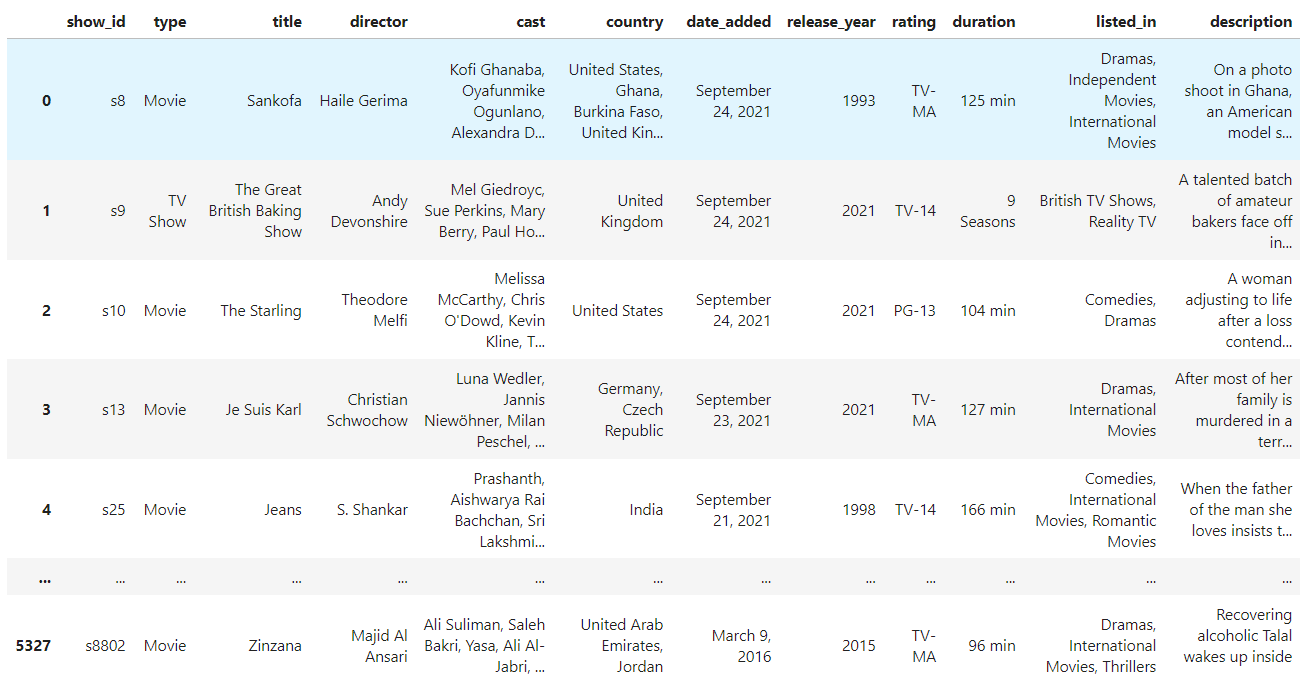
Onze airline-dataset heeft geen missende waarden, dus laten we in plaats daarvan de dataset Netflix Movies and TV shows gebruiken. Die bevat missende waarden, ideaal om reset_index() te demonstreren.
import pandas as pd
df = pd.read_csv("netflix_shows.csv")
df.head()
Je ziet dat er missende waarden in het DataFrame staan. Verwijder rijen met missende waarden met de methode dropna().
df.dropna(inplace=True)
df.head()
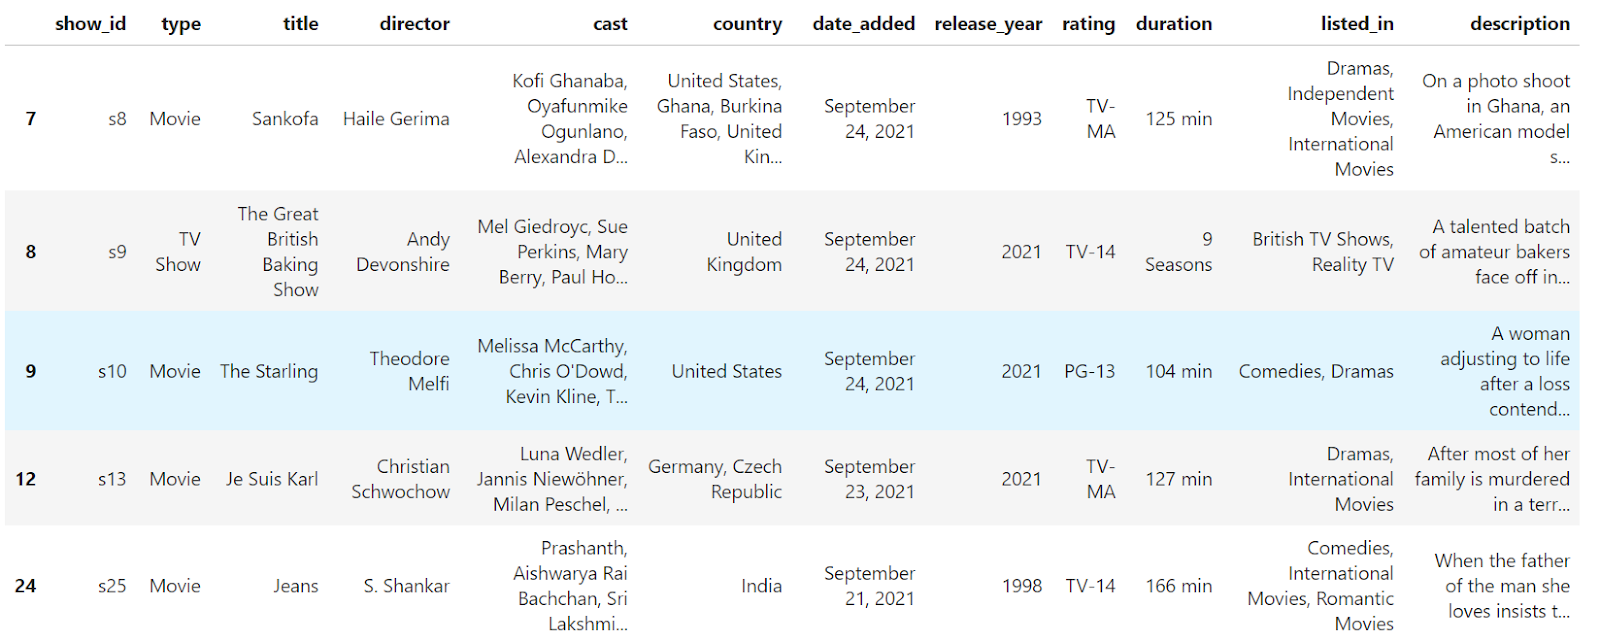
De rijen met NaN-waarden zijn uit het DataFrame verwijderd. De index is echter niet meer doorlopend (0, 1, 2, 4). Laten we die resetten:
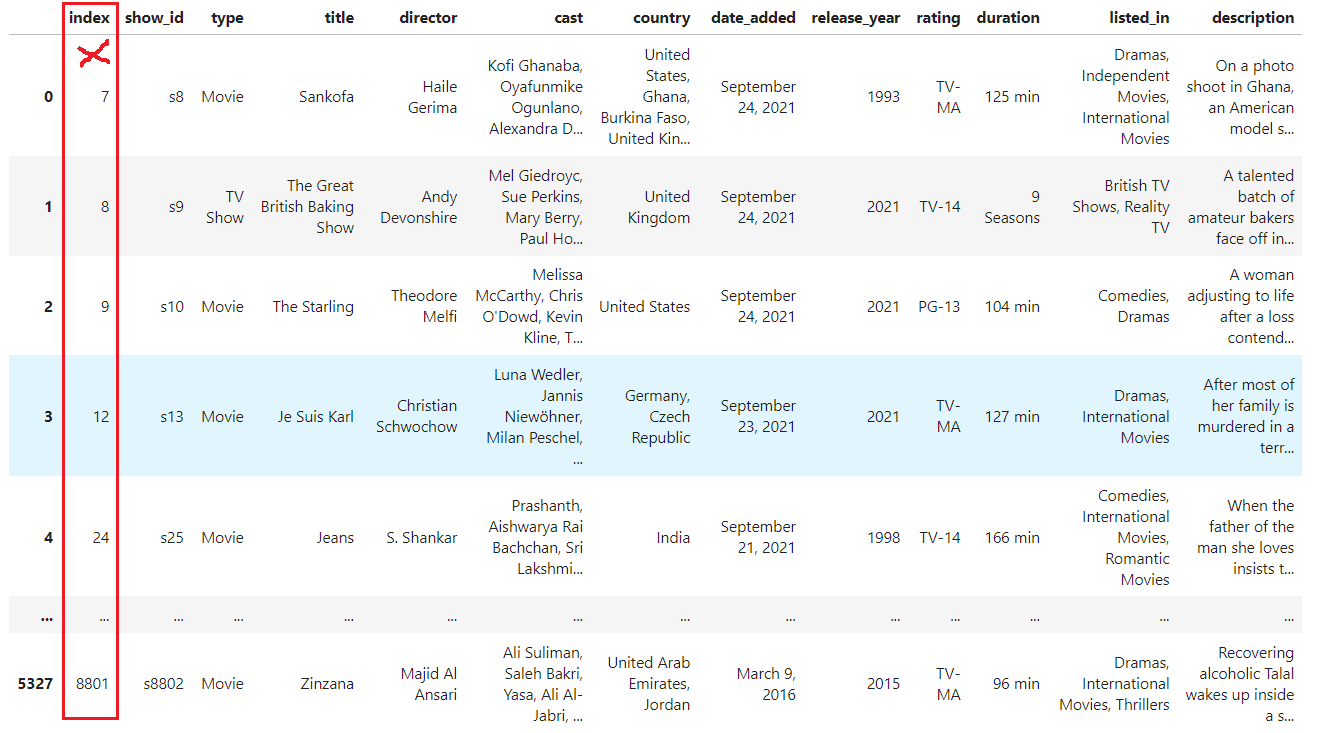
df.reset_index()
Nu is de index doorlopend; omdat we de parameter drop echter niet expliciet hebben meegegeven, is de oude index omgezet in een kolom met de standaardnaam index. Laten we de oude index volledig uit het DataFrame verwijderen:
df.reset_index(drop=True)
We hebben de betekenisloze oude index volledig verwijderd en de huidige index is nu doorlopend. De laatste stap is om deze wijzigingen in ons oorspronkelijke DataFrame op te slaan met de parameter inplace:
df.reset_index(drop=True, inplace=True)Je hebt geleerd hoe de functie reset_index in Pandas efficiënt omgaat met DataFrame-indexen. Of je nu werkt met gefilterde data, geconcateneerde DataFrames of complexe meerlagige indexen, reset_index zorgt voor een schoon en georganiseerd DataFrame. De parameters helpen bij het beheren van uiteenlopende indexscenario’s in datamanipulatietaken.
Blijf leren om vergelijkbare functies als reset_index te gebruiken met DataCamp’s Data Analyst with Python career track. Je kunt ook onze Python List Index() Tutorial lezen als je met lijsten werkt en meer wilt leren over de functie index() zoals die voor lijsten geldt.
Top pandas Courses
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

