Kursus
Manipulasi Data dengan pandas
4 jam
567.9K
Setelah memanipulasi dan memfilter dataset berukuran besar, Anda mungkin mendapatkan DataFrame yang tepat seperti yang dibutuhkan. Namun, DataFrame ini mempertahankan indeks asli yang bisa jadi tidak berurutan. Dalam kasus seperti ini, Anda perlu mengatur ulang indeks DataFrame.
Dalam tutorial ini, kita akan membahas metode pandas reset_index() yang digunakan untuk mengatur ulang indeks sebuah DataFrame. Kita akan mengeksplorasi berbagai opsi yang tersedia pada metode ini. Selain itu, kita juga akan membahas cara mengatur ulang indeks untuk DataFrame sederhana dan multi-level.
Untuk berlatih mengatur ulang indeks DataFrame, kita akan menggunakan dataset maskapai. Kita akan menggunakan Datalab dari Datacamp, lingkungan interaktif yang dirancang khusus untuk analisis data dengan Python, sehingga sangat cocok untuk diikuti dalam tutorial ini.
Metode reset_index di Pandas mengatur ulang indeks DataFrame ke indeks bawaan. Setelah operasi seperti pemfilteran, penggabungan (concatenation), atau merging, indeks mungkin tidak lagi berurutan. Metode ini membantu menata kembali indeks agar bersih dan berurutan. Jika DataFrame memiliki MultiIndex, metode ini dapat menghapus satu atau lebih level.
Sintaks dasar:
df.reset_index(level=None, drop=False, inplace=False, col_level=0, col_fill="")Parameter:
Mengembalikan:
DataFrame dengan indeks baru atau None jika inplace=True.
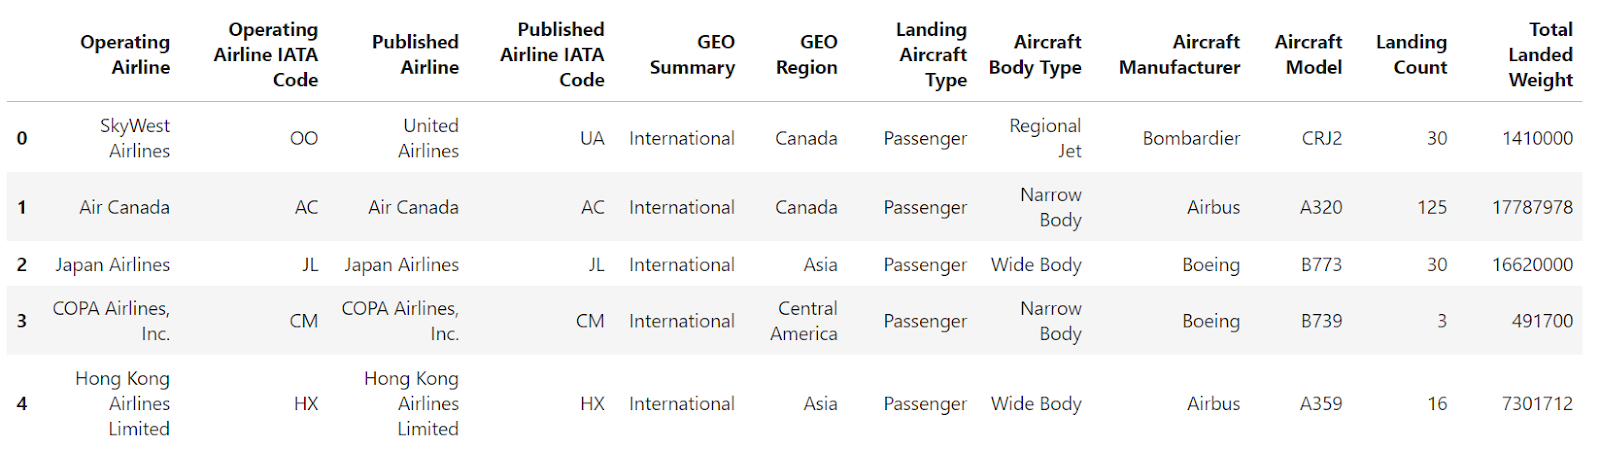
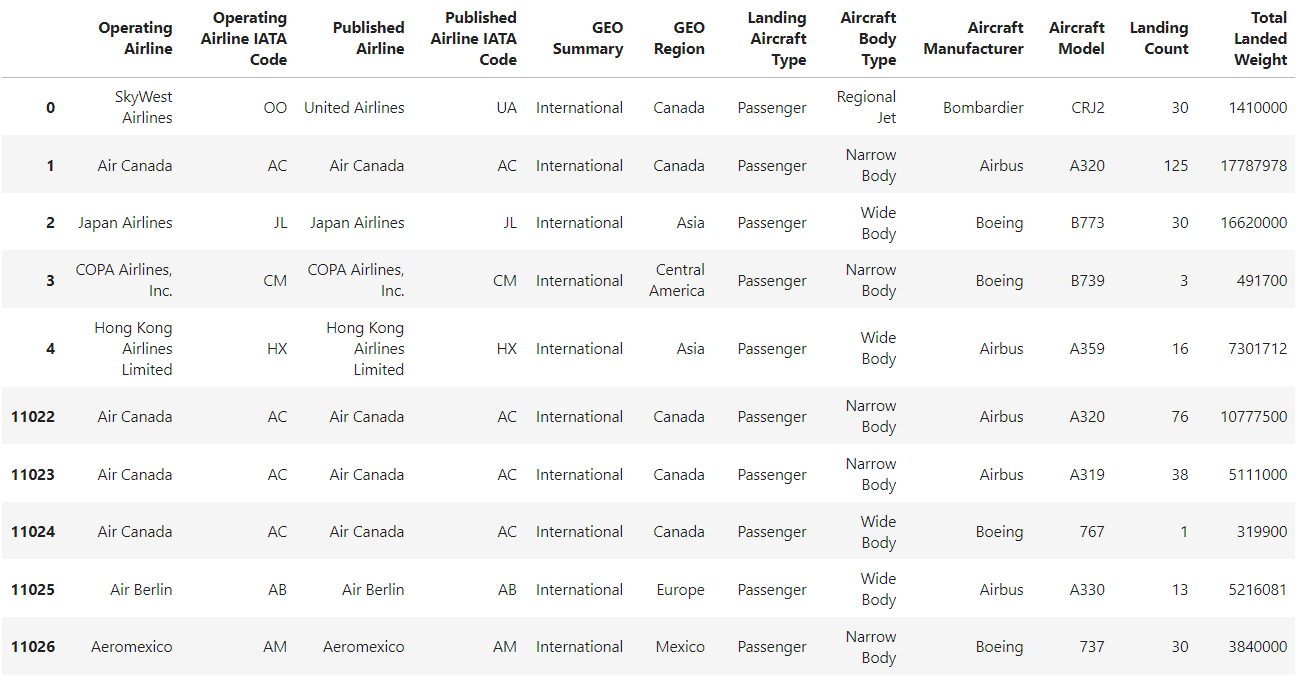
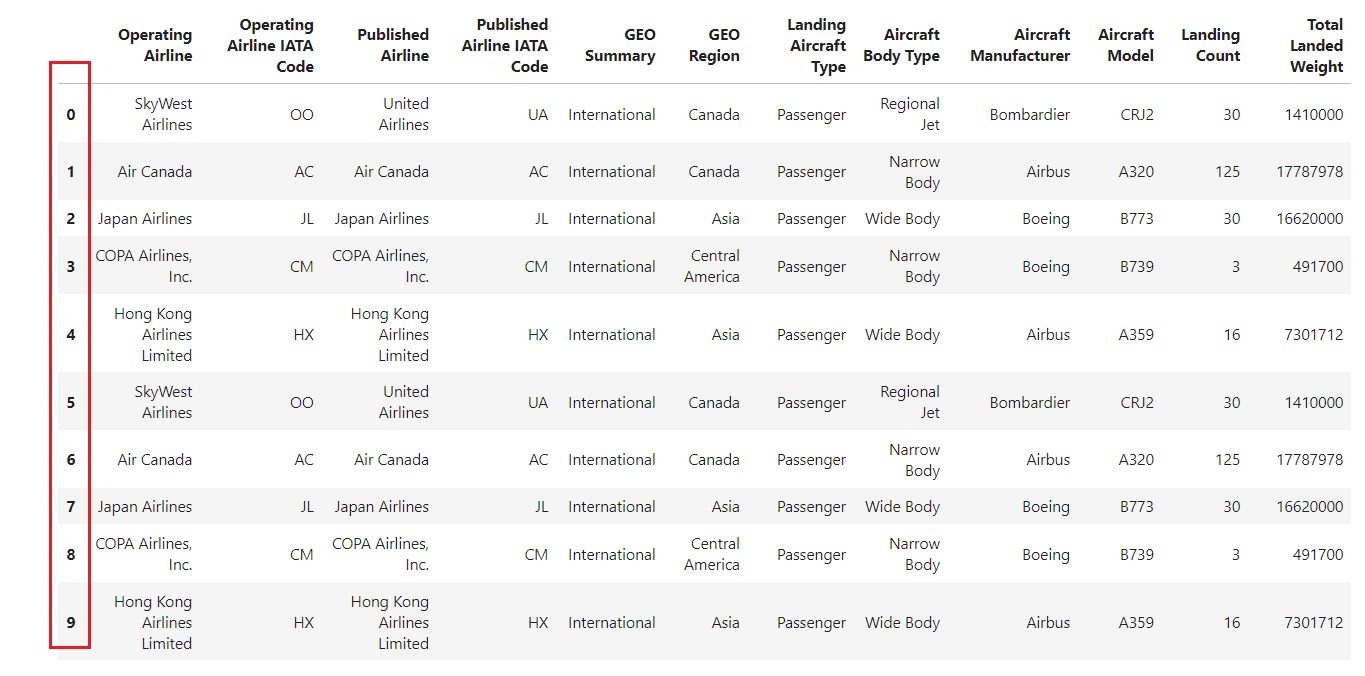
Jika Anda membaca file CSV menggunakan metode pandas read_csv() tanpa menentukan indeks, DataFrame yang dihasilkan akan memiliki indeks berbasis integer bawaan yang dimulai dari 0 dan bertambah 1 untuk setiap baris berikutnya.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df
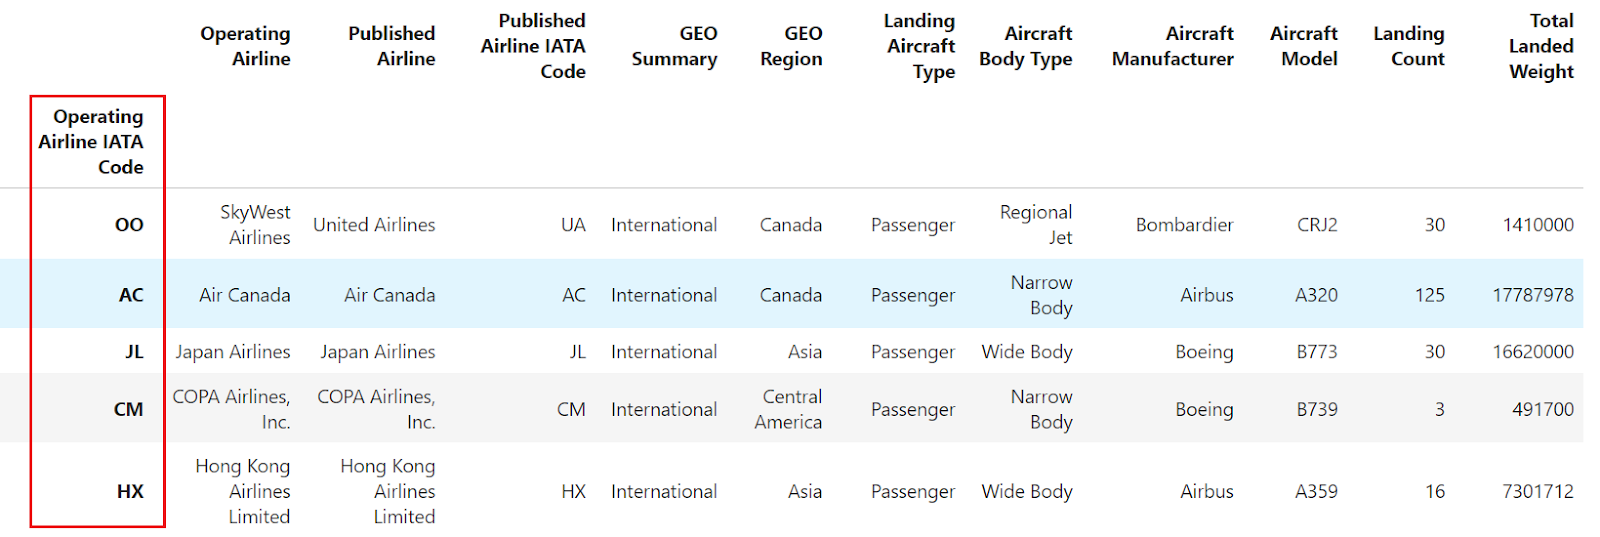
Dalam beberapa kasus, Anda mungkin lebih memilih label baris yang lebih deskriptif. Untuk mencapainya, Anda dapat menetapkan salah satu kolom DataFrame sebagai indeksnya (label baris). Saat menggunakan metode read_csv() untuk memuat data dari file CSV, tentukan kolom yang diinginkan untuk indeks menggunakan parameter index_col.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv", index_col="Operating Airline IATA Code").head()
df
Sebagai alternatif, Anda dapat menggunakan metode set_index() untuk menjadikan kolom mana pun dari DataFrame sebagai indeks:
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df.set_index("Operating Airline IATA Code", inplace=True)
df
Perhatikan bahwa cuplikan kode tersebut akan mengubah DataFrame asli.
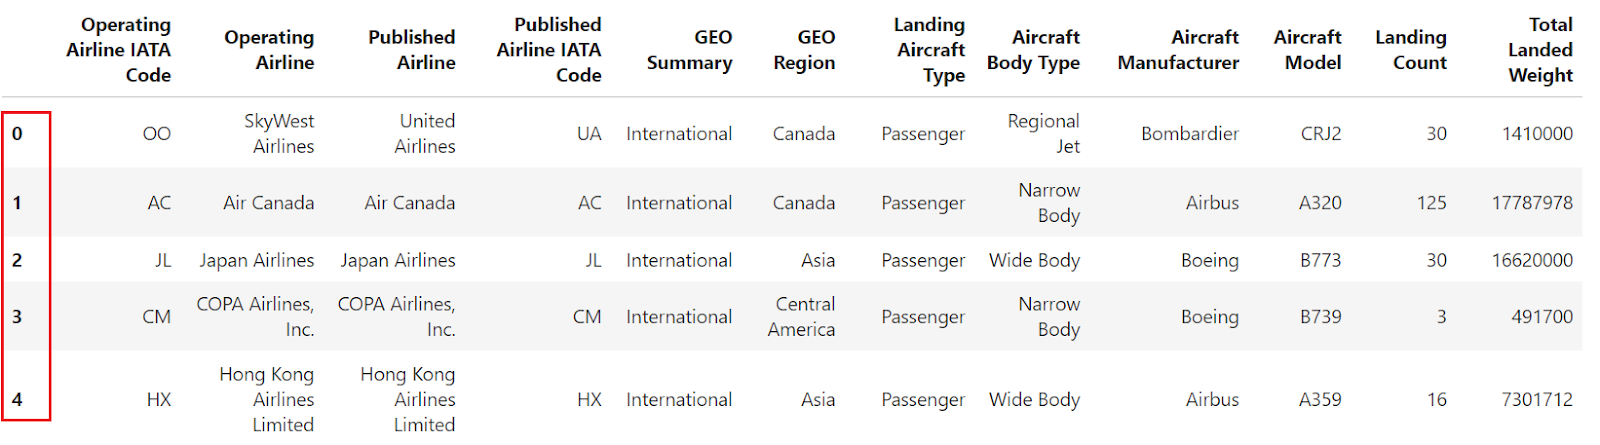
Bagaimana jika Anda perlu mengembalikan indeks numerik default? Di sinilah metode pandas reset_index() berguna.
df.reset_index()
Contoh tersebut menunjukkan bahwa, setelah menjadikan kolom 'Operating Airline IATA Code' sebagai indeks, reset_index digunakan untuk mengembalikan DataFrame ke indeks integer default.
Metode reset_index() di Pandas adalah alat yang kuat untuk menata ulang indeks DataFrame saat Anda berurusan dengan dataset yang telah difilter, DataFrame yang digabungkan, atau indeks multi-level.
Pelajari lebih lanjut tentang mengubah bentuk DataFrame dari format lebar ke panjang, cara stack dan unstack baris dan kolom, serta cara mengelola DataFrame multi-indeks di kursus online kami.
Saat Anda memfilter sebuah DataFrame, indeks asli dipertahankan. Dengan menggunakan reset_index, Anda dapat mengindeks ulang DataFrame yang telah difilter.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
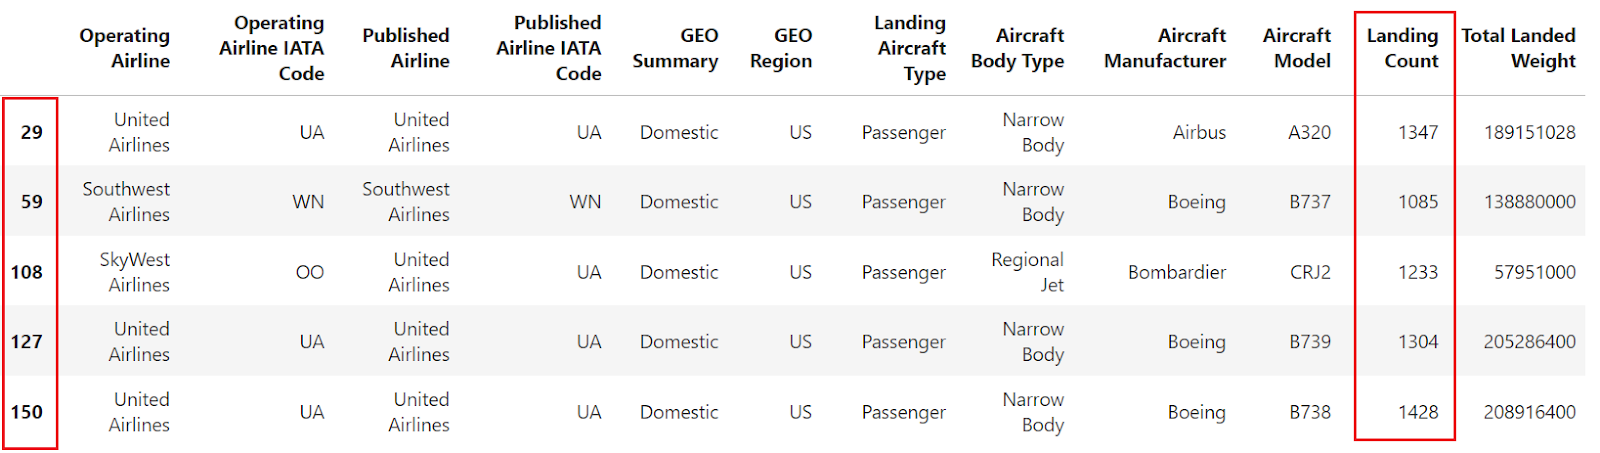
Mari kita filter data untuk memilih hanya baris di mana "landing count" lebih besar dari 1000. Setelah pemfilteran, indeks mungkin tidak berurutan. Kemudian, Anda dapat menggunakan metode reset_index untuk mengatur ulang indeks DataFrame yang telah difilter.
filtered_df = df[df["Landing Count"] > 1000].head()
filtered_df
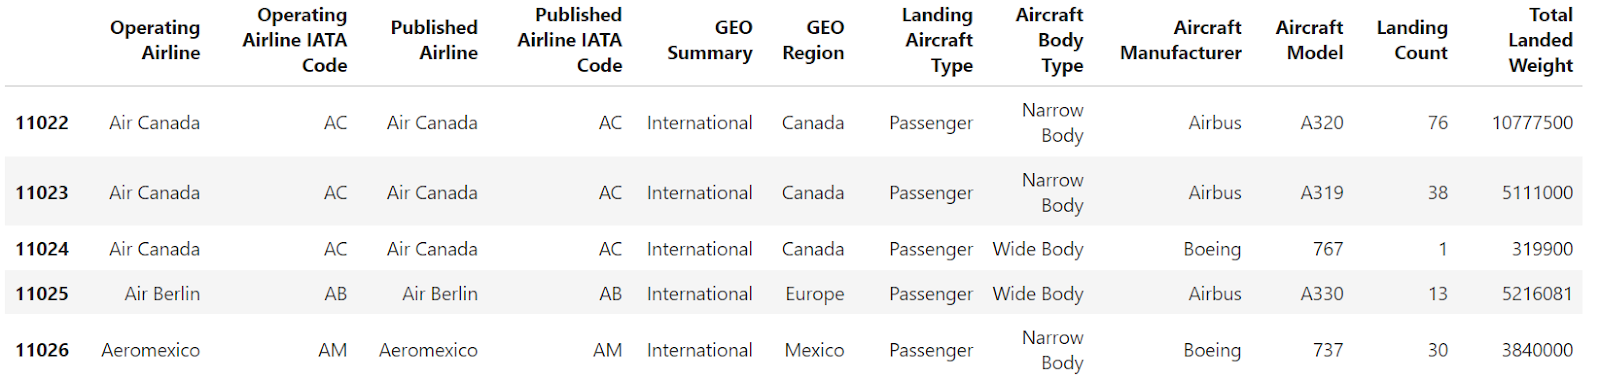
Gambar di atas menunjukkan bahwa data frame difilter berdasarkan kondisi yang diterapkan, namun indeksnya tidak berurutan. Sekarang, mari gunakan reset_index untuk mengindeks ulang DataFrame yang telah difilter dan memastikan indeks berurutan. Berikut caranya:
filtered_df_reset = filtered_df.reset_index()
filtered_df_reset
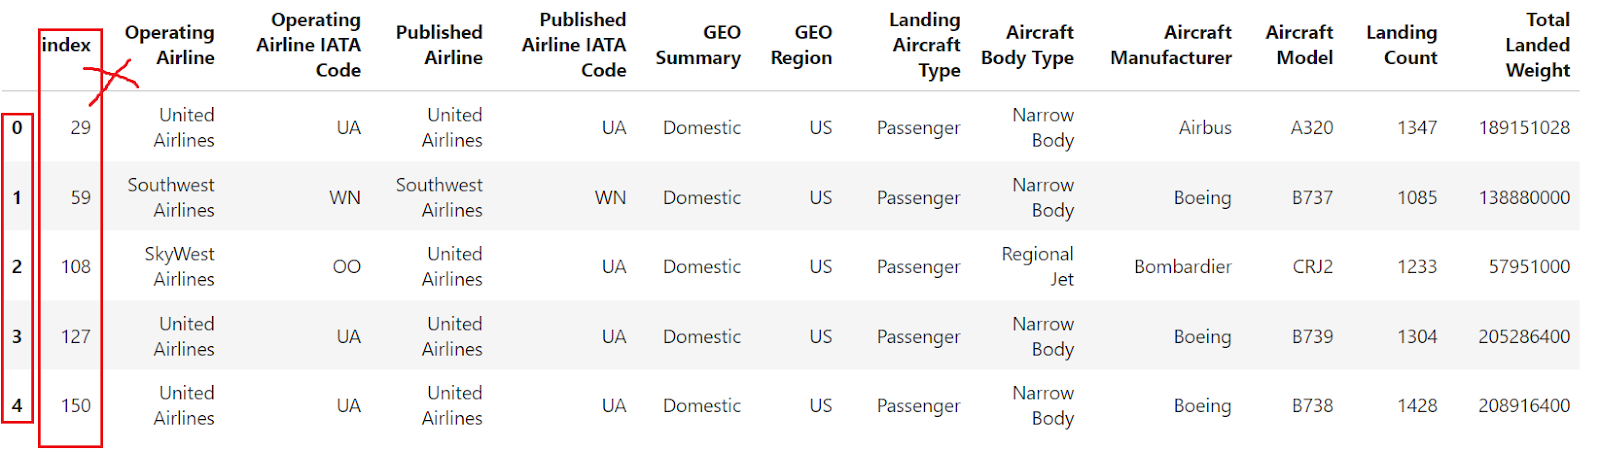
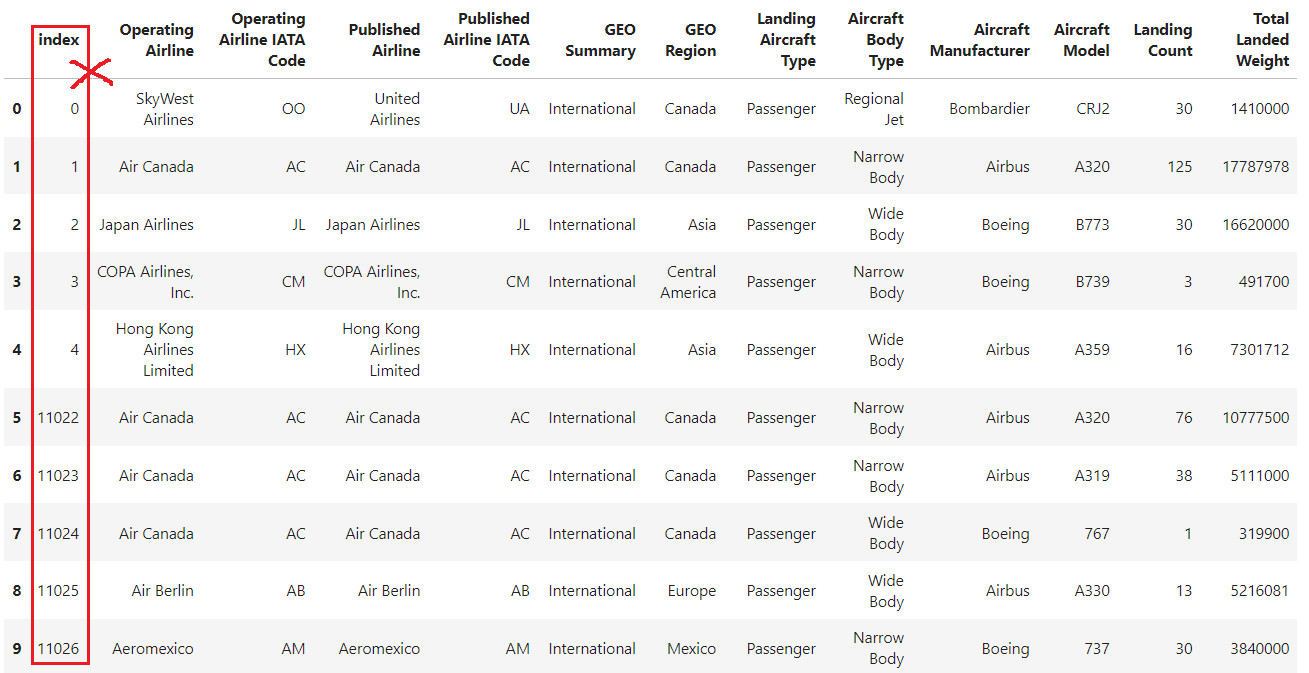
Perilaku default metode ini mencakup mengganti indeks DataFrame yang ada dengan indeks berbasis integer bawaan dan mengonversi indeks lama menjadi kolom baru dengan nama yang sama (atau "index" jika tidak bernama).
Jadi, gunakan parameter drop=True agar indeks lama tidak ditambahkan sebagai kolom baru.
filtered_df_reset = filtered_df.reset_index(drop=True)
filtered_df_reset
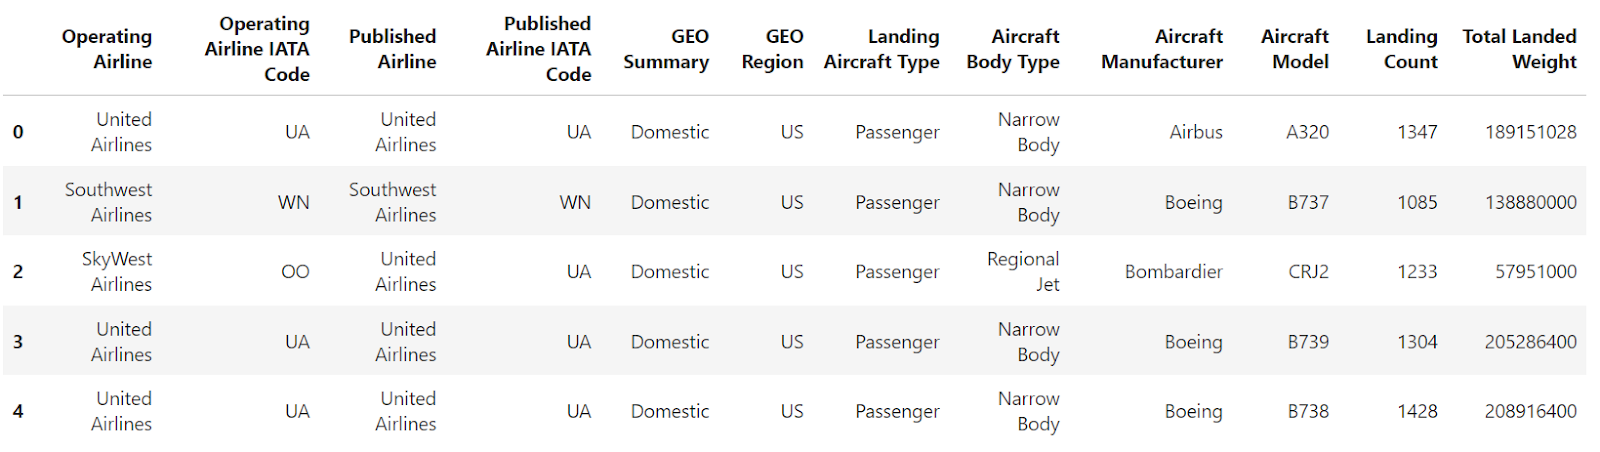
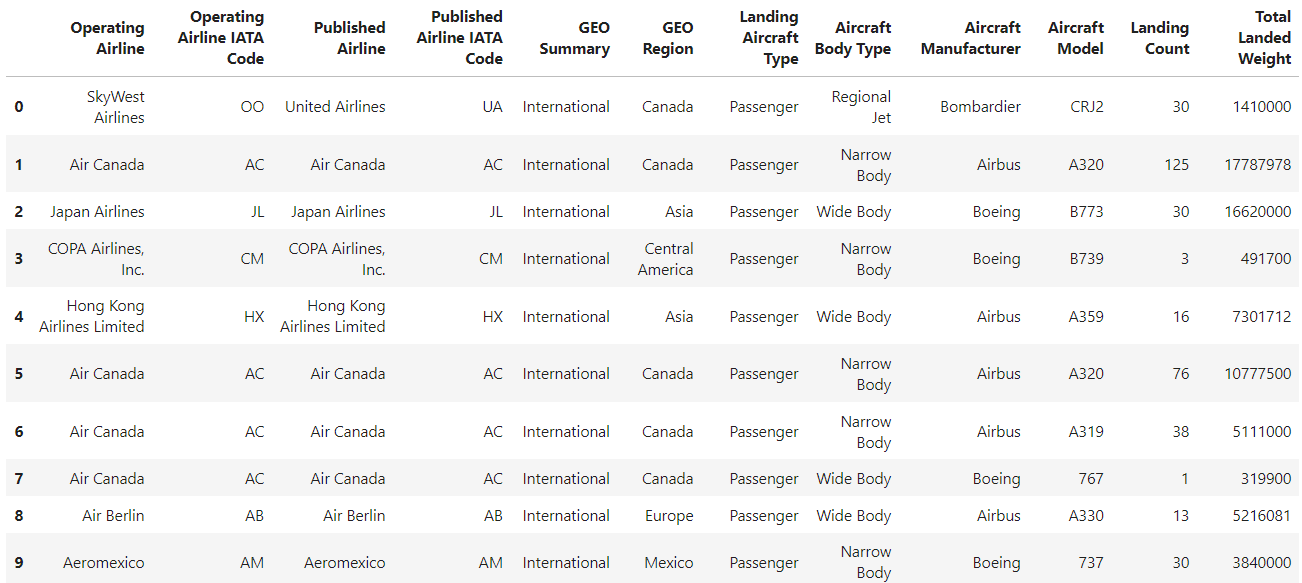
Bagus! Indeks sekarang diatur ulang ke indeks integer default (0, 1, 2, …), sehingga bersih dan berurutan.
Saat menggabungkan DataFrame, DataFrame hasilnya mungkin berisi indeks duplikat atau tidak berurutan. Mengatur ulang indeks akan menghasilkan indeks yang bersih dan berurutan.
Misalkan Anda memiliki dua DataFrame dan ingin mengonkatenasikannya. Saya membuat dua DataFrame dari dataset maskapai untuk tujuan demonstrasi.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
split_index = int(df.shape[0] / 2)
df1 = df[:split_index].head()
df2 = df[split_index:].head()
Berikut df1:
Berikut df2:
Mari kita konkatenasi DataFrame df1 dan df2.
df_concat = pd.concat([df1, df2])
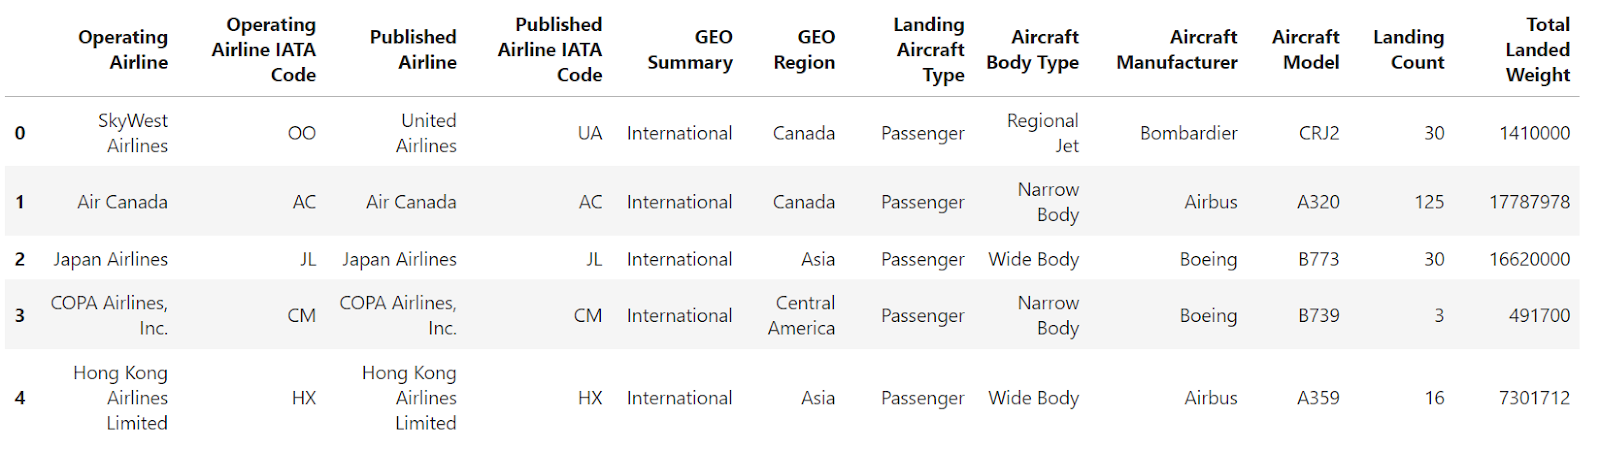
Data menunjukkan indeks yang tidak berurutan. Kita perlu mengatur ulang indeks DataFrame hasil konkatenasi agar menjadi berurutan.
Mari kita atur ulang indeks DataFrame menggunakan metode reset_index() di pandas.
df_concat.reset_index()
Berikut hasilnya setelah mengatur ulang indeks DataFrame. Metode reset_index mengonversi indeks lama menjadi kolom baru. Untuk menghapus kolom tambahan ini, Anda perlu menggunakan parameter drop=True.
df_concat.reset_index(drop=True)
Untuk DataFrame dengan pengindeksan hierarkis (multi-level), reset_index dapat digunakan untuk menyederhanakan DataFrame dengan mengonversi indeks multi-level kembali menjadi kolom.
Mari lihat contoh DataFrame dengan indeks multi-level.
import pandas as pd
df = pd.read_csv(
    "airlines_dataset.csv", index_col=["Aircraft Model", "Operating Airline IATA Code"]
).head()
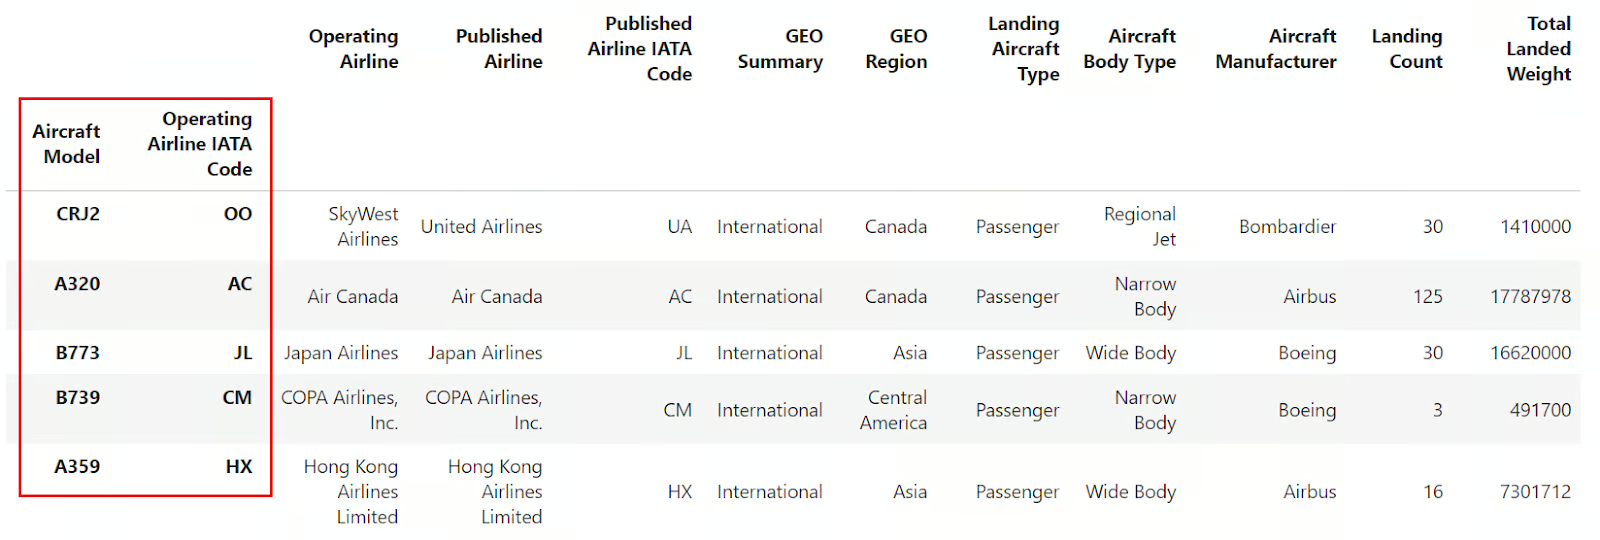
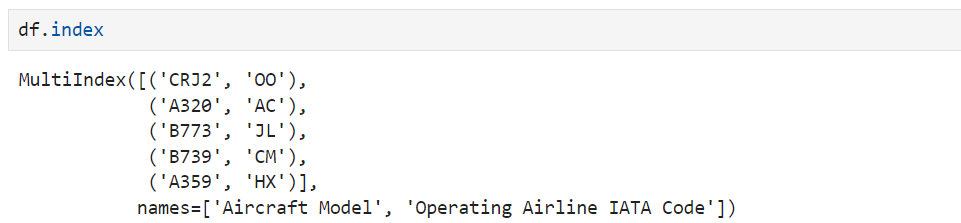
Jika Anda memeriksa indeksnya, akan terlihat bahwa ini bukan indeks DataFrame umum melainkan objek MultiIndex
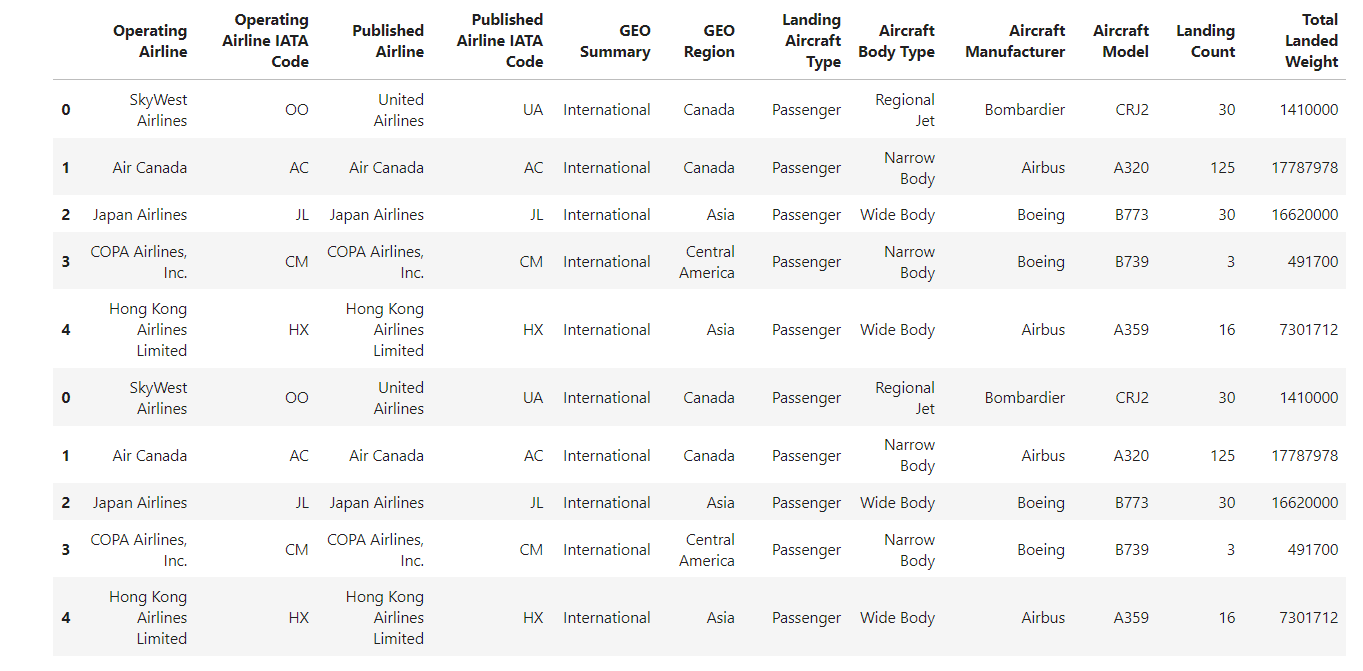
Sekarang, mari gunakan metode pandas reset_index() yang menghapus semua level dari MultiIndex:
df.reset_index()
Anda dapat melihat bahwa kedua level MultiIndex dikonversi menjadi kolom umum DataFrame sementara indeks diatur ulang ke indeks berbasis integer bawaan.
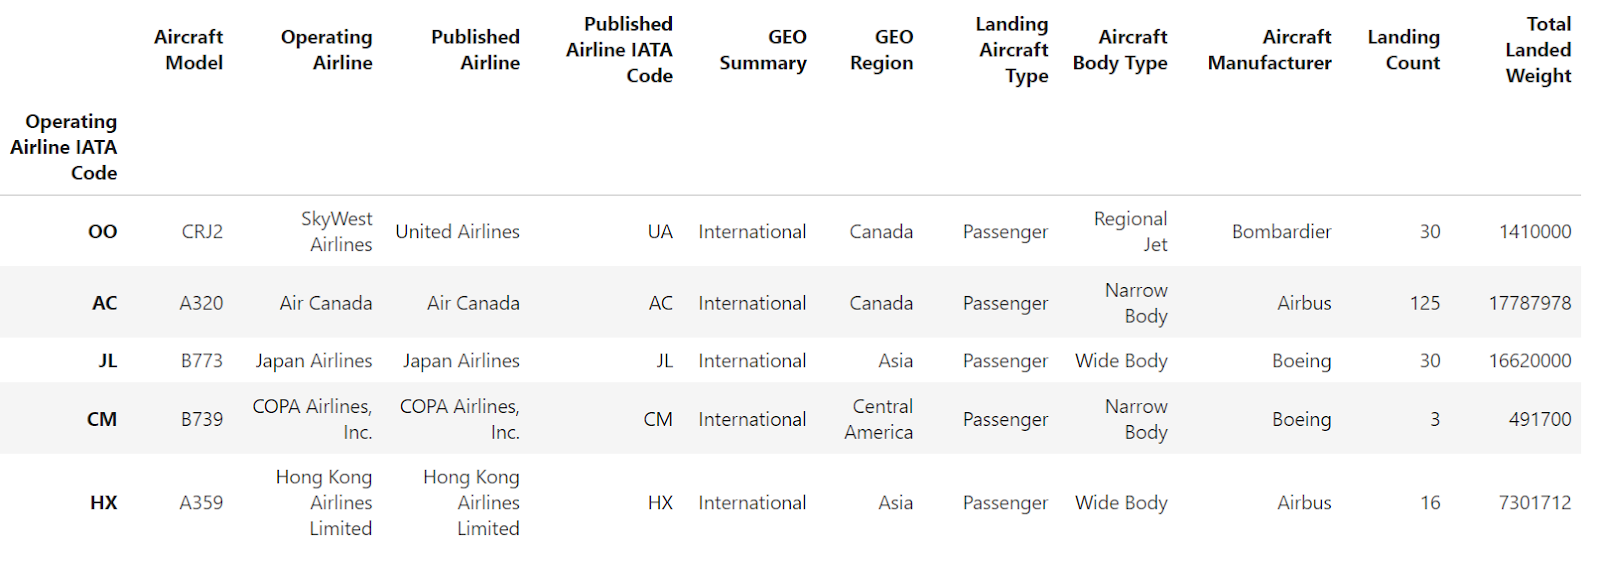
Anda juga dapat menggunakan parameter level untuk menghapus level tertentu dari indeks DataFrame. Ini akan mengonversi level yang dipilih menjadi kolom umum DataFrame kecuali Anda memilih untuk menghapus informasi ini sepenuhnya dari DataFrame menggunakan parameter drop. Mari kita lihat:
df.reset_index(level=["Aircraft Model"])
Gambar di atas menunjukkan bahwa "Aircraft Model" sekarang menjadi kolom biasa di DataFrame. Hanya "Operating Airline IATA Code" yang tetap sebagai indeks.
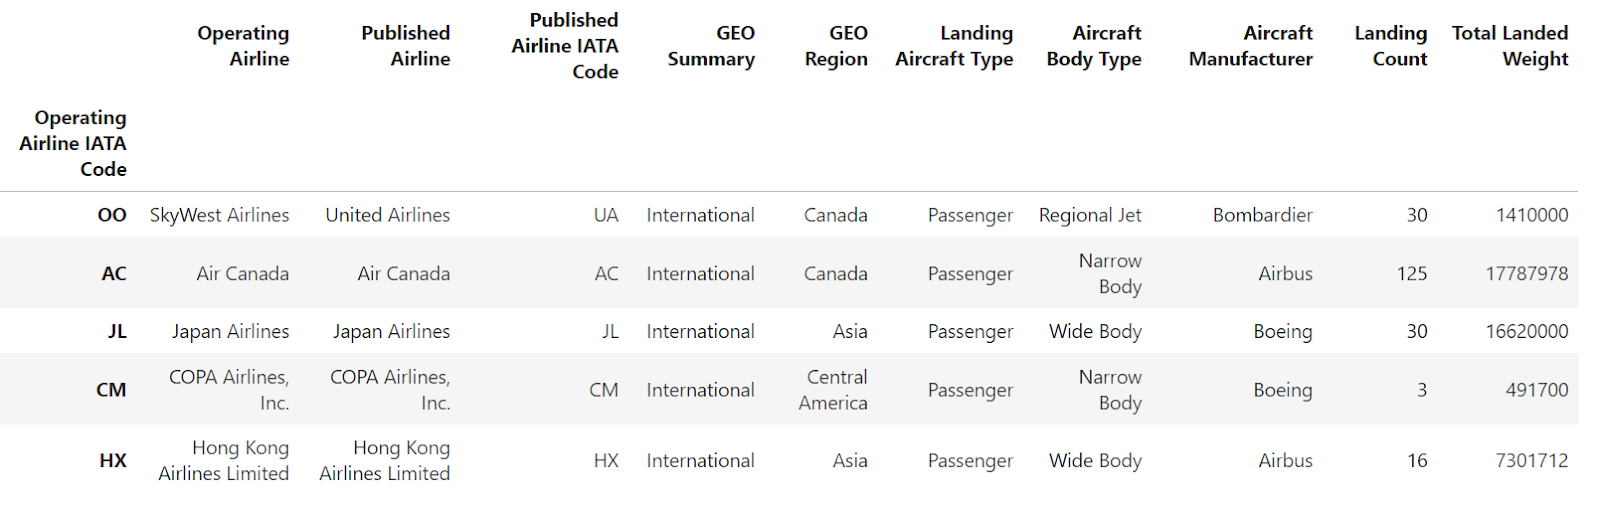
Sekarang, jika Anda tidak ingin indeks yang disebutkan dalam daftar menjadi kolom biasa, Anda dapat mengombinasikan parameter drop dan level untuk menghapusnya dari DataFrame.
df.reset_index(level=["Aircraft Model"], drop=True)
Indeks 'Aircraft Model' telah dihapus dari indeks dan dari DataFrame. Indeks lainnya, 'Operating Airline IATA Code', dipertahankan sebagai indeks saat ini dari DataFrame.
Misalkan Anda menggabungkan dua DataFrame; DataFrame hasil penggabungan tidak lagi memiliki indeks berurutan, seperti ditunjukkan pada DataFrame di bawah.
Mari kita atur ulang indeks DataFrame menggunakan metode reset_index() dari pandas.
df.reset_index()
Parameter drop menentukan apakah akan menyimpan indeks lama sebagai kolom di DataFrame setelah mengatur ulang indeks atau menghapusnya sepenuhnya. Secara default (drop=False), indeks lama disimpan, sebagaimana ditunjukkan pada semua contoh sebelumnya. Sebaliknya, menetapkan drop=True akan menghapus indeks lama dari DataFrame setelah pengaturan ulang.
df.reset_index(drop=True)
Modifikasi DataFrame secara langsung menggunakan parameter inplace untuk menghindari pembuatan DataFrame baru.
Misalkan Anda memiliki DataFrame berikut:
Mengatur parameter inplace menjadi True memastikan perubahan diterapkan langsung pada DataFrame asli, sehingga tidak membuat DataFrame terpisah.
df_concat.reset_index(drop=True, inplace=True)
df_concat
Kelola indeks duplikat dengan mengatur ulang dan mengindeks ulang secara tepat.
Misalkan Anda memiliki data dengan indeks duplikat.
Dengan menggunakan reset_index() dengan drop=True dan inplace=True memastikan bahwa DataFrame yang dihasilkan akan memiliki indeks berkelanjutan, dimulai dari 0 dan meningkat secara berurutan.
df.reset_index(drop=True, inplace=True)
inplace=False jika Anda mengharapkan DataFrame asli dimodifikasi. Jika inplace diatur ke False, DataFrame baru dikembalikan dan DataFrame asli tidak berubah.drop untuk menghindari kehilangan data yang tidak disengaja. Menghapus indeks akan menghilangkan nilai indeks saat ini secara permanen.Mari kita terapkan apa yang telah kita pelajari tentang mengatur ulang indeks DataFrame dan melihat bagaimana mengatur ulang indeks bermanfaat saat menghapus nilai hilang.
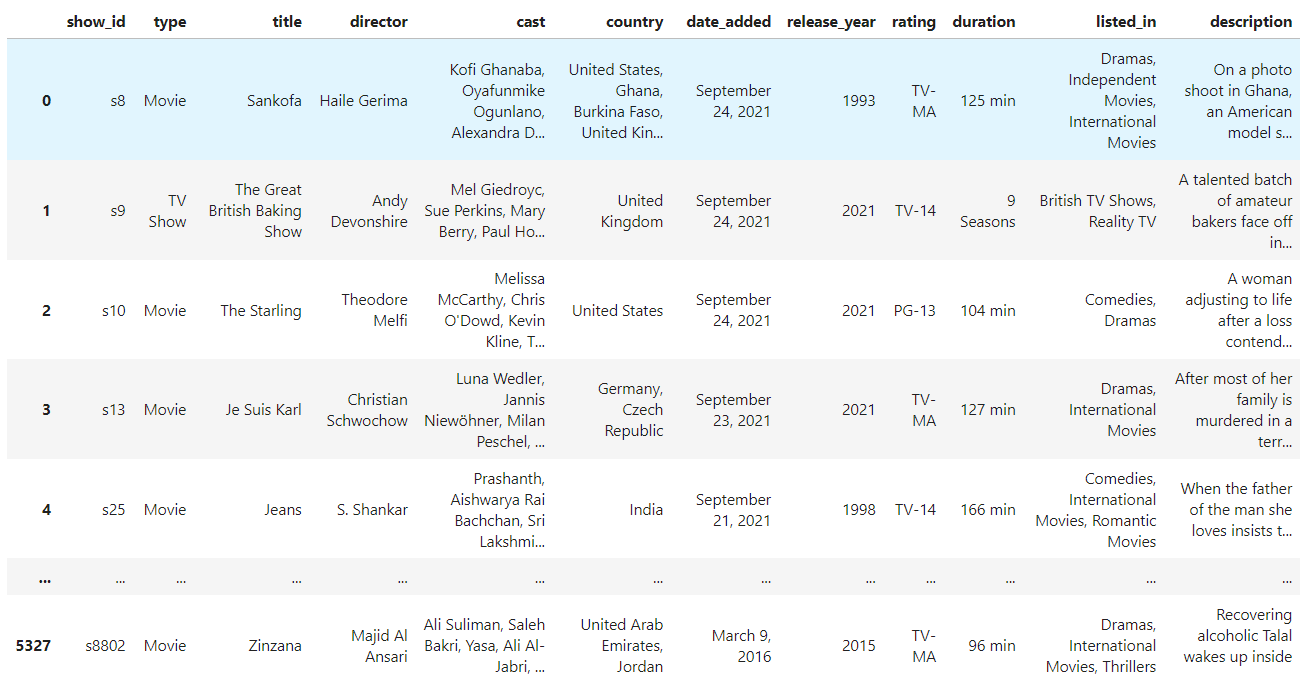
Dataset maskapai kita tidak memiliki nilai yang hilang, jadi mari gunakan dataset Film dan Acara TV Netflix sebagai gantinya. Dataset ini memiliki nilai yang hilang, sangat cocok untuk mendemonstrasikan reset_index().
import pandas as pd
df = pd.read_csv("netflix_shows.csv")
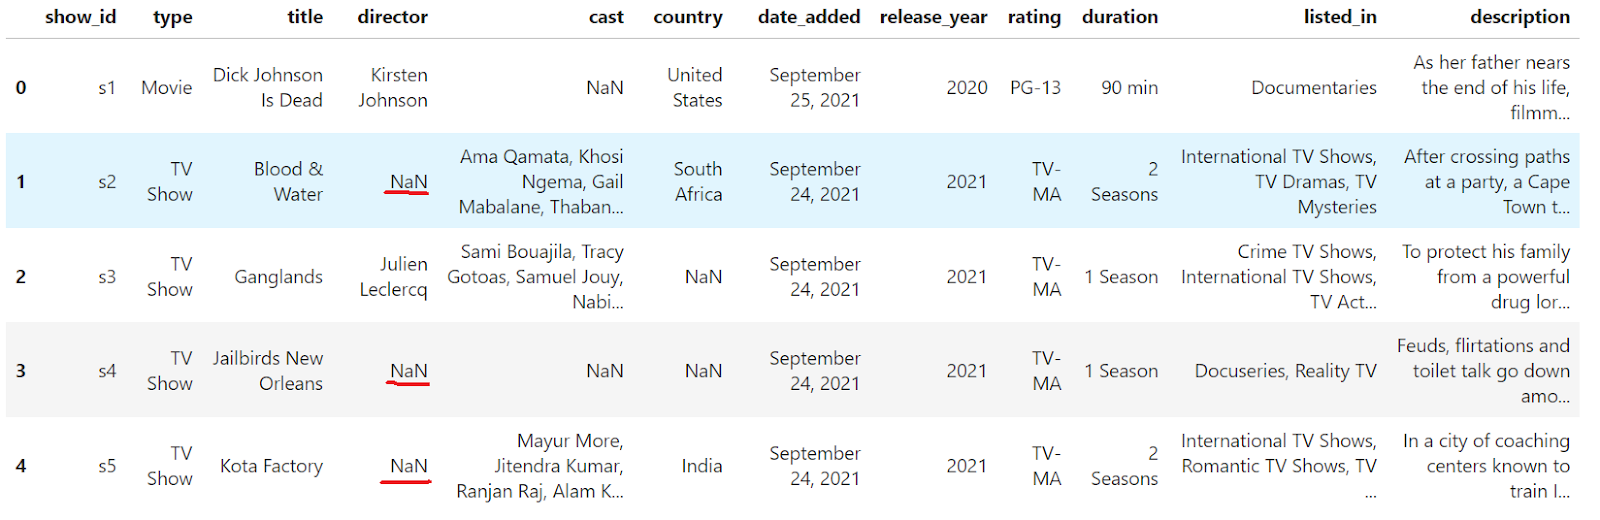
df.head()
Anda dapat melihat bahwa terdapat nilai yang hilang dalam DataFrame. Hapus baris yang mengandung nilai hilang menggunakan metode dropna().
df.dropna(inplace=True)
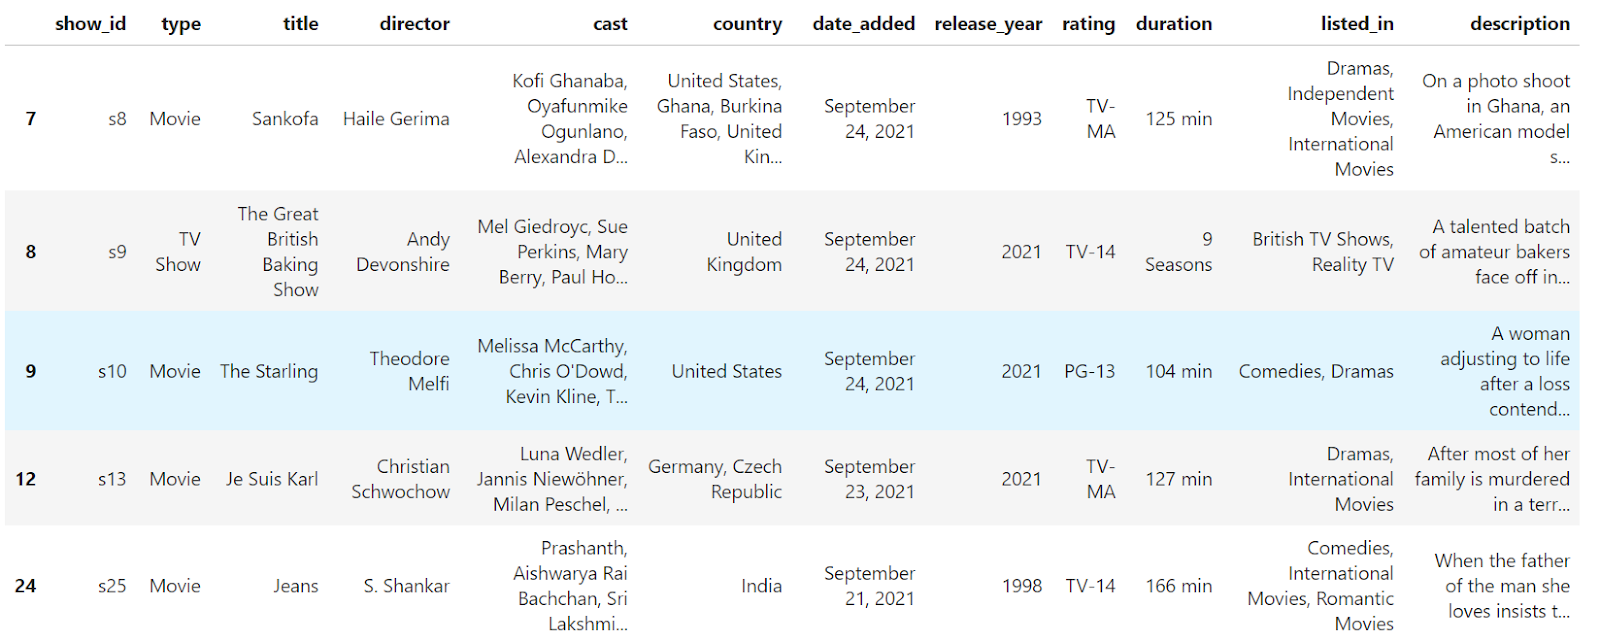
df.head()
Baris yang mengandung nilai NaN telah dihapus dari DataFrame. Namun, indeksnya tidak lagi berkelanjutan (0, 1, 2, 4). Mari kita atur ulang:
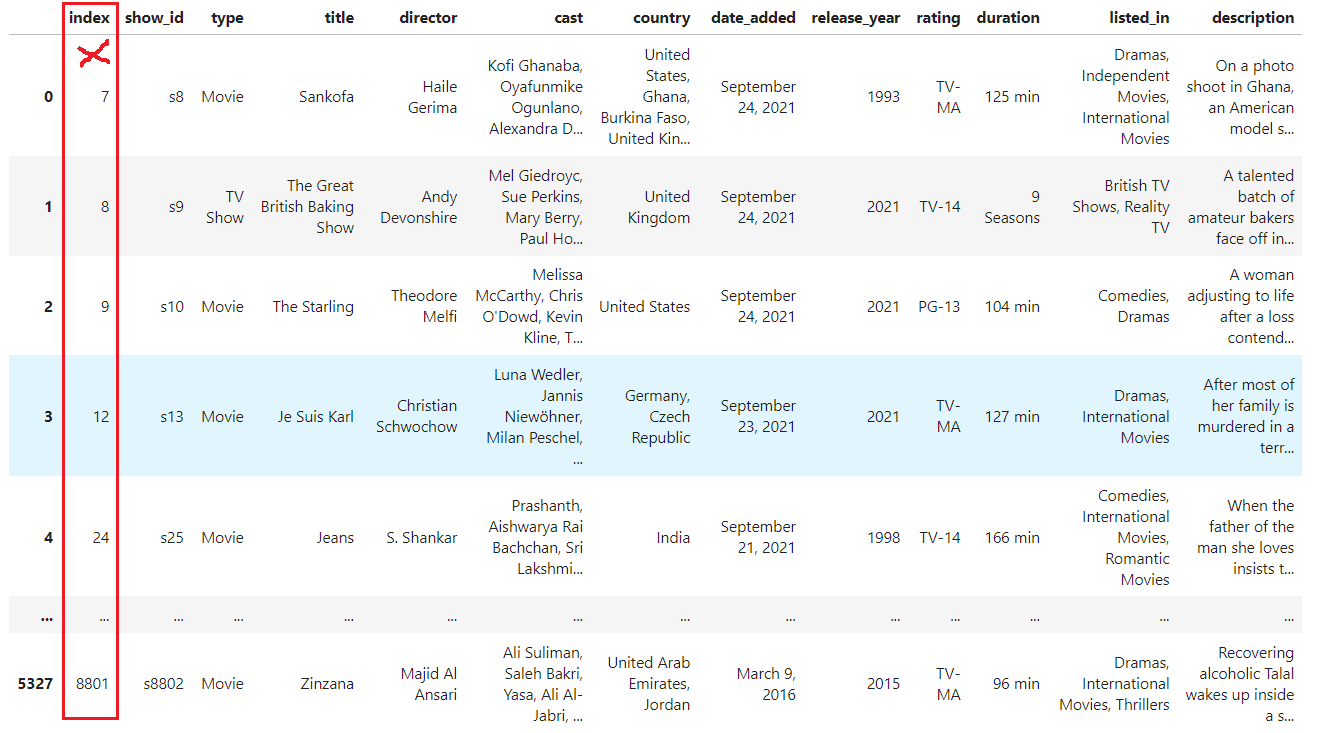
df.reset_index()
Kini indeks sudah berkelanjutan; namun, karena kita tidak secara eksplisit meneruskan parameter drop, indeks lama dikonversi menjadi kolom dengan nama default index. Mari kita hapus indeks lama sepenuhnya dari DataFrame:
df.reset_index(drop=True)
Kita telah sepenuhnya menghapus indeks lama yang tidak bermakna, dan indeks saat ini kini berkelanjutan. Langkah terakhir adalah menyimpan modifikasi ini ke DataFrame asli menggunakan parameter inplace:
df.reset_index(drop=True, inplace=True)Anda telah mempelajari bagaimana fungsi reset_index di Pandas mengelola indeks DataFrame secara efisien. Baik saat menangani data yang difilter, DataFrame yang dikonkatenasi, maupun pengindeksan multi-level yang kompleks, reset_index memastikan DataFrame tetap rapi dan terorganisasi. Parameternya membantu mengelola berbagai skenario pengindeksan dalam tugas manipulasi data.
Teruslah belajar menggunakan fungsi serupa dengan reset_index melalui jalur karier Data Analyst with Python dari DataCamp. Anda juga dapat membaca Tutorial Python List Index() kami jika Anda bekerja dengan list dan ingin mempelajari fungsi index() pada list.
Kursus pandas Teratas
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



