Cours
Manipulation de données avec pandas
4 h
564.1K
Après avoir manipulé et filtré un large jeu de données, vous obtenez peut-être exactement le DataFrame souhaité. Toutefois, ce DataFrame conserve l’index d’origine, qui peut être non séquentiel. Dans ce cas, il est utile de réinitialiser l’index du DataFrame.
Dans ce tutoriel, nous allons voir la méthode pandas reset_index(), utilisée pour rétablir l’index par défaut d’un DataFrame. Nous explorerons les différentes options disponibles avec cette méthode. Nous verrons aussi comment réinitialiser l’index pour des DataFrame simples ou à plusieurs niveaux.
Pour nous entraîner à réinitialiser l’index d’un DataFrame, nous utiliserons un jeu de données sur les compagnies aériennes. Nous utiliserons Datalab de Datacamp, un environnement interactif spécialement conçu pour l’analyse de données en Python, idéal pour suivre ce tutoriel pas à pas.
La méthode reset_index dans pandas réinitialise l’index d’un DataFrame à l’index par défaut. Après des opérations comme le filtrage, la concaténation ou la jointure, l’index peut ne plus être séquentiel. Cette méthode permet de rétablir un index propre et continu. Si le DataFrame possède un MultiIndex, elle peut supprimer un ou plusieurs niveaux.
Syntaxe de base :
df.reset_index(level=None, drop=False, inplace=False, col_level=0, col_fill="")Paramètres :
Renvoie :
un DataFrame avec le nouvel index, ou None si inplace=True.
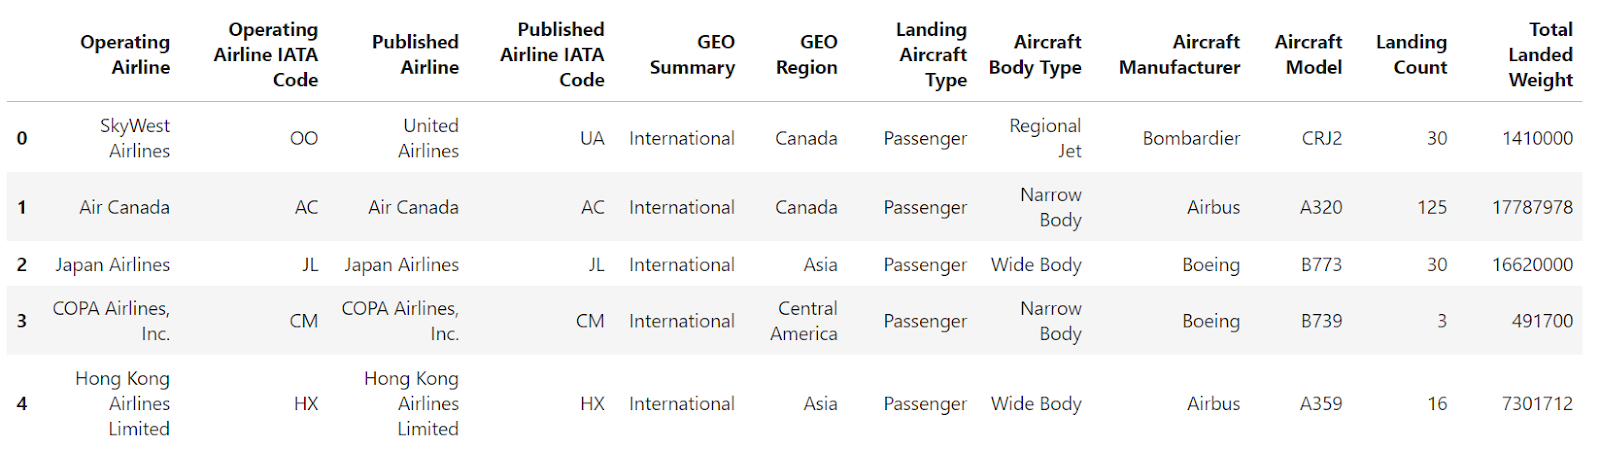
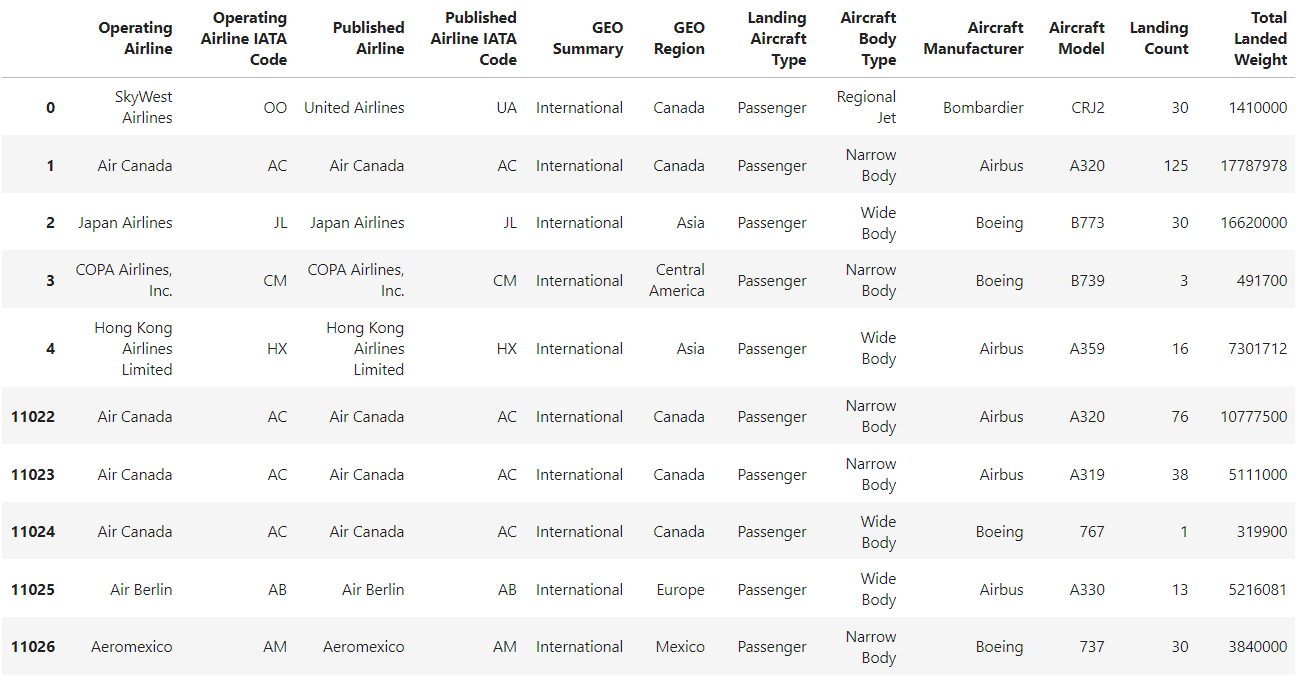
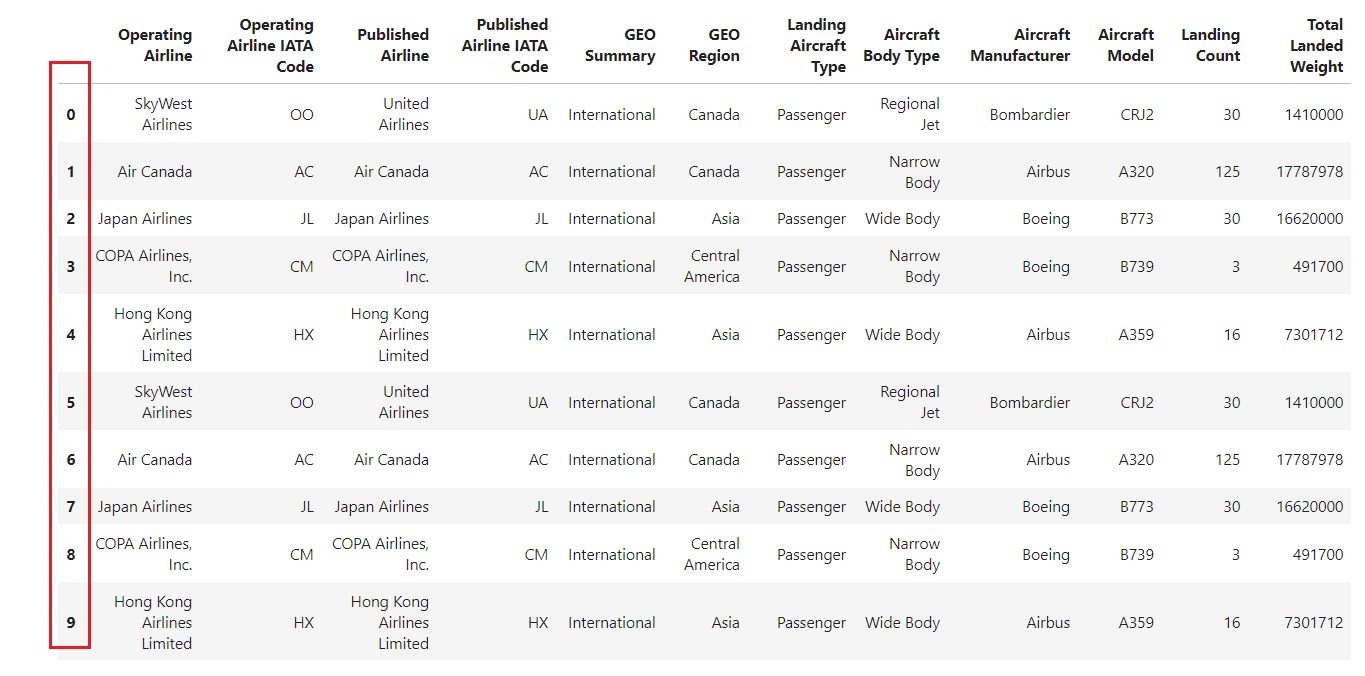
Si vous lisez un fichier CSV avec la méthode pandas read_csv() sans spécifier d’index, le DataFrame obtenu aura un index entier par défaut commençant à 0 et s’incrémentant de 1 à chaque ligne.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df
Dans certains cas, vous pouvez préférer des étiquettes de lignes plus parlantes. Pour cela, vous pouvez définir l’une des colonnes du DataFrame comme index (étiquettes de lignes). Lors de l’utilisation de read_csv() pour charger un CSV, indiquez la colonne souhaitée via le paramètre index_col.
import pandas as pd
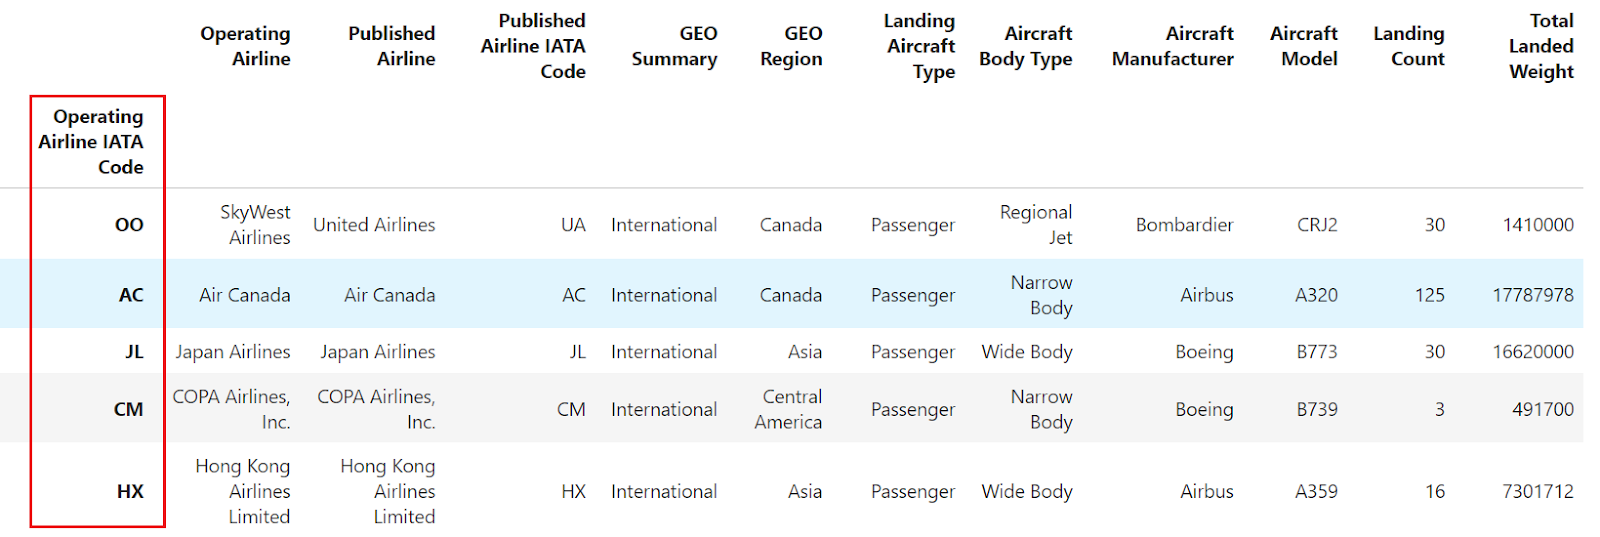
df = pd.read_csv("airlines_dataset.csv", index_col="Operating Airline IATA Code").head()
df
Autre possibilité : utiliser la méthode set_index() pour définir n’importe quelle colonne comme index du DataFrame :
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df.set_index("Operating Airline IATA Code", inplace=True)
df
Notez que cet extrait de code modifie le DataFrame original.
Et si vous devez restaurer l’index numérique par défaut ? C’est précisément le rôle de la méthode pandas reset_index().
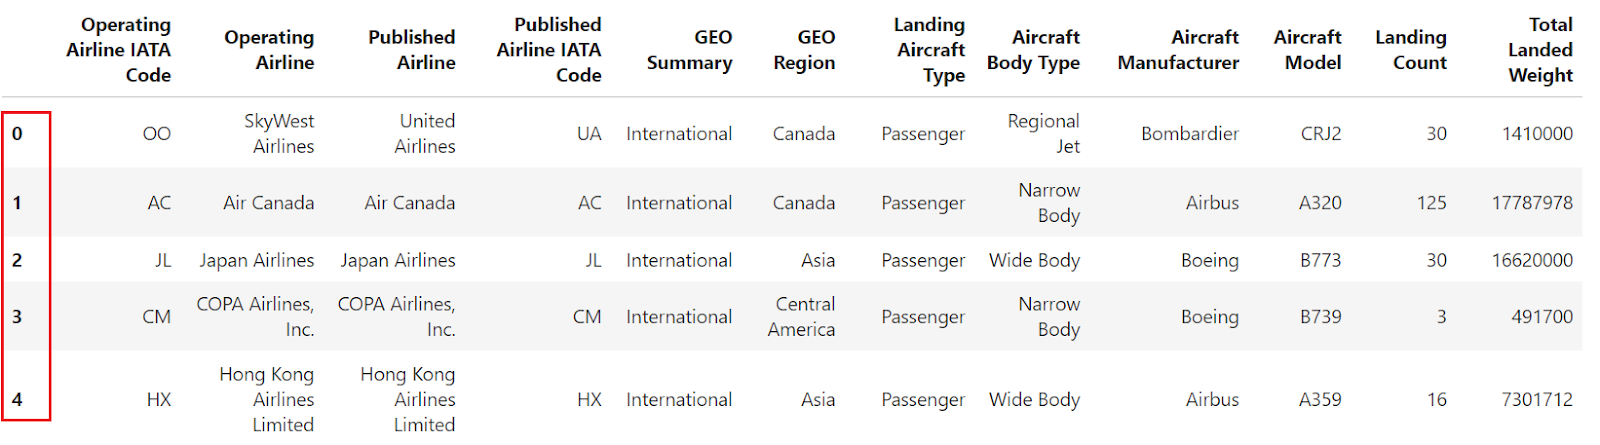
df.reset_index()
Cet exemple montre qu’après avoir utilisé la colonne "Operating Airline IATA Code" comme index, reset_index permet de revenir à l’index entier par défaut.
La méthode reset_index() est un outil puissant pour réorganiser les index des DataFrame lorsque vous travaillez avec des données filtrées, des DataFrame concaténés ou des index multi-niveaux.
Pour aller plus loin sur la restructuration des DataFrame du format large au format long, le stack/unstack des lignes et colonnes, et la gestion des DataFrame multi-index, consultez notre cours en ligne.
Lorsque vous filtrez un DataFrame, l’index d’origine est conservé. En utilisant reset_index, vous pouvez réindexer le DataFrame filtré.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
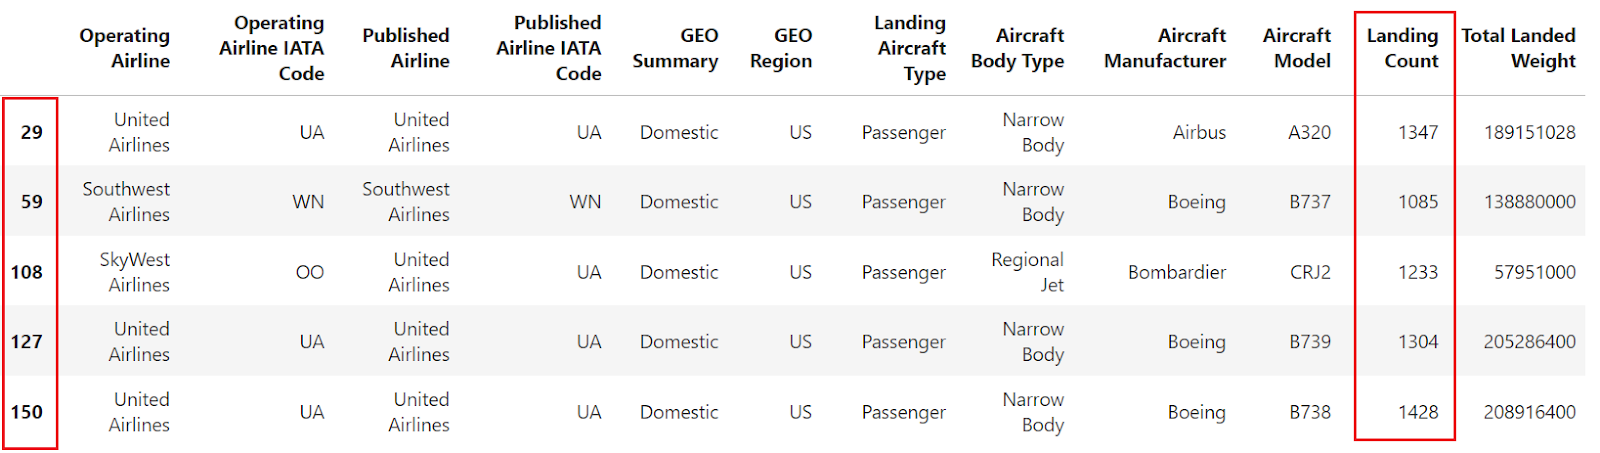
Filtrons les données pour ne garder que les lignes dont le "Landing Count" est supérieur à 1000. Après filtrage, les indices peuvent être non séquentiels. Vous pouvez ensuite utiliser la méthode reset_index pour réinitialiser l’index du DataFrame filtré.
filtered_df = df[df["Landing Count"] > 1000].head()
filtered_df
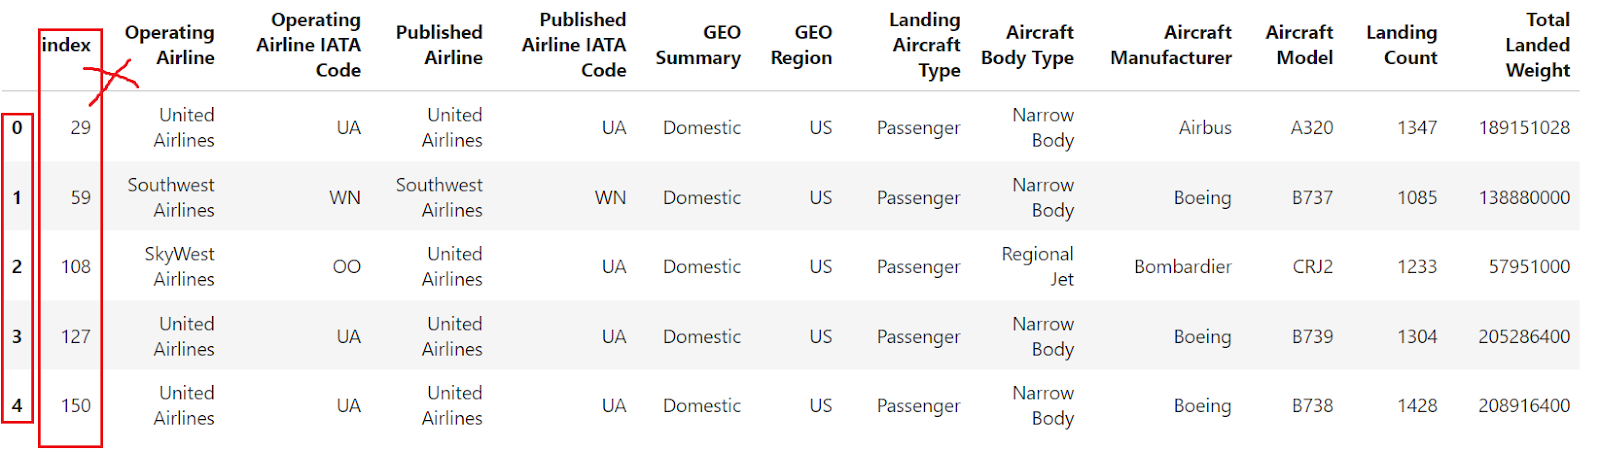
L’image ci-dessus montre que le DataFrame est bien filtré selon la condition, mais l’index n’est pas séquentiel. Utilisons maintenant reset_index pour réindexer le DataFrame filtré et obtenir un index continu. Voici comment procéder :
filtered_df_reset = filtered_df.reset_index()
filtered_df_reset
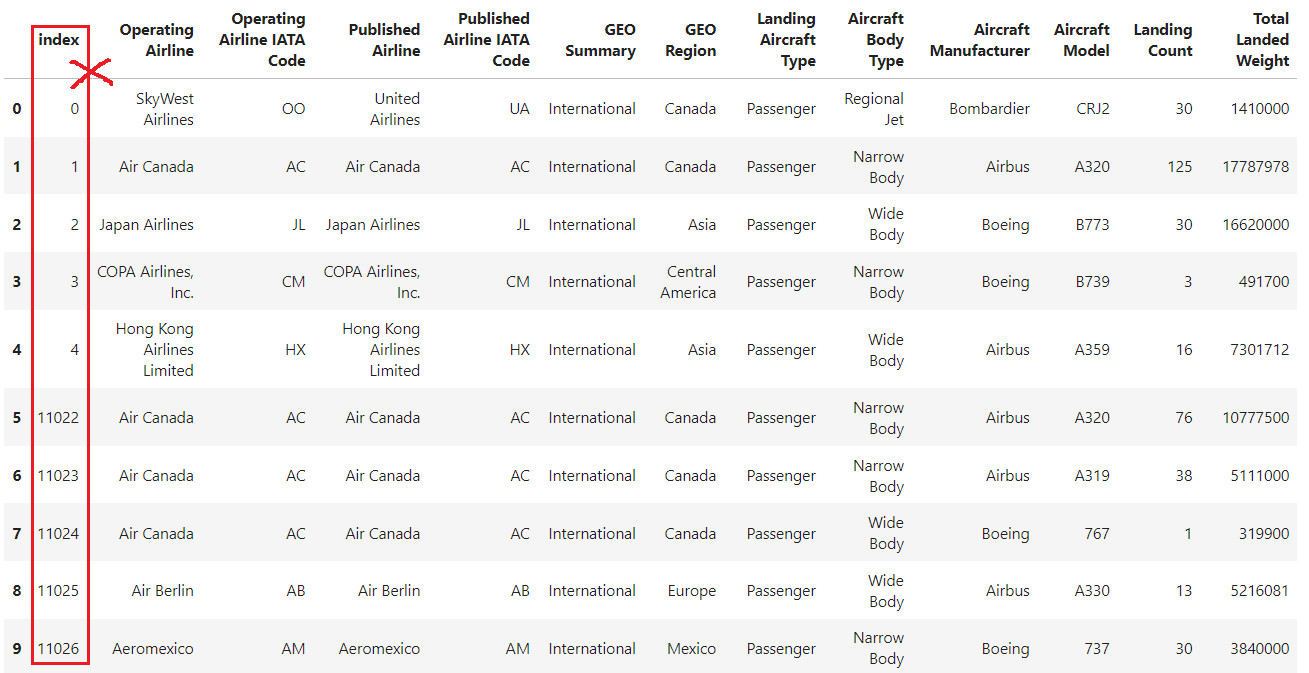
Par défaut, cette méthode remplace l’index existant par un index entier par défaut et convertit l’ancien index en une nouvelle colonne portant le même nom (ou "index" s’il était sans nom).
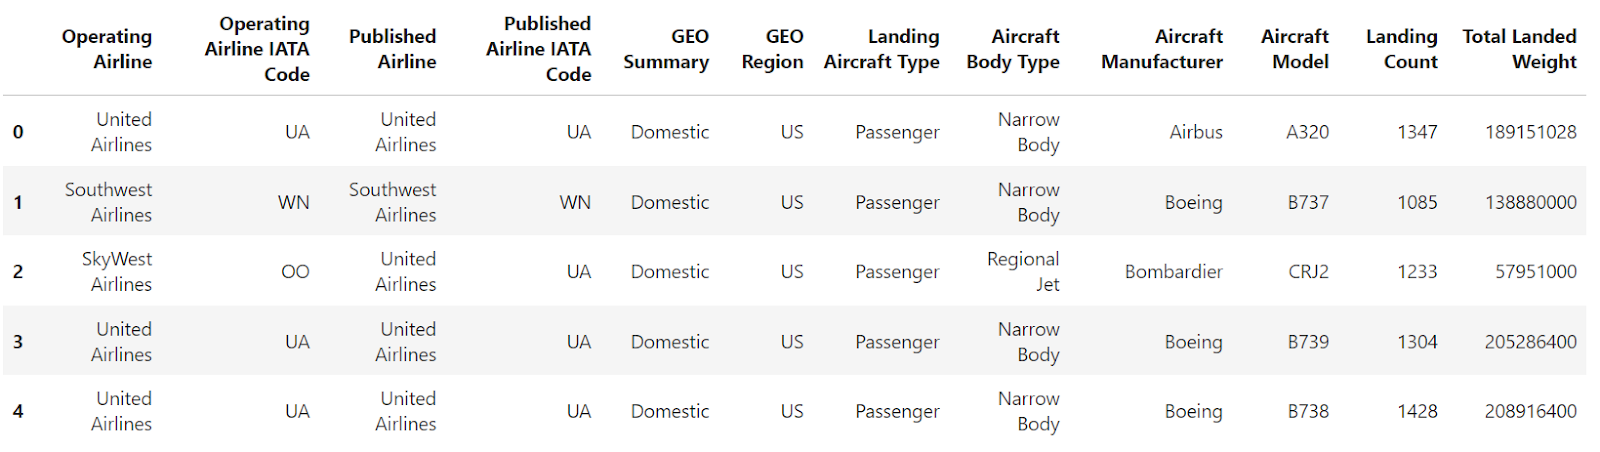
Utilisez donc le paramètre drop=True afin d’éviter d’ajouter l’ancien index comme nouvelle colonne.
filtered_df_reset = filtered_df.reset_index(drop=True)
filtered_df_reset
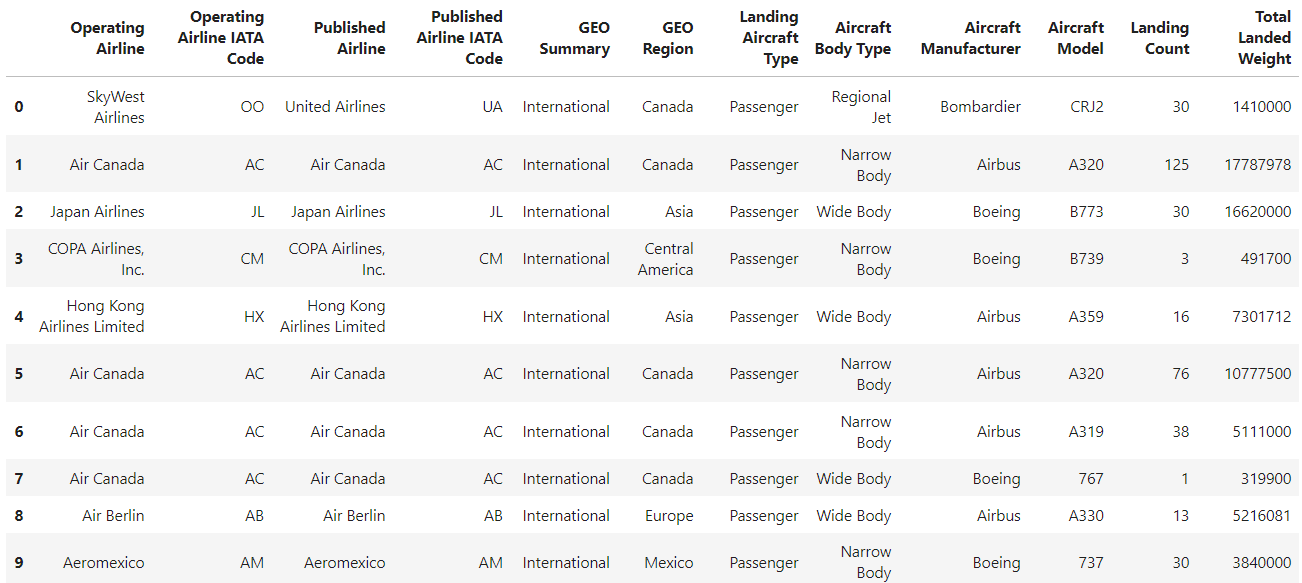
Parfait ! Les indices sont désormais réinitialisés sur l’index entier par défaut (0, 1, 2, …), pour un résultat propre et séquentiel.
Lors de la combinaison de DataFrame, le DataFrame résultant peut contenir des indices dupliqués ou non séquentiels. Réinitialiser l’index permet d’obtenir un index propre et continu.
Supposons que vous ayez deux DataFrame à concaténer. J’ai créé deux DataFrame à partir du jeu de données airlines pour l’exemple.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
split_index = int(df.shape[0] / 2)
df1 = df[:split_index].head()
df2 = df[split_index:].head()
Voici df1 :
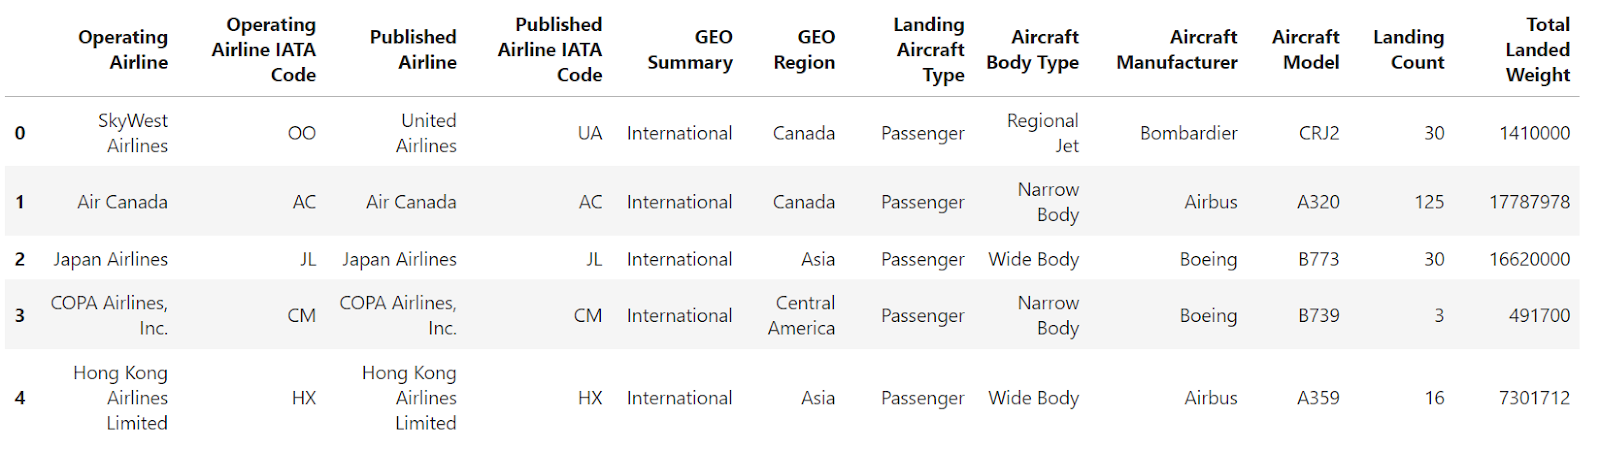
Voici df2 :
Concaténons les DataFrame df1 et df2.
df_concat = pd.concat([df1, df2])
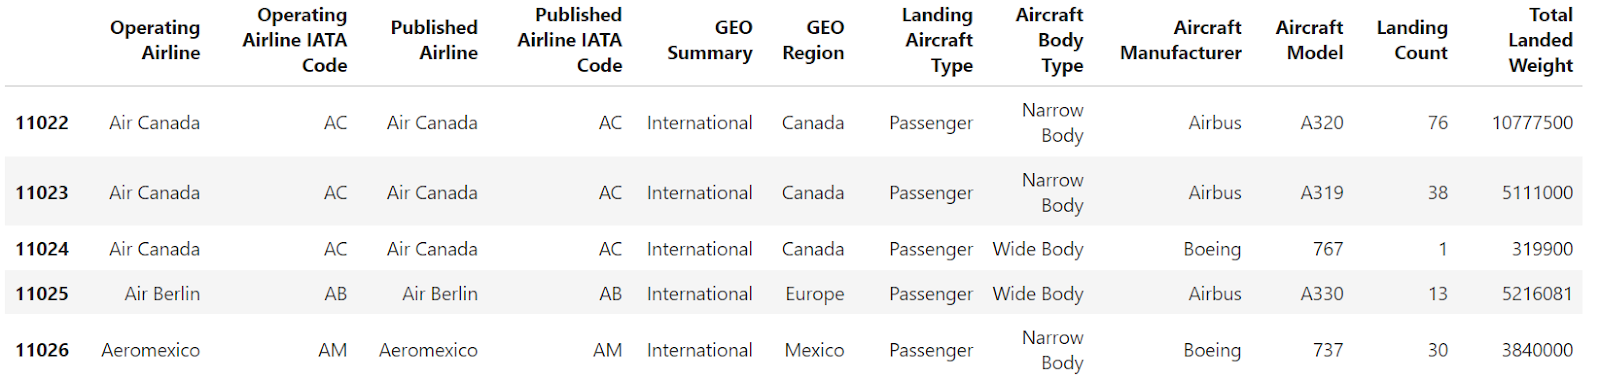
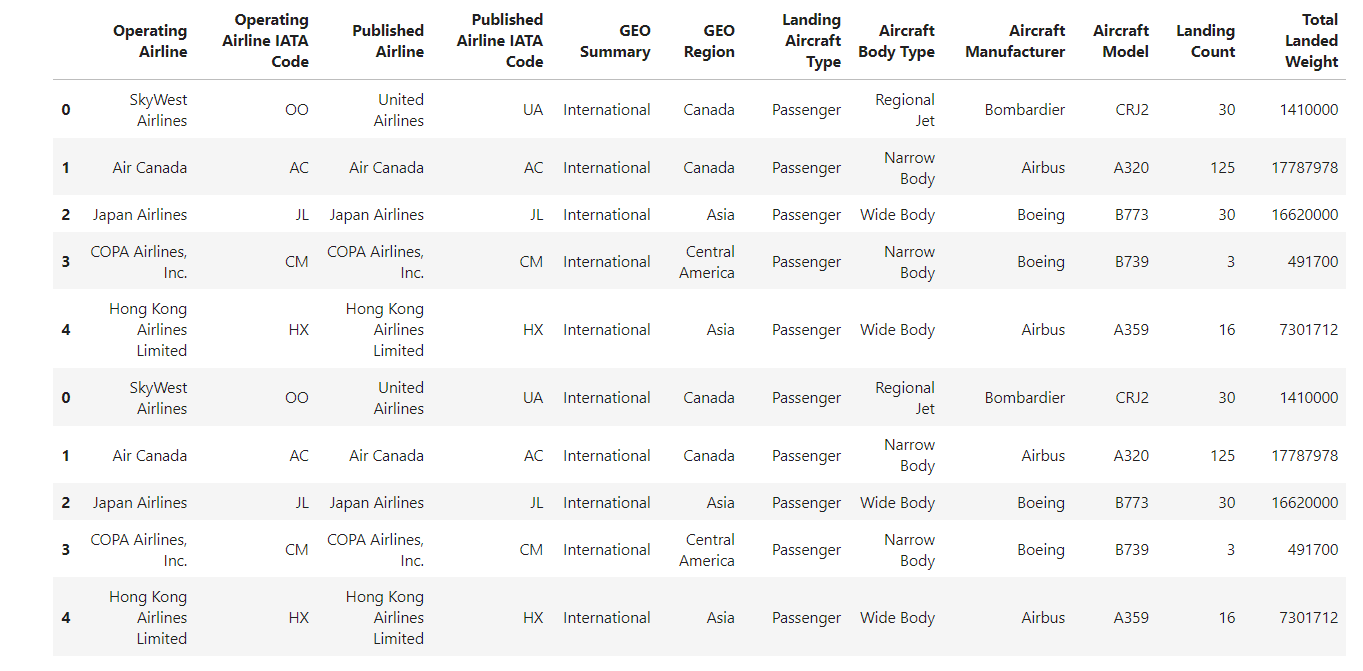
Les indices ne sont pas séquentiels. Nous devons réinitialiser l’index du DataFrame concaténé pour le rendre continu.
Réinitialisons l’index du DataFrame avec la méthode reset_index() de pandas.
df_concat.reset_index()
Voici le résultat après réinitialisation de l’index. La méthode reset_index convertit l’ancien index en nouvelle colonne. Pour retirer cette colonne en trop, utilisez le paramètre drop=True.
df_concat.reset_index(drop=True)
Pour les DataFrame avec un index hiérarchique (multi-niveaux), reset_index permet de simplifier le DataFrame en reconvertissant les niveaux de l’index en colonnes.
Voyons un exemple de DataFrame avec un multi-index.
import pandas as pd
df = pd.read_csv(
    "airlines_dataset.csv", index_col=["Aircraft Model", "Operating Airline IATA Code"]
).head()
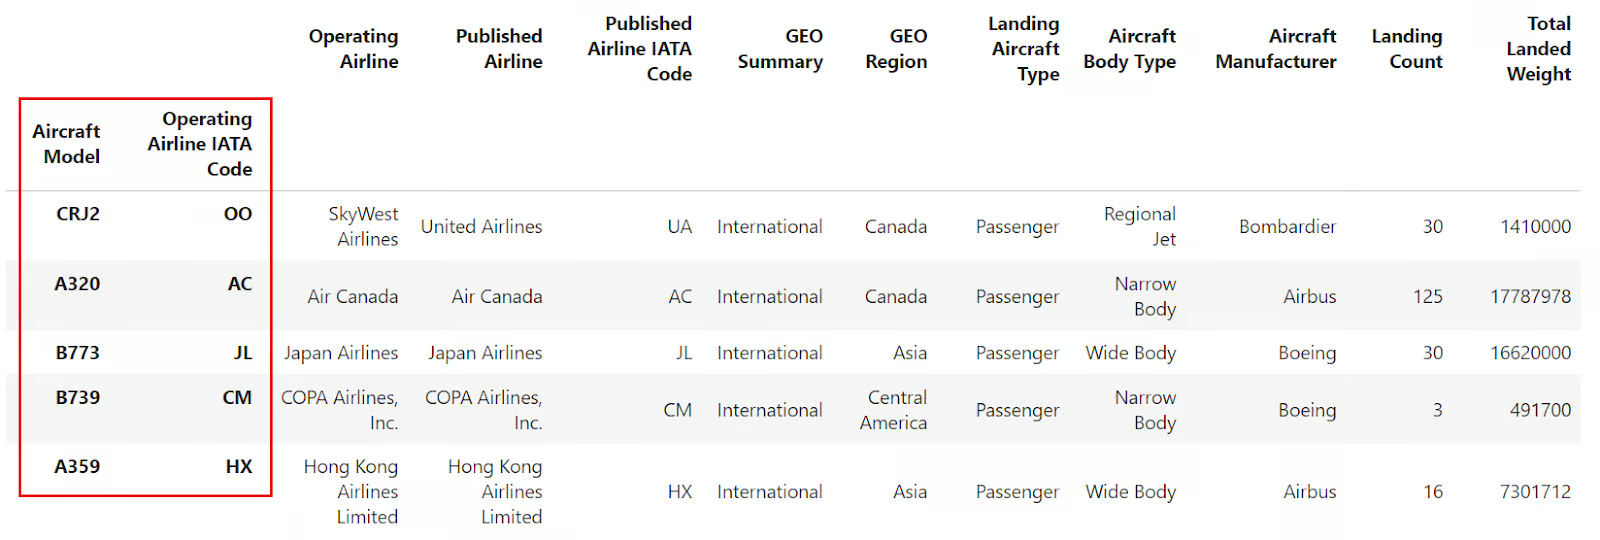
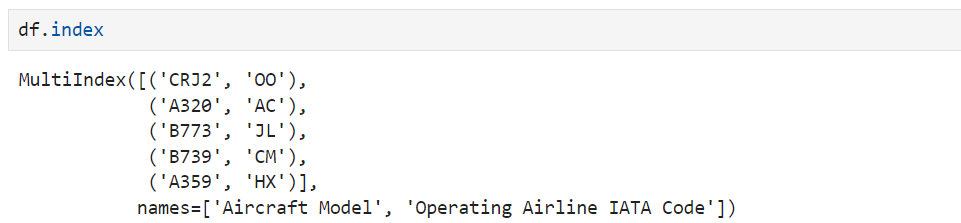
Si vous examinez son index, vous verrez qu’il ne s’agit pas d’un index classique de DataFrame, mais d’un objet MultiIndex.
Utilisons maintenant la méthode pandas reset_index(), qui supprime tous les niveaux d’un MultiIndex :
df.reset_index()
Vous constatez que les deux niveaux du MultiIndex sont convertis en colonnes classiques, tandis que l’index est réinitialisé à l’index entier par défaut.
Vous pouvez également utiliser le paramètre level pour supprimer certains niveaux de l’index. Les niveaux sélectionnés sont convertis en colonnes, sauf si vous choisissez de supprimer complètement ces informations avec le paramètre drop. Voyons cela :
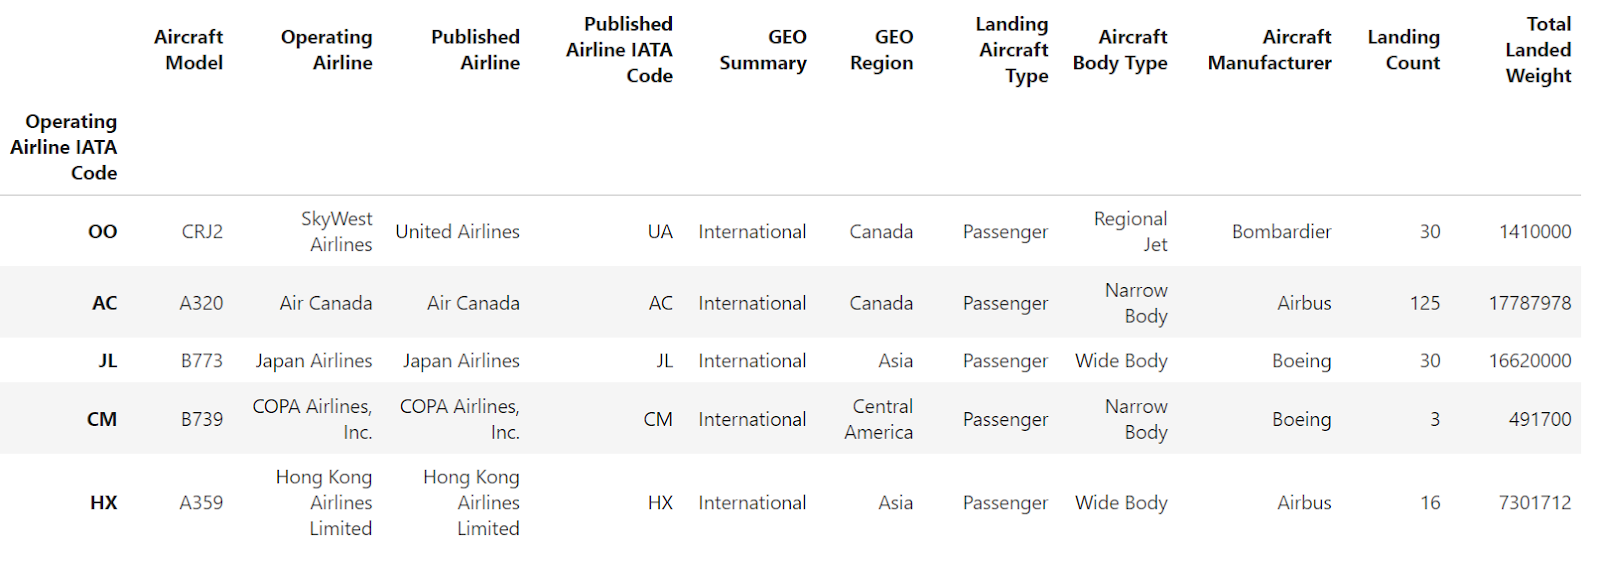
df.reset_index(level=["Aircraft Model"])
L’image ci-dessus montre que "Aircraft Model" est désormais une colonne classique. Seul "Operating Airline IATA Code" reste en index.
Si vous ne souhaitez pas que l’index listé devienne une colonne classique, combinez les paramètres drop et level pour le supprimer du DataFrame.
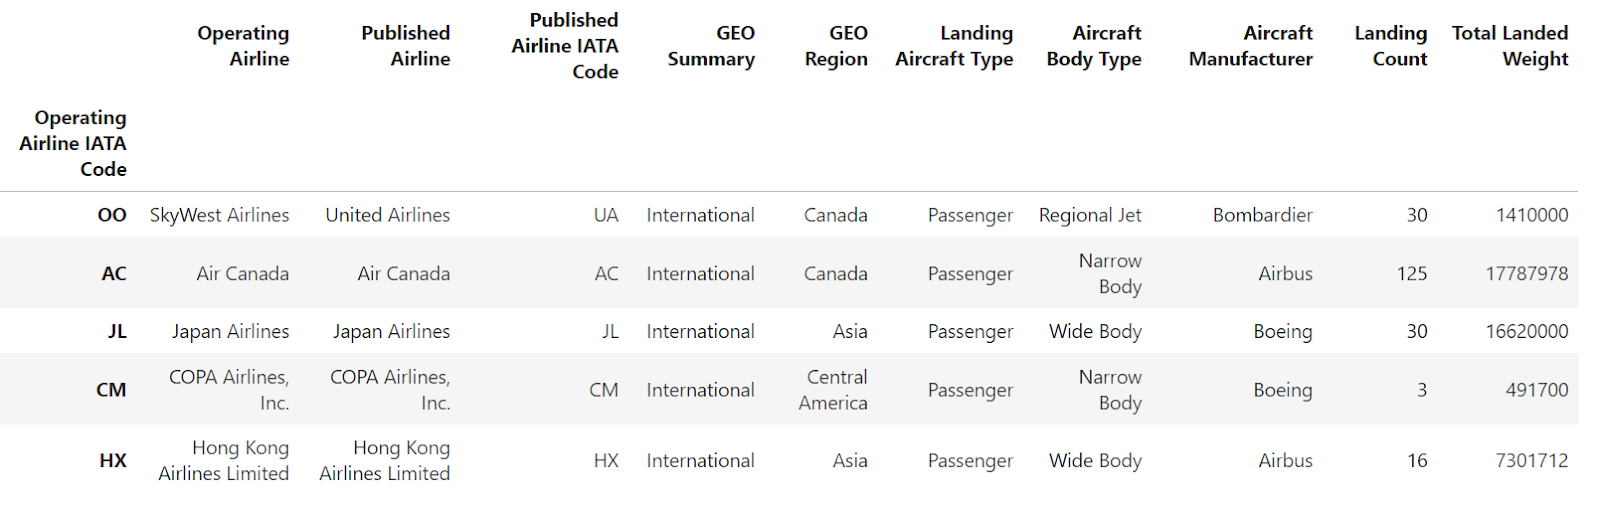
df.reset_index(level=["Aircraft Model"], drop=True)
L’index "Aircraft Model" a été retiré de l’index et du DataFrame. L’autre index, "Operating Airline IATA Code", est conservé comme index courant.
Si vous fusionnez deux DataFrame, le DataFrame obtenu n’aura plus d’indices séquentiels, comme ci-dessous.
Réinitialisons l’index du DataFrame avec la méthode reset_index() de pandas.
df.reset_index()
Le paramètre drop détermine s’il faut conserver l’ancien index comme colonne après la réinitialisation, ou le supprimer totalement. Par défaut (drop=False), l’ancien index est conservé, comme montré précédemment. En revanche, drop=True supprime l’ancien index du DataFrame après réinitialisation.
df.reset_index(drop=True)
Modifiez le DataFrame sur place grâce au paramètre inplace pour éviter de créer un nouveau DataFrame.
Supposons que vous ayez le DataFrame ci-dessous :
En définissant inplace à True, les modifications sont appliquées directement au DataFrame original, sans créer de copie.
df_concat.reset_index(drop=True, inplace=True)
df_concat
Gérez les indices dupliqués en réinitialisant puis en réindexant correctement.
Supposons que vos données contiennent des indices en double.
L’utilisation de reset_index() avec drop=True et inplace=True garantit un index continu, démarrant à 0 et s’incrémentant séquentiellement.
df.reset_index(drop=True, inplace=True)
inplace=False si vous vous attendez à modifier le DataFrame original. Si inplace est à False, une nouvelle copie est renvoyée et l’original reste inchangé.drop pour éviter toute suppression accidentelle d’informations. Supprimer l’index retire définitivement ses valeurs.Appliquons ce que nous avons appris et voyons en quoi la réinitialisation de l’index est utile lors de la suppression de valeurs manquantes.
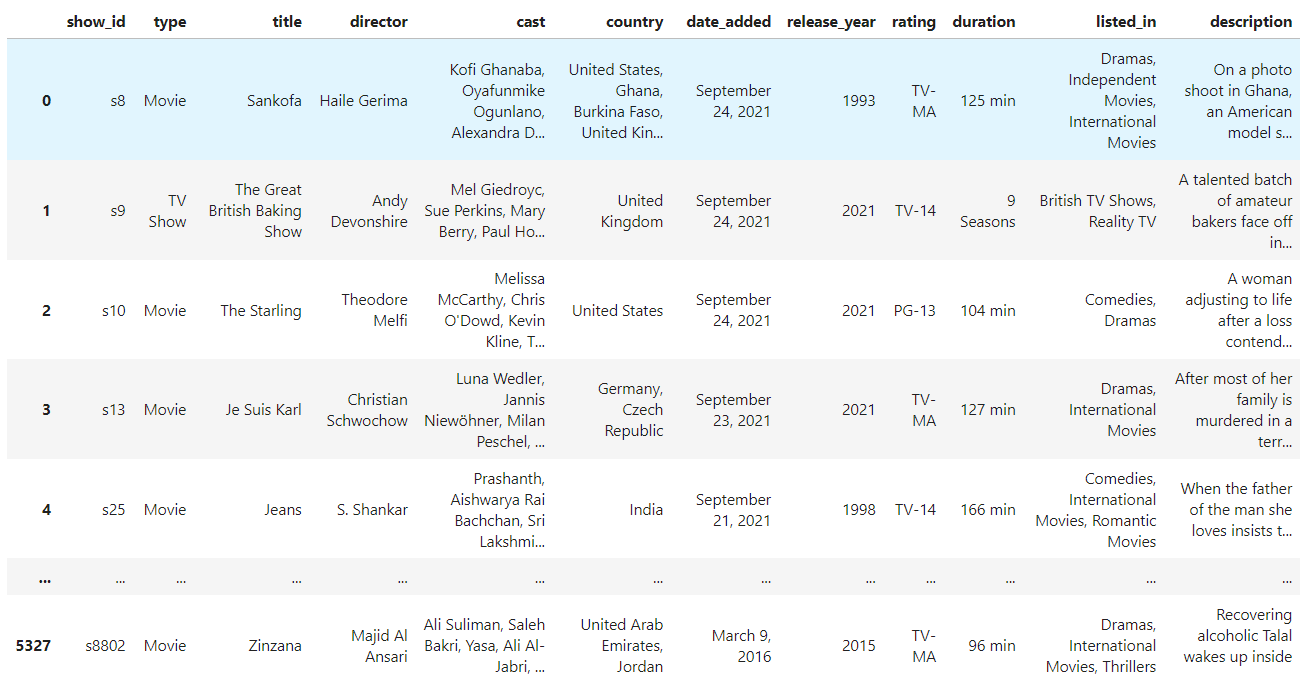
Notre jeu de données aérien ne comporte pas de valeurs manquantes, utilisons donc plutôt le jeu de données Netflix Movies and TV shows. Il contient des valeurs manquantes, parfait pour illustrer reset_index().
import pandas as pd
df = pd.read_csv("netflix_shows.csv")
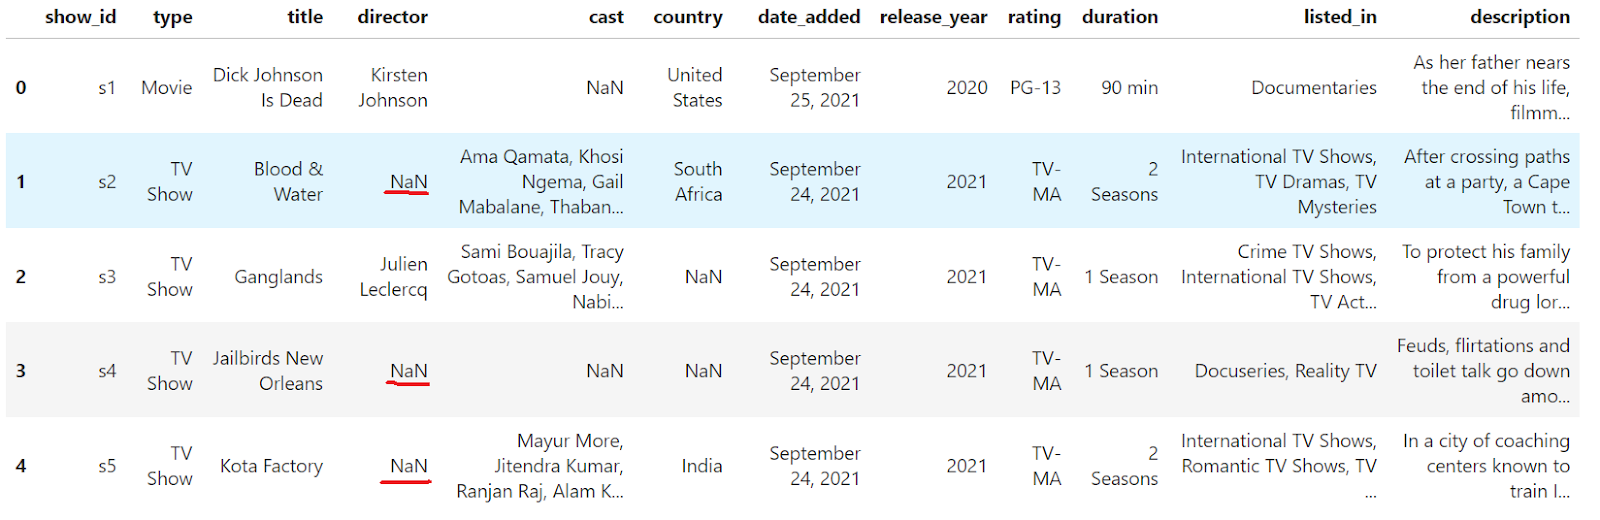
df.head()
On observe des valeurs manquantes dans le DataFrame. Supprimez les lignes concernées avec la méthode dropna().
df.dropna(inplace=True)
df.head()
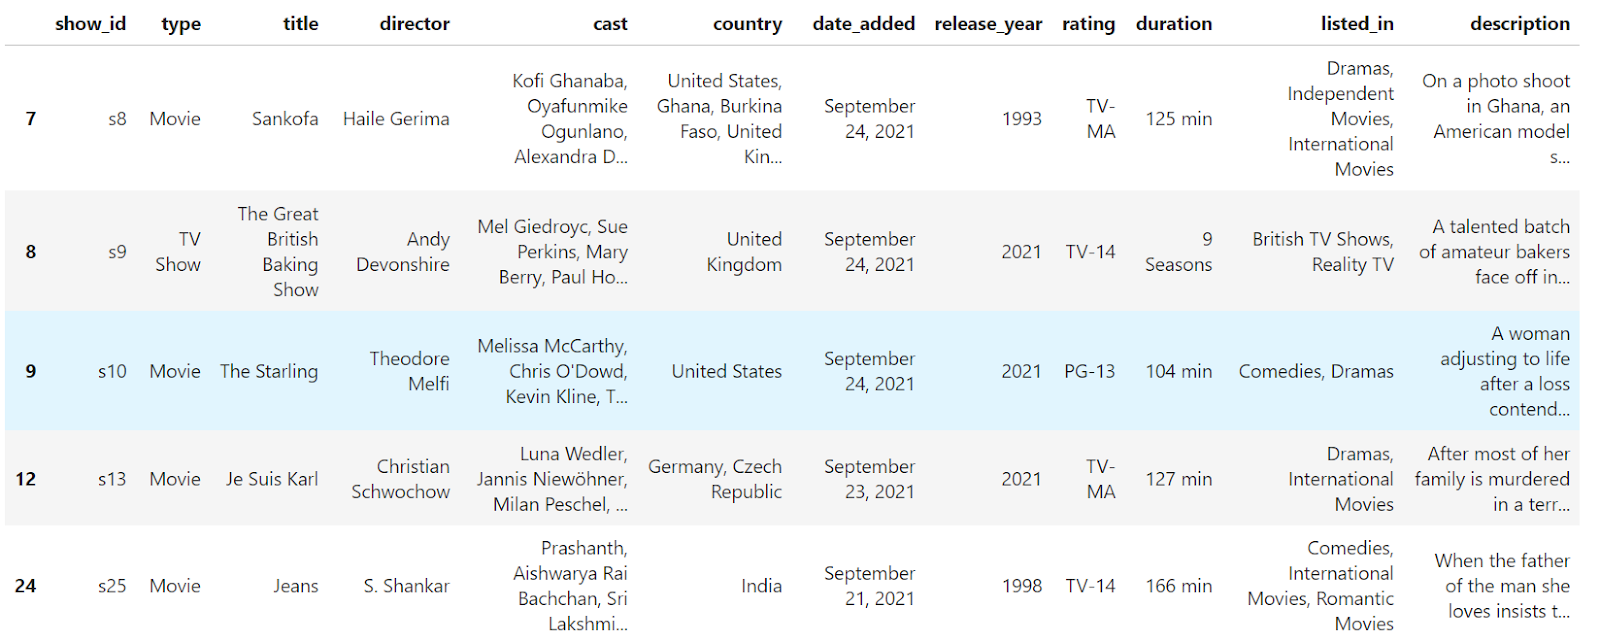
Les lignes contenant des NaN ont été supprimées. Cependant, l’index n’est plus continu (0, 1, 2, 4). Réinitialisons-le :
df.reset_index()
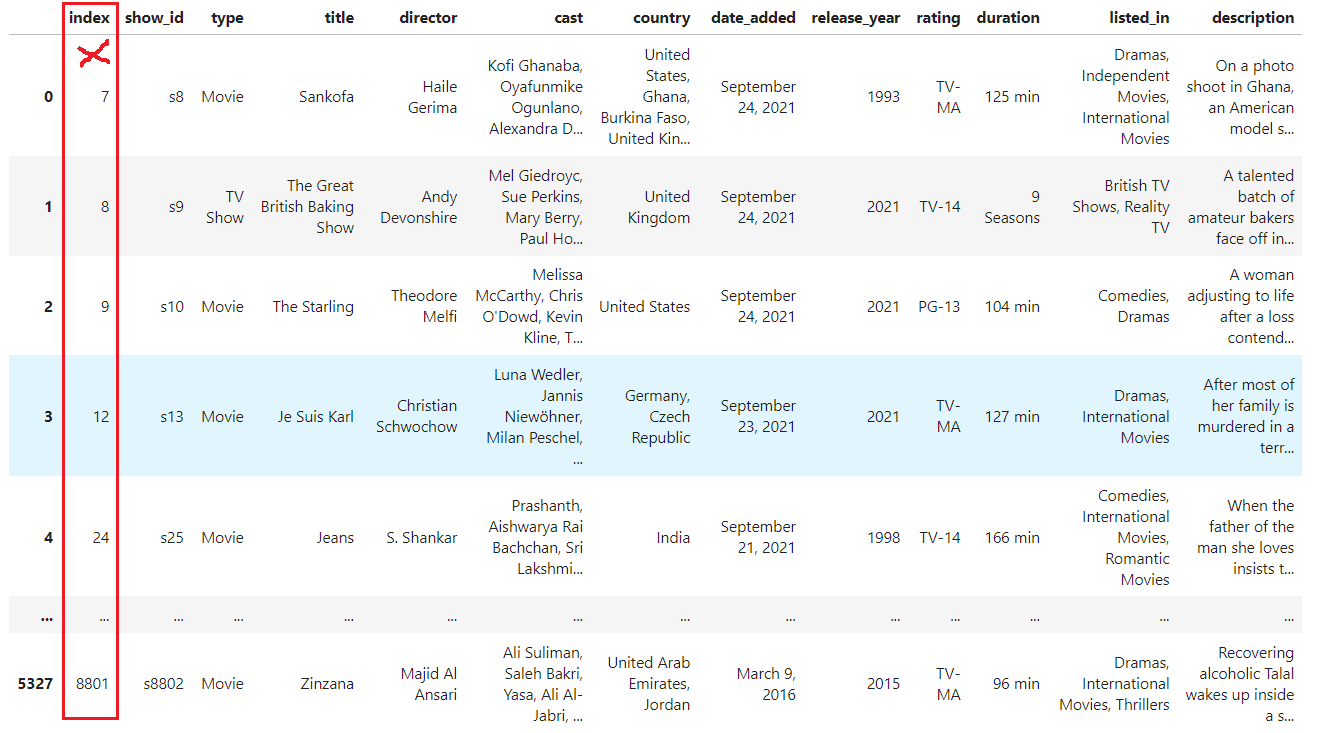
L’index est désormais continu, mais comme nous n’avons pas précisé le paramètre drop, l’ancien index a été converti en colonne, nommée par défaut index. Supprimons-le complètement du DataFrame :
df.reset_index(drop=True)
Nous avons entièrement supprimé l’ancien index, devenu inutile, et l’index courant est maintenant continu. Dernière étape : enregistrer ces modifications dans notre DataFrame original grâce au paramètre inplace :
df.reset_index(drop=True, inplace=True)Vous avez vu comment la fonction reset_index dans Pandas gère efficacement les index des DataFrame. Que vous traitiez des données filtrées, des DataFrame concaténés ou un index multi-niveaux complexe, reset_index assure un DataFrame propre et organisé. Ses paramètres permettent de gérer des scénarios d’indexation variés lors de manipulations de données.
Poursuivez votre apprentissage de fonctions similaires à reset_index avec le parcours Data Analyst with Python de DataCamp. Vous pouvez aussi consulter notre Python List Index() Tutorial si vous travaillez avec des listes et souhaitez découvrir la fonction index() appliquée aux listes.
Meilleures formations pandas
Cours
Cours
Cours