Kurs
Datenbearbeitung mit pandas
4 Std.
567.9K
Nach dem Bearbeiten und Filtern eines großen Datensatzes erhältst du möglicherweise genau den benötigten DataFrame. Dieser behält jedoch oft den ursprünglichen, nicht fortlaufenden Index. In solchen Fällen solltest du den Index des DataFrame zurücksetzen.
In diesem Tutorial sprechen wir über die pandas-Methode reset_index(), mit der der Index eines DataFrame auf den Standard zurückgesetzt wird. Wir sehen uns die verschiedenen Optionen an, die diese Methode bietet. Außerdem zeigen wir, wie du den Index bei einfachen und mehrstufigen DataFrames zurücksetzt.
Zum Üben verwenden wir ein Airline-Dataset. Wir nutzen Datacamps Datalab, eine interaktive Umgebung, die speziell für Datenanalyse in Python entwickelt wurde – ideal, um dem Tutorial Schritt für Schritt zu folgen.
Die Methode reset_index in pandas setzt den Index eines DataFrame auf den Standardindex zurück. Nach Operationen wie Filtern, Zusammenführen oder Konkatenation ist der Index oft nicht mehr fortlaufend. Diese Methode stellt einen sauberen, fortlaufenden Index wieder her. Bei einem MultiIndex können ein oder mehrere Ebenen entfernt werden.
Grundlegende Syntax:
df.reset_index(level=None, drop=False, inplace=False, col_level=0, col_fill="")Parameter:
Rückgabe:
DataFrame mit neuem Index oder None, wenn inplace=True gesetzt ist.
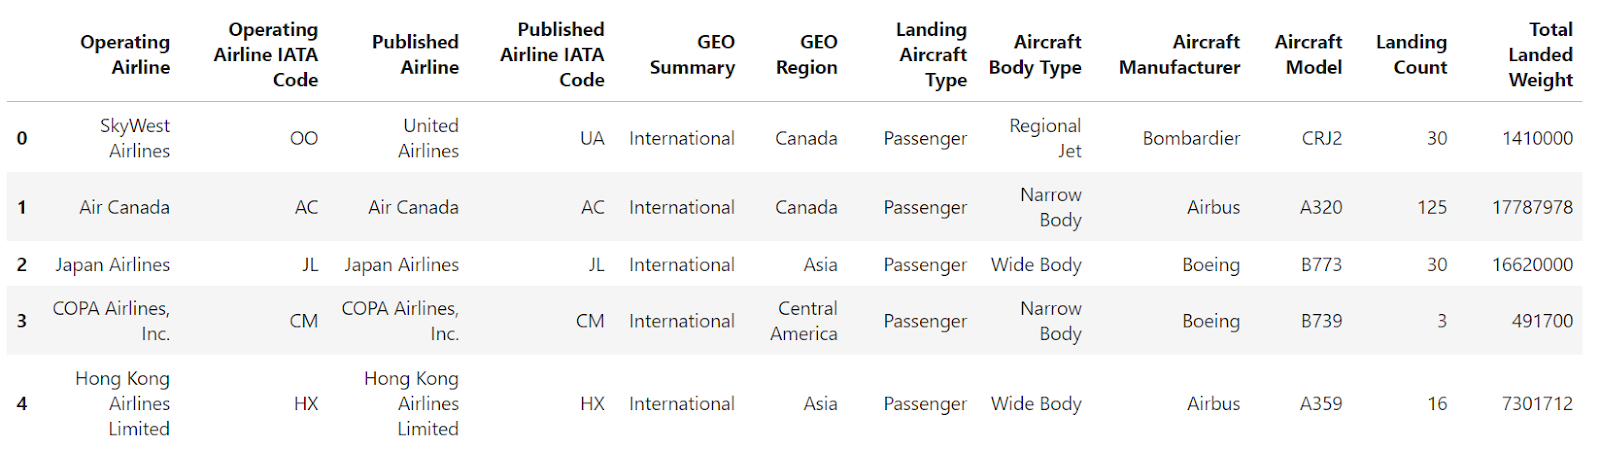
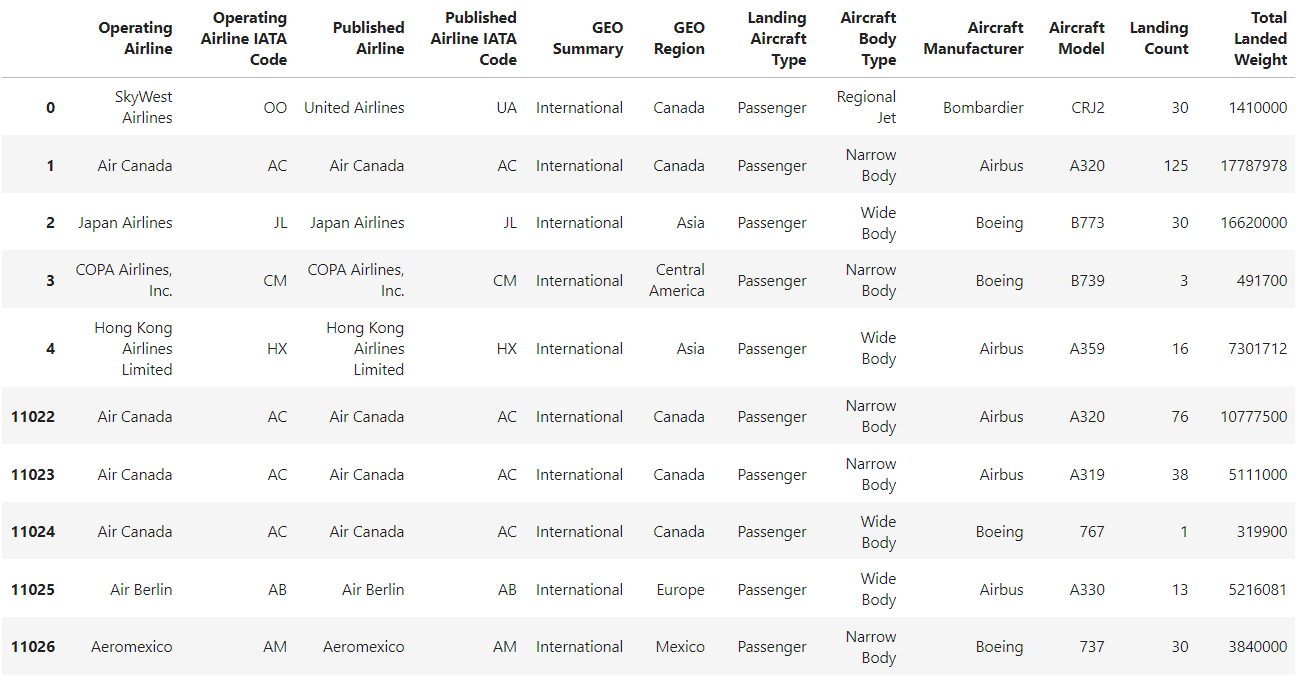
Wenn du eine CSV-Datei mit der pandas-Methode read_csv() ohne Index einliest, erhält der DataFrame standardmäßig einen ganzzahlbasierten Index, beginnend bei 0 und pro Zeile um 1 steigend.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df
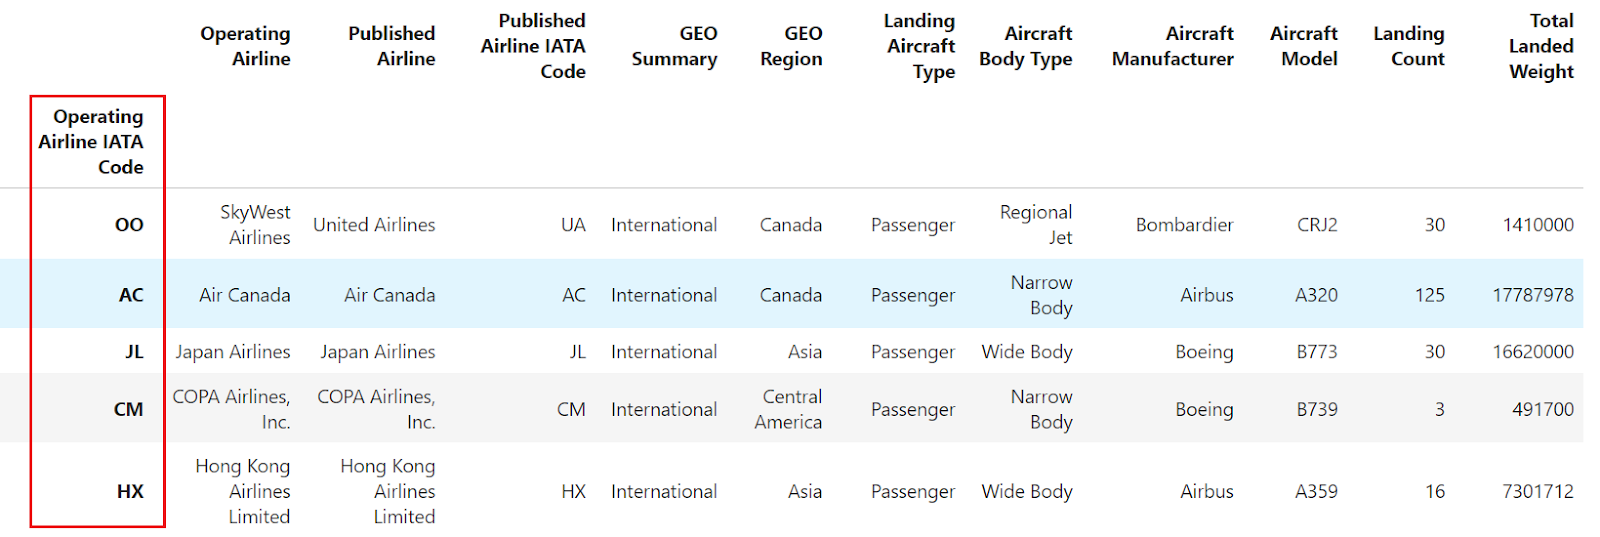
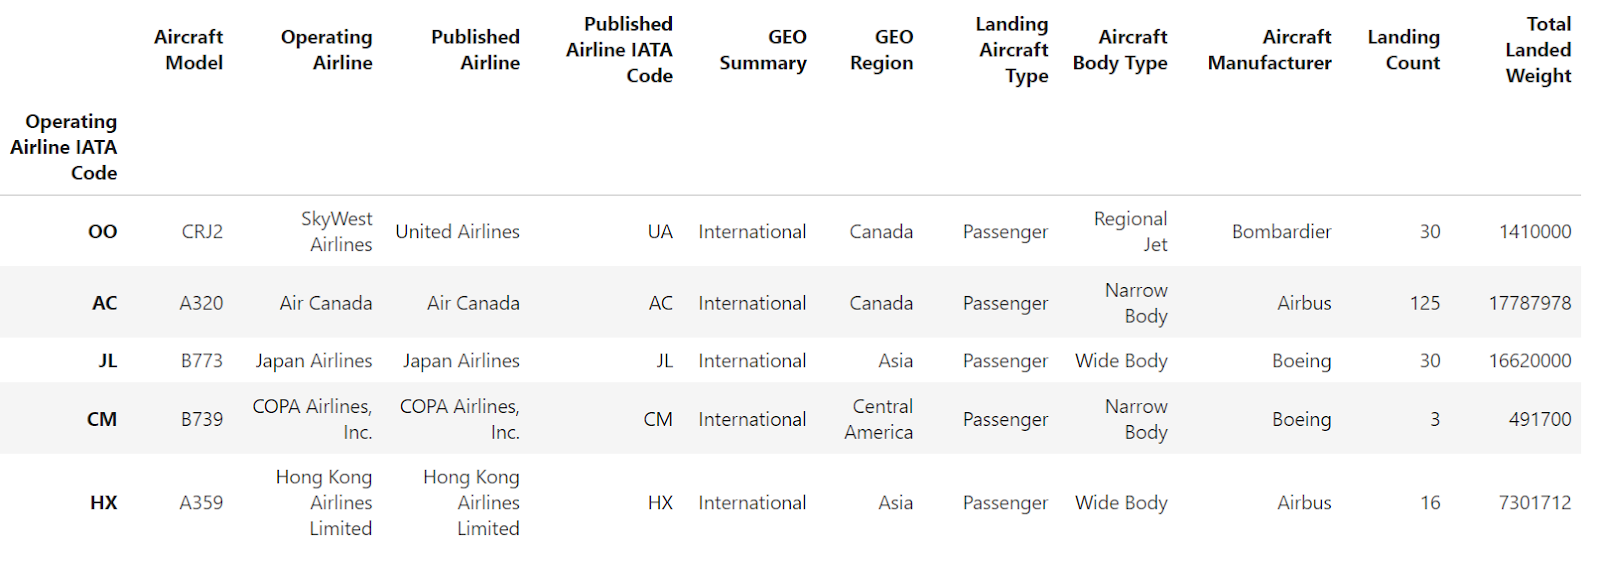
Manchmal sind beschreibendere Zeilenlabels sinnvoll. Dafür kannst du eine Spalte als Index (Zeilenlabels) setzen. Beim Laden per read_csv() gibst du die gewünschte Indexspalte über den Parameter index_col an.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv", index_col="Operating Airline IATA Code").head()
df
Alternativ kannst du mit der Methode set_index() jede beliebige Spalte eines DataFrame als Index festlegen:
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df.set_index("Operating Airline IATA Code", inplace=True)
df
Beachte, dass dieses Snippet den ursprünglichen DataFrame verändert.
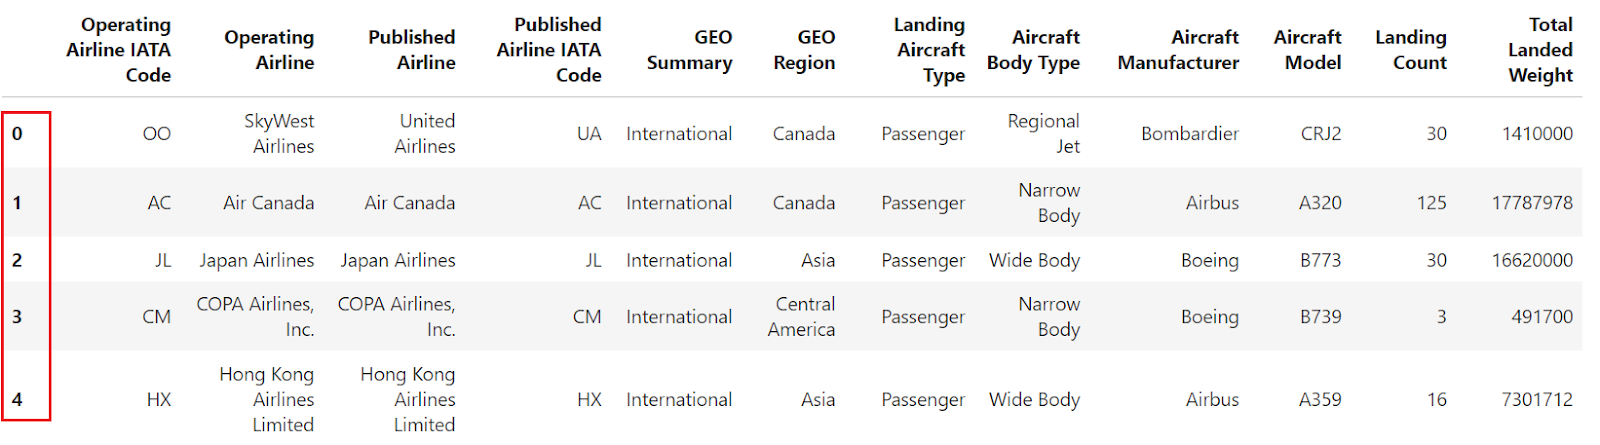
Was ist, wenn du den standardmäßigen numerischen Index wiederherstellen willst? Hier kommt die pandas-Methode reset_index() ins Spiel.
df.reset_index()
Das Beispiel zeigt: Nachdem die Spalte "Operating Airline IATA Code" als Index gesetzt wurde, stellt reset_index den ursprünglichen ganzzahligen Standardindex wieder her.
Die pandas-Methode reset_index() ist ein starkes Werkzeug, um DataFrame-Indizes nach dem Filtern, beim Zusammenführen/Konkatenieren oder bei MultiIndex-Strukturen neu zu organisieren.
Lerne mehr über das Umformen von DataFrames von Wide- zu Long-Formaten, das Stapeln und Entstapeln von Zeilen und Spalten sowie den Umgang mit MultiIndex-DataFrames in unserem Online-Kurs.
Beim Filtern bleibt der ursprüngliche Index erhalten. Mit reset_index kannst du den gefilterten DataFrame neu indizieren.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
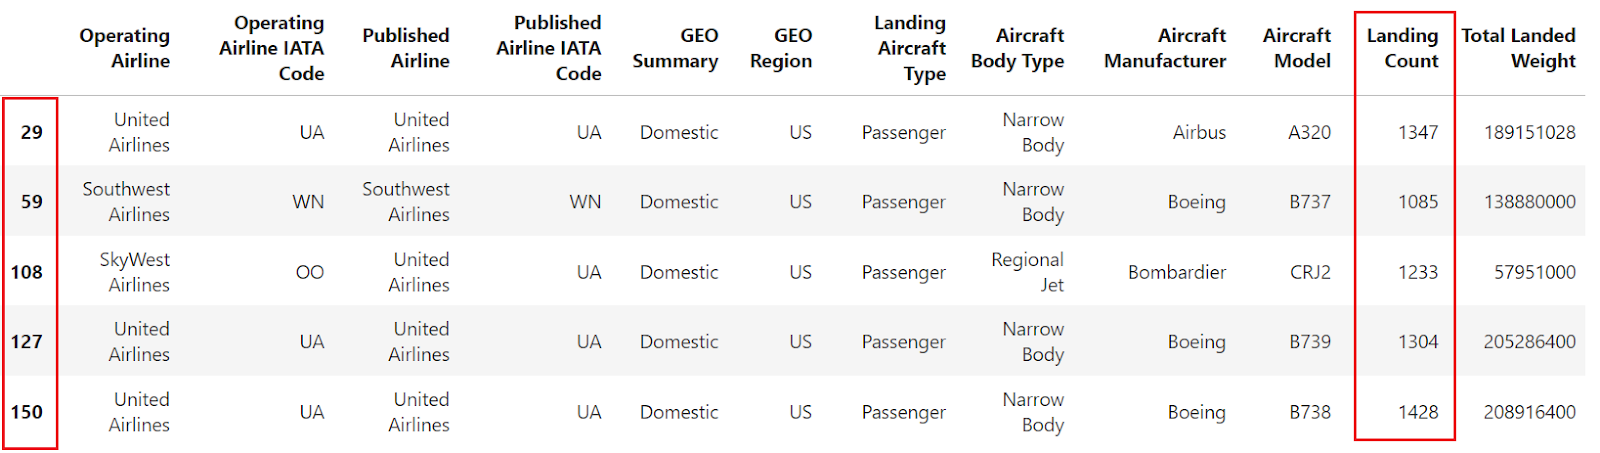
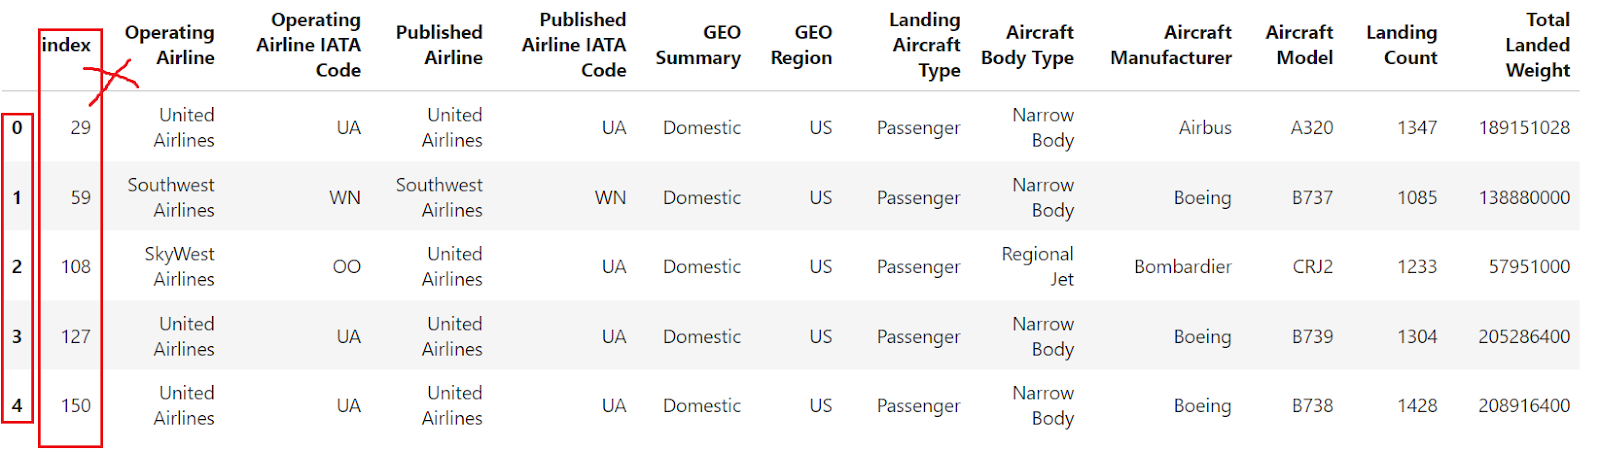
Filtern wir die Daten auf Zeilen, in denen der "Landing Count" größer als 1000 ist. Nach dem Filtern ist der Index eventuell nicht mehr fortlaufend. Anschließend kannst du die Methode reset_index verwenden, um den Index des gefilterten DataFrame zurückzusetzen.
filtered_df = df[df["Landing Count"] > 1000].head()
filtered_df
Das Bild zeigt: Der DataFrame wurde nach der Bedingung gefiltert, aber der Index ist nicht fortlaufend. Jetzt setzen wir mit reset_index neu, damit der Index wieder sequenziell ist. So geht's:
filtered_df_reset = filtered_df.reset_index()
filtered_df_reset
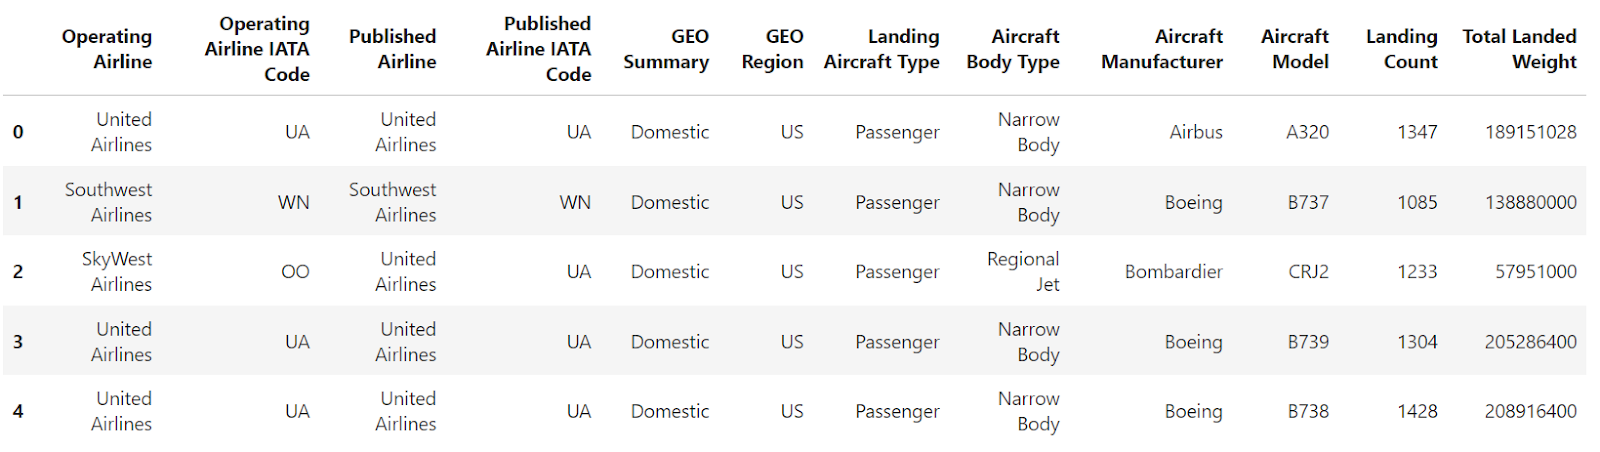
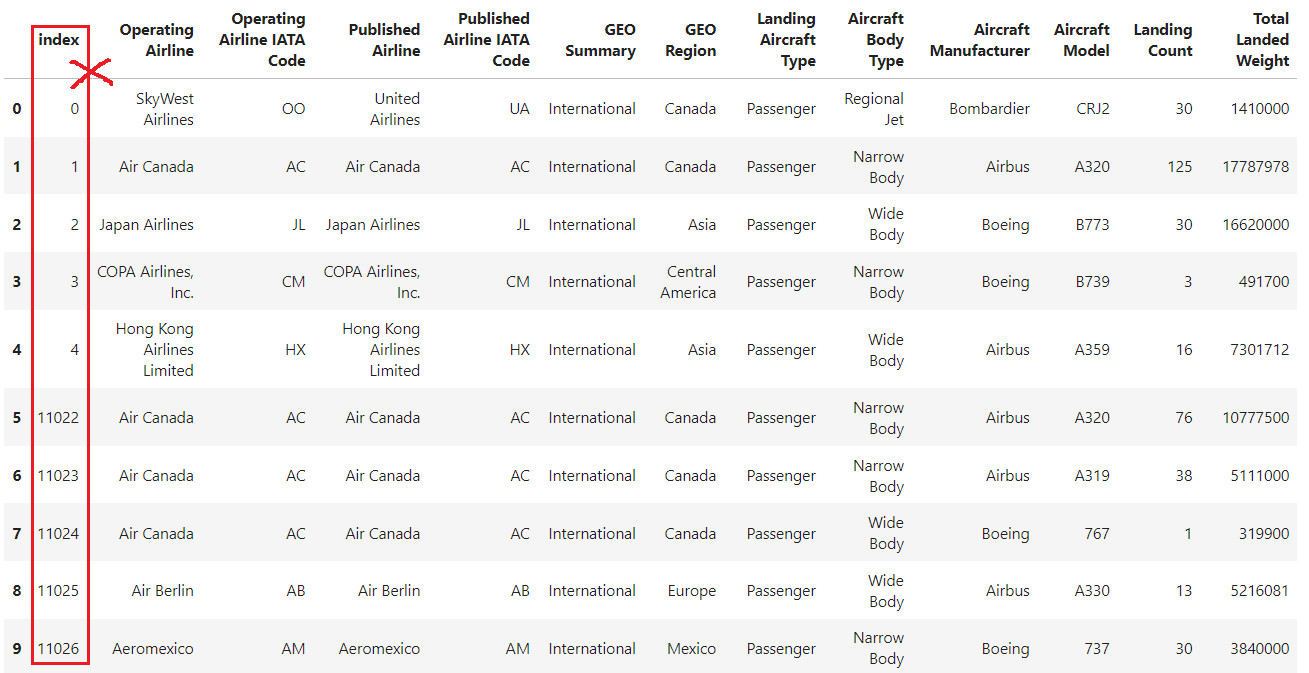
Standardmäßig ersetzt diese Methode den bestehenden Index durch einen ganzzahligen Standardindex und wandelt den alten Index in eine neue Spalte um (mit gleichem Namen oder "index", falls er namenlos war).
Verwende daher den Parameter drop=True, damit der alte Index nicht als neue Spalte hinzugefügt wird.
filtered_df_reset = filtered_df.reset_index(drop=True)
filtered_df_reset
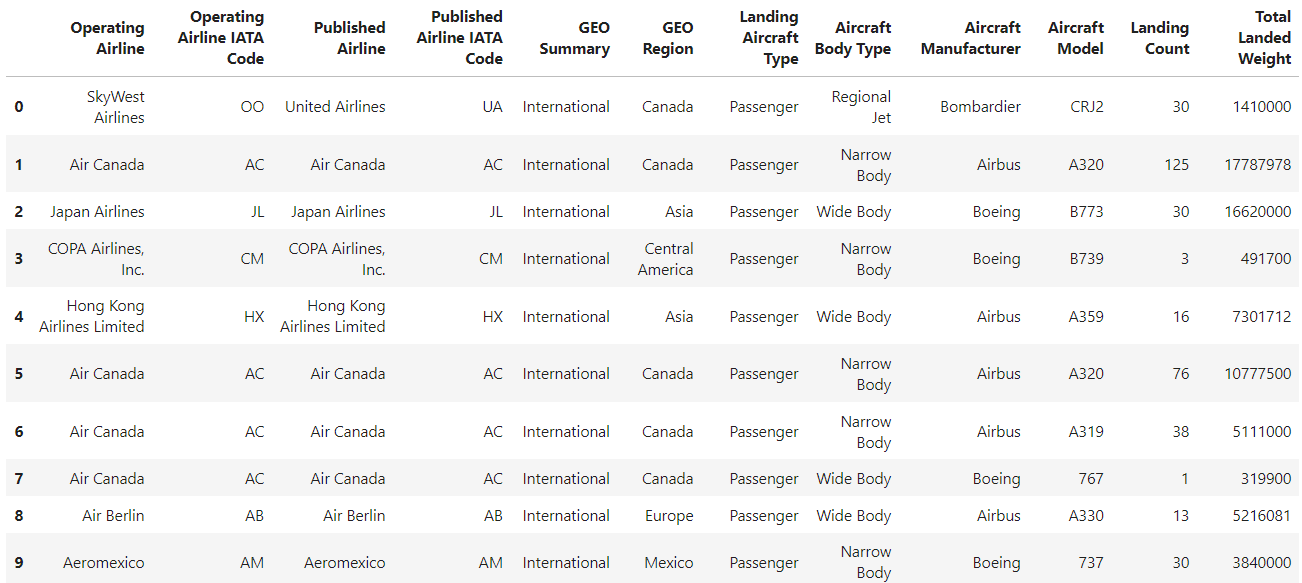
Perfekt! Die Indizes wurden auf den Standard (0, 1, 2, …) zurückgesetzt – sauber und fortlaufend.
Beim Kombinieren von DataFrames können doppelte oder nicht fortlaufende Indizes entstehen. Ein Zurücksetzen erzeugt wieder einen sauberen, fortlaufenden Index.
Angenommen, du hast zwei DataFrames, die du konkatenieren willst. Für die Demo habe ich zwei DataFrames aus dem Airline-Datensatz erzeugt.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
split_index = int(df.shape[0] / 2)
df1 = df[:split_index].head()
df2 = df[split_index:].head()
Das ist df1:
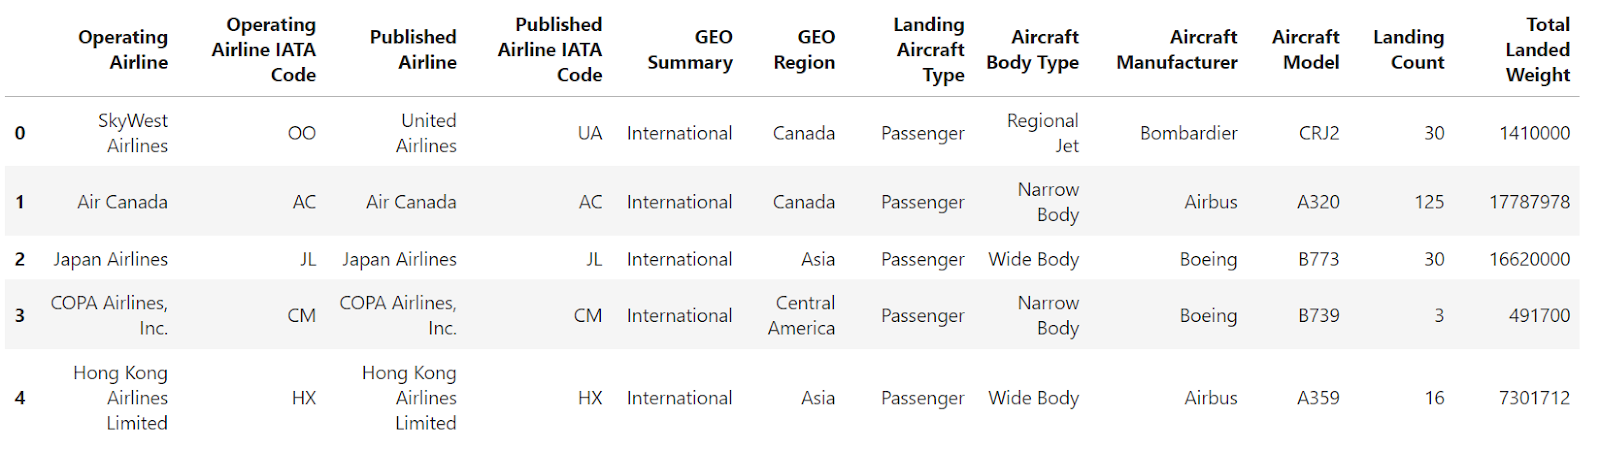
Und das ist df2:
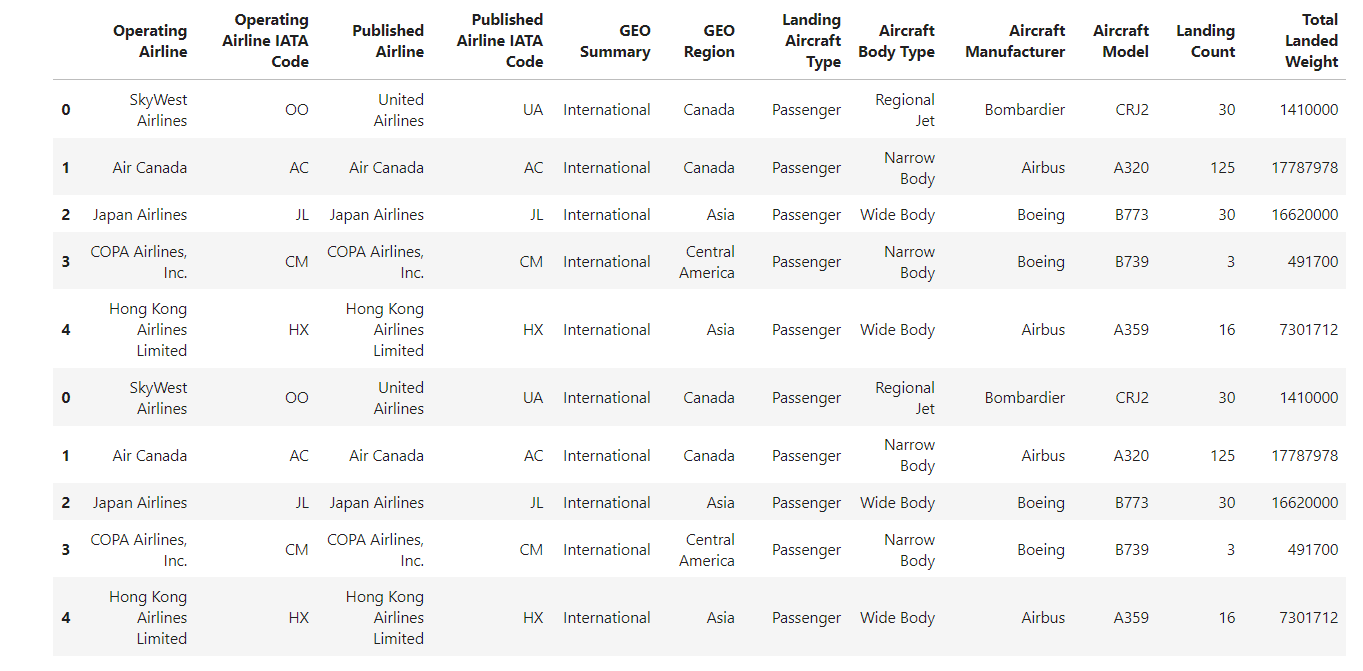
Konkatenieren wir nun df1 und df2.
df_concat = pd.concat([df1, df2])
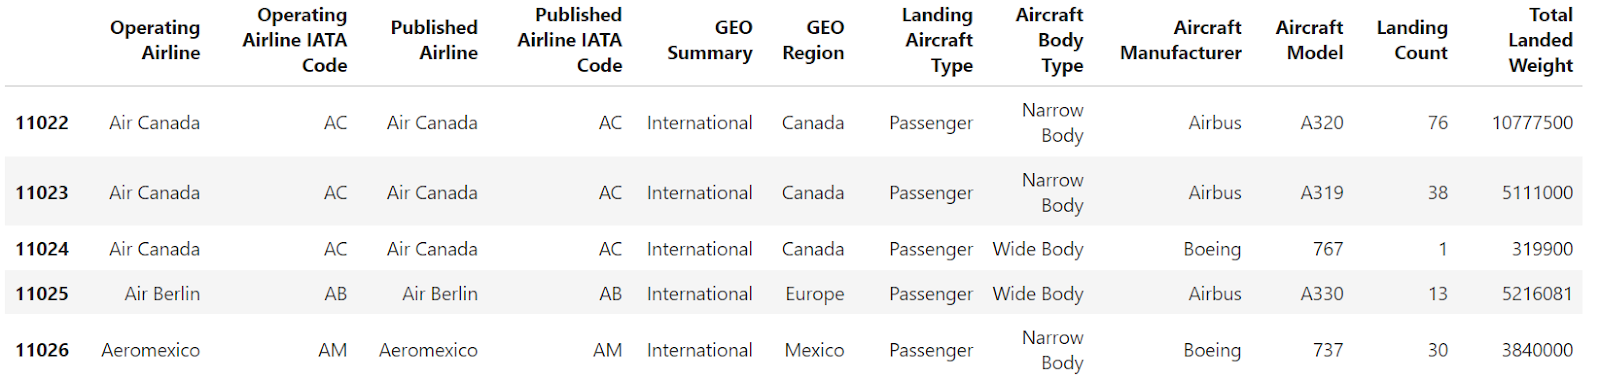
Die Indizes sind nicht fortlaufend. Wir setzen den Index des konkatenierten DataFrame zurück, um ihn zu sequenzialisieren.
Setzen wir den Index mit der pandas-Methode reset_index() zurück.
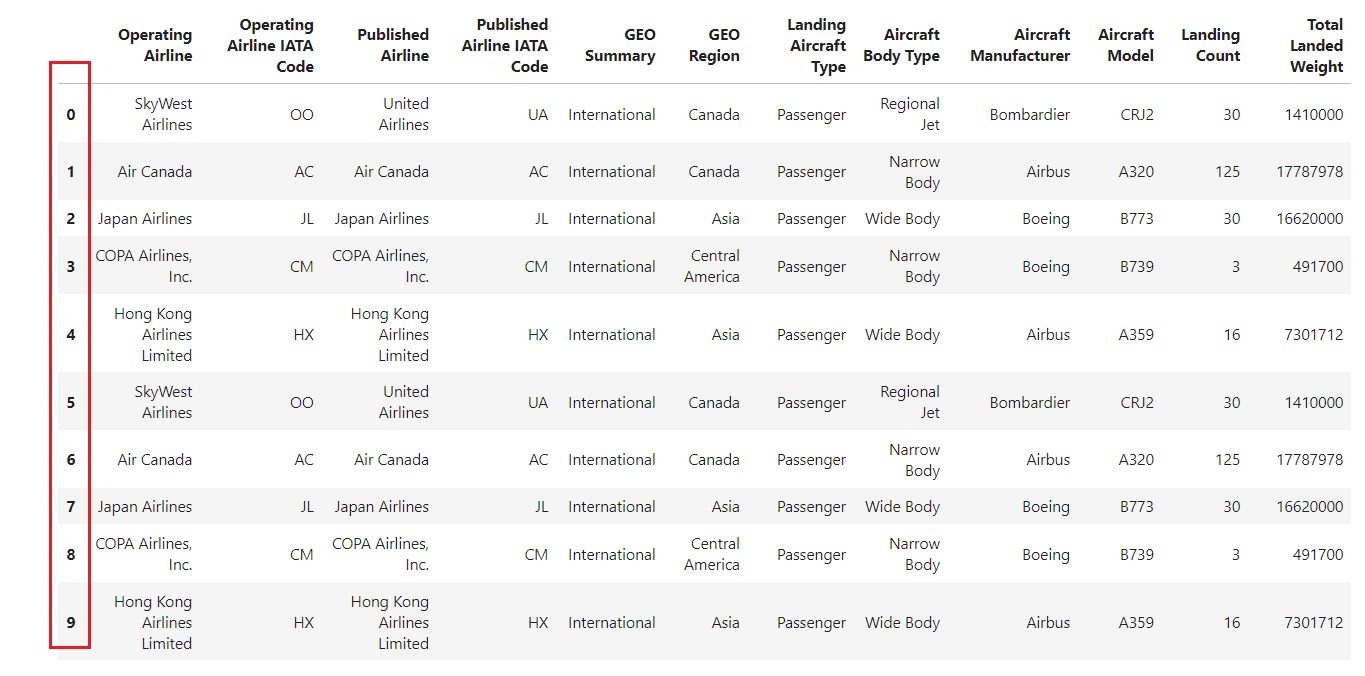
df_concat.reset_index()
So sieht das Ergebnis nach dem Zurücksetzen aus. Die Methode reset_index wandelt den alten Index in eine neue Spalte um. Um diese Zusatzspalte zu entfernen, setze den Parameter drop=True.
df_concat.reset_index(drop=True)
Bei DataFrames mit hierarchischem (mehrstufigem) Index kannst du mit reset_index den DataFrame vereinfachen, indem die Ebenen zurück in Spalten überführt werden.
Schauen wir uns einen DataFrame mit MultiIndex an.
import pandas as pd
df = pd.read_csv(
    "airlines_dataset.csv", index_col=["Aircraft Model", "Operating Airline IATA Code"]
).head()
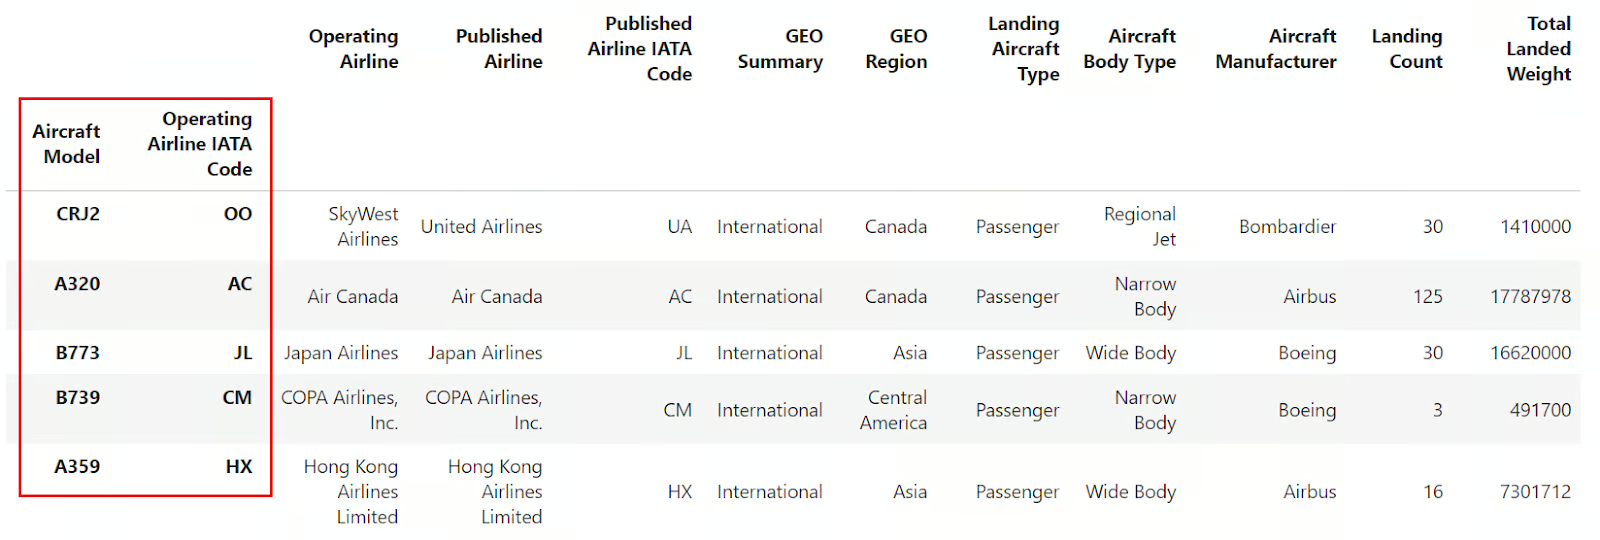
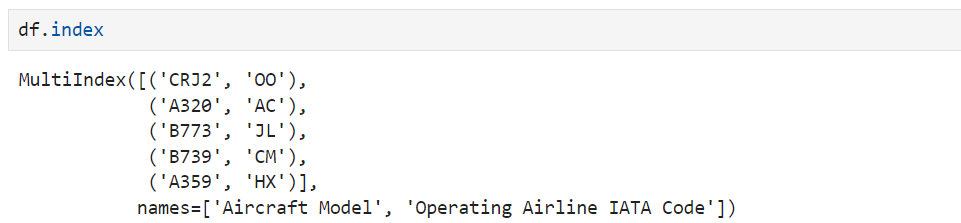
Prüfst du den Index, siehst du: Es ist kein einfacher Index, sondern ein MultiIndex-Objekt.
Nun verwenden wir die pandas-Methode reset_index(), die alle Ebenen eines MultiIndex entfernt:
df.reset_index()
Beide Ebenen des MultiIndex wurden in normale DataFrame-Spalten überführt, der Index selbst ist wieder der ganzzahlige Standardindex.
Mit dem Parameter level kannst du gezielt bestimmte Ebenen aus dem Index entfernen. Diese werden dann zu normalen Spalten – es sei denn, du verwirfst sie vollständig mit dem Parameter drop. Beispiel:
df.reset_index(level=["Aircraft Model"])
Wie zu sehen ist, ist "Aircraft Model" jetzt eine normale Spalte. Nur "Operating Airline IATA Code" bleibt als Index erhalten.
Wenn diese Ebene nicht als Spalte übernommen werden soll, kannst du drop und level kombinieren, um sie komplett zu entfernen.
df.reset_index(level=["Aircraft Model"], drop=True)Der Index "Aircraft Model" wurde sowohl aus dem Index als auch aus dem DataFrame entfernt. Der andere Index, "Operating Airline IATA Code", bleibt als aktueller Index bestehen.
Wenn du zwei DataFrames mergst, ist der resultierende Index oft nicht mehr fortlaufend, wie im folgenden DataFrame zu sehen.
Setzen wir den Index des DataFrame mit der pandas-Methode reset_index() zurück.
df.reset_index()
Der Parameter drop steuert, ob der alte Index nach dem Zurücksetzen als Spalte im DataFrame erhalten bleibt oder vollständig entfernt wird. Standardmäßig (drop=False) bleibt er erhalten, wie in den bisherigen Beispielen. Mit drop=True entfernst du den alten Index vollständig.
df.reset_index(drop=True)
Ändere den DataFrame direkt mit dem Parameter inplace, um keinen neuen DataFrame zu erzeugen.
Angenommen, du hast folgenden DataFrame:
Setzt du inplace auf True, werden die Änderungen direkt am Original-DataFrame vorgenommen, ohne einen separaten zu erzeugen.
df_concat.reset_index(drop=True, inplace=True)
df_concat
Behandle doppelte Indizes, indem du den Index zurücksetzt und neu indizierst.
Angenommen, deine Daten enthalten doppelte Indizes.
Mit reset_index() sowie drop=True und inplace=True stellst du sicher, dass der resultierende DataFrame wieder einen lückenlosen, bei 0 beginnenden Index hat.
df.reset_index(drop=True, inplace=True)
inplace=False arbeitest, wenn du erwartest, dass der Original-DataFrame geändert wird. Ist inplace auf False gesetzt, wird ein neuer DataFrame zurückgegeben und das Original bleibt unverändert.drop um, um unbeabsichtigten Verlust von Indexinformationen zu vermeiden. Beim Droppen werden die aktuellen Indexwerte dauerhaft entfernt.Wenden wir das Gelernte an und sehen, wie nützlich das Zurücksetzen des Index ist, wenn fehlende Werte entfernt werden.
Unser Airline-Datensatz enthält keine fehlenden Werte, deshalb verwenden wir stattdessen das Dataset Netflix Movies and TV shows. Dort gibt es fehlende Werte – ideal, um reset_index() zu demonstrieren.
import pandas as pd
df = pd.read_csv("netflix_shows.csv")
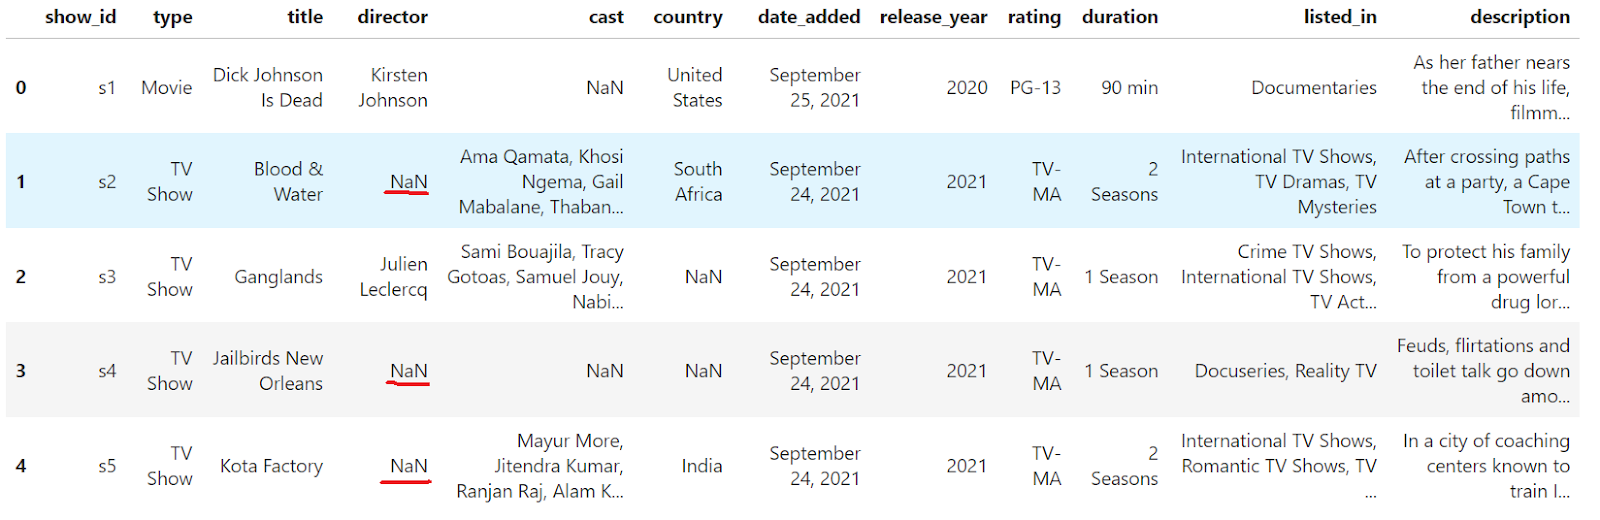
df.head()
Wie du siehst, gibt es fehlende Werte im DataFrame. Entferne Zeilen mit fehlenden Werten mit der Methode dropna().
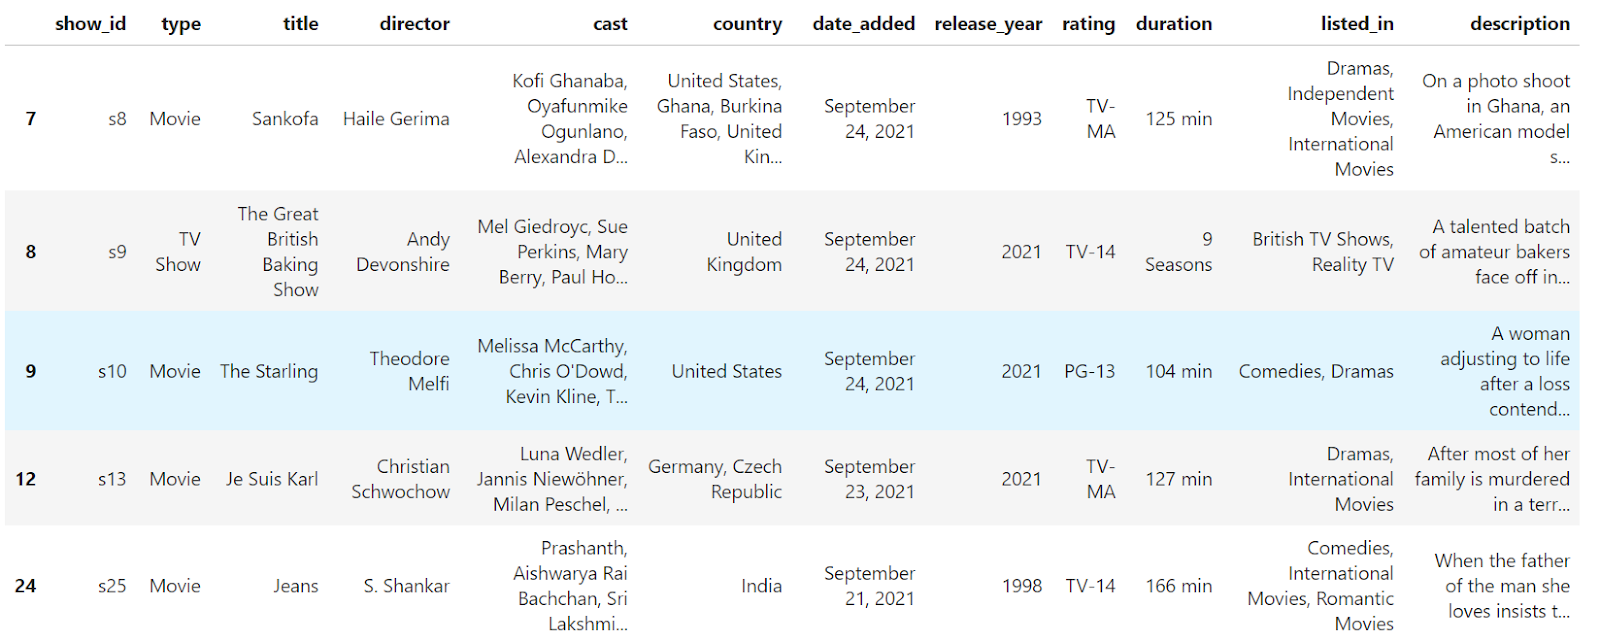
df.dropna(inplace=True)
df.head()
Die Zeilen mit NaN wurden entfernt. Der Index ist nun aber nicht mehr lückenlos (0, 1, 2, 4). Setzen wir ihn zurück:
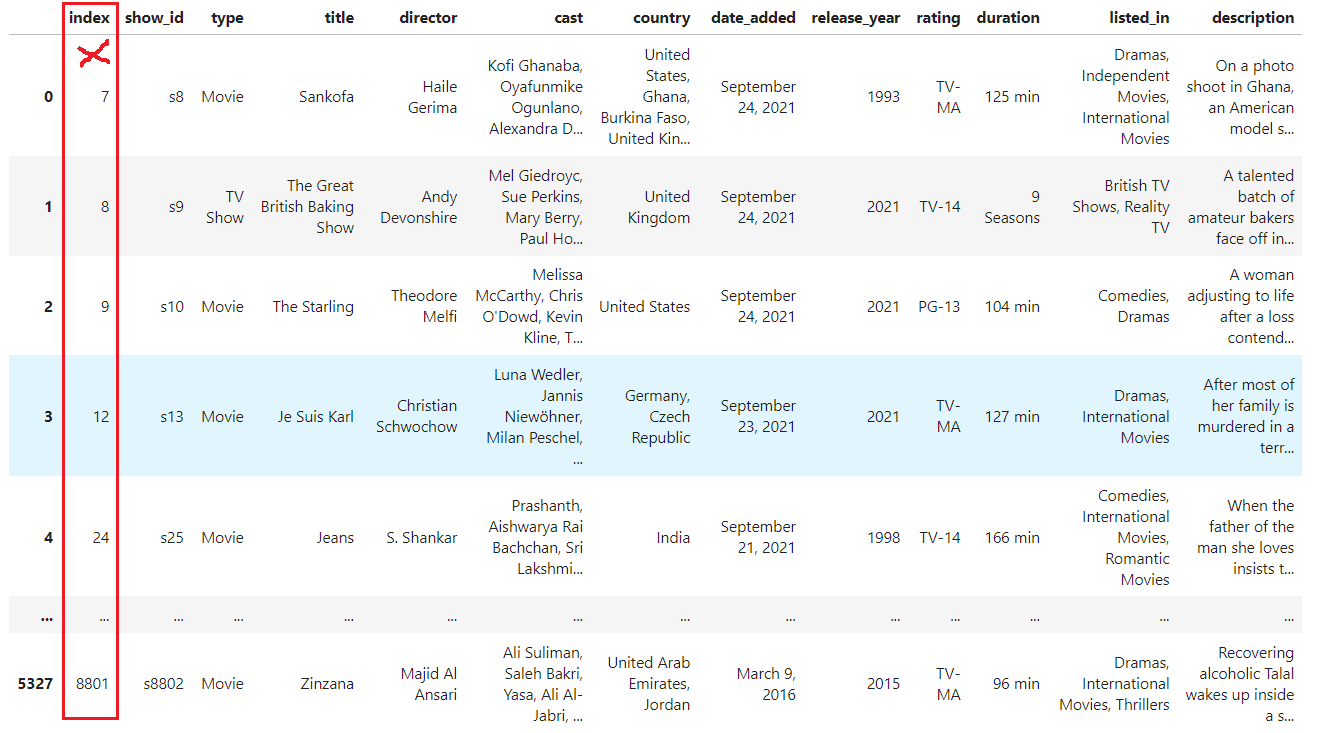
df.reset_index()
Jetzt ist der Index wieder lückenlos. Weil wir drop nicht angegeben haben, wurde der alte Index als Spalte mit dem Standardnamen index übernommen. Entfernen wir ihn vollständig:
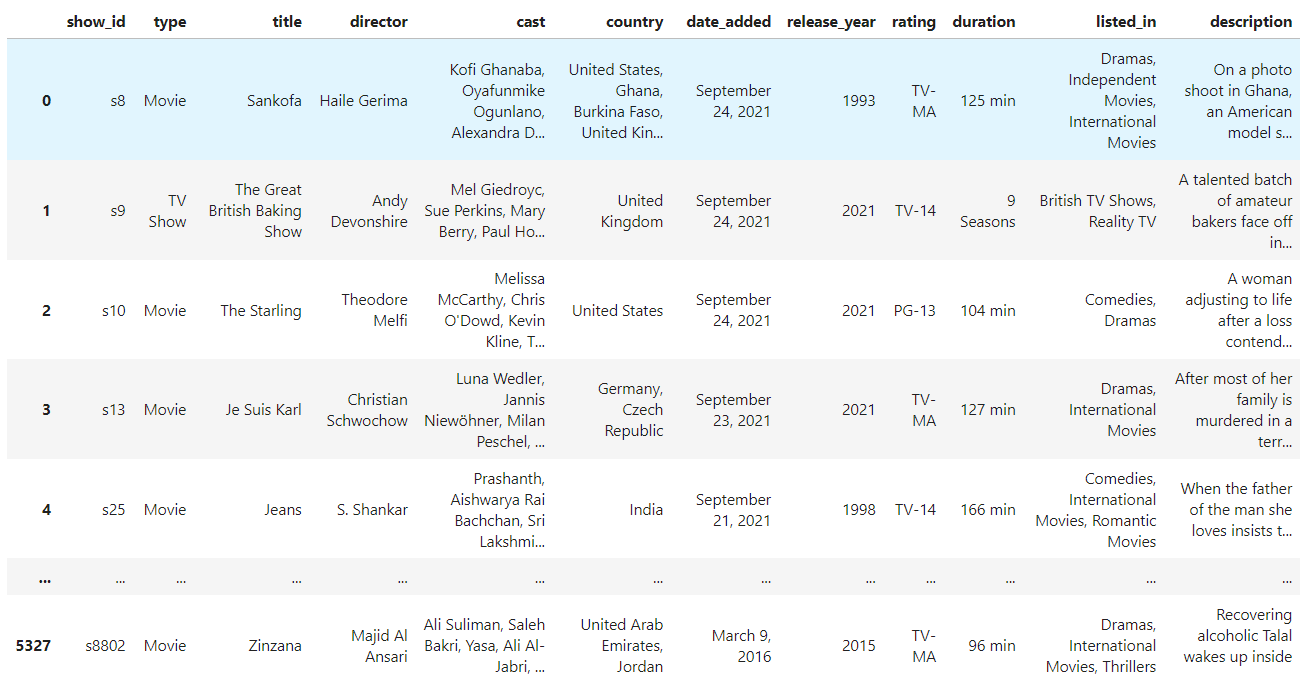
df.reset_index(drop=True)
Der alte, bedeutungslose Index ist vollständig entfernt, der aktuelle Index ist fortlaufend. Im letzten Schritt speichern wir die Änderung direkt im Original-DataFrame über den Parameter inplace:
df.reset_index(drop=True, inplace=True)Du hast gelernt, wie die Funktion reset_index in Pandas effizient mit DataFrame-Indizes umgeht. Ob gefilterte Daten, konkateniere DataFrames oder komplexes MultiIndexing – reset_index sorgt für einen aufgeräumten DataFrame. Die Parameter helfen dir, verschiedenste Index-Szenarien in der Datenmanipulation zu steuern.
Lerne weiter mit ähnlichen Funktionen wie reset_index im Data Analyst with Python Career Track von DataCamp. Wenn du mit Listen arbeitest, lies auch unser Python List Index() Tutorial, um die Funktion index() für Listen kennenzulernen.
Top pandas Courses
Kurs
Kurs
Kurs
Tutorial
Sejal Jaiswal
6 Min.
Tutorial
Aditya Sharma
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
DataCamp Team
2 Min.
Tutorial
Aditya Sharma
7 Min.
Tutorial
DataCamp Team
5 Min.


