Kurs
pandas ile Veri İşleme
4 sa
567.9K
Büyük bir veri kümesini dönüştürüp filtreledikten sonra, tam da ihtiyacınız olan DataFrame’e ulaşmış olabilirsiniz. Ancak bu DataFrame, sıralı olmayabilen orijinal indeksi korur. Bu gibi durumlarda DataFrame’in indeksini sıfırlamanız gerekir.
Bu eğitimde, bir DataFrame’in indeksini sıfırlamak için kullanılan pandas reset_index() yöntemini ele alacağız. Bu yöntemle sunulan farklı seçenekleri inceleyeceğiz. Ayrıca, basit ve çok seviyeli DataFrame’lerde indeksin nasıl sıfırlanacağını da anlatacağız.
DataFrame indeksini sıfırlama alıştırmaları için bir havayolu veri kümesi kullanacağız. Bu eğitimi takip etmek için mükemmel bir araç olan, özellikle Python’da veri analizi için tasarlanmış etkileşimli bir ortam olan DataCamp’in Datalab’ını kullanacağız.
Pandas’taki reset_index yöntemi, bir DataFrame’in indeksini varsayılan indekse sıfırlar. Filtreleme, birleştirme veya bir araya getirme gibi işlemlerden sonra indeks sıralı olmayabilir. Bu yöntem, temiz ve sıralı bir indeksi yeniden kurmaya yardımcı olur. DataFrame bir MultiIndex’e sahipse bir veya daha fazla seviyeyi kaldırabilir.
Temel sözdizimi:
df.reset_index(level=None, drop=False, inplace=False, col_level=0, col_fill="")Parametreler:
Döndürür:
Yeni indeksli bir DataFrame veya inplace=True ise None.
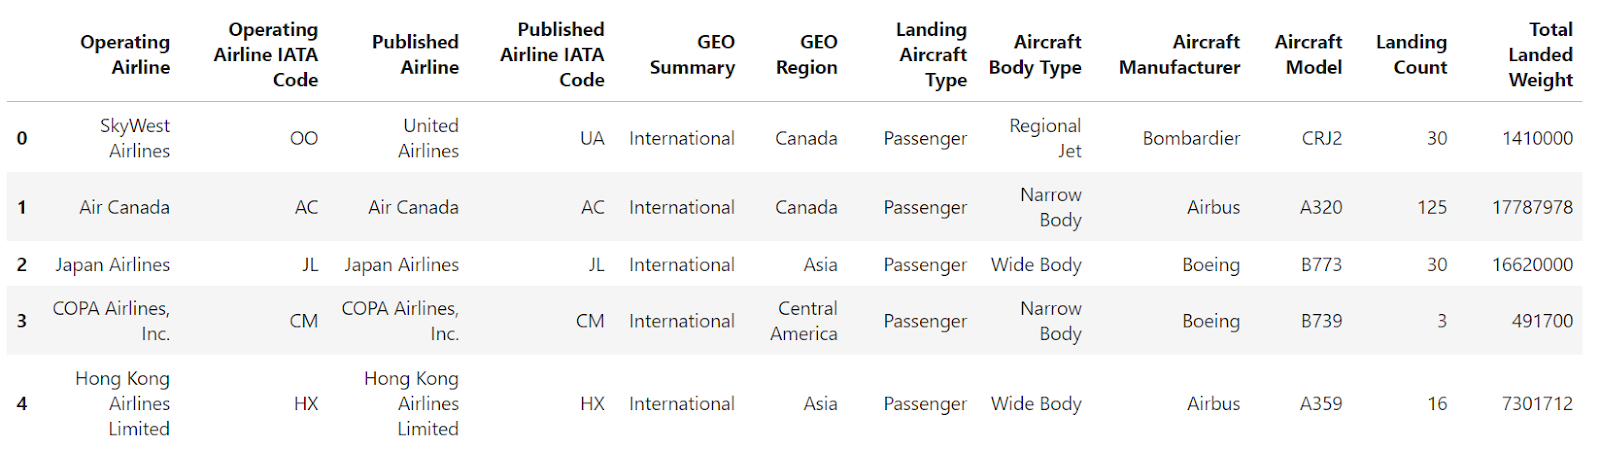
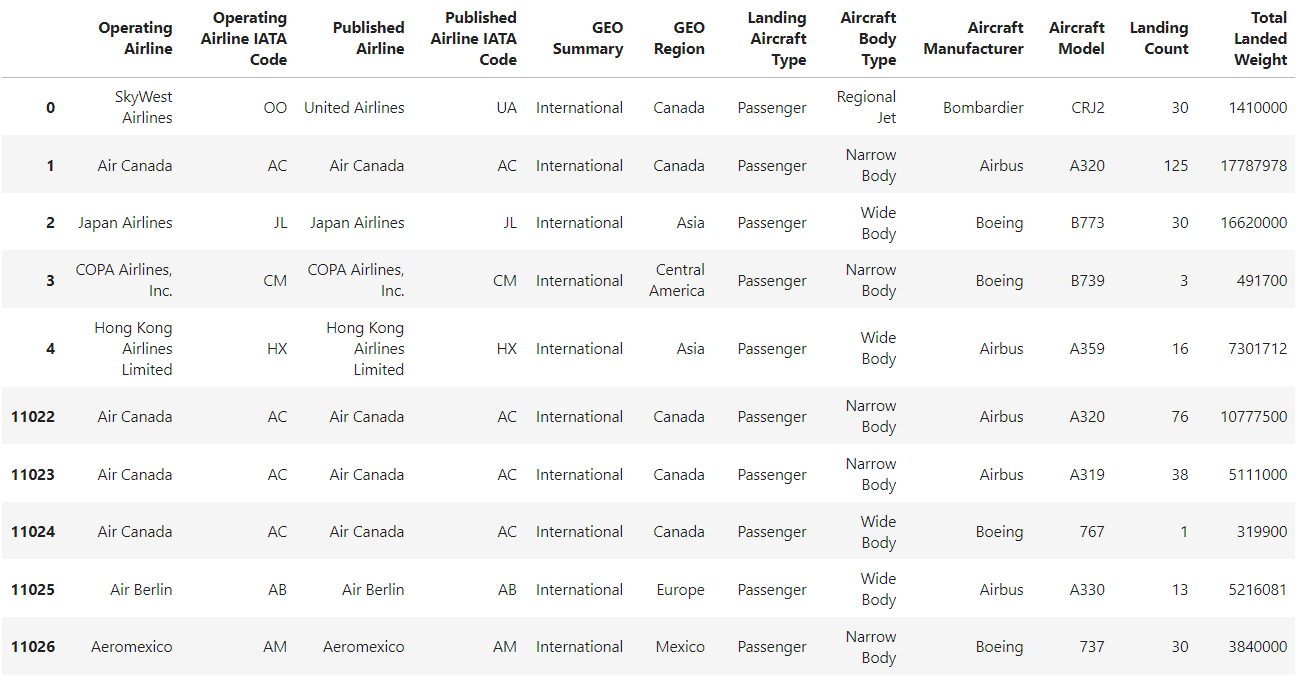
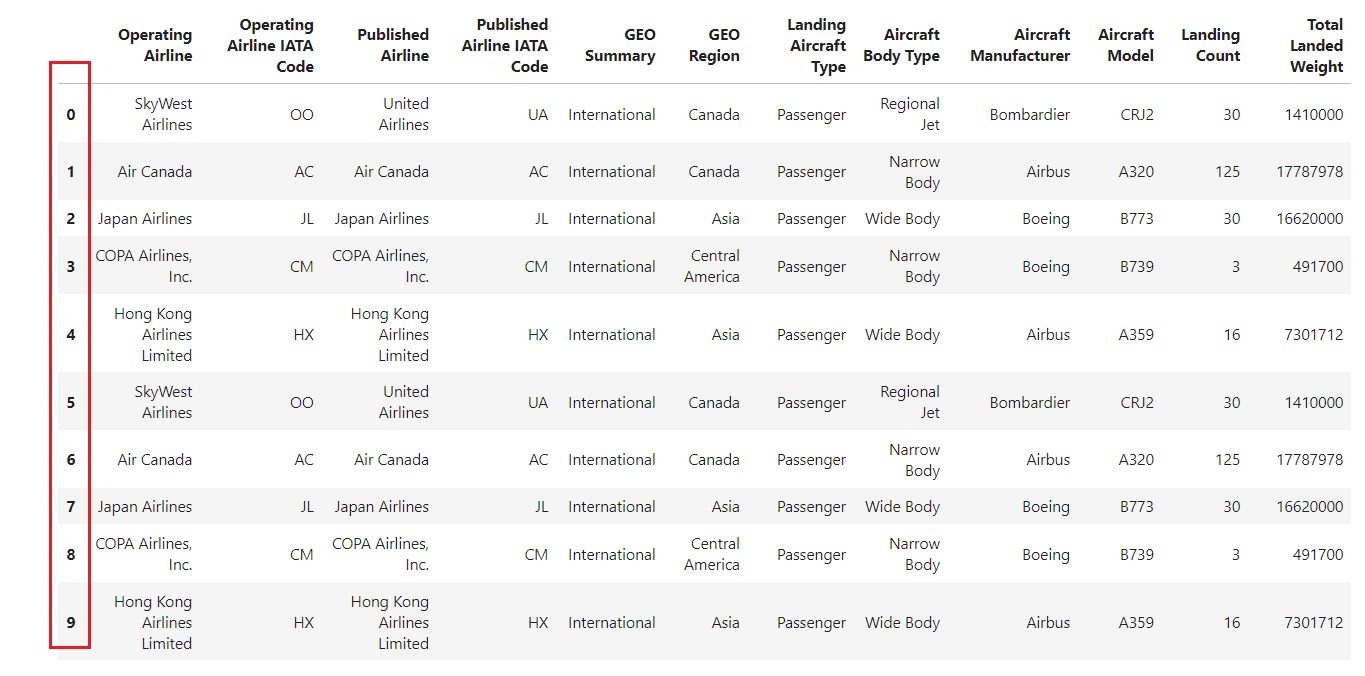
Pandas read_csv() yöntemini bir indeks belirtmeden kullanarak bir CSV dosyası okursanız, elde edilen DataFrame 0’dan başlayıp her satırda 1 artan, varsayılan tamsayı tabanlı bir indekse sahip olur.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df
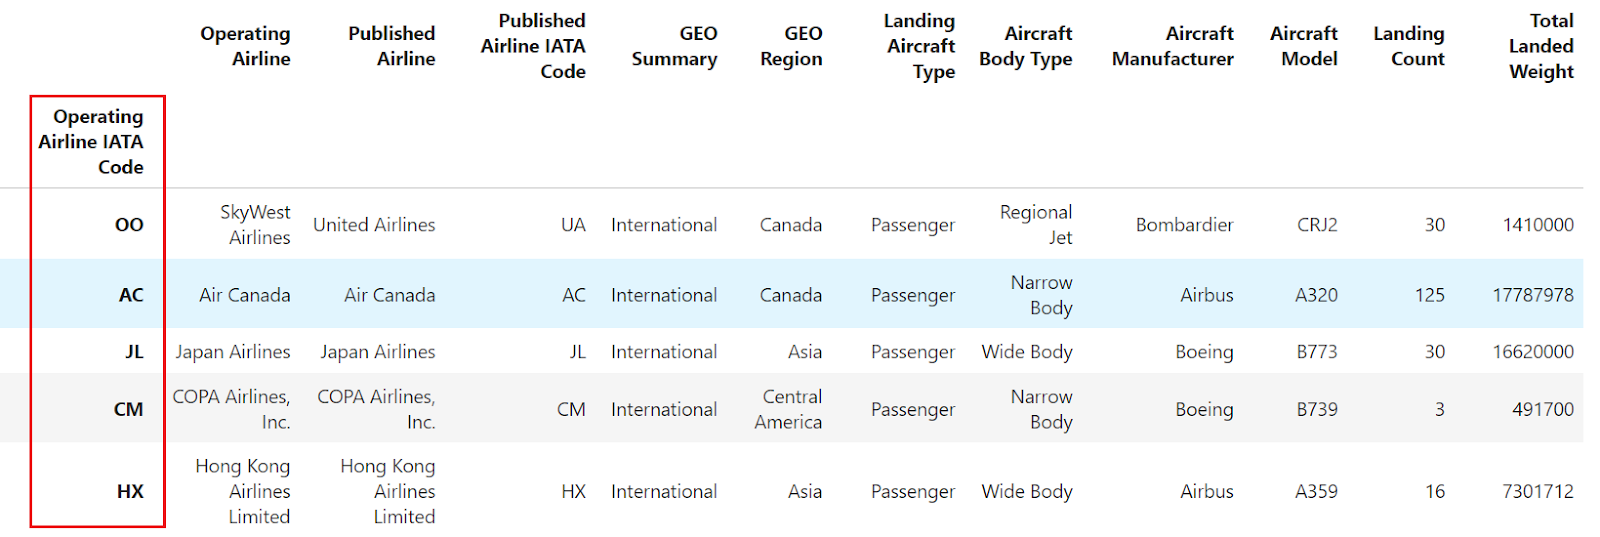
Bazı durumlarda daha açıklayıcı satır etiketlerini tercih edebilirsiniz. Bunu sağlamak için, DataFrame’in sütunlarından birini indeksi (satır etiketleri) olarak ayarlayabilirsiniz. CSV dosyasından veri yüklemek için read_csv() yöntemini kullanırken, index_col parametresiyle indeks için istenen sütunu belirtin.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv", index_col="Operating Airline IATA Code").head()
df
Alternatif olarak, bir DataFrame’in herhangi bir sütununu indeks olarak ayarlamak için set_index() yöntemini kullanabilirsiniz:
import pandas as pd
df = pd.read_csv("airlines_dataset.csv").head()
df.set_index("Operating Airline IATA Code", inplace=True)
df
Bu kod parçasının orijinal DataFrame üzerinde değişiklik yapacağını unutmayın.
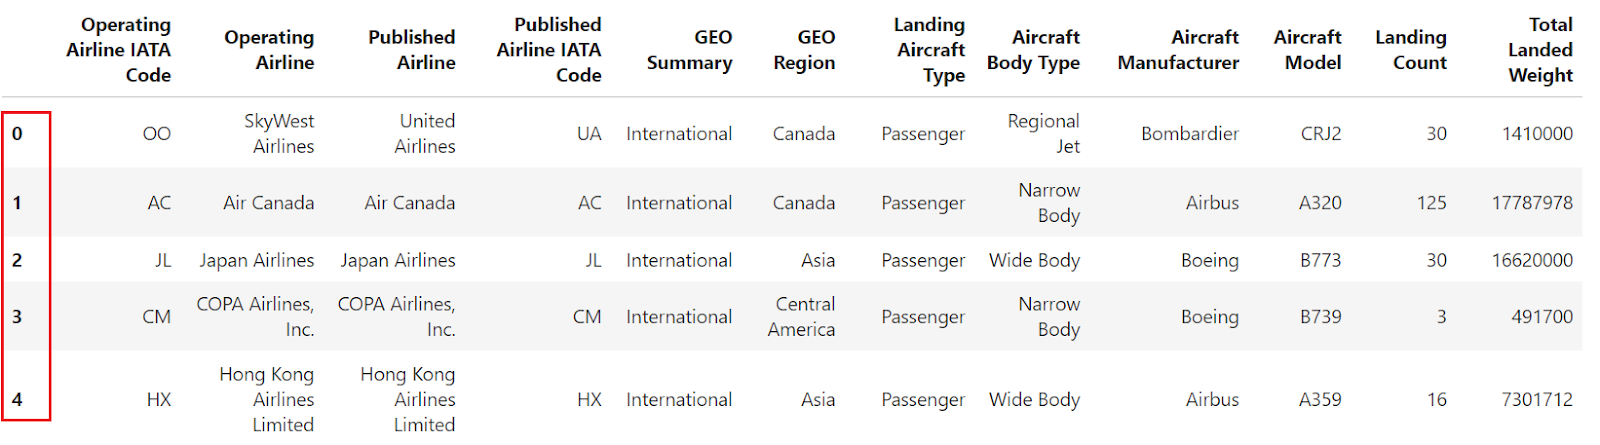
Peki varsayılan sayısal indeksi geri yüklemeniz gerekirse? İşte bu noktada pandas’ın reset_index() yöntemi devreye girer.
df.reset_index()
Örnek, 'Operating Airline IATA Code' sütunu indeks olarak ayarlandıktan sonra, DataFrame’i varsayılan tamsayı indeksine döndürmek için reset_index kullanıldığını gösterir.
Pandas’taki reset_index() yöntemi, filtrelenmiş veri kümeleri, birleştirilmiş DataFrame’ler veya çok seviyeli indekslerle çalışırken DataFrame indekslerini yeniden düzenlemek için güçlü bir araçtır.
DataFrame’leri genişten uzuna dönüştürme, satır ve sütunları stack/unstack etme ve çoklu indeksli DataFrame’lerle çalışma hakkında daha fazla bilgi edinmek için DataFrame’leri yeniden şekillendirme konulu çevrimiçi kursumuzu inceleyin.
Bir DataFrame’i filtrelediğinizde, orijinal indeks korunur. reset_index kullanarak filtrelenmiş DataFrame’i yeniden indeksleyebilirsiniz.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
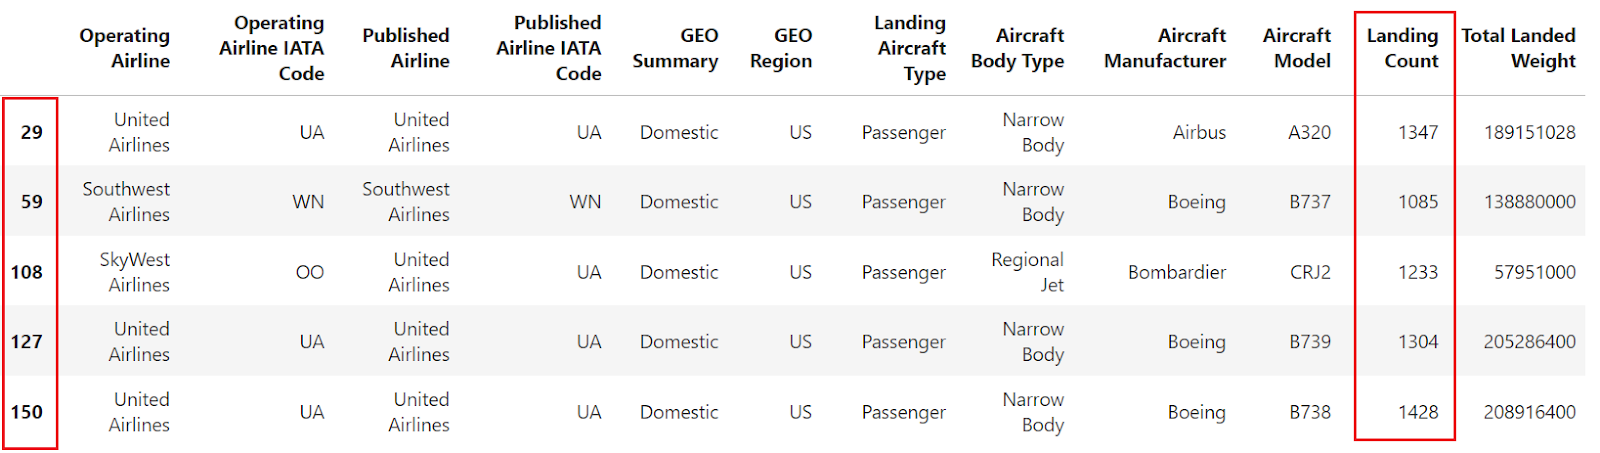
Verileri, "landing count" değerinin 1000’den büyük olduğu satırları seçmek için filtreleyelim. Filtrelemeden sonra indeksler sıralı olmayabilir. Ardından, filtrelenen DataFrame’in indeksini sıfırlamak için reset_index yöntemini kullanabilirsiniz.
filtered_df = df[df["Landing Count"] > 1000].head()
filtered_df
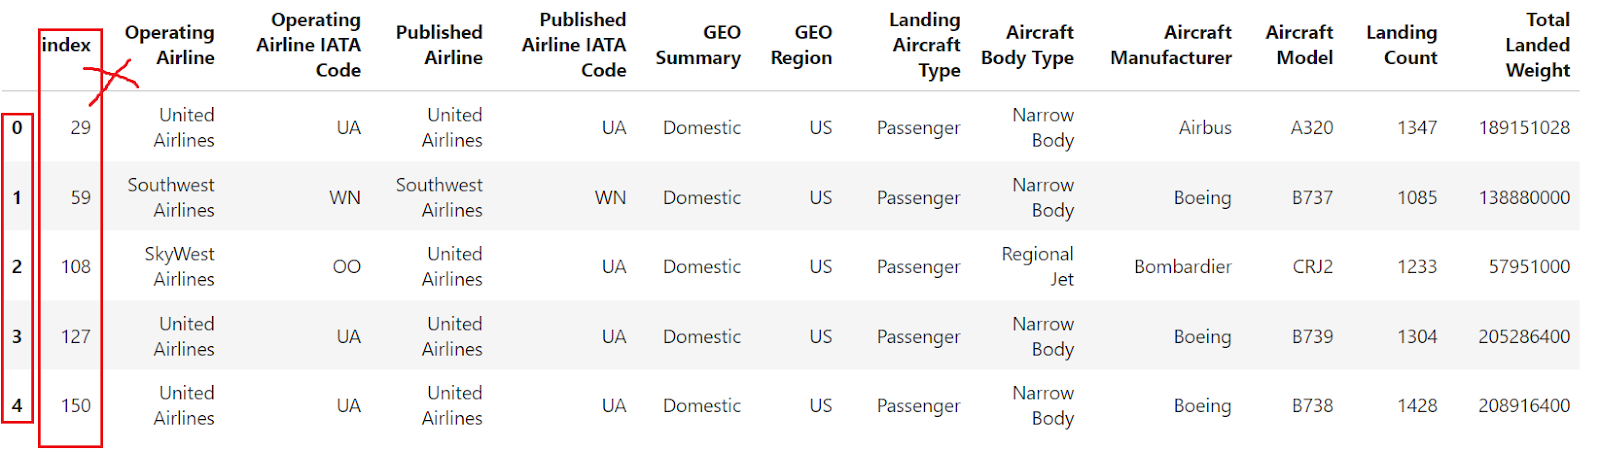
Yukarıdaki görsel, DataFrame’in uygulanan koşula göre filtrelendiğini ancak indeksin sıralı olmadığını gösteriyor. Şimdi, filtrelenen DataFrame’i yeniden indekslemek ve sıralı bir indeks sağlamak için reset_index kullanalım. Bunu şu şekilde yapabilirsiniz:
filtered_df_reset = filtered_df.reset_index()
filtered_df_reset
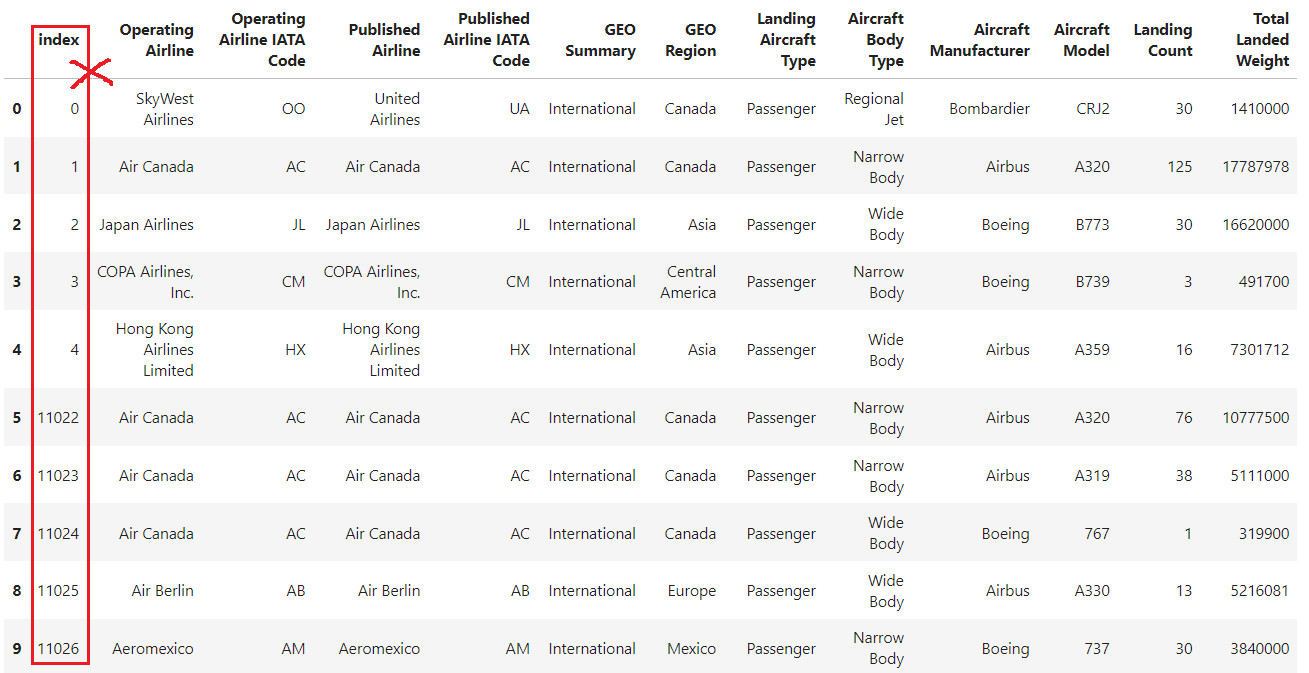
Bu yöntemin varsayılan davranışı, mevcut DataFrame indeksini varsayılan tamsayı tabanlı bir indeksle değiştirmek ve eski indeksi aynı adla (veya adsız ise "index") yeni bir sütuna dönüştürmektir.
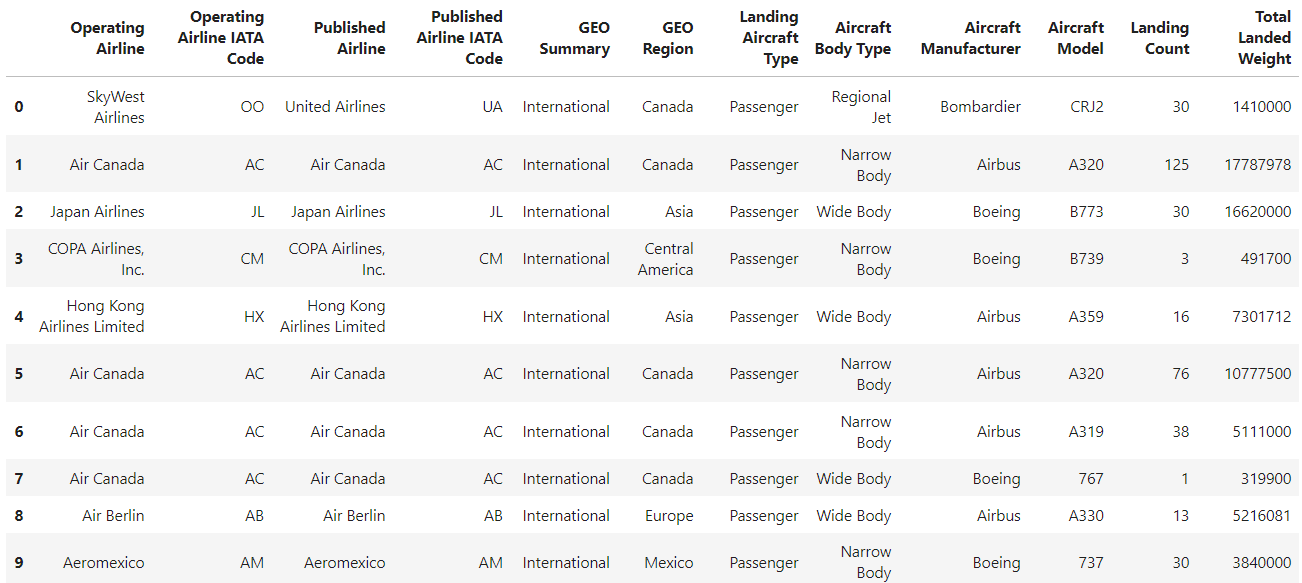
Bu nedenle, eski indeksin yeni bir sütun olarak eklenmemesini sağlayan drop=True parametresini kullanın.
filtered_df_reset = filtered_df.reset_index(drop=True)
filtered_df_reset
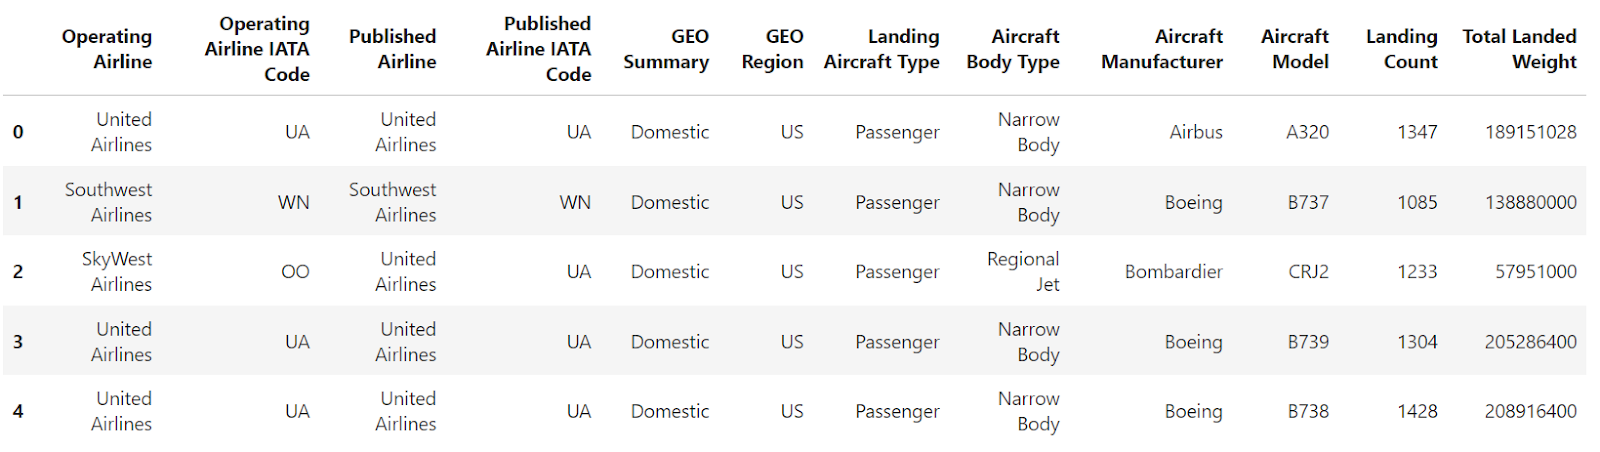
Harika! İndeksler artık varsayılan tamsayı indeksine (0, 1, 2, …) sıfırlandı ve temiz, sıralı bir yapı elde edildi.
DataFrame’leri birleştirirken, ortaya çıkan DataFrame yinelenen veya sıralı olmayan indeksler içerebilir. İndeksi sıfırlamak, temiz ve sıralı bir indeks oluşturur.
Diyelim ki iki DataFrame’iniz var ve bunları birleştirmek istiyorsunuz. Gösterim amacıyla havayolu veri setinden iki DataFrame oluşturdum.
import pandas as pd
df = pd.read_csv("airlines_dataset.csv")
split_index = int(df.shape[0] / 2)
df1 = df[:split_index].head()
df2 = df[split_index:].head()
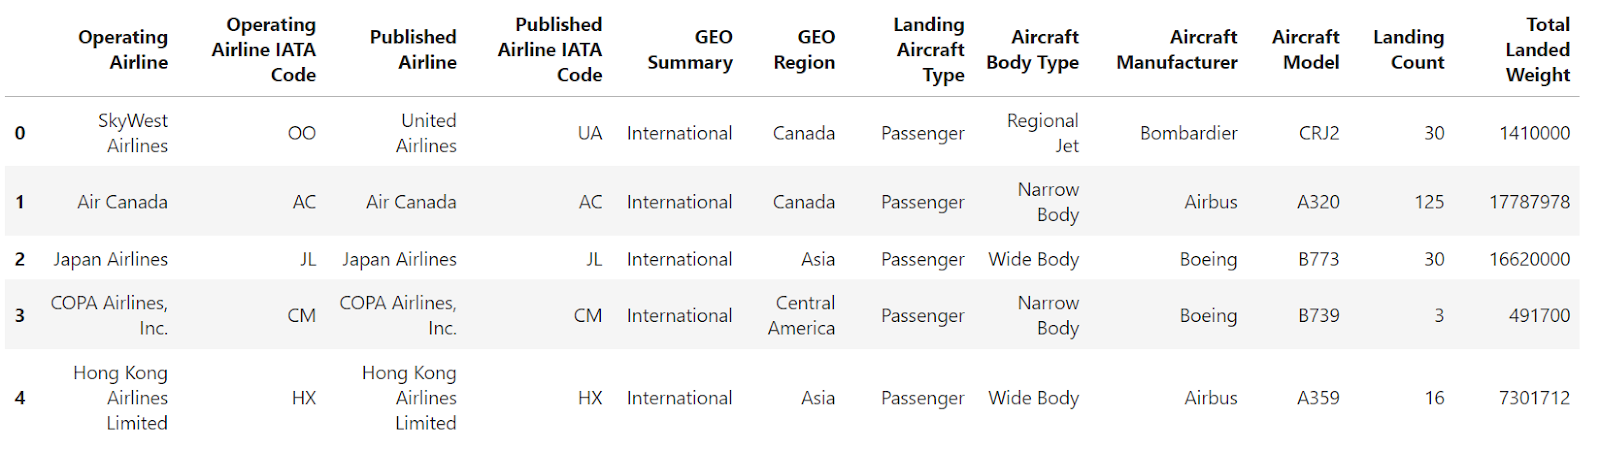
df1 şu şekilde:
df2 şu şekilde:
DataFrame’leri, yani df1 ve df2, birleştirelim.
df_concat = pd.concat([df1, df2])
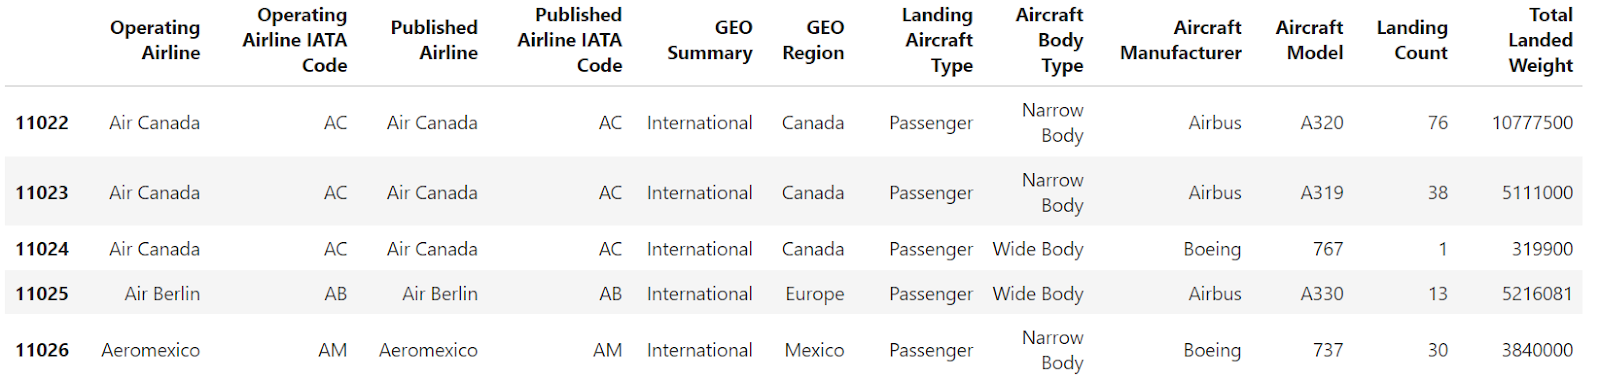
Veriler sıralı olmayan indeksler gösteriyor. Birleştirilmiş DataFrame’in indeksini sıralı hale getirmek için sıfırlamamız gerekiyor.
DataFrame’in indeksini pandas’taki reset_index() yöntemiyle sıfırlayalım.
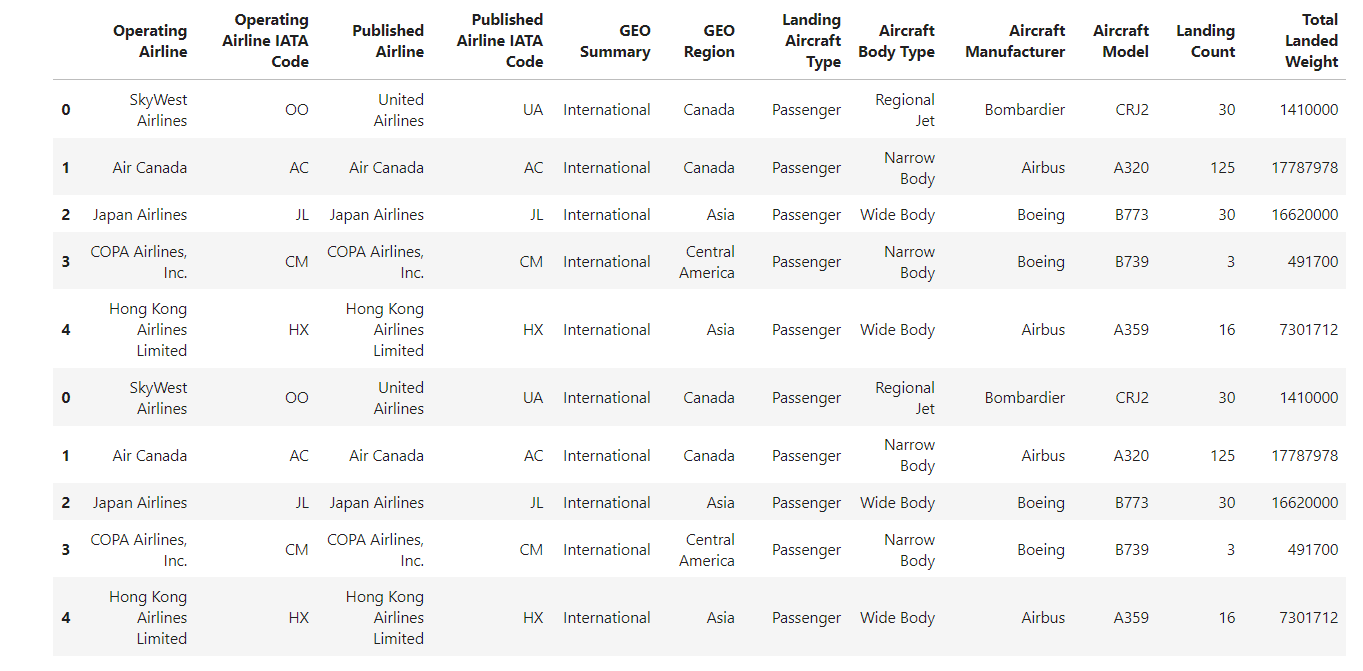
df_concat.reset_index()
İşte DataFrame’in indeksi sıfırlandıktan sonraki sonuç. reset_index yöntemi eski indeksi yeni bir sütuna dönüştürür. Bu ekstra sütunu kaldırmak için drop=True parametresini kullanmanız gerekir.
df_concat.reset_index(drop=True)
Hiyerarşik (çok seviyeli) indekslemeye sahip DataFrame’ler için, reset_index, çok seviyeli indeksi sütunlara dönüştürerek DataFrame’i basitleştirmek için kullanılabilir.
Çok seviyeli indekse sahip bir DataFrame örneğine bakalım.
import pandas as pd
df = pd.read_csv(
    "airlines_dataset.csv", index_col=["Aircraft Model", "Operating Airline IATA Code"]
).head()
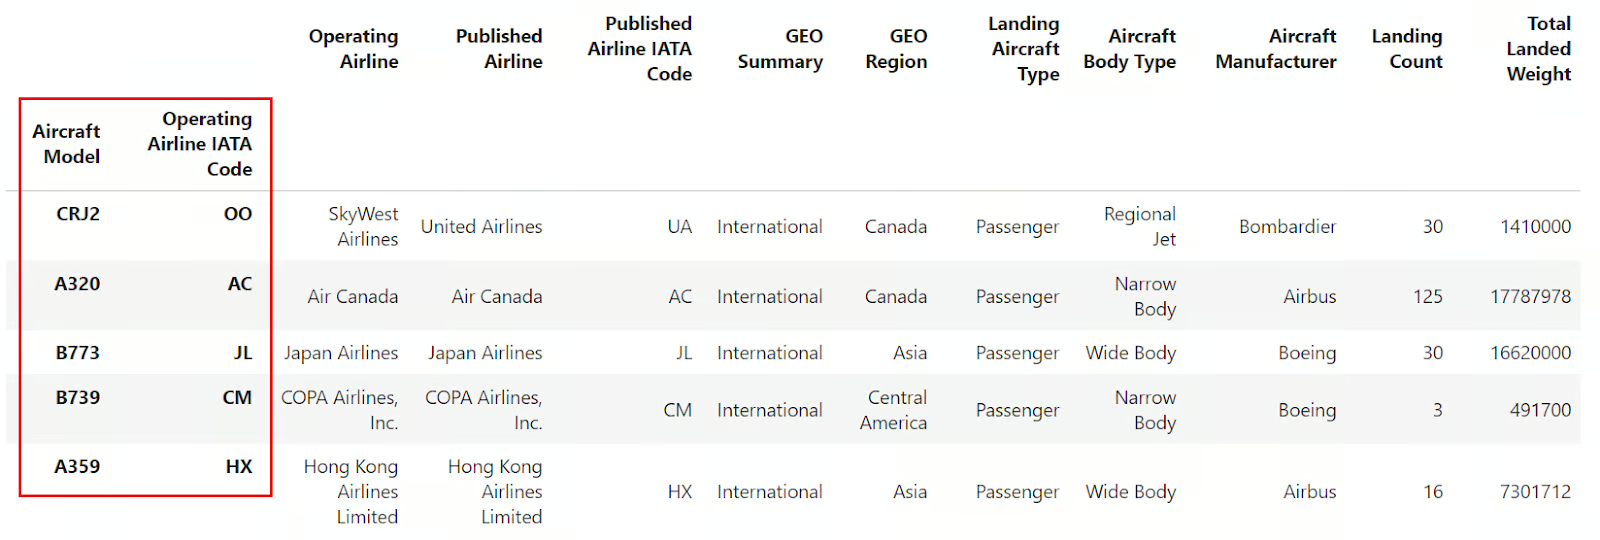
İndeksine bakarsanız, bunun yaygın bir DataFrame indeksi değil bir MultiIndex nesnesi olduğunu görürsünüz
Şimdi pandas’ın, MultiIndex’in tüm seviyelerini kaldıran reset_index() yöntemini kullanalım:
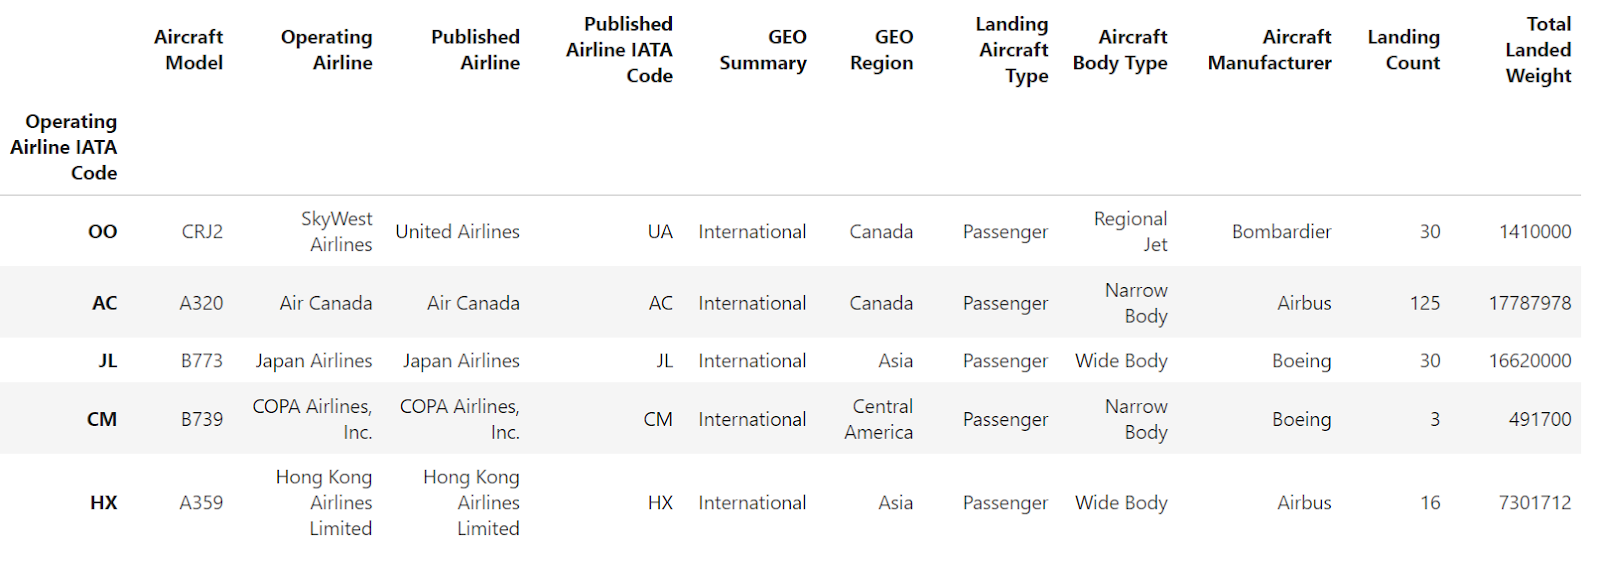
df.reset_index()
Gördüğünüz gibi, MultiIndex’in her iki seviyesi de normal DataFrame sütunlarına dönüştürülürken indeks varsayılan tamsayı tabanlı olana sıfırlandı.
Ayrıca, DataFrame indeksinden seçili seviyeleri kaldırmak için level parametresini de kullanabilirsiniz. Bu, seçilen seviyeleri, drop parametresini kullanarak bu bilgiyi DataFrame’den tamamen atmıyorsanız, normal DataFrame sütunlarına dönüştürür. Bakalım:
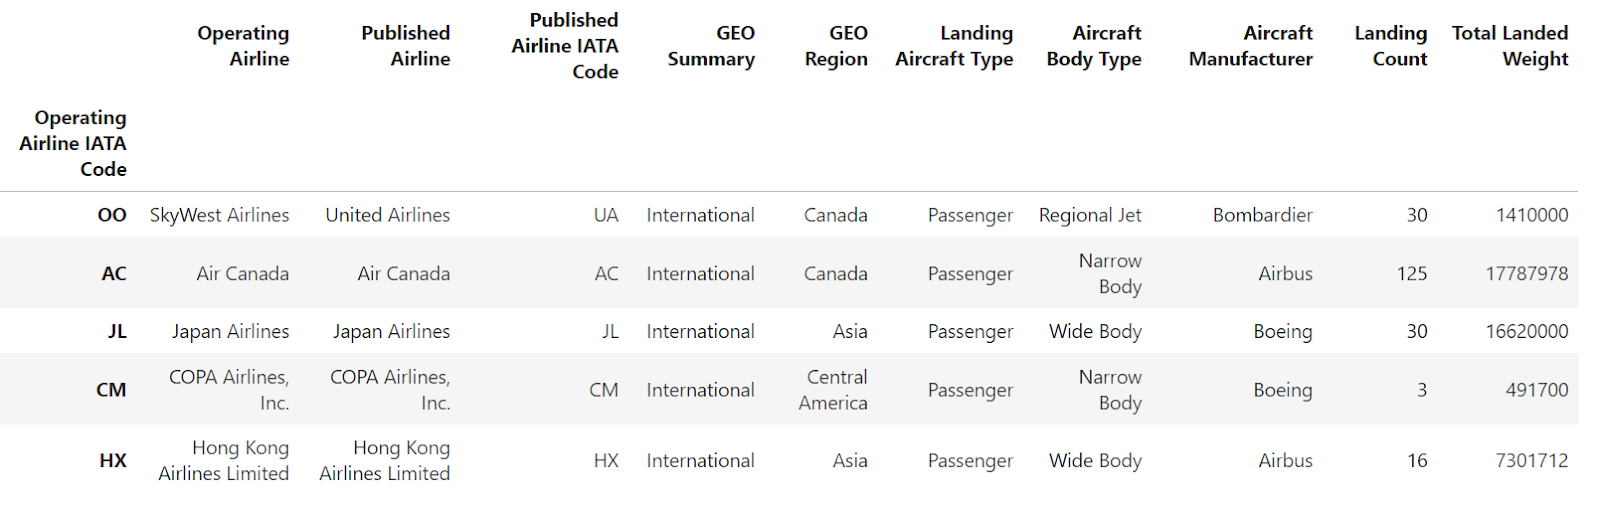
df.reset_index(level=["Aircraft Model"])
Yukarıdaki görsel, "Aircraft Model"in artık DataFrame’de normal bir sütun olduğunu gösteriyor. Sadece "Operating Airline IATA Code" indeks olarak kaldı.
Şimdi, listede belirtilen indeksin normal bir sütun olmasını istemiyorsanız, onu DataFrame’den atmak için drop ve level parametrelerini birlikte kullanabilirsiniz.
df.reset_index(level=["Aircraft Model"], drop=True)
'Aircraft Model' indeksten ve DataFrame’den kaldırıldı. Diğer indeks olan 'Operating Airline IATA Code', DataFrame’in geçerli indeksi olarak korundu.
İki DataFrame’i birleştirdiğinizi varsayalım; ortaya çıkan birleştirilmiş DataFrame, aşağıdaki DataFrame’de gösterildiği gibi artık sıralı indekslere sahip olmayacaktır.
DataFrame’in indeksini pandas’ın reset_index() yöntemiyle sıfırlayalım.
df.reset_index()
drop, indeksi sıfırladıktan sonra eski indeksin DataFrame’de bir sütun olarak tutulup tutulmayacağını veya tamamen atılıp atılmayacağını belirler. Varsayılan olarak (drop=False), önceki tüm örneklerde gösterildiği gibi eski indeks korunur. Alternatif olarak drop=True ayarı, indeksi sıfırladıktan sonra eski indeksi DataFrame’den kaldırır.
df.reset_index(drop=True)
Yeni bir DataFrame oluşturmaktan kaçınmak için inplace parametresini kullanarak DataFrame’i yerinde değiştirin.
Aşağıdaki DataFrame’e sahip olduğunuzu varsayalım:
inplace parametresini True olarak ayarlamak, değişikliklerin doğrudan orijinal DataFrame’e uygulanmasını ve ayrı bir DataFrame oluşturulmamasını sağlar.
df_concat.reset_index(drop=True, inplace=True)
df_concat
Yinelenen indeksleri, sıfırlayıp yeniden indeksleyerek doğru şekilde yönetin.
Yinelenen indekslere sahip verileriniz olduğunu varsayalım.
drop=True ve inplace=True ile birlikte reset_index() kullanmak, ortaya çıkan DataFrame’in 0’dan başlayıp sıralı şekilde artan kesintisiz indekslere sahip olmasını sağlar.
df.reset_index(drop=True, inplace=True)
inplace=False kullanmadığınızdan emin olun. inplace False ise yeni bir DataFrame döndürülür ve orijinal DataFrame değişmeden kalır.drop parametresine dikkat edin. İndeksin düşürülmesi, mevcut indeks değerlerini kalıcı olarak kaldırır.Öğrendiğimiz DataFrame indeksini sıfırlama yöntemlerini uygulayalım ve eksik değerleri düşürürken indeks sıfırlamanın nasıl faydalı olabileceğini görelim.
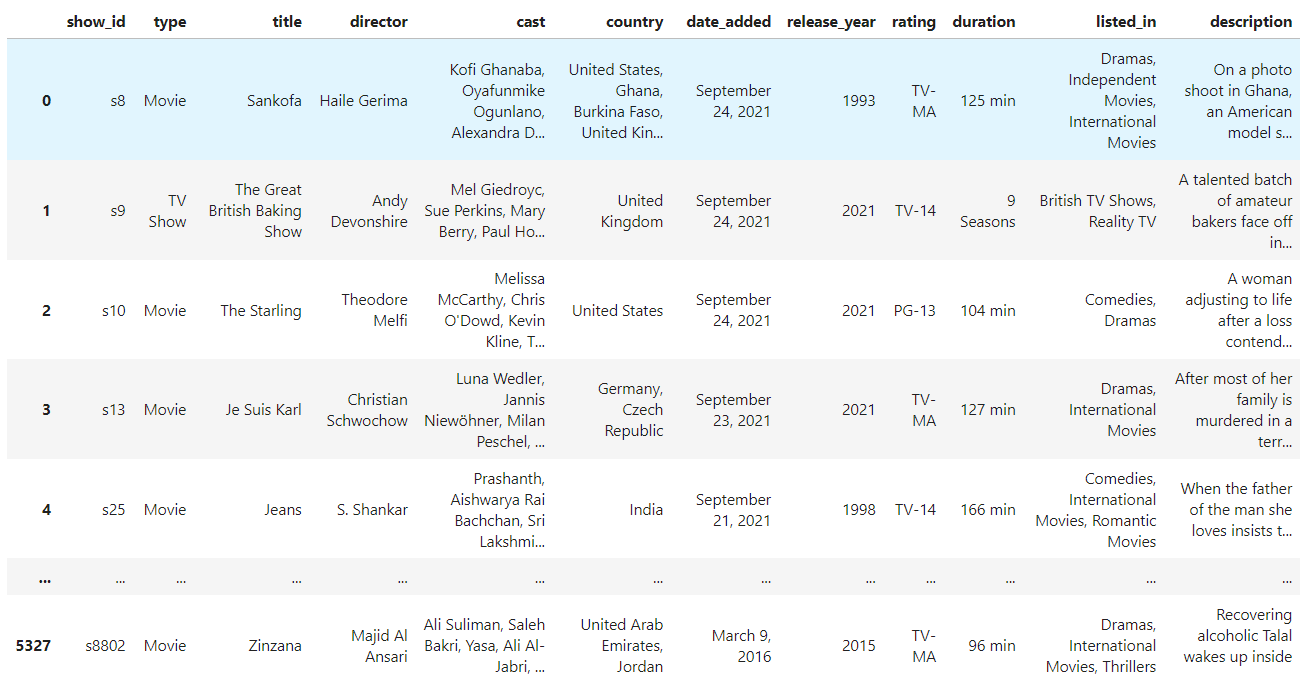
Havayolu veri kümemizde eksik değer yok, bu yüzden bunun yerine Netflix Filmleri ve TV programları veri setini kullanalım. Eksik değerler içerir ve reset_index() için ideal bir örnektir.
import pandas as pd
df = pd.read_csv("netflix_shows.csv")
df.head()
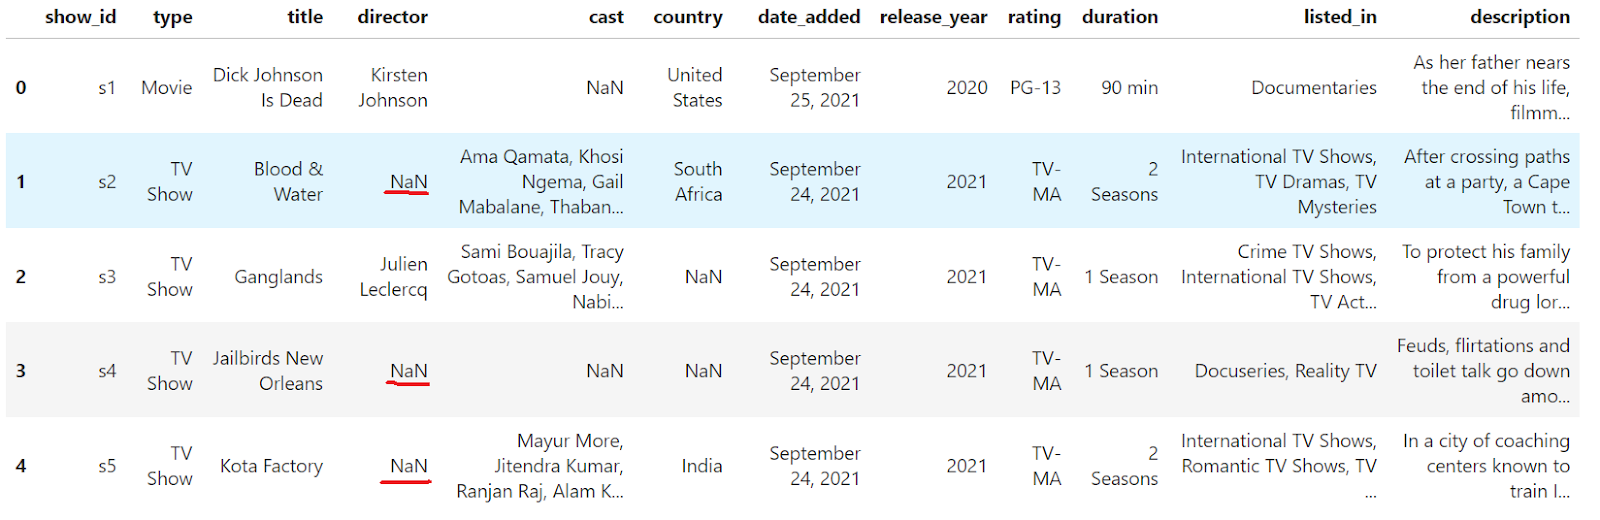
DataFrame’de eksik değerler olduğunu görebilirsiniz. dropna() yöntemiyle eksik değer içeren satırları düşürün.
df.dropna(inplace=True)
df.head()
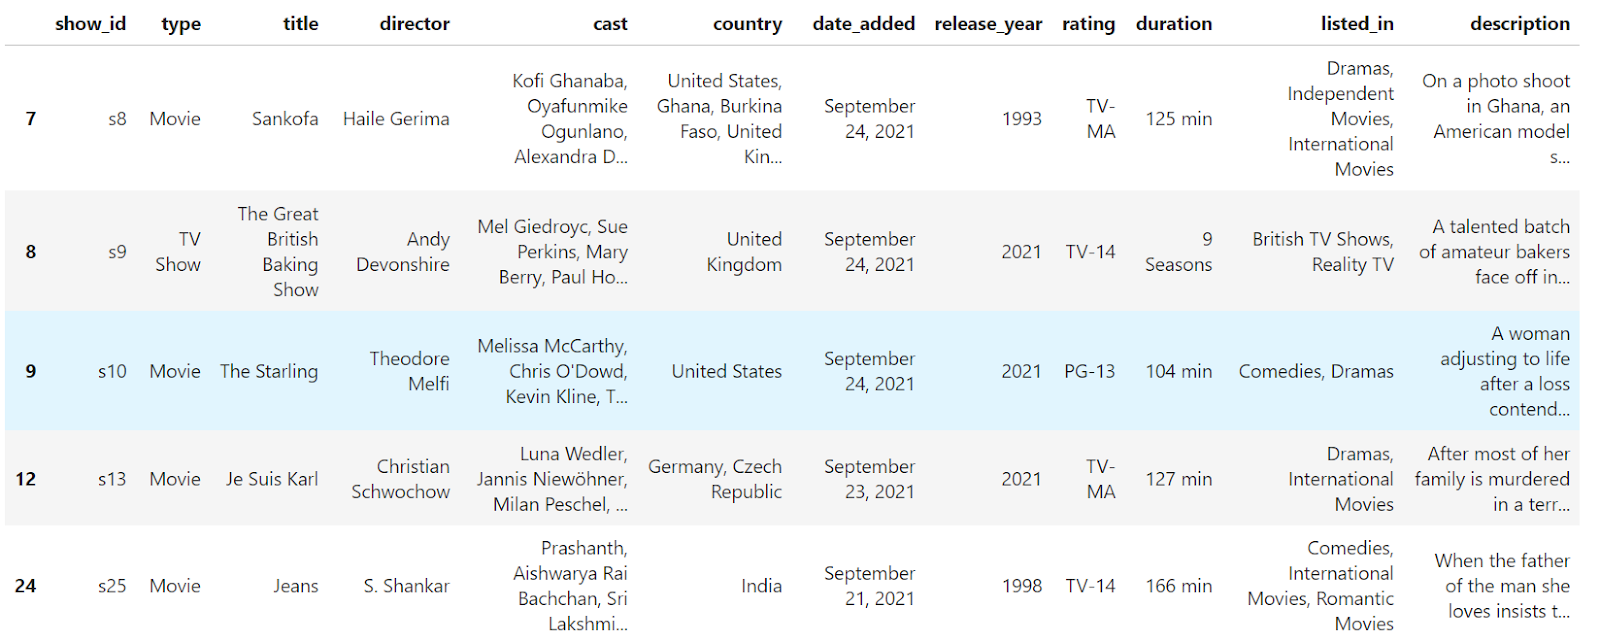
NaN değerleri içeren satırlar DataFrame’den kaldırıldı. Ancak indeks artık kesintisiz değil (0, 1, 2, 4). Bunu sıfırlayalım:
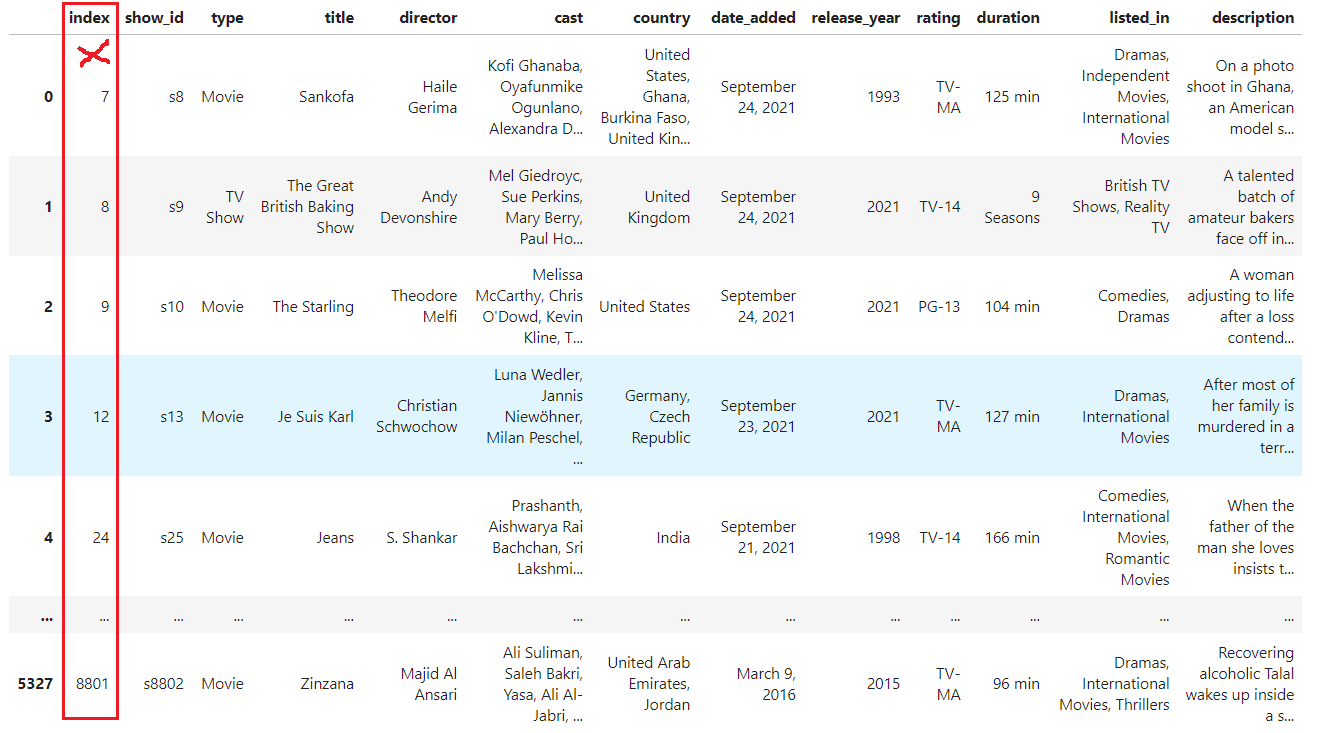
df.reset_index()
Artık indeks kesintisiz; ancak drop parametresini açıkça geçmediğimiz için eski indeks varsayılan adıyla bir sütuna dönüştürüldü: index. Eski indeksi DataFrame’den tamamen kaldıralım:
df.reset_index(drop=True)
Anlamsız eski indeksi tamamen kaldırdık ve geçerli indeks artık kesintisiz. Son adım, bu değişiklikleri orijinal DataFrame’imize inplace parametresiyle kaydetmektir:
df.reset_index(drop=True, inplace=True) reset_index işlevinin Pandas’da DataFrame indekslerini nasıl verimli yönettiğini öğrendiniz. İster filtrelenmiş verilerle, ister birleştirilmiş DataFrame’lerle, ister karmaşık çok seviyeli indekslerle çalışın, reset_index temiz ve düzenli bir DataFrame sağlar. Parametreleri, veri işleme görevlerinde farklı indeksleme senaryolarını yönetmenize yardımcı olur.
reset_index benzeri işlevleri kullanmayı öğrenmeye DataCamp’in Python ile Veri Analisti kariyer yoluyla devam edin. Ayrıca listelerle çalışıyor ve listelerdeki index() işlevini öğrenmek istiyorsanız Python List Index() Eğitimi makalemizi de okuyabilirsiniz.
En iyi pandas Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




