
Last chance! 50% off DataCamp Premium
Sale ends in
हाइपरपैरामीटर को ऐसे समझें जैसे किसी एल्गोरिद्म के सेटिंग्स, जिन्हें आप प्रदर्शन बेहतर करने के लिए समायोजित कर सकते हैं, ठीक वैसे ही जैसे आप एएम रेडियो के नॉब घुमाकर स्पष्ट सिग्नल लेते हैं। किसी मशीन लर्निंग मॉडल को बनाते समय, आपको मॉडल आर्किटेक्चर तय करने के लिए विकल्प मिलते हैं। अक्सर, आपको तुरंत यह नहीं पता होता कि किसी दिए गए मॉडल के लिए इष्टतम आर्किटेक्चर क्या होना चाहिए, इसलिए आप संभावनाओं की एक रेंज को एक्सप्लोर करना चाहेंगे। सच्चे मशीन लर्निंग अंदाज़ में, आदर्श रूप से आप मशीन से ही यह एक्सप्लोरेशन करवाना चाहेंगे और स्वचालित रूप से इष्टतम मॉडल आर्किटेक्चर चुनवाना चाहेंगे।
आप केस स्टडी सेक्शन में देखेंगे कि हाइपरपैरामीटर मानों के सही चुनाव से किसी मशीन लर्निंग मॉडल के प्रदर्शन पर क्या असर पड़ता है। इस सन्दर्भ में, सही मानों के सेट को चुनना आमतौर पर “हाइपरपैरामीटर ऑप्टिमाइज़ेशन” या “हाइपरपैरामीटर ट्यूनिंग” कहलाता है।
मॉडलों में कई हाइपरपैरामीटर हो सकते हैं और पैरामीटरों के सर्वश्रेष्ठ संयोजन को खोजना एक सर्च समस्या की तरह माना जा सकता है।
हालाँकि अब कई हाइपरपैरामीटर ऑप्टिमाइज़ेशन/ट्यूनिंग एल्गोरिद्म हैं, यह पोस्ट दो सरल रणनीतियों पर चर्चा करती है: 1. ग्रिड सर्च और 2. रैंडम सर्च।
ग्रिड सर्च हाइपरपैरामीटर ट्यूनिंग का एक तरीका है जो ग्रिड में निर्दिष्ट एल्गोरिद्म पैरामीटरों के हर संयोजन के लिए व्यवस्थित रूप से मॉडल बनाता और उसका मूल्यांकन करता है।
आइए निम्नलिखित उदाहरण पर विचार करें:
मान लीजिए, मशीन लर्निंग मॉडल X हाइपरपैरामीटर a1, a2 और a3 लेता है। ग्रिड सर्चिंग में, आप पहले a1, a2 और a3 के लिए मानों की रेंज परिभाषित करते हैं। आप इसे प्रत्येक हाइपरपैरामीटर के लिए मानों की एक array की तरह समझ सकते हैं। अब ग्रिड सर्च तकनीक X के कई संस्करण बनाएगी जिनमें आपके द्वारा पहले से परिभाषित हाइपरपैरामीटर (a1, a2 और a3) मानों के सभी संभावित संयोजन होंगे। हाइपरपैरामीटर मानों की इस रेंज को ग्रिड कहा जाता है।
मान लीजिए, आपने ग्रिड इस प्रकार परिभाषित किया:
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
ध्यान दें कि जिन हाइपरपैरामीटरों के लिए आप मानों की array परिभाषित कर रहे हैं, वे वैध होनी चाहिए, यानी यदि कोई हाइपरपैरामीटर केवल Integer मान लेता है तो आप उसे Floating मान नहीं दे सकते।
अब, ग्रिड सर्च आपके द्वारा परिभाषित ग्रिड के साथ X के कई संस्करण बनाना शुरू करेगा।
यह [0,10,105] संयोजन से शुरू करेगा, और [5,60,125] पर समाप्त करेगा। यह इनके बीच के सभी मध्यवर्ती संयोजनों से गुज़रेगा, जिससे ग्रिड सर्च अत्यधिक कम्प्यूटेशनल रूप से महँगा हो जाता है।
अब दूसरी खोज तकनीक रैंडम सर्च पर नज़र डालते हैं:
हाइपरपैरामीटर के रैंडम सर्च का विचार James Bergstra और Yoshua Bengio ने प्रस्तावित किया था। आप मूल शोध पत्र यहाँ देख सकते हैं।
रैंडम सर्च ग्रिड सर्च से भिन्न है। यहाँ आप प्रत्येक हाइपरपैरामीटर के लिए जाँचने हेतु एक विविक्त मान-समुच्चय नहीं देते; बल्कि, आप प्रत्येक हाइपरपैरामीटर के लिए एक सांख्यिकीय वितरण देते हैं, जिनसे मानों का यादृच्छिक सैंपल लिया जा सकता है।
आगे बढ़ने से पहले, समझते हैं कि वितरण और सैंपलिंग का क्या अर्थ है:
सांख्यिकी में, वितरण से तात्पर्य मूलतः किसी चर के मानों की ऐसी व्यवस्था से है जो उनके अवलोकित या सैद्धांतिक आवृत्ति-वितरण को दर्शाती है।
दूसरी ओर, सैंपलिंग सांख्यिकी में प्रयुक्त शब्द है। यह लक्ष्य आबादी से एक प्रतिनिधि सैंपल चुनने और उस सैंपल से डेटा एकत्र करने की प्रक्रिया है ताकि पूरी आबादी के बारे में कुछ समझा जा सके।
अब फिर से रैंडम सर्च की अवधारणा पर लौटते हैं।
आप प्रत्येक हाइपरपैरामीटर के लिए एक सैंपलिंग वितरण परिभाषित करेंगे। आप यह भी तय कर सकते हैं कि इष्टतम मॉडल खोजते समय आप कितनी iterations बनाना चाहते हैं। हर iteration में, मॉडल के हाइपरपैरामीटर मान परिभाषित वितरणों से सैंपल करके सेट किए जाएंगे। रैंडम सर्च को ग्रिड सर्च के स्थान पर उपयोग करने के पीछे प्रमुख सैद्धांतिक सहारों में से एक यह तथ्य है कि अधिकतर मामलों में सभी हाइपरपैरामीटर समान रूप से महत्वपूर्ण नहीं होते। मूल शोध पत्र के अनुसार:
“…अधिकांश डेटासेट्स के लिए केवल कुछ ही हाइपर-पैरामीटर वास्तव में मायने रखते हैं, लेकिन अलग-अलग डेटासेट्स पर अलग-अलग हाइपर-पैरामीटर महत्वपूर्ण होते हैं। यह परिघटना नए डेटासेट्स के लिए एल्गोरिद्म कॉन्फ़िगर करने में ग्रिड सर्च को एक खराब विकल्प बनाती है।”
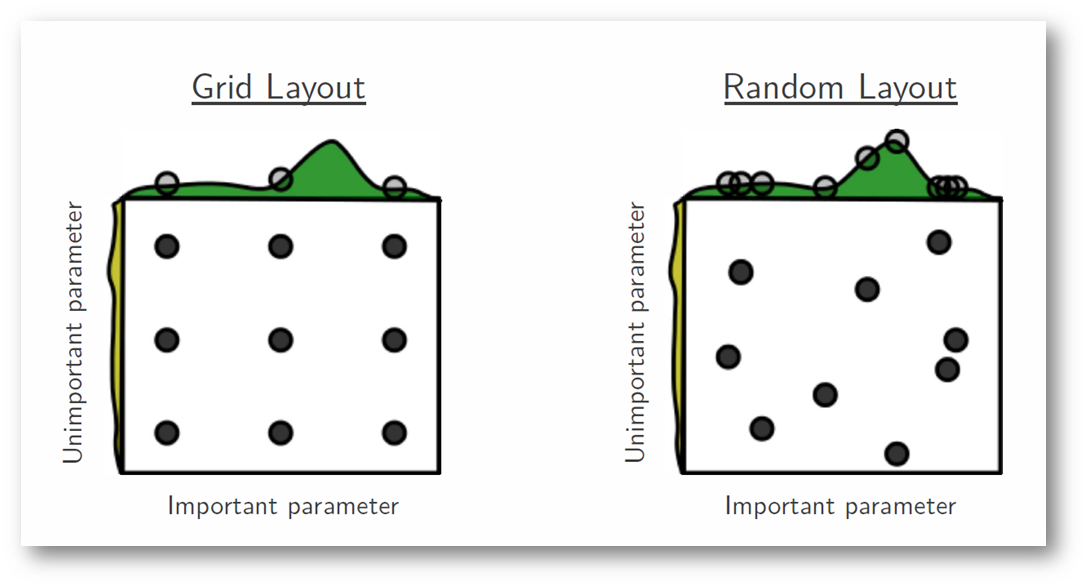
निम्नलिखित चित्र में, हम एक ऐसे हाइपरपैरामीटर स्पेस में खोज रहे हैं जहाँ एक हाइपरपैरामीटर का मॉडल स्कोर के ऑप्टिमाइज़ेशन पर उल्लेखनीय रूप से अधिक प्रभाव है — प्रत्येक अक्ष पर दिखाए गए वितरण मॉडल के स्कोर का प्रतिनिधित्व करते हैं। हर मामले में, हम नौ अलग-अलग मॉडलों का मूल्यांकन कर रहे हैं। ग्रिड सर्च रणनीति स्पष्ट रूप से इष्टतम मॉडल चूक जाती है और महत्वहीन पैरामीटर पर अनावश्यक समय व्यतीत करती है। इस ग्रिड सर्च के दौरान, हमने प्रत्येक हाइपरपैरामीटर को अलग-थलग कर, अन्य सभी को स्थिर रखते हुए, उसके सर्वोत्तम मान की खोज की। जिन मामलों में अध्ययन किया जा रहा हाइपरपैरामीटर परिणामस्वरूप मॉडल स्कोर पर कम प्रभाव डालता है, वहाँ यह प्रयास व्यर्थ जाता है। इसके विपरीत, रैंडम सर्च की खोज-क्षमता कहीं बेहतर होती है और वह महत्वपूर्ण हाइपरपैरामीटर के इष्टतम मान को खोजने पर अधिक ध्यान केंद्रित कर सकता है।
अगले सेक्शनों में, आप Python के साथ ग्रिड सर्च और रैंडम सर्च को क्रिया में देखेंगे। आप प्रभावशीलता और दक्षता के संदर्भ में यह भी तय कर पाएँगे कि कौन बेहतर है।
अप्लाइड मशीन लर्निंग की प्रक्रिया में, परिणाम प्रस्तुत करने से पहले हाइपरपैरामीटर ट्यूनिंग अंतिम चरण होता है।
आप Pima Indian diabetes डेटासेट का उपयोग करेंगे। यह डेटासेट एक क्लासिफिकेशन समस्या से संबंधित है, जिसमें आपको डेटासेट की 8 विशेषताओं के आधार पर यह भविष्यवाणी करनी है कि किसी व्यक्ति को मधुमेह होगा या नहीं। डेटासेट का पूरा विवरण आपको यहाँ मिल जाएगा।
डेटासेट में कुल 768 ऑब्ज़र्वेशन हैं। आपका पहला कार्य डेटासेट को लोड करना है ताकि आप आगे बढ़ सकें। लेकिन उससे पहले, वे डिपेंडेंसी इम्पोर्ट कर लेते हैं जिनकी आवश्यकता पड़ेगी।
# Dependencies

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
अब जब डिपेंडेंसी इम्पोर्ट हो चुकी हैं तो Pandas लाइब्रेरी की मदद से Pima Indians डेटासेट को एक Dataframe ऑब्जेक्ट में लोड करते हैं।
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
डेटासेट सफलतापूर्वक data नामक Dataframe ऑब्जेक्ट में लोड हो गया है। अब डेटा पर एक नज़र डालते हैं।
data.head()

तो आप 8 अलग-अलग फीचर्स देख सकते हैं जिन्हें 1 और 0 के आउटकम में लेबल किया गया है, जहाँ 1 का अर्थ है कि उस ऑब्ज़र्वेशन को मधुमेह है और 0 का अर्थ है कि उसे मधुमेह नहीं है। यह डेटासेट मिसिंग वैल्यू के लिए जाना जाता है। विशेषकर, कुछ कॉलम में मिसिंग ऑब्ज़र्वेशन शून्य मान के रूप में चिह्नित हैं। हम इसे उन कॉलमों की परिभाषा और इस डोमेन नॉलेज से पुष्ट कर सकते हैं कि बॉडी मास इंडेक्स या ब्लड प्रेशर के लिए शून्य मान अमान्य है।
(मिसिंग वैल्यू के कारण मशीन लर्निंग मॉडल बनाते समय कई समस्याएँ आती हैं। इस केस में, आप मधुमेह होने या न होने की भविष्यवाणी के लिए Logistic Regression क्लासिफायर का उपयोग करेंगे। अब, Logistic Regression मिसिंग वैल्यू की समस्याओं को संभाल नहीं सकता।)
(यदि आपको Logistic Regression पर एक त्वरित रिफ्रेशर चाहिए, तो आप यहाँ देख सकते हैं।)
आइए Pandas की describe() यूटिलिटी से डेटा के बारे में कुछ सांख्यिकीय जानकारी प्राप्त करते हैं।
data.describe()

यह उपयोगी है।
हम देख सकते हैं कि कुछ कॉलमों में न्यूनतम मान शून्य (0) है। कुछ कॉलमों में शून्य का मान समझ में नहीं आता और वह अमान्य या मिसिंग वैल्यू को दर्शाता है।
विशेष रूप से, निम्नलिखित कॉलमों में शून्य का न्यूनतम मान अमान्य है:
अब आपको मानों की पहचान कर उन्हें मिसिंग के रूप में चिह्नित करना है। इसे कच्चे डेटा को देखकर पुष्ट करते हैं, उदाहरण में डेटा की पहली 20 पंक्तियाँ प्रिंट की गई हैं।
data.head(20)

आप कई कॉलमों में 0 देख सकते हैं, है न?
आप इन कॉलमों में मिसिंग वैल्यू की संख्या की गिनती कर सकते हैं। ऐसा आप DataFrame के उस सबसेट में जिन मानों का मान शून्य है, उन्हें True मार्क करके कर सकते हैं। फिर प्रत्येक कॉलम में True मानों की संख्या गिनी जा सकती है। इसके लिए आपको कॉलम नामों के बिना डेटा को पुनः इम्पोर्ट करना होगा।
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
आप देख सकते हैं कि कॉलम 1, 2 और 5 में कुछ ही शून्य मान हैं, जबकि कॉलम 3 और 4 में कहीं अधिक हैं, लगभग आधी पंक्तियों में। कॉलम 0 में भी कुछ मिसिंग वैल्यू हैं जो स्वाभाविक है। कॉलम 8 लक्ष्य चर को दर्शाता है, इसलिए इसमें '0' का होना स्वाभाविक है।
यह दर्शाता है कि अलग-अलग कॉलमों के लिए अलग-अलग “मिसिंग वैल्यू” रणनीतियों की आवश्यकता हो सकती है, जैसे कि यह सुनिश्चित करना कि प्रेडिक्टिव मॉडल को ट्रेन करने के लिए पर्याप्त रिकॉर्ड्स बचे रहें।
Python में, खासकर Pandas, NumPy और Scikit-Learn में, मिसिंग वैल्यू को NaN के रूप में मार्क किया जाता है।
NaN मान वाले मान sum, count आदि जैसे ऑपरेशनों से अनदेखे कर दिए जाते हैं।
Pandas DataFrame में आप रुचि के कॉलमों के सबसेट पर replace() फ़ंक्शन का उपयोग कर मानों को आसानी से NaN के रूप में मार्क कर सकते हैं।
मिसिंग वैल्यू मार्क करने के बाद, आप isnull() फ़ंक्शन का उपयोग करके डेटासेट में सभी NaN मानों को True मार्क कर सकते हैं और प्रत्येक कॉलम के लिए मिसिंग वैल्यू की गिनती प्राप्त कर सकते हैं।
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
आप देख सकते हैं कि कॉलम 1:5 में उतनी ही मिसिंग वैल्यू हैं जितनी ऊपर शून्य मानों की पहचान हुई थी। यह संकेत है कि आपने पहचानी गई मिसिंग वैल्यू को सही ढंग से मार्क किया है।
यह एक उपयोगी सारांश है। लेकिन आप वास्तविक डेटा भी देखना चाहेंगे ताकि पुष्टि हो सके कि आप स्वयं को धोखा नहीं दे रहे।
नीचे वही उदाहरण है, बस आप डेटा की पहली 5 पंक्तियाँ प्रिंट कर रहे हैं।
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
कच्चे डेटा से स्पष्ट है कि मिसिंग वैल्यू मार्क करना अपेक्षित रूप से काम कर गया। अब, आप मिसिंग वैल्यू को इम्प्यूट करेंगे। इम्प्यूटिंग का तात्पर्य मिसिंग वैल्यू को बदलने के लिए किसी मॉडल का उपयोग करना है। हालाँकि मिसिंग वैल्यू इम्प्यूट करने के कई समाधान हैं, आप mean imputation का उपयोग करेंगे जिसका अर्थ है किसी कॉलम की मिसिंग वैल्यू को उसी कॉलम के औसत से बदलना। इसे Pandas की fillna() यूटिलिटी से करते हैं।
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
शाबाश! आपने अब मिसिंग वैल्यू की समस्या संभाल ली है। अब इस डेटा का उपयोग scikit-learn से एक Logistic Regression मॉडल बनाने में करते हैं।
पहले आप कुछ रैंडम हाइपरपैरामीटर मानों के साथ मॉडल देखेंगे। फिर आप दो अलग रणनीतियों — ग्रिड सर्च और रैंडम सर्च — के साथ दो अन्य Logistic Regression मॉडल बनाएँगे।
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
आपने कुछ रैंडम हाइपरपैरामीटर मानों के साथ Logistic Regression मॉडल बना लिया है। जिन हाइपरपैरामीटर का आपने उपयोग किया है, वे हैं:
आगे केस स्टडी में, आप इन हाइपरपैरामीटरों को ऑप्टिमाइज़/ट्यून करेंगे ताकि परिणाम में बदलाव देख सकें।
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
          penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False)
अब सटीकता (accuracy) स्कोर जाँचने का समय है।
lr.score(X,y)
0.7747395833333334
ऊपर के चरण में, आपने अपने LR मॉडल को उसी डेटा पर लागू किया और उसका स्कोर निकाला। लेकिन हमेशा आपके मशीन लर्निंग मॉडल की स्थिरता को वैलिडेट करने की ज़रूरत होती है। आप बस अपने ट्रेनिंग डेटा पर मॉडल फिट कर दें और उम्मीद करें कि यह वास्तविक, अनदेखे डेटा पर भी सटीक काम करेगा — ऐसा नहीं किया जा सकता। आपको किसी प्रकार का आश्वासन चाहिए कि आपके मॉडल ने डेटा के अधिकतर पैटर्न सही तरह पकड़े हैं।
खैर, क्रॉस-वैलिडेशन मदद करता है। मैं इसके विवरण में नहीं जाऊँगा क्योंकि यह इस ब्लॉग के दायरे से बाहर है। लेकिन यह पोस्ट बहुत अच्छा काम करती है।
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator

kfold = KFold(n_splits=3, random_state=7)
आपने n_splits को 3 दिया है, जो मूलतः इसे 3-फोल्ड क्रॉस-वैलिडेशन बनाता है। आपने random_state के रूप में 7 दिया है। यह केवल परिणामों को पुनरुत्पादित करने के लिए है। आप कोई भी पूर्णांक दे सकते थे। अब, इसे लागू करते हैं।
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
आप देख सकते हैं कि स्कोर में थोड़ा कमी आई है। वैसे भी, हाइपरपैरामीटर ट्यूनिंग/ऑप्टिमाइज़ेशन से आप और बेहतर कर सकते हैं।
एक और LR मॉडल बनाते हैं, पर इस बार इसके हाइपरपैरामीटर ट्यून होंगे। आप पहले यह ग्रिड सर्च से करेंगे।
पहले वे डिपेंडेंसी इम्पोर्ट करते हैं जिनकी आपको आवश्यकता होगी। Scikit-learn इसके लिए GridSearchCV नामक यूटिलिटी प्रदान करता है।
from sklearn.model_selection import GridSearchCV
आइए उन हाइपरपैरामीटरों के ग्रिड मानों को परिभाषित करें जिनका आपने ऊपर उपयोग किया।
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
आपने ग्रिड परिभाषित कर दिया है। अब इनके ऊपर ग्रिड सर्च चलाते हैं और निष्पादन समय के साथ परिणाम देखते हैं।
import time

lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
आप एक बड़ा हाइपरपैरामीटर ग्रिड भी परिभाषित कर सकते हैं और ग्रिड सर्च लागू कर सकते हैं।
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
आप देख सकते हैं कि सटीकता स्कोर में वृद्धि हुई है, लेकिन निष्पादन समय में भी पर्याप्त बढ़ोतरी हुई है। ग्रिड जितना बड़ा होगा, निष्पादन समय उतना ही अधिक होगा।
अब सब कुछ फिर से चलाते हैं लेकिन इस बार रैंडम सर्च के साथ। Scikit-learn इसे करने के लिए RandomSearchCV प्रदान करता है। हमेशा की तरह, इसके लिए आवश्यक डिपेंडेंसी इम्पोर्ट करनी होंगी।
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
वाह! रैंडम सर्च ने वही सटीकता दी लेकिन समय बहुत कम लगा।
केस स्टडी भाग के लिए बस इतना ही। अब, समापन करते हैं!
इस ट्यूटोरियल में, आपने मशीन लर्निंग मॉडल के पैरामीटर और हाइपरपैरामीटर तथा उनके बीच के अंतर के बारे में सीखा। आपने यह भी जाना कि कुशल मशीन लर्निंग मॉडल बनाने में हाइपरपैरामीटर ऑप्टिमाइज़ेशन क्या भूमिका निभाता है। आपने scikit-learn की मदद से Python में एक साधारण Logistic Regression क्लासिफायर बनाया।
आपने ग्रिड सर्च और रैंडम सर्च से हाइपरपैरामीटर ट्यून किए और देखा कि कौन बेहतर प्रदर्शन करता है।
इसके अलावा, आपने छोटे-छोटे डेटा प्रीप्रोसेसिंग चरण (जैसे मिसिंग वैल्यू हैंडल करना) देखे जो मशीन लर्निंग मॉडल को डेटा देने से पहले आवश्यक होते हैं। आपने क्रॉस-वैलिडेशन को भी कवर किया।
यह सब एक साथ बहुत कुछ है, और आपकी डेटा साइंस यात्रा में ये सभी समान रूप से महत्वपूर्ण हैं। मैं आपको कुछ आगे की पढ़ाई के लिए छोड़ता हूँ।
आगे पढ़ें:
जो लोग थोड़ा अधिक उन्नत हैं, उनके लिए मैं न्यूरल नेटवर्क के हाइपरपैरामीटर को प्रभावी ढंग से ऑप्टिमाइज़ करने पर यह शोध-पत्र पढ़ने की कड़ी की सिफारिश करता हूँ: link
यदि आप मशीन लर्निंग के बारे में और सीखना चाहते हैं, तो DataCamp के निम्नलिखित कोर्स करें:
मशीन लर्निंग के बारे में और जानें
कोर्स
कोर्स
कोर्स