Hyperparameter Tuning in Python
BasicSkill Level
4 uur
25.4K learners
De beste manier om over hyperparameters te denken is als de instellingen van een algoritme die je kunt aanpassen om de prestaties te optimaliseren, net zoals je aan de knoppen van een AM‑radio draait om een helder signaal te krijgen. Bij het bouwen van een machinelearningmodel krijg je ontwerpkeuzes voorgeschoteld over hoe je je modelarchitectuur definieert. Vaak weet je niet direct wat de optimale modelarchitectuur is voor een bepaald model, en dus wil je graag een reeks mogelijkheden verkennen. In echte machinelearning‑stijl laat je die verkenning idealiter door de machine uitvoeren en de optimale modelarchitectuur automatisch selecteren.
In de casestudysectie zie je hoe de juiste keuze van hyperparameterwaarden de prestaties van een machinelearningmodel beïnvloedt. In deze context staat het kiezen van de juiste set waarden bekend als „hyperparameteroptimalisatie” of „hyperparametertuning”.
Modellen kunnen veel hyperparameters hebben en het vinden van de beste combinatie kan worden benaderd als een zoekprobleem.
Hoewel er tegenwoordig veel algoritmen voor hyperparameteroptimalisatie/-tuning zijn, bespreken we hier twee eenvoudige strategieën: 1. grid search en 2. random search.
Grid search is een aanpak voor hyperparametertuning die systematisch een model opbouwt en evalueert voor elke combinatie van algoritmeparameters die in een rooster zijn opgegeven.
Neem het volgende voorbeeld:
Stel, een machinelearningmodel X neemt hyperparameters a1, a2 en a3. Bij grid search definieer je eerst het bereik van waarden voor elk van de hyperparameters a1, a2 en a3. Je kunt dit zien als een array met waarden voor elke hyperparameter. De grid search‑techniek zal vervolgens veel versies van X construeren met alle mogelijke combinaties van hyperparametervaarden (a1, a2 en a3) die je in eerste instantie hebt gedefinieerd. Dit bereik van hyperparameterwaarden wordt het rooster genoemd.
Stel dat je het rooster definieert als:
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
Let op dat de array met waarden die je voor de hyperparameters definieert legitiem moet zijn, in die zin dat je geen float‑waarden kunt aanleveren als de hyperparameter alleen integer‑waarden accepteert.
Nu start grid search met het construeren van meerdere versies van X op basis van het rooster dat je zojuist hebt gedefinieerd.
Het begint met de combinatie [0,10,105] en eindigt met [5,60,125]. Het doorloopt alle tussenliggende combinaties, wat grid search computationeel erg kostbaar maakt.
Laten we naar de andere zoektechniek kijken: random search.
Het idee van random search voor hyperparameters is voorgesteld door James Bergstra & Yoshua Bengio. Je vindt het originele artikel hier.
Random search verschilt van grid search. Je levert geen discrete set waarden meer aan om voor elke hyperparameter te verkennen; in plaats daarvan geef je een statistische verdeling op voor elke hyperparameter waaruit waarden willekeurig kunnen worden bemonsterd.
Voordat we verder gaan, even opfrissen wat verdeling en steekproeven betekenen:
In de statistiek bedoelen we met verdeling de ordening van waarden van een variabele die hun waargenomen of theoretische frequentie van voorkomen weergeeft.
Steekproeven (sampling) is daarentegen het proces waarbij je een representatieve steekproef kiest uit een doelpopulatie en data verzamelt uit die steekproef om iets te begrijpen over de populatie als geheel.
Laten we nu teruggaan naar het concept van willekeurige search.
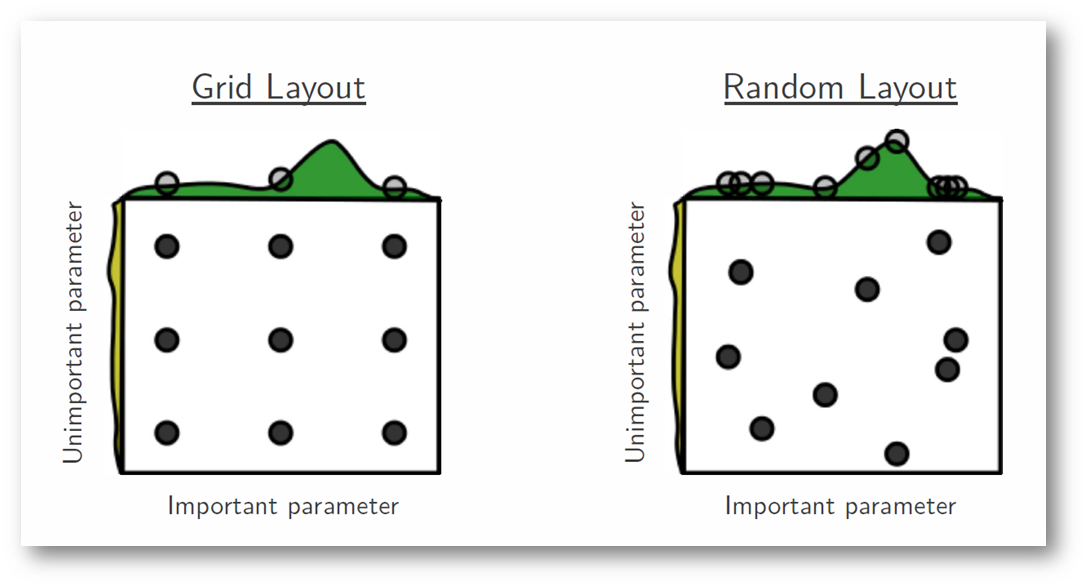
Je definieert een steekproefverdeling voor elke hyperparameter. Je kunt ook aangeven hoeveel iteraties je wilt uitvoeren bij het zoeken naar het optimale model. Bij elke iteratie worden de hyperparametervaarden van het model ingesteld door te sampelen uit de gedefinieerde verdelingen. Een van de belangrijkste theoretische onderbouwingen voor het gebruik van random search in plaats van grid search is het feit dat in de meeste gevallen hyperparameters niet even belangrijk zijn. Volgens het oorspronkelijke artikel:
„… voor de meeste datasets doen slechts enkele hyperparameters er echt toe, maar zijn op verschillende datasets verschillende hyperparameters belangrijk. Dit fenomeen maakt grid search een slechte keuze om algoritmen te configureren voor nieuwe datasets.”
In de onderstaande figuur zoeken we in een hyperparameter‑ruimte waarbij één hyperparameter aanzienlijk meer invloed heeft op het optimaliseren van de modelscore – de verdelingen op elke as representeren de modelscore. In beide gevallen evalueren we negen verschillende modellen. De grid‑searchstrategie mist duidelijk het optimale model en besteedt dubbel werk aan het verkennen van de onbelangrijke parameter. Tijdens deze grid search isoleerden we elke hyperparameter en zochten we naar de best mogelijke waarde terwijl alle andere hyperparameters constant werden gehouden. In gevallen waarin de bestudeerde hyperparameter weinig effect heeft op de uiteindelijke modelscore, leidt dit tot verspilde moeite. Omgekeerd heeft random search veel meer verkennend vermogen en kan het zich richten op het vinden van de optimale waarde voor de cruciale hyperparameter.
In de volgende secties zie je grid search en random search in actie met Python. Je kunt dan ook bepalen welke effectiever en efficiënter is.
Hyperparametertuning is de laatste stap in het proces van toegepaste machine learning voordat je resultaten presenteert.
Je gebruikt de Pima Indian diabetes‑dataset. De dataset komt overeen met een classificatieprobleem waarbij je moet voorspellen of iemand diabetes krijgt op basis van de 8 features in de dataset. De volledige beschrijving van de dataset vind je hier.
De dataset bevat in totaal 768 observaties. Je eerste taak is de dataset laden zodat je verder kunt. Maar eerst importeren we de afhankelijkheden die je nodig hebt.
# Dependencies

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
Nu de afhankelijkheden zijn geïmporteerd, laden we de Pima Indians‑dataset in een DataFrame‑object met de bekende Pandas‑bibliotheek.
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
De dataset is succesvol geladen in het DataFrame‑object data. Laten we nu naar de data kijken.
data.head()

Je ziet dus 8 verschillende features met uitkomsten 1 en 0, waarbij 1 staat voor een observatie met diabetes en 0 voor een observatie zonder diabetes. Van de dataset is bekend dat er ontbrekende waarden zijn. Specifiek zijn er ontbrekende observaties voor sommige kolommen die als nul zijn gemarkeerd. Dat kunnen we onderbouwen met de definitie van die kolommen en de domeinkennis dat een nulwaarde ongeldig is voor die metingen, bijvoorbeeld een nulpunt voor BMI of bloeddruk is ongeldig.
(Ontbrekende waarden zorgen voor veel problemen wanneer je een machinelearningmodel probeert te bouwen. In dit geval gebruik je een Logistic Regression‑classifier om te voorspellen of patiënten wel of geen diabetes hebben. Logistic Regression kan niet overweg met ontbrekende waarden.)
(Als je een snelle opfrisser wilt over Logistic Regression, kijk dan hier.)
Laten we wat statistieken over de data opvragen met de describe()‑functie van Pandas.
data.describe()

Dit is nuttig.
We zien dat er kolommen zijn met een minimumwaarde van nul (0). In sommige kolommen slaat een nulwaarde nergens op en duidt het op een ongeldige of ontbrekende waarde.
Concreet hebben de volgende kolommen een ongeldige minimumwaarde nul:
Nu moet je waarden identificeren en markeren als ontbrekend. Laten we dit bevestigen door naar de ruwe data te kijken; onderstaand voorbeeld print de eerste 20 rijen.
data.head(20)

Je ziet nullen in meerdere kolommen, toch?
Je kunt een telling krijgen van het aantal ontbrekende waarden in elk van deze kolommen. Dat kan door in de subset van de DataFrame waarin je geïnteresseerd bent alle nulwaarden als True te markeren. Vervolgens tel je het aantal True‑waarden per kolom. Hiervoor moet je de data opnieuw importeren zonder kolomnamen.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Je ziet dat kolommen 1, 2 en 5 maar een paar nullen hebben, terwijl kolommen 3 en 4 er veel meer hebben, bijna de helft van de rijen. Kolom 0 heeft ook enkele ontbrekende waarden, maar dat is logisch. Kolom 8 is de doelvariabele, dus nullen daarin zijn natuurlijk.
Dit benadrukt dat verschillende strategieën voor „ontbrekende waarden” nodig kunnen zijn voor verschillende kolommen, bijvoorbeeld om ervoor te zorgen dat er genoeg records overblijven om een voorspellend model te trainen.
In Python, specifiek in Pandas, NumPy en Scikit‑Learn, markeer je ontbrekende waarden als NaN.
Waarden met NaN worden genegeerd bij bewerkingen zoals som, count, enzovoort.
Je kunt waarden eenvoudig als NaN markeren met de Pandas‑DataFrame door de functie replace() te gebruiken op een subset van de kolommen waarin je geïnteresseerd bent.
Nadat je de ontbrekende waarden hebt gemarkeerd, kun je met de functie isnull() alle NaN‑waarden in de dataset als True markeren en een telling krijgen van de ontbrekende waarden per kolom.
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Je ziet dat kolommen 1:5 hetzelfde aantal ontbrekende waarden hebben als het aantal nulwaarden dat we hierboven identificeerden. Dat is een teken dat je de ontbrekende waarden correct hebt gemarkeerd.
Dit is een nuttige samenvatting. Maar je wilt ook de daadwerkelijke data zien om te bevestigen dat je jezelf niet voor de gek houdt.
Hieronder hetzelfde voorbeeld, maar nu print je de eerste 5 rijen.
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
Uit de ruwe data blijkt duidelijk dat het markeren van de ontbrekende waarden het gewenste effect had. Nu ga je de ontbrekende waarden imputeren. Imputeren betekent dat je een model gebruikt om ontbrekende waarden te vervangen. Hoewel er meerdere oplossingen zijn om ontbrekende waarden te imputeren, gebruiken we mean imputation: je vervangt de ontbrekende waarden in een kolom door het gemiddelde van die kolom. Laten we dit doen met de Pandas‑functie fillna().
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Top! Je hebt het probleem van ontbrekende waarden nu aangepakt. Laten we deze data gebruiken om met scikit‑learn een Logistic Regression‑model te bouwen.
Eerst bekijk je het model met enkele willekeurige hyperparametervaarden. Daarna bouw je twee andere Logistic Regression‑modellen met twee verschillende strategieën: grid search en random search.
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
Je hebt het Logistic Regression‑model gecreëerd met enkele willekeurige hyperparametervaarden. De hyperparameters die je gebruikte zijn:
Later in de casestudy ga je deze hyperparameters optimaliseren/tunen om het effect op de resultaten te zien.
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
          penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False)
Tijd om de nauwkeurigheidsscore te controleren.
lr.score(X,y)
0.7747395833333334
In de bovenstaande stap paste je je LR‑model toe op dezelfde data en evalueerde je de score. Maar je moet altijd de stabiliteit van je machinelearningmodel valideren. Je kunt het model niet simpelweg fitten op je trainingsdata en hopen dat het nauwkeurig werkt op echte, ongeziene data. Je hebt een vorm van zekerheid nodig dat je model de meeste patronen uit de data correct heeft opgepikt.
Cross‑validatie schiet te hulp. Ik ga niet in op de details, want dat valt buiten de scope van deze blog. Maar deze post legt het uitstekend uit.
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator

kfold = KFold(n_splits=3, random_state=7)
Je gaf n_splits op als 3, wat neerkomt op 3‑voudige cross‑validatie. Je gaf ook random_state=7 op. Dit is puur om resultaten te reproduceren. Je had ook een ander geheel getal kunnen gebruiken. Laten we dit nu toepassen.
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
Je ziet een kleine daling in de score. Hoe dan ook, met hyperparametertuning/‑optimalisatie kun je dit verbeteren.
Laten we een ander LR‑model bouwen, maar nu met getunede hyperparameters. Eerst doen we dit met grid search.
Importeer eerst de benodigde afhankelijkheden. Scikit‑learn biedt hiervoor de utility GridSearchCV.
from sklearn.model_selection import GridSearchCV
Laten we de roosterwaarden definiëren voor de hyperparameters die je hierboven gebruikte.
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
Je hebt het rooster gedefinieerd. Laten we de grid search erover uitvoeren en de resultaten met de uitvoeringstijd bekijken.
import time

lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
Je kunt ook een groter rooster met hyperparameters definiëren en grid search toepassen.
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
Je ziet een verbetering in de nauwkeurigheidsscore, maar de uitvoeringstijd neemt ook merkbaar toe. Hoe groter het rooster, hoe langer de uitvoeringstijd.
Laten we alles opnieuw doen, maar nu met random search. Scikit‑learn biedt hiervoor RandomSearchCV. Zoals gebruikelijk importeer je eerst de benodigde afhankelijkheden.
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
Wow! Random search leverde dezelfde nauwkeurigheid op, maar in veel minder tijd.
Dat was het voor de casestudy. Laten we afronden!
In deze tutorial leerde je over parameters en hyperparameters van een machinelearningmodel en ook hun verschillen. Je zag bovendien welke rol hyperparameteroptimalisatie speelt bij het bouwen van efficiënte machinelearningmodellen. Je bouwde een eenvoudige Logistic Regression‑classifier in Python met scikit‑learn.
Je stemde de hyperparameters af met grid search en random search en zag welke beter presteert.
Daarnaast zag je kleine stappen in datapreprocessing (zoals het omgaan met ontbrekende waarden) die nodig zijn voordat je data aan het machinelearningmodel voert. Je behandelde ook cross‑validatie.
Dat is veel om te verwerken, en alles is even belangrijk in je data‑science‑reis. Ik laat je achter met wat verdere lectuur.
Verder lezen:
Voor wie wat verder gevorderd is, raad ik dit paper ten zeerste aan voor het effectief optimaliseren van hyperparameters van neurale netwerken. link
Wil je meer leren over Machine Learning? Volg dan de volgende cursussen van DataCamp:
Leer meer over Machine Learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

