Ottimizzazione degli iperparametri in Python
BasicSkill Level
4 ore
25.4K learners
Il modo migliore per pensare agli iperparametri è come alle impostazioni di un algoritmo che possono essere regolate per ottimizzarne le prestazioni, proprio come potresti girare le manopole di una radio AM per ottenere un segnale chiaro. Quando crei un modello di machine learning, ti troverai davanti a scelte progettuali su come definire l’architettura del modello. Spesso non sai subito quale dovrebbe essere l’architettura ottimale per un dato modello e quindi vuoi poter esplorare un ventaglio di possibilità. In puro stile machine learning, idealmente chiederai alla macchina di svolgere questa esplorazione e selezionare automaticamente l’architettura ottimale.
Vedrai nella sezione del caso di studio come la scelta corretta dei valori degli iperparametri influenzi le prestazioni di un modello di machine learning. In questo contesto, scegliere il giusto set di valori è comunemente noto come “ottimizzazione degli iperparametri” o “tuning degli iperparametri”.
I modelli possono avere molti iperparametri e trovare la migliore combinazione può essere trattato come un problema di ricerca.
Sebbene oggi esistano molti algoritmi di ottimizzazione/tuning degli iperparametri, in questo post ne trattiamo due semplici: 1. grid search e 2. random search.
La grid search è un approccio al tuning che costruisce ed evalua sistematicamente un modello per ogni combinazione di parametri dell’algoritmo specificati in una griglia.
Consideriamo il seguente esempio:
Supponiamo che un modello di machine learning X prenda gli iperparametri a1, a2 e a3. Nella grid search, prima definisci l’intervallo di valori per ciascuno degli iperparametri a1, a2 e a3. Puoi pensarli come array di valori per ciascun iperparametro. Ora la tecnica di grid search costruirà molte versioni di X con tutte le possibili combinazioni dei valori degli iperparametri (a1, a2 e a3) che hai definito all’inizio. Questo intervallo di valori degli iperparametri è chiamato griglia.
Supponi di aver definito la griglia come:
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
Nota che l’array di valori che stai definendo per gli iperparametri deve essere legittimo, nel senso che non puoi fornire valori di tipo Floating all’array se l’iperparametro accetta solo valori Integer.
Ora la grid search inizierà a costruire diverse versioni di X con la griglia che hai appena definito.
Partirà dalla combinazione [0,10,105] e finirà con [5,60,125]. Passerà per tutte le combinazioni intermedie tra queste due, il che rende la grid search computazionalmente molto costosa.
Diamo un’occhiata all’altra tecnica di ricerca: la random search:
L’idea della random search degli iperparametri è stata proposta da James Bergstra & Yoshua Bengio. Puoi consultare l’articolo originale qui.
La random search differisce dalla grid search. Non fornisci più un insieme discreto di valori da esplorare per ciascun iperparametro; piuttosto, fornisci una distribuzione statistica per ciascun iperparametro da cui i valori possono essere campionati casualmente.
Prima di andare oltre, capiamo cosa significano distribuzione e campionamento:
In statistica, per distribuzione si intende essenzialmente una disposizione dei valori di una variabile che mostra la loro frequenza osservata o teorica di occorrenza.
Il campionamento, invece, è un termine usato in statistica. È il processo di scelta di un campione rappresentativo da una popolazione target e di raccolta dei dati da quel campione per comprendere qualcosa sull’intera popolazione.
Torniamo ora al concetto di random search.
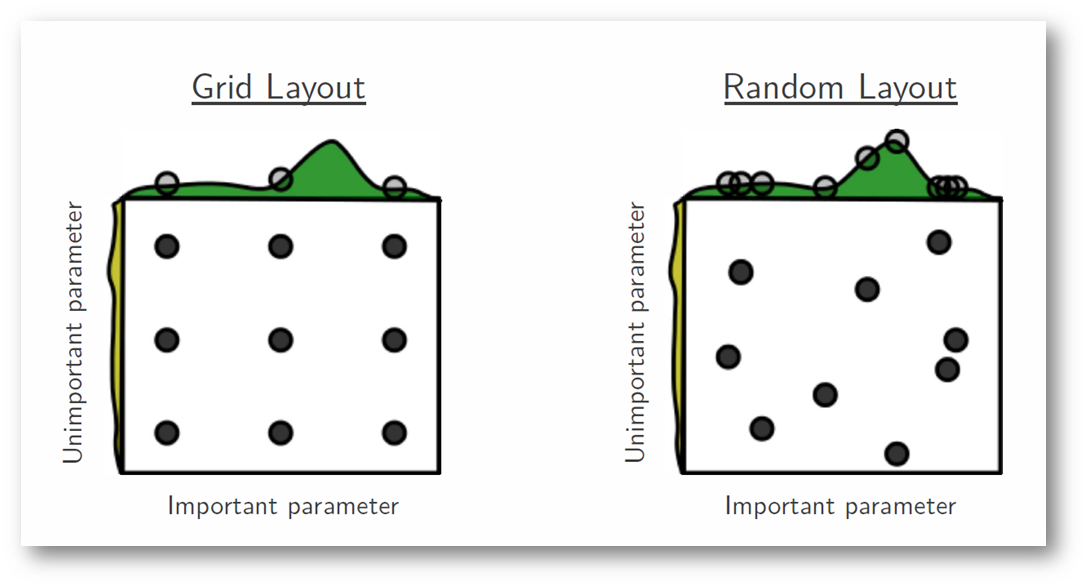
Definirai una distribuzione di campionamento per ciascun iperparametro. Puoi anche definire quante iterazioni vuoi costruire durante la ricerca del modello ottimale. Per ogni iterazione, i valori degli iperparametri del modello verranno impostati campionando dalle distribuzioni definite. Uno dei principali supporti teorici a favore dell’uso della random search al posto della grid search è il fatto che, nella maggior parte dei casi, gli iperparametri non sono ugualmente importanti. Secondo l’articolo originale:
“…per la maggior parte dei dataset solo pochi iperparametri contano davvero, ma iperparametri diversi sono importanti su dataset diversi. Questo fenomeno rende la grid search una scelta poco adatta per configurare algoritmi su nuovi dataset.”
Nella figura seguente, stiamo cercando in uno spazio di iperparametri dove un iperparametro ha un’influenza significativamente maggiore nell’ottimizzare lo score del modello: le distribuzioni mostrate su ciascun asse rappresentano lo score del modello. In entrambi i casi, stiamo valutando nove modelli diversi. La strategia di grid search manca palesemente il modello ottimale e spende tempo in modo ridondante esplorando il parametro non importante. Durante questa grid search, abbiamo isolato ciascun iperparametro e cercato il miglior valore possibile mantenendo tutti gli altri iperparametri costanti. Nei casi in cui l’iperparametro studiato ha scarso effetto sullo score risultante, questo si traduce in sforzi sprecati. Al contrario, la random search ha un potere esplorativo molto migliore e può concentrarsi nel trovare il valore ottimale per l’iperparametro critico.
Nelle sezioni seguenti vedrai grid search e random search in azione con Python. Potrai anche decidere quale sia migliore in termini di efficacia ed efficienza.
Il tuning degli iperparametri è l’ultimo passaggio nel processo di machine learning applicato prima di presentare i risultati.
Userai il dataset sul diabete dei Pima Indian. Il dataset corrisponde a un problema di classificazione in cui devi effettuare previsioni in base al fatto che una persona svilupperà il diabete, dati gli 8 attributi del dataset. Puoi trovare la descrizione completa del dataset qui.
Nel dataset ci sono in totale 768 osservazioni. Il primo compito è caricare il dataset per poter procedere. Ma prima importiamo le dipendenze di cui avrai bisogno.
# Dependencies

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
Ora che le dipendenze sono state importate, carichiamo il dataset Pima Indians in un oggetto DataFrame con la famosa libreria Pandas.
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
Il dataset è stato caricato correttamente nell’oggetto DataFrame data. Diamo ora un’occhiata ai dati.
data.head()

Quindi puoi vedere 8 diverse feature etichettate in esiti 1 e 0, dove 1 indica che l’osservazione ha il diabete e 0 che non lo ha. È noto che il dataset contiene valori mancanti. In particolare, ci sono osservazioni mancanti per alcune colonne contrassegnate con valore zero. Possiamo confermarlo dalla definizione di quelle colonne e dalla conoscenza del dominio, per cui uno zero è invalido per quelle misure, ad esempio zero per l’indice di massa corporea o la pressione sanguigna è invalido.
(I valori mancanti creano molti problemi quando provi a costruire un modello di machine learning. In questo caso userai un classificatore di Regressione Logistica per prevedere se i pazienti hanno il diabete o meno. Ora, la Regressione Logistica non può gestire i problemi di valori mancanti.)
(Se vuoi un rapido ripasso sulla Regressione Logistica puoi fare riferimento qui.)
Ricaviamo un po’ di statistiche sui dati con l’utilità describe() di Pandas.
data.describe()

Utile.
Possiamo vedere che ci sono colonne che hanno un valore minimo pari a zero (0). Per alcune colonne, un valore zero non ha senso e indica un valore mancante o invalido.
Nello specifico, le seguenti colonne hanno un valore minimo zero non valido:
Ora devi identificare e contrassegnare i valori come mancanti. Confermiamolo guardando i dati grezzi: l’esempio stampa le prime 20 righe di dati.
data.head(20)

Vedi degli 0 in diverse colonne, giusto?
Puoi ottenere un conteggio dei valori mancanti in ciascuna di queste colonne. Puoi farlo marcando come True tutti i valori pari a zero nel sottoinsieme del DataFrame che ti interessa. Puoi quindi contare il numero di valori true in ogni colonna. Per questo, dovrai reimportare i dati senza i nomi delle colonne.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Puoi vedere che le colonne 1, 2 e 5 hanno pochi valori zero, mentre le colonne 3 e 4 ne mostrano molti di più, quasi metà delle righe. La colonna 0 ha diversi valori mancanti, ma ciò è naturale. La colonna 8 indica la variabile target, quindi gli ‘0’ in essa sono naturali.
Questo evidenzia che possono essere necessarie diverse strategie di “valori mancanti” per colonne diverse, ad esempio per garantire che resti un numero sufficiente di record per addestrare un modello predittivo.
In Python, in particolare in Pandas, NumPy e Scikit-Learn, i valori mancanti sono contrassegnati come NaN.
I valori NaN vengono ignorati in operazioni come somma, conteggio, ecc.
Puoi contrassegnare facilmente i valori come NaN con il DataFrame Pandas usando la funzione replace() su un sottoinsieme delle colonne che ti interessano.
Dopo aver contrassegnato i valori mancanti, puoi usare la funzione isnull() per marcare come True tutti i valori NaN nel dataset e ottenere un conteggio dei valori mancanti per ogni colonna.
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Puoi vedere che le colonne da 1 a 5 hanno lo stesso numero di valori mancanti dei valori zero identificati sopra. È il segno che hai contrassegnato correttamente i valori mancanti identificati.
Questo è un riepilogo utile. Ma vuoi comunque guardare i dati reali per confermare di non esserti ingannato da solo.
Di seguito lo stesso esempio, ma stampando le prime 5 righe di dati.
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
È evidente dai dati grezzi che il contrassegno dei valori mancanti ha avuto l’effetto desiderato. Ora imputerai i valori mancanti. Per imputazione si intende l’uso di un modello per sostituire i valori mancanti. Sebbene esistano diverse soluzioni per l’imputazione, userai l’imputazione con la media, cioè sostituire i valori mancanti in una colonna con la media di quella colonna. Facciamolo con l’utilità fillna() di Pandas.
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Ottimo! Hai ora gestito il problema dei valori mancanti. Usiamo ora questi dati per costruire un modello di Regressione Logistica con scikit-learn.
Per prima cosa vedrai il modello con alcuni valori di iperparametri scelti a caso. Poi costruirai altri due modelli di Regressione Logistica con due strategie diverse: grid search e random search.
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
Hai creato il modello di Regressione Logistica con alcuni valori di iperparametri casuali. Gli iperparametri che hai usato sono:
Più avanti nel caso di studio, ottimizzerai/effettuerai il tuning di questi iperparametri per vedere il cambiamento nei risultati.
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
          penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False)
È il momento di controllare l’accuracy.
lr.score(X,y)
0.7747395833333334
Nel passaggio sopra hai applicato il modello LR agli stessi dati e ne hai valutato lo score. Ma c’è sempre bisogno di validare la stabilità del tuo modello di machine learning. Non puoi semplicemente adattare il modello ai dati di training e sperare che funzioni accuratamente sui dati reali che non ha mai visto prima. Ti serve una qualche garanzia che il tuo modello abbia colto correttamente la maggior parte dei pattern nei dati.
Beh, la cross-validation viene in aiuto. Non entrerò nei dettagli perché esula dallo scopo di questo blog. Ma questo post fa un ottimo lavoro.
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator

kfold = KFold(n_splits=3, random_state=7)
Hai fornito n_splits pari a 3, che in sostanza lo rende una cross-validation a 3 fold. Hai anche impostato random_state a 7. Serve solo a riprodurre i risultati. Avresti potuto fornire anche un qualsiasi altro intero. Ora applichiamola.
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
Puoi vedere che c’è un leggero calo dello score. In ogni caso, puoi fare meglio con il tuning/ottimizzazione degli iperparametri.
Costruiamo un altro modello LR, ma questa volta con iperparametri ottimizzati. Per prima cosa lo farai con la grid search.
Importiamo le dipendenze necessarie. Scikit-learn fornisce un’utilità chiamata GridSearchCV per questo.
from sklearn.model_selection import GridSearchCV
Definiamo i valori di griglia degli iperparametri che hai usato sopra.
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
Hai definito la griglia. Eseguiamo la grid search su di essa e vediamo i risultati con il tempo di esecuzione.
import time

lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
Puoi anche definire una griglia più ampia di iperparametri ed eseguire la grid search.
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
Vedi un aumento dell’accuracy, ma anche una crescita significativa del tempo di esecuzione. Più grande è la griglia, maggiore è il tempo.
Rieseguiamo tutto ma questa volta con la random search. Scikit-learn fornisce RandomSearchCV per farlo. Come al solito, dovrai importare le dipendenze necessarie.
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
Wow! La random search ha ottenuto la stessa accuracy ma in molto meno tempo.
Questo è tutto per la parte del caso di studio. Ora, tiriamo le somme!
In questo tutorial hai imparato cosa sono i parametri e gli iperparametri di un modello di machine learning e anche le loro differenze. Hai anche visto quale ruolo gioca l’ottimizzazione degli iperparametri nella costruzione di modelli di machine learning efficienti. Hai costruito un semplice classificatore di Regressione Logistica in Python con l’aiuto di scikit-learn.
Hai effettuato il tuning degli iperparametri con grid search e random search e visto quale funziona meglio.
Inoltre, hai visto piccoli passaggi di preprocessing dei dati (come la gestione dei valori mancanti) necessari prima di alimentare i dati nel modello di machine learning. Hai coperto anche la cross-validation.
È tanta roba, e tutti elementi ugualmente importanti nel tuo percorso di data science. Ti lascio con alcune letture aggiuntive che puoi fare.
Letture aggiuntive:
Per chi è un po’ più avanzato, consiglierei vivamente di leggere questo paper per ottimizzare efficacemente gli iperparametri delle reti neurali. link
Se vuoi saperne di più sul Machine Learning, segui i seguenti corsi di DataCamp:
Approfondisci il Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



