Penyetelan Hyperparameter di Python
BasicSkill Level
4 jam
25.4K learners
Cara terbaik memahami hyperparameter adalah menganggapnya seperti pengaturan sebuah algoritme yang dapat disesuaikan untuk mengoptimalkan performa, layaknya Anda memutar tombol pada radio AM untuk mendapatkan sinyal yang jernih. Saat membuat model machine learning, Anda akan dihadapkan pada pilihan desain untuk mendefinisikan arsitektur model. Sering kali, Anda tidak langsung tahu arsitektur optimal untuk model tertentu, sehingga Anda ingin dapat menjelajahi beragam kemungkinan. Dalam semangat machine learning yang sesungguhnya, idealnya Anda meminta mesin untuk melakukan eksplorasi ini dan secara otomatis memilih arsitektur model yang optimal.
Anda akan melihat pada bagian studi kasus bagaimana pemilihan nilai hyperparameter yang tepat memengaruhi performa sebuah model machine learning. Dalam konteks ini, memilih seperangkat nilai yang tepat biasanya dikenal sebagai “Hyperparameter optimization” atau “Hyperparameter tuning”.
Model dapat memiliki banyak hyperparameter dan menemukan kombinasi terbaik dapat diperlakukan sebagai masalah pencarian.
Meskipun kini ada banyak algoritme optimisasi/penyetelan hyperparameter, tulisan ini membahas dua strategi sederhana: 1. grid search dan 2. random search.
Grid search adalah pendekatan penyetelan hyperparameter yang secara metodis membangun dan mengevaluasi model untuk setiap kombinasi parameter algoritme yang ditentukan dalam sebuah grid.
Pertimbangkan contoh berikut:
Misalkan, sebuah model machine learning X menggunakan hyperparameter a1, a2, dan a3. Dalam grid searching, Anda terlebih dahulu mendefinisikan rentang nilai untuk masing-masing hyperparameter a1, a2, dan a3. Anda dapat menganggap ini sebagai sebuah array nilai untuk setiap hyperparameter. Kini teknik grid search akan membangun banyak versi X dengan semua kombinasi nilai hyperparameter (a1, a2, dan a3) yang Anda definisikan di awal. Rentang nilai hyperparameter ini disebut sebagai grid.
Misalkan, Anda mendefinisikan grid sebagai:
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
Perhatikan bahwa array nilai yang Anda definisikan untuk hyperparameter harus sah, dalam arti Anda tidak dapat memberikan nilai bertipe Floating ke array jika hyperparameter tersebut hanya menerima nilai Integer.
Sekarang, grid search akan mulai membangun beberapa versi X dengan grid yang baru saja Anda definisikan.
Ia akan memulai dengan kombinasi [0,10,105], dan berakhir dengan [5,60,125]. Ia akan melalui semua kombinasi di antaranya yang membuat grid search sangat mahal secara komputasi.
Mari kita lihat teknik pencarian lain yaitu Random search:
Gagasan pencarian acak hyperparameter diusulkan oleh James Bergstra & Yoshua Bengio. Anda dapat melihat makalah aslinya di sini.
Random search berbeda dari grid search. Alih-alih menyediakan sekumpulan nilai diskret untuk dijelajahi bagi setiap hyperparameter, Anda menyediakan distribusi statistik untuk setiap hyperparameter yang darinya nilai dapat diambil secara acak.
Sebelum melangkah lebih jauh, mari pahami apa yang dimaksud dengan distribusi dan pengambilan sampel:
Dalam Statistik, distribusi pada dasarnya adalah susunan nilai suatu variabel yang menunjukkan frekuensi kemunculan yang teramati atau teoritis.
Di sisi lain, sampling adalah istilah dalam statistik. Ini adalah proses memilih sampel yang representatif dari populasi sasaran dan mengumpulkan data dari sampel tersebut untuk memahami sesuatu tentang populasi secara keseluruhan.
Sekarang mari kembali ke konsep pencarian acak.
Anda akan mendefinisikan distribusi sampling untuk setiap hyperparameter. Anda juga dapat menentukan berapa banyak iterasi yang ingin Anda bangun saat mencari model optimal. Untuk setiap iterasi, nilai hyperparameter model akan ditetapkan dengan mengambil sampel dari distribusi yang didefinisikan. Salah satu landasan teoretis utama yang memotivasi penggunaan random search sebagai pengganti grid search adalah fakta bahwa dalam banyak kasus, hyperparameter tidak sama pentingnya. Menurut makalah asli:
“…untuk sebagian besar dataset hanya beberapa hyperparameter yang benar-benar penting, tetapi hyperparameter yang penting berbeda-beda pada dataset yang berbeda. Fenomena ini membuat grid search menjadi pilihan yang buruk untuk mengonfigurasi algoritme pada dataset baru.”
Pada gambar berikut, kita mencari pada ruang hyperparameter di mana satu hyperparameter memiliki pengaruh yang jauh lebih besar dalam mengoptimalkan skor model — distribusi yang ditampilkan pada setiap sumbu merepresentasikan skor model. Dalam setiap kasus, kita mengevaluasi sembilan model yang berbeda. Strategi grid search secara terang-terangan melewatkan model optimal dan menghabiskan waktu berulang mengeksplorasi parameter yang tidak penting. Selama grid search ini, kita mengisolasi setiap hyperparameter dan mencari nilai terbaik sambil menahan semua hyperparameter lain tetap konstan. Untuk kasus di mana hyperparameter yang dipelajari memiliki sedikit pengaruh pada skor model yang dihasilkan, ini mengakibatkan upaya yang sia-sia. Sebaliknya, random search memiliki daya jelajah yang jauh lebih baik dan dapat berfokus menemukan nilai optimal untuk hyperparameter yang krusial.
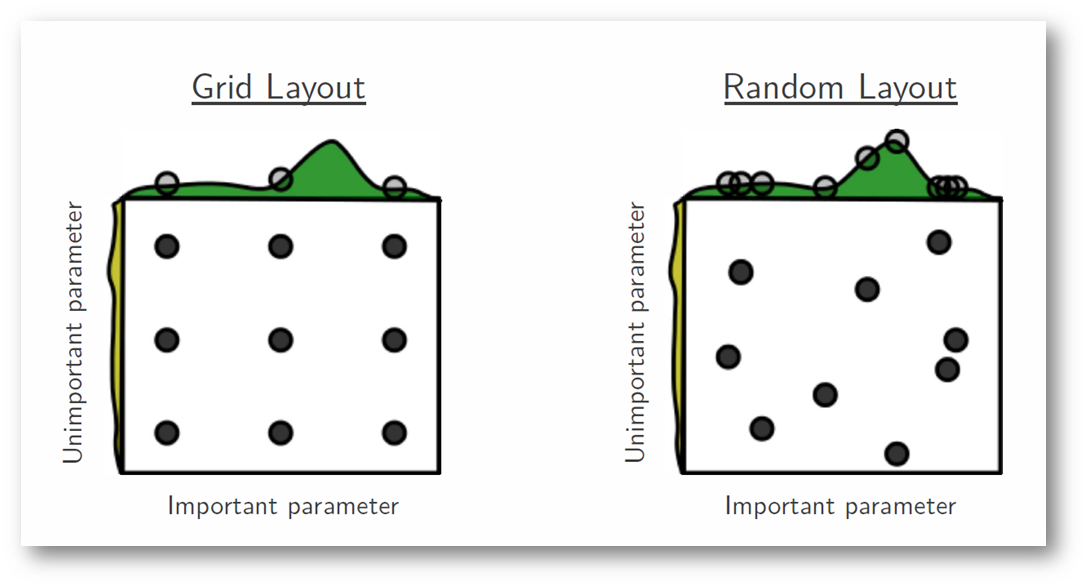
Pada bagian berikut, Anda akan melihat grid search dan random search secara langsung dengan Python. Anda juga akan dapat memutuskan mana yang lebih baik dari sisi efektivitas dan efisiensi.
Penyetelan hyperparameter adalah langkah terakhir dalam proses machine learning terapan sebelum menyajikan hasil.
Anda akan menggunakan dataset diabetes Pima Indian. Dataset ini merupakan masalah klasifikasi di mana Anda perlu membuat prediksi apakah seseorang akan menderita diabetes berdasarkan 8 fitur dalam dataset. Anda dapat menemukan deskripsi lengkap dataset di sini.
Total terdapat 768 observasi dalam dataset. Tugas pertama Anda adalah memuat dataset agar dapat melanjutkan. Namun sebelum itu, mari impor dependensi yang Anda perlukan.
# Dependencies

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
Sekarang karena dependensi sudah diimpor, mari muat dataset Pima Indians ke dalam objek DataFrame dengan pustaka Pandas yang terkenal.
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
Dataset berhasil dimuat ke dalam objek DataFrame data. Sekarang, mari lihat datanya.
data.head()

Jadi Anda memiliki 8 fitur berbeda yang diberi label menjadi keluaran 1 dan 0 di mana 1 berarti observasi tersebut menderita diabetes, dan 0 berarti observasi tersebut tidak menderita diabetes. Dataset ini diketahui memiliki nilai hilang. Secara khusus, ada observasi yang hilang untuk beberapa kolom yang ditandai sebagai nilai nol. Kita dapat menguatkannya dari definisi kolom-kolom tersebut, dan pengetahuan domain bahwa nilai nol tidak valid untuk ukuran-ukuran tersebut, misalnya nol untuk body mass index atau tekanan darah tidak valid.
(Nilai hilang menimbulkan banyak masalah saat Anda mencoba membangun model machine learning. Dalam kasus ini, Anda akan menggunakan klasifikator Logistic Regression untuk memprediksi apakah pasien menderita diabetes atau tidak. Logistic Regression tidak dapat menangani masalah nilai hilang.)
(Jika Anda ingin penyegaran cepat tentang Logistic Regression, Anda dapat merujuk di sini.)
Mari dapatkan beberapa statistik tentang data dengan utilitas describe() dari Pandas.
data.describe()

Ini berguna.
Kita dapat melihat ada kolom yang memiliki nilai minimum nol (0). Pada beberapa kolom, nilai nol tidak masuk akal dan menunjukkan nilai tidak valid atau hilang.
Secara khusus, kolom-kolom berikut memiliki nilai minimum nol yang tidak valid:
Sekarang Anda perlu mengidentifikasi dan menandai nilai sebagai hilang. Mari konfirmasi ini dengan melihat data mentah; contoh berikut mencetak 20 baris pertama data.
data.head(20)

Anda dapat melihat 0 di beberapa kolom, bukan?
Anda dapat memperoleh jumlah nilai hilang di masing-masing kolom ini. Anda dapat melakukannya dengan menandai semua nilai dalam subset DataFrame yang Anda minati yang bernilai nol sebagai True. Lalu Anda dapat menghitung jumlah nilai True di setiap kolom. Untuk ini, Anda harus memuat ulang data tanpa nama kolom.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Anda dapat melihat bahwa kolom 1, 2, dan 5 hanya memiliki beberapa nilai nol, sedangkan kolom 3 dan 4 menunjukkan jauh lebih banyak, hampir setengah dari baris. Kolom 0 memiliki beberapa nilai hilang meskipun itu wajar. Kolom 8 menunjukkan variabel target sehingga angka '0' di dalamnya adalah wajar.
Ini menyoroti bahwa strategi “nilai hilang” yang berbeda mungkin diperlukan untuk kolom yang berbeda, misalnya untuk memastikan masih ada jumlah catatan yang cukup untuk melatih model prediktif.
Di Python, khususnya Pandas, NumPy, dan Scikit-Learn, Anda menandai nilai hilang sebagai NaN.
Nilai dengan NaN diabaikan dari operasi seperti jumlah, hitung, dll.
Anda dapat menandai nilai sebagai NaN dengan mudah menggunakan DataFrame Pandas dengan fungsi replace() pada subset kolom yang Anda minati.
Setelah Anda menandai nilai hilang, Anda dapat menggunakan fungsi isnull() untuk menandai semua nilai NaN dalam dataset sebagai True dan mendapatkan jumlah nilai hilang untuk setiap kolom.
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Anda dapat melihat bahwa kolom 1:5 memiliki jumlah nilai hilang yang sama dengan nilai nol yang diidentifikasi di atas. Ini pertanda bahwa Anda telah menandai nilai hilang yang diidentifikasi dengan benar.
Ini adalah ringkasan yang berguna. Namun Anda ingin melihat data aktual untuk memastikan bahwa Anda tidak keliru.
Di bawah ini contoh yang sama, hanya saja Anda mencetak 5 baris pertama data.
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
Jelas dari data mentah bahwa penandaan nilai hilang memberikan efek yang diinginkan. Sekarang, Anda akan melakukan imputasi nilai hilang. Imputasi mengacu pada penggunaan suatu model untuk mengganti nilai hilang. Meskipun ada beberapa solusi untuk imputasi nilai hilang, Anda akan menggunakan imputasi mean yang berarti mengganti nilai hilang pada suatu kolom dengan nilai rata-rata kolom tersebut. Mari lakukan ini dengan utilitas fillna() dari Pandas.
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Selamat! Anda kini telah menangani masalah nilai hilang. Sekarang mari gunakan data ini untuk membangun model Logistic Regression menggunakan scikit-learn.
Pertama, Anda akan melihat model dengan beberapa nilai hyperparameter acak. Lalu Anda akan membangun dua model Logistic Regression lain dengan dua strategi berbeda — Grid search dan Random search.
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
Anda telah membuat model Logistic Regression dengan beberapa nilai hyperparameter acak. Hyperparameter yang Anda gunakan adalah:
Nantinya pada studi kasus, Anda akan mengoptimalkan/menyetel hyperparameter ini untuk melihat perubahan hasilnya.
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
          penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False)
Saatnya memeriksa skor akurasi.
lr.score(X,y)
0.7747395833333334
Pada langkah di atas, Anda menerapkan model LR ke data yang sama dan mengevaluasi skornya. Namun selalu ada kebutuhan untuk memvalidasi kestabilan model machine learning Anda. Anda tidak bisa sekadar menyesuaikan model ke data pelatihan dan berharap model tersebut akan bekerja akurat pada data nyata yang belum pernah dilihat sebelumnya. Anda memerlukan semacam jaminan bahwa model Anda telah menangkap sebagian besar pola dari data dengan benar.
Nah, Cross-validation hadir sebagai solusinya. Saya tidak akan membahas detailnya karena di luar cakupan blog ini. Namun tulisan ini menjelaskannya dengan sangat baik.
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator

kfold = KFold(n_splits=3, random_state=7)
Anda memberikan n_splits sebesar 3, yang pada dasarnya membuatnya menjadi cross-validation 3-fold. Anda juga memberikan random_state bernilai 7. Ini hanya untuk mereproduksi hasil. Anda juga bisa memberikan nilai integer lainnya. Sekarang, mari terapkan ini.
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
Anda dapat melihat ada sedikit penurunan skor. Bagaimanapun, Anda dapat memperoleh hasil lebih baik dengan penyetelan/optimisasi hyperparameter.
Mari bangun model LR lain, namun kali ini hyperparameter-nya akan disetel. Anda akan mulai dengan grid search.
Pertama-tama impor dependensi yang Anda perlukan. Scikit-learn menyediakan utilitas bernama GridSearchCV untuk ini.
from sklearn.model_selection import GridSearchCV
Mari definisikan nilai grid untuk hyperparameter yang Anda gunakan di atas.
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
Anda telah mendefinisikan grid. Mari jalankan grid search atasnya dan lihat hasilnya beserta waktu eksekusi.
import time

lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
Anda juga dapat mendefinisikan grid hyperparameter yang lebih besar dan menerapkan grid search.
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
Anda dapat melihat kenaikan skor akurasi, tetapi ada peningkatan waktu eksekusi yang cukup besar juga. Semakin besar grid, semakin lama waktu eksekusi.
Mari jalankan ulang semuanya tetapi kali ini dengan random search. Scikit-learn menyediakan RandomSearchCV untuk itu. Seperti biasa, Anda harus mengimpor dependensi yang diperlukan.
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
Wah! Random search menghasilkan akurasi yang sama tetapi dalam waktu yang jauh lebih singkat.
Itu saja untuk bagian studi kasus. Sekarang, mari kita simpulkan!
Dalam tutorial ini, Anda mempelajari tentang parameter dan hyperparameter dari sebuah model machine learning beserta perbedaannya. Anda juga mengetahui peran optimisasi hyperparameter dalam membangun model machine learning yang efisien. Anda membangun klasifikator Logistic Regression sederhana di Python dengan bantuan scikit-learn.
Anda menyetel hyperparameter dengan grid search dan random search dan melihat mana yang berkinerja lebih baik.
Selain itu, Anda melihat langkah praproses data sederhana (seperti menangani nilai hilang) yang diperlukan sebelum Anda memasukkan data ke dalam model machine learning. Anda juga membahas Cross-validation.
Itu cukup banyak hal, dan semuanya sama pentingnya dalam perjalanan data science Anda. Saya akan menutup dengan beberapa bacaan lanjutan yang dapat Anda lakukan.
Bacaan lanjutan:
Bagi yang sedikit lebih mahir, saya sangat merekomendasikan membaca makalah ini untuk mengoptimalkan hyperparameter jaringan saraf secara efektif. tautan
Jika Anda ingin mempelajari lebih lanjut tentang Machine Learning, ikuti kursus berikut dari DataCamp:
Pelajari lebih lanjut tentang Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



