Python'da Hiperparametre Ayarlama
BasicSkill Level
4 sa
25.4K learners
Hiperparametreleri, bir algoritmanın performansı optimize edecek şekilde ayarlanabilen ayarları gibi düşünebilirsiniz; tıpkı net bir sinyal almak için bir AM radyonun düğmelerini çevirmeniz gibi. Bir makine öğrenimi modeli oluştururken, model mimarinizi nasıl tanımlayacağınıza dair tasarım seçimleriyle karşılaşırsınız. Çoğu zaman, belirli bir model için en iyi mimarinin ne olması gerektiğini hemen bilemezsiniz ve bu nedenle bir dizi olasılığı keşfetmek istersiniz. Gerçek bir makine öğrenimi yaklaşımıyla, ideal olarak bu keşfi makinenin yapmasını ve en iyi model mimarisini otomatik olarak seçmesini istersiniz.
Vaka çalışması bölümünde, doğru hiperparametre değerlerinin bir makine öğrenimi modelinin performansını nasıl etkilediğini göreceksiniz. Bu bağlamda, doğru değer kümesini seçmek genellikle “Hiperparametre optimizasyonu” veya “Hiperparametre ayarlaması” olarak bilinir.
Modellerin birçok hiperparametresi olabilir ve en iyi parametre kombinasyonunu bulmak bir arama problemi olarak ele alınabilir.
Günümüzde birçok hiperparametre optimizasyonu/ayarlaması algoritması olsa da, bu yazı iki basit stratejiyi ele alır: 1. Izgara araması (grid search) ve 2. Rastgele arama (random search).
Izgara araması, bir ızgarada belirtilen algoritma parametrelerinin her bir kombinasyonu için yöntembilimsel olarak bir model inşa edip değerlendiren bir hiperparametre ayarlama yaklaşımıdır.
Şu örneği ele alalım:
Diyelim ki X adlı bir makine öğrenimi modeli a1, a2 ve a3 hiperparametrelerini alıyor. Izgara aramasında, önce a1, a2 ve a3 hiperparametrelerinin her biri için değer aralıklarını tanımlarsınız. Bunu, her hiperparametre için bir değer dizisi olarak düşünebilirsiniz. Şimdi ızgara araması tekniği, ilk aşamada tanımladığınız hiperparametre (a1, a2 ve a3) değerlerinin tüm olası kombinasyonlarıyla X'in birçok sürümünü oluşturacaktır. Bu hiperparametre değerleri aralığına ızgara denir.
Diyelim ki ızgarayı şu şekilde tanımladınız:
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
Şunu unutmayın: Hiperparametreler için tanımladığınız değer dizisinin, geçerli olması gerekir; örneğin hiperparametre yalnızca Tam sayı değerleri alıyorsa, diziye Ondalık tipinde değerler veremezsiniz.
Artık ızgara araması, az önce tanımladığınız ızgarayla X'in çeşitli sürümlerini oluşturmaya başlayacaktır.
[0,10,105] kombinasyonuyla başlayacak ve [5,60,125] ile sona erecektir. Bu ikisi arasındaki tüm ara kombinasyonlardan geçecektir; bu da ızgara aramasını hesaplama açısından çok maliyetli hale getirir.
Şimdi diğer arama tekniği olan Rastgele aramaya bakalım:
Hiperparametrelerin rastgele aranması fikri James Bergstra ve Yoshua Bengio tarafından ortaya atılmıştır. Orijinal makaleyi buradan inceleyebilirsiniz.
Rastgele arama, ızgara aramasından farklıdır. Artık her hiperparametre için keşfedilecek ayrık bir değer kümesi sunmazsınız; bunun yerine, değerlerin rastgele örneklenebileceği her hiperparametre için bir istatistiksel dağılım sağlarsınız.
Daha ileri gitmeden önce, dağılım ve örneklemenin ne anlama geldiğini anlayalım:
İstatistikte dağılım, özünde bir değişkenin değerlerinin gözlenen veya kuramsal görülme sıklıklarını gösteren bir düzenlemesi anlamına gelir.
Öte yandan, örnekleme istatistikte kullanılan bir terimdir. Hedef bir popülasyondan temsili bir örnek seçme ve popülasyonun tamamı hakkında bir şeyler anlamak için bu örnekten veri toplama sürecidir.
Şimdi tekrar rastgele arama kavramına dönelim.
Her hiperparametre için bir örnekleme dağılımı tanımlarsınız. Ayrıca, en iyi modeli ararken kaç yineleme oluşturmak istediğinizi de belirleyebilirsiniz. Her yinelemede, modelin hiperparametre değerleri tanımlanan dağılımlardan örneklenerek ayarlanır. Rastgele aramanın ızgara aramasına tercih edilmesini motive eden temel kuramsal dayanaklardan biri, çoğu durumda hiperparametrelerin eşit derecede önemli olmamasıdır. Orijinal makaleye göre:
“…çoğu veri kümesi için hiperparametrelerin yalnızca birkaçı gerçekten önemlidir, ancak farklı veri kümelerinde farklı hiperparametreler önem kazanır. Bu olgu, yeni veri kümeleri için algoritmaları yapılandırmada ızgara aramasını kötü bir tercih haline getirir.”
Aşağıdaki şekilde, bir hiperparametrenin model skorunu optimize etmede belirgin biçimde daha etkili olduğu bir hiperparametre uzayında arama yapıyoruz – her eksende gösterilen dağılımlar modelin skorunu temsil eder. Her iki durumda da dokuz farklı modeli değerlendiriyoruz. Izgara arama stratejisi, en iyi modeli açıkça ıskalar ve önemsiz parametreyi keşfetmek için gereksiz zaman harcar. Bu ızgara aramasında, her hiperparametreyi yalıtıp diğer tüm hiperparametreleri sabit tutarken olası en iyi değeri aradık. İncelenen hiperparametrenin sonuç model skoruna az etkisi olduğu durumlarda bu, boşa çaba demektir. Buna karşın, rastgele arama çok daha iyi bir keşif gücüne sahiptir ve kritik hiperparametre için en uygun değeri bulmaya odaklanabilir.
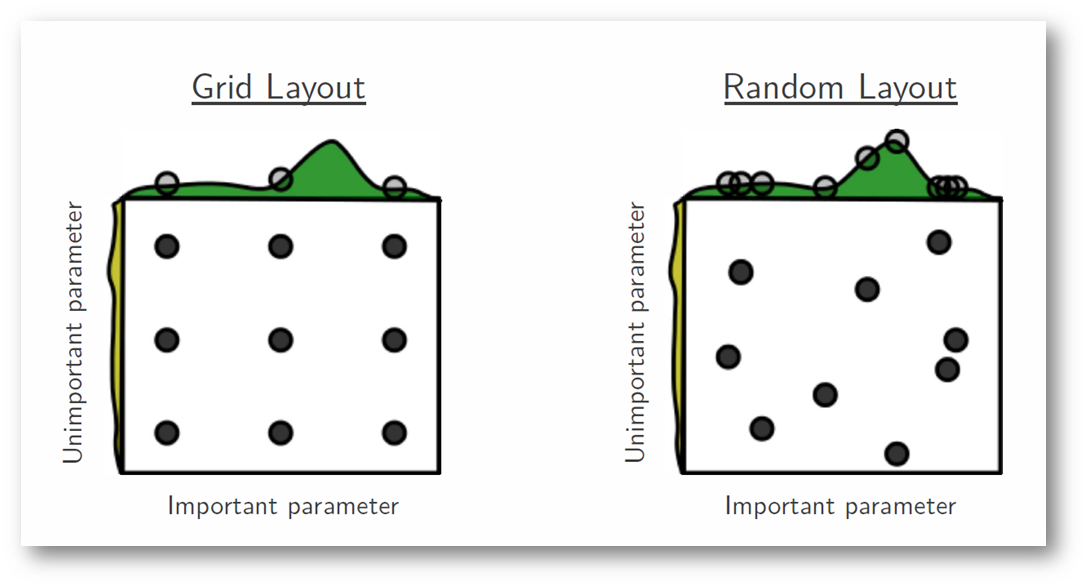
Takip eden bölümlerde, Python ile ızgara araması ve rastgele aramayı uygulamada göreceksiniz. Ayrıca hangisinin etkinlik ve verimlilik açısından daha iyi olduğuna karar verebileceksiniz.
Hiperparametre ayarlaması, sonuçları sunmadan önce uygulamalı makine öğrenimi sürecindeki son adımdır.
Pima Indian diyabet veri setini kullanacaksınız. Veri seti, veri kümesindeki 8 özelliğe bakarak bir kişinin diyabetten muzdarip olup olmayacağına dair tahminler yapmanız gereken bir sınıflandırma problemine karşılık gelir. Veri setinin tam açıklamasını burada bulabilirsiniz.
Veri setinde toplam 768 gözlem vardır. İlk göreviniz, devam edebilmek için veri setini yüklemektir. Ancak ondan önce ihtiyaç duyacağınız bağımlılıkları içe aktaralım.
# Dependencies

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
Bağımlılıkları içe aktardığımıza göre ünlü Pandas kütüphanesiyle Pima Indians veri setini bir DataFrame nesnesine yükleyelim.
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
Veri seti data adlı DataFrame nesnesine başarıyla yüklendi. Şimdi, verilere bir göz atalım.
data.head()

Böylece, 1 ve 0 olarak etiketlenmiş 8 farklı özelliği görebilirsiniz; burada 1, gözlemin diyabeti olduğunu, 0 ise gözlemin diyabeti olmadığını belirtir. Veri setinin eksik değerlere sahip olduğu bilinmektedir. Özellikle, bazı sütunlarda eksik gözlemler sıfır değer olarak işaretlenmiştir. Bunu, o sütunların tanımlarından ve beden kitle indeksi veya kan basıncı için sıfırın geçersiz olduğu gibi alan bilgisinden teyit edebiliriz.
(Eksik değerler, bir makine öğrenimi modeli kurmaya çalıştığınızda birçok soruna yol açar. Bu durumda, diyabet hastalarını tahmin etmek için bir Lojistik Regresyon sınıflandırıcısı kullanacaksınız. Ancak Lojistik Regresyon eksik değer problemlerini ele alamaz.)
(Lojistik Regresyonla ilgili hızlı bir hatırlatma isterseniz buraya bakabilirsiniz.)
Pandas'ın describe() yardımcı aracıyla veriler hakkında bazı istatistikler alalım.
data.describe()

Bu faydalı.
Bazı sütunlarda minimum değerin sıfır (0) olduğunu görebiliriz. Bazı sütunlarda sıfır değeri mantıklı değildir ve geçersiz veya eksik bir değeri gösterir.
Özellikle, aşağıdaki sütunlarda geçersiz sıfır minimum değeri vardır:
Şimdi değerleri eksik olarak tanımlayıp işaretlemeniz gerekiyor. Bunu ham veriye bakarak teyit edelim; örnek, verinin ilk 20 satırını yazdırır.
data.head(20)

Birçok sütunda 0 görüyorsunuz, değil mi?
Bu sütunların her birindeki eksik değerlerin sayısını alabilirsiniz. Bunu, ilgilendiğiniz DataFrame alt kümesindeki sıfır değerlerin tümünü True olarak işaretleyerek yapabilirsiniz. Ardından her sütundaki True değerlerin sayısını sayabilirsiniz. Bunun için veriyi sütun adları olmadan yeniden içe aktarmanız gerekecektir.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
1, 2 ve 5. sütunlarda sadece birkaç sıfır değer varken, 3 ve 4. sütunlar çok daha fazlasını, neredeyse satırların yarısını göstermektedir. 0. sütunda da birkaç eksik değer vardır, ancak bu doğaldır. 8. sütun hedef değişkeni ifade eder, dolayısıyla burada '0'ların olması doğaldır.
Bu durum, farklı sütunlar için farklı “eksik değer” stratejilerine ihtiyaç duyulabileceğini vurgular; örneğin, yine de yeterli sayıda kaydın kalmasını sağlayarak bir kestirim modeli eğitebilmek için.
Python'da, özellikle Pandas, NumPy ve Scikit-Learn'de eksik değerler NaN olarak işaretlenir.
NaN değere sahip değerler, toplam, sayım vb. işlemlerde yoksayılır.
İlgilendiğiniz sütunların bir alt kümesi üzerinde replace() işlevini kullanarak Pandas DataFrame ile değerleri kolayca NaN olarak işaretleyebilirsiniz.
Eksik değerleri işaretledikten sonra, veri setindeki tüm NaN değerlerini True olarak işaretlemek ve her sütun için eksik değer sayısını almak üzere isnull() işlevini kullanabilirsiniz.
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
1:5 sütunlarının, yukarıda sıfır değer olarak belirlenenlerle aynı sayıda eksik değere sahip olduğunu görebilirsiniz. Bu, belirlediğiniz eksik değerleri doğru şekilde işaretlediğinizin bir göstergesidir.
Bu faydalı bir özet. Ancak kendimizi kandırmadığımızdan emin olmak için gerçek verilere de bakmak isteriz.
Aşağıda aynı örnek yer alır; yalnızca verinin ilk 5 satırını yazdırırsınız.
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
Ham veriden, eksik değerleri işaretlemenin istenen etkiyi yarattığı açıkça görülmektedir. Şimdi eksik değerleri imputasyonla dolduracağız. İmputasyon, eksik değerleri değiştirmek için bir model kullanmayı ifade eder. Eksik değerleri doldurmak için çeşitli çözümler olmakla birlikte, burada ortalama imputasyonu kullanacaksınız; yani bir sütundaki eksik değerleri o sütunun ortalamasıyla değiştirmek. Bunu Pandas'ın fillna() aracıyla yapalım.
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Harika! Artık eksik değer problemini ele aldınız. Şimdi bu veriyi kullanarak scikit-learn ile bir Lojistik Regresyon modeli oluşturalım.
Önce modeli bazı rastgele hiperparametre değerleriyle göreceksiniz. Ardından iki farklı stratejiyle – Izgara araması ve Rastgele arama – iki başka Lojistik Regresyon modeli kuracaksınız.
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
Lojistik Regresyon modelini bazı rastgele hiperparametre değerleriyle oluşturdunuz. Kullandığınız hiperparametreler şunlardır:
Vaka çalışmasının ilerleyen kısımlarında, bu hiperparametreleri optimize/ayarlayarak sonuçlardaki değişimi göreceksiniz.
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
          penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False)
Şimdi doğruluk skorunu kontrol etme zamanı.
lr.score(X,y)
0.7747395833333334
Yukarıdaki adımda, LR modelinizi aynı veriye uygulayıp skorunu değerlendirdiniz. Ancak makine öğrenimi modelinizin kararlılığını doğrulama ihtiyacı her zaman vardır. Modelinizi eğitim verinize uydurup, daha önce hiç görmediği gerçek veride de doğru çalışacağını umamazsınız. Modelinizin veriden kalıpları büyük ölçüde doğru yakaladığına dair bir güvenceye ihtiyacınız var.
İşte burada Kurtarma için Çapraz Doğrulama (Cross-validation) devreye girer. Ayrıntılarına girmeyeceğim; bu blogun kapsamı dışında. Ancak bu yazı bu işi gayet iyi yapıyor.
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator

kfold = KFold(n_splits=3, random_state=7)
n_splits parametresi olarak 3 verdiniz; bu da esasen 3 katlı bir çapraz doğrulama yapar. Ayrıca random_state olarak 7 belirlediniz. Bu, sonuçları yeniden üretmek içindir. Başka herhangi bir tamsayı da verebilirdiniz. Şimdi bunu uygulayalım.
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
Skorda küçük bir düşüş olduğunu görebilirsiniz. Yine de, hiperparametre ayarlaması/optimizasyonuyla daha iyisini yapabilirsiniz.
Şimdi başka bir LR modeli oluşturalım; fakat bu kez hiperparametreleri ayarlanmış olacak. Önce bunu ızgara aramasıyla yapacaksınız.
İhtiyacınız olacak bağımlılıkları içe aktaralım. Scikit-learn bunun için GridSearchCV adlı bir yardımcı araç sağlar.
from sklearn.model_selection import GridSearchCV
Yukarıda kullandığınız hiperparametrelerin ızgara değerlerini tanımlayalım.
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
Izgarayı tanımladınız. Şimdi ızgara aramasını bunlar üzerinde çalıştırıp sonuçlara, yürütme süresiyle birlikte bakalım.
import time

lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
Daha büyük bir hiperparametre ızgarası da tanımlayıp ızgara araması uygulayabilirsiniz.
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
Doğruluk skorunda bir artış görebilirsiniz; ancak yürütme süresinde de kayda değer bir artış var. Izgara büyüdükçe yürütme süresi de artar.
Şimdi her şeyi tekrar çalıştıralım; ama bu kez rastgele aramayla. Scikit-learn bunun için RandomSearchCV sağlar. Her zamanki gibi, gerekli bağımlılıkları içe aktarmanız gerekir.
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
Vay! Rastgele arama aynı doğruluğu çok daha kısa sürede sağladı.
Vaka çalışması kısmı bu kadar. Şimdi, kapanışı yapalım!
Bu derste, bir makine öğrenimi modelinin parametreleri ve hiperparametrelerini ve aralarındaki farkları öğrendiniz. Ayrıca, verimli makine öğrenimi modelleri kurmada hiperparametre optimizasyonunun rolünü de gördünüz. scikit-learn yardımıyla Python'da basit bir Lojistik Regresyon sınıflandırıcısı kurdunuz.
Hiperparametreleri ızgara araması ve rastgele aramayla ayarladınız ve hangisinin daha iyi performans gösterdiğini gördünüz.
Ayrıca, verilerinizi makine öğrenimi modeline beslemeden önce gereken küçük veri ön işleme adımlarını (eksik değerlerin ele alınması gibi) gördünüz. Çapraz doğrulamayı da ele aldınız.
Hepsi birden çok şey ve veri bilimi yolculuğunuzda eşit derecede önemliler. Sizi bazı ek okumalarla baş başa bırakıyorum.
Ek okumalar:
Biraz daha ileri düzey olanlar için, sinir ağlarının hiperparametrelerini etkin biçimde optimize etmek üzerine bu makaleyi şiddetle öneririm. link
Makine Öğrenimi hakkında daha fazla bilgi edinmek isterseniz, DataCamp'teki şu kursları alın:
Makine Öğrenimi hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




