Tinh chỉnh siêu tham số trong Python
BasicSkill Level
4 giờ
25.5K learners
Cách hình dung siêu tham số tốt nhất là như các thiết lập của thuật toán có thể điều chỉnh để tối ưu hiệu suất, tương tự bạn vặn các núm trên radio AM để bắt tín hiệu rõ. Khi tạo một mô hình học máy, bạn sẽ phải đưa ra các lựa chọn thiết kế về kiến trúc mô hình. Thường thì bạn chưa biết ngay kiến trúc tối ưu cho một mô hình cụ thể, nên bạn muốn khám phá một dải khả năng. Theo đúng tinh thần học máy, lý tưởng là bạn để máy thực hiện việc khám phá này và tự động chọn kiến trúc tối ưu.
Bạn sẽ thấy trong phần nghiên cứu tình huống cách lựa chọn siêu tham số phù hợp ảnh hưởng đến hiệu suất mô hình ra sao. Trong bối cảnh này, việc chọn đúng bộ giá trị thường được gọi là “Tối ưu siêu tham số” hoặc “Hiệu chỉnh siêu tham số”.
Các mô hình có thể có nhiều siêu tham số và việc tìm tổ hợp tốt nhất có thể xem là một bài toán tìm kiếm.
Dù hiện có nhiều thuật toán tối ưu/hiệu chỉnh siêu tham số, bài viết này bàn về hai chiến lược đơn giản: 1. tìm kiếm lưới (grid search) và 2. Tìm kiếm ngẫu nhiên (Random Search).
Tìm kiếm lưới là cách tiếp cận hiệu chỉnh siêu tham số sẽ xây dựng và đánh giá mô hình một cách có hệ thống cho mỗi tổ hợp tham số thuật toán được chỉ định trong một lưới.
Xét ví dụ sau:
Giả sử mô hình học máy X nhận các siêu tham số a1, a2 và a3. Trong tìm kiếm lưới, trước tiên bạn xác định miền giá trị cho từng siêu tham số a1, a2 và a3. Có thể xem đây là một mảng giá trị cho từng siêu tham số. Kỹ thuật tìm kiếm lưới sẽ tạo ra nhiều phiên bản của X với tất cả các tổ hợp có thể của các giá trị (a1, a2, a3) mà bạn đã định nghĩa. Miền giá trị này được gọi là lưới.
Giả sử, bạn định nghĩa lưới như sau:
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
Lưu ý, mảng giá trị bạn định nghĩa cho các siêu tham số phải hợp lệ; bạn không thể cung cấp giá trị Floating nếu siêu tham số chỉ nhận giá trị Integer.
Giờ đây, tìm kiếm lưới sẽ bắt đầu quá trình tạo nhiều phiên bản của X dựa trên lưới bạn vừa định nghĩa.
Nó sẽ bắt đầu với tổ hợp [0,10,105], và kết thúc với [5,60,125]. Nó sẽ duyệt qua tất cả tổ hợp trung gian giữa hai tổ hợp này, khiến tìm kiếm lưới rất tốn chi phí tính toán.
Hãy xem kỹ thuật tìm kiếm khác: Tìm kiếm ngẫu nhiên:
Ý tưởng tìm kiếm ngẫu nhiên cho siêu tham số được đề xuất bởi James Bergstra & Yoshua Bengio. Bạn có thể xem bài báo gốc tại đây.
Tìm kiếm ngẫu nhiên khác với tìm kiếm lưới. Ở chỗ bạn không còn cung cấp một tập giá trị rời rạc để khảo sát cho mỗi siêu tham số; thay vào đó, bạn cung cấp một phân phối xác suất cho mỗi siêu tham số, từ đó các giá trị có thể được lấy mẫu ngẫu nhiên.
Trước khi đi xa hơn, hãy hiểu “phân phối” và “lấy mẫu” nghĩa là gì:
Trong Thống kê, phân phối về bản chất là sự sắp xếp các giá trị của một biến thể hiện tần suất xuất hiện quan sát được hoặc lý thuyết của chúng.
Mặt khác, Lấy mẫu là thuật ngữ trong thống kê. Đó là quá trình chọn một mẫu đại diện từ quần thể mục tiêu và thu thập dữ liệu từ mẫu đó để hiểu về quần thể nói chung.
Giờ hãy quay lại khái niệm tìm kiếm ngẫu nhiên.
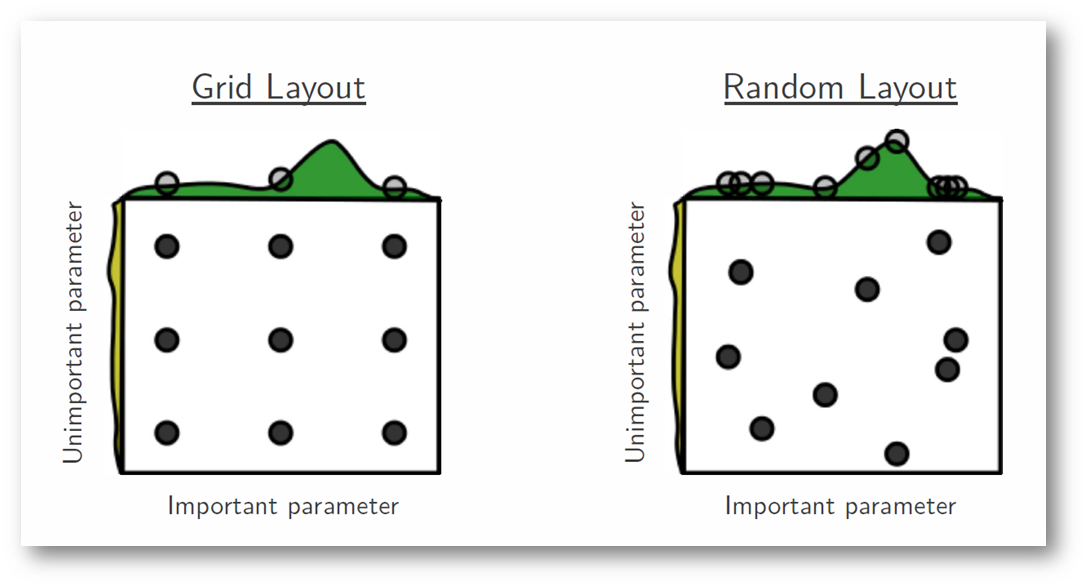
Bạn sẽ xác định một phân phối lấy mẫu cho mỗi siêu tham số. Bạn cũng có thể xác định số vòng lặp bạn muốn xây dựng khi tìm mô hình tối ưu. Ở mỗi vòng lặp, giá trị siêu tham số của mô hình sẽ được thiết lập bằng cách lấy mẫu từ các phân phối đã định nghĩa. Một cơ sở lý thuyết chính thúc đẩy việc dùng tìm kiếm ngẫu nhiên thay cho tìm kiếm lưới là ở hầu hết các trường hợp, siêu tham số không quan trọng như nhau. Theo bài báo gốc:
“…với hầu hết các tập dữ liệu, chỉ có một vài siêu tham số thực sự quan trọng, nhưng các siêu tham số quan trọng lại khác nhau trên các tập dữ liệu khác nhau. Hiện tượng này khiến tìm kiếm lưới trở thành lựa chọn kém hiệu quả khi cấu hình thuật toán cho các tập dữ liệu mới.”
Trong hình sau, chúng ta tìm kiếm trên không gian siêu tham số mà một siêu tham số có ảnh hưởng lớn hơn đáng kể đến tối ưu hóa điểm số mô hình — các phân phối trên mỗi trục biểu diễn điểm số mô hình. Trong mỗi trường hợp, ta đánh giá chín mô hình khác nhau. Chiến lược tìm kiếm lưới bỏ lỡ mô hình tối ưu và tốn thời gian lặp thừa ở tham số kém quan trọng. Trong tìm kiếm lưới này, ta cô lập từng siêu tham số và tìm giá trị tốt nhất trong khi giữ các siêu tham số khác cố định. Với các trường hợp siêu tham số đang xét ít ảnh hưởng đến điểm số, nỗ lực đó bị lãng phí. Ngược lại, tìm kiếm ngẫu nhiên có khả năng khám phá tốt hơn nhiều và có thể tập trung tìm giá trị tối ưu cho siêu tham số then chốt.
Ở các phần tiếp theo, bạn sẽ thấy tìm kiếm lưới và tìm kiếm ngẫu nhiên vận hành bằng Python. Bạn cũng sẽ có thể quyết định cách nào hiệu quả và hiệu suất hơn.
Hiệu chỉnh siêu tham số là bước cuối trong quy trình học máy ứng dụng trước khi trình bày kết quả.
Bạn sẽ dùng tập dữ liệu tiểu đường Pima Indian. Tập dữ liệu tương ứng với một bài toán phân loại trong đó bạn cần dự đoán một người có khả năng mắc tiểu đường hay không dựa trên 8 đặc trưng. Bạn có thể xem mô tả đầy đủ tại đây.
Tổng cộng có 768 quan sát trong tập dữ liệu. Nhiệm vụ đầu tiên là tải dữ liệu để có thể tiếp tục. Trước đó, hãy nhập các thư viện phụ thuộc cần dùng.
# Dependencies

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
Giờ các phụ thuộc đã được nhập, hãy nạp tập dữ liệu Pima Indians vào một đối tượng DataFrame bằng thư viện Pandas nổi tiếng.
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
Tập dữ liệu đã được nạp thành công vào đối tượng DataFrame data. Bây giờ, hãy xem qua dữ liệu.
data.head()

Bạn có thể thấy 8 đặc trưng khác nhau được gán nhãn kết quả 1 và 0, trong đó 1 là có tiểu đường và 0 là không có. Tập dữ liệu được biết là có giá trị thiếu. Cụ thể, một số cột có quan sát thiếu được đánh dấu bằng giá trị 0. Ta có thể kiểm chứng điều này từ định nghĩa của các cột và hiểu biết miền rằng giá trị 0 là không hợp lệ cho các thước đo đó, ví dụ 0 cho chỉ số khối cơ thể hoặc huyết áp là không hợp lệ.
(Giá trị thiếu gây ra nhiều vấn đề khi bạn xây dựng mô hình học máy. Trong trường hợp này, bạn sẽ dùng bộ phân loại Hồi quy Logistic để dự đoán bệnh nhân có tiểu đường hay không. Hồi quy Logistic không thể tự xử lý vấn đề giá trị thiếu.)
(Nếu bạn muốn ôn nhanh về Hồi quy Logistic, có thể tham khảo tại đây.)
Hãy xem một số thống kê về dữ liệu bằng tiện ích describe() của Pandas.
data.describe()

Khá hữu ích.
Ta thấy có những cột có giá trị nhỏ nhất bằng 0. Với một số cột, giá trị 0 là vô nghĩa và cho thấy giá trị không hợp lệ hoặc bị thiếu.
Cụ thể, các cột sau có giá trị tối thiểu bằng 0 không hợp lệ:
Giờ bạn cần xác định và đánh dấu các giá trị là thiếu. Hãy xác nhận bằng cách xem dữ liệu thô; ví dụ dưới đây in 20 dòng đầu tiên.
data.head(20)

Bạn thấy số 0 ở vài cột, đúng không?
Bạn có thể đếm số lượng giá trị thiếu ở từng cột này. Cách làm là đánh dấu tất cả giá trị 0 trong tập con DataFrame bạn quan tâm là True. Sau đó đếm số giá trị True ở mỗi cột. Để làm điều này, bạn sẽ cần nhập lại dữ liệu mà không có tên cột.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Bạn thấy các cột 1, 2 và 5 chỉ có vài giá trị 0, trong khi cột 3 và 4 có nhiều hơn rất nhiều, gần một nửa số hàng. Cột 0 có vài giá trị thiếu nhưng điều đó là tự nhiên. Cột 8 biểu thị biến mục tiêu nên các giá trị ‘0’ ở đó là bình thường.
Điều này cho thấy có thể cần những chiến lược xử lý “giá trị thiếu” khác nhau cho từng cột, ví dụ để đảm bảo vẫn còn đủ bản ghi để huấn luyện mô hình dự đoán.
Trong Python, cụ thể là Pandas, NumPy và Scikit-Learn, bạn đánh dấu giá trị thiếu bằng NaN.
Các giá trị NaN sẽ bị bỏ qua trong các phép như tổng, đếm, v.v.
Bạn có thể đánh dấu các giá trị là NaN dễ dàng bằng DataFrame của Pandas với hàm replace() trên tập con các cột quan tâm.
Sau khi đã đánh dấu giá trị thiếu, bạn có thể dùng hàm isnull() để đánh dấu tất cả giá trị NaN trong tập dữ liệu là True và đếm số giá trị thiếu cho mỗi cột.
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Bạn thấy các cột 1:5 có số lượng giá trị thiếu giống hệt số lượng giá trị 0 đã xác định ở trên. Đây là dấu hiệu bạn đã đánh dấu đúng các giá trị thiếu.
Tổng kết này khá hữu ích. Nhưng bạn vẫn muốn xem dữ liệu thực tế để chắc chắn mình không nhầm.
Dưới đây là ví dụ tương tự, nhưng in 5 dòng đầu tiên.
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
Rõ ràng từ dữ liệu thô rằng việc đánh dấu giá trị thiếu đã cho kết quả như mong đợi. Giờ bạn sẽ nội suy (impute) các giá trị thiếu. Nội suy nghĩa là dùng một mô hình để thay thế giá trị thiếu. Dù có nhiều cách nội suy, ở đây bạn sẽ dùng nội suy trung bình, tức thay giá trị thiếu trong một cột bằng giá trị trung bình của chính cột đó. Hãy làm điều này với tiện ích fillna() của Pandas.
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Tuyệt vời! Bạn đã xử lý xong vấn đề giá trị thiếu. Bây giờ hãy dùng dữ liệu này để xây dựng mô hình Hồi quy Logistic bằng scikit-learn.
Đầu tiên, bạn sẽ xem mô hình với một số giá trị siêu tham số ngẫu nhiên. Sau đó, bạn sẽ xây dựng hai mô hình Hồi quy Logistic khác với hai chiến lược — Tìm kiếm lưới và Tìm kiếm ngẫu nhiên.
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
Bạn đã tạo mô hình Hồi quy Logistic với một số giá trị siêu tham số ngẫu nhiên. Các siêu tham số bạn dùng là:
Ở phần sau của nghiên cứu tình huống, bạn sẽ tối ưu/hiệu chỉnh các siêu tham số này để xem sự thay đổi về kết quả.
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
          penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False)
Đến lúc kiểm tra điểm chính xác.
lr.score(X,y)
0.7747395833333334
Ở bước trên, bạn áp dụng mô hình LR lên cùng dữ liệu và đánh giá điểm số. Nhưng luôn cần xác thực độ ổn định của mô hình học máy. Bạn không thể chỉ fit mô hình vào dữ liệu huấn luyện rồi hy vọng nó sẽ hoạt động chính xác với dữ liệu thực mà nó chưa từng thấy. Bạn cần một mức đảm bảo rằng mô hình đã nắm bắt đúng phần lớn các mẫu trong dữ liệu.
Rất may, có Cross-validation. Tôi sẽ không đi sâu chi tiết vì ngoài phạm vi bài viết. Nhưng bài viết này giải thích rất tốt.
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator

kfold = KFold(n_splits=3, random_state=7)
Bạn đặt n_splits là 3, tức là cross-validation 3 lần gập. Bạn cũng đặt random_state là 7 để có thể tái lập kết quả. Bạn có thể đặt bất kỳ số nguyên nào khác. Giờ hãy áp dụng.
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
Bạn thấy điểm số giảm nhẹ. Dù sao, bạn có thể làm tốt hơn với tối ưu/hiệu chỉnh siêu tham số.
Hãy xây dựng một mô hình LR khác, lần này các siêu tham số sẽ được hiệu chỉnh. Trước hết với tìm kiếm lưới.
Hãy nhập các phụ thuộc cần thiết. Scikit-learn cung cấp tiện ích GridSearchCV cho việc này.
from sklearn.model_selection import GridSearchCV
Hãy định nghĩa các giá trị lưới cho những siêu tham số bạn đã dùng ở trên.
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
Bạn đã định nghĩa lưới. Hãy chạy tìm kiếm lưới trên đó và xem kết quả cùng thời gian thực thi.
import time

lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
Bạn cũng có thể định nghĩa một lưới siêu tham số lớn hơn và áp dụng tìm kiếm lưới.
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
Bạn thấy độ chính xác tăng lên, nhưng thời gian thực thi cũng tăng đáng kể. Lưới càng lớn, thời gian chạy càng nhiều.
Hãy chạy lại mọi thứ nhưng lần này dùng tìm kiếm ngẫu nhiên. Scikit-learn cung cấp RandomSearchCV cho việc đó. Như thường lệ, bạn cần nhập các phụ thuộc cần thiết.
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)

start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
Ồ! Tìm kiếm ngẫu nhiên cho ra độ chính xác tương tự nhưng thời gian ngắn hơn nhiều.
Phần nghiên cứu tình huống đến đây là hết. Giờ hãy tổng kết!
Trong hướng dẫn này, bạn đã tìm hiểu về tham số và siêu tham số của một mô hình học máy và sự khác nhau giữa chúng. Bạn cũng biết vai trò của tối ưu siêu tham số trong việc xây dựng các mô hình học máy hiệu quả. Bạn đã xây dựng một bộ phân loại Hồi quy Logistic đơn giản trong Python với scikit-learn.
Bạn đã hiệu chỉnh siêu tham số với tìm kiếm lưới và tìm kiếm ngẫu nhiên và thấy cách nào hoạt động tốt hơn.
Ngoài ra, bạn đã thấy các bước tiền xử lý dữ liệu nhỏ (như xử lý giá trị thiếu) cần thực hiện trước khi đưa dữ liệu vào mô hình học máy. Bạn cũng đã đề cập tới Cross-validation.
Có khá nhiều nội dung, và tất cả đều quan trọng như nhau trong hành trình khoa học dữ liệu của bạn. Tôi xin để lại một số tài liệu đọc thêm.
Tài liệu đọc thêm:
Với những bạn đã ở mức nâng cao hơn, tôi rất khuyến nghị đọc bài báo này để tối ưu hiệu quả siêu tham số của mạng nơ-ron. link
Nếu bạn muốn học thêm về Học máy, hãy tham gia các khóa học sau từ DataCamp:
Tìm hiểu thêm về Học máy
Khóa học
Khóa học
Khóa học