

在 Power BI 中创建您的第一个预测模型
在 Power BI 中构建预测模型需要多个步骤,从准备数据、使用 R 或 Python 拟合模型,到部署并在后续对模型进行监控。
我们将通过逐步演示,带您使用 Python 和一份来自 DataCamp 的客户流失数据集在 Power BI 中创建第一个预测模型。您还可以查看我们完整的用 Python 预测客户流失课程,更深入地了解客户流失与营销分析。
1. 选择合适的算法
在 Power BI 中为预测分析选择合适的算法对于获得准确且有意义的结果至关重要。预测分析并不存在“一刀切”的算法,正确选择取决于您的具体数据、目标和约束条件。
在我们的示例中,目标变量是二元的(客户是否流失),因此将构建一个分类模型。
以下是一些帮助您确定最适合数据的算法的指南:
了解您的数据和目标:
- 数据类型:考虑您的数据性质(分类型、数值型、时间序列等)。
- 业务目标:明确您要预测的内容(如分类、回归、聚类)。
- 数据规模与质量:数据的体量与质量会影响算法的选择。
算法适配性:
- 回归算法(如线性回归)适用于预测连续型结果,如销售预测。
- 分类算法(如逻辑回归、决策树和随机森林)用于预测分类型结果(如本例中的客户是否流失)。
- 聚类算法(如k-means)适合将数据分割为具有相似特征的群组。
- 时间序列分析(如ARIMA 模型)用于基于时间序列数据进行预测。
复杂度与可解释性:较简单的模型(如线性回归和决策树)更易解释,也更容易向相关方说明。在某些情况下,更复杂的模型(如神经网络)可能提供更高的准确性,但难以解释,且往往需要更多计算资源。
实验与验证:选择一个不仅能准确预测目标、且能很好泛化到未见数据的模型是明智之举。您可以通过尝试多种算法并比较其性能指标来实现这一点。
2. 准备数据
首先,将用于预测模型的数据导入 Power BI(若要使用 R 和 Python 脚本,数据必须导入)。接着,您可以使用 Power Query 清洗并准备数据用于分析。这可能涉及处理缺失值、筛选、创建新的计算列等。
3. 编写 Python 脚本
在 Power BI Desktop 中,您需要先启用 Python 脚本功能。转到“文件 -> 选项和设置 -> 选项 -> Python 脚本”来设置您的 Python 环境。
在 Power Query 编辑器中,您可以在功能区的“转换”选项卡中选择“运行 Python 脚本”。这会弹出一个对话框,您可以在其中输入 Python 代码。以下是我们用于客户流失模型的脚本:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
# Separate features from the target variable
X = dataset.drop('Churn', axis=1) # Features
y = dataset['Churn'] # Target variable
# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)
# Initialize and train the logistic regression model
model = LogisticRegression()
model.fit(X_train, y_train)
# Make predictions on the test set
y_pred = model.predict(X_test)
# Evaluate the model using various metrics like accuracy, precision, recall, etc.
# If you are happy with your model, obtain final predictions.
# Append predictions to the full dataset
dataset['Predicted_Label'] = model.predict(X)
dataset['Predicted_Probability'] = model.predict_proba(X)[:, 1]4. 可视化预测模型
运行 Python 脚本后,您可以在 Power BI 中可视化输出结果。在上面的 Python 脚本中,我们将预测标签和概率追加到了完整数据集中。这使我们能够可视化各特征变量对概率的影响,并构建一个讲述我们数据与预测结果故事的仪表板。
如果您想提升Power BI 数据可视化技能,并学习如何在 Power BI 中创建高效的报表,我们也提供相关课程供您学习。
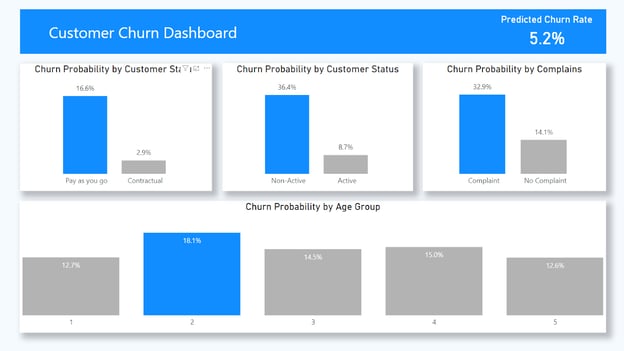
图片由作者提供
5. 部署与监控预测模型
当您的模型准备就绪并完成可视化后,您可以将 Power BI 报表发布到 Power BI 服务,以便在组织范围内更广泛地访问。发布到 Power BI 服务后,您可以设置计划刷新,以确保模型使用最新数据。请注意,包含 Python 或 R 脚本的报表仅能使用个人网关进行刷新。
请定期监控模型的性能,确保其随时间推移依然准确。如果模型性能或数据模式发生变化,您应在 Power BI Desktop 中更新模型并重新发布报表。例如,模型中的某个变量可能不再相关,或者公司可能已停止收集该变量的数据。
常见挑战及应对最佳实践
与任何分析平台一样,Power BI 中的预测分析也会面临一系列挑战。理解这些挑战并采用最佳实践有助于减轻潜在问题。以下是一些常见挑战及其解决方案:
1. 数据质量与准备
挑战:预测分析高度依赖数据质量。缺失值、不一致的数据格式以及异常值等问题会显著影响模型准确性。
解决方案:建立数据清洗与预处理流程,维护数据及预测模型的质量与可靠性。
2. 选择合适的模型
挑战:选择不合适的预测模型会导致糟糕的预测效果,且为您的数据挑选合适的算法有时并不容易。
解决方案:清晰定义业务问题并花时间理解数据,有助于您选出最合适的模型。您还可以测试不同模型,并使用准确率、精确率、召回率等指标比较其性能,以指导决策。
3. 模型过拟合
挑战:当模型过于复杂并学习到了训练数据中的噪声时,就会发生过拟合,从而在新数据上表现不佳。
解决方案:将数据划分为训练集与测试集,以验证模型性能;并在训练中考虑使用正则化方法来防止过拟合。
4. 处理大型数据集
挑战:对于超大型数据集,Power BI 可能会出现性能问题,尤其是在执行 R 和 Python 脚本时。此外,还存在额外限制:任何运行超过 30 分钟的 Python 脚本都会超时。
解决方案:仅导入所需数据,并尽可能进行聚合以优化性能。您也可以考虑单独训练预测模型,仅将预测结果导入 Power BI。此方法可避免每次刷新都重新训练模型,从而降低持续超时的风险。
此外,您可以在 Power BI 中使用参数来控制何时重新训练模型。例如,您可以设置一个参数来决定是否运行训练代码,并根据参数值调整 Python 代码:
parameter_value = int(dataset['ModelRefreshControl'][0]) # Assuming the parameter is passed as a column in the dataset
if parameter_value == 1:
# Code to train the model
# model.fit(X_train, y_train)
else:
# Code to load the pre-trained model
# model = load_model('my_model')5. 数据隐私与安全
挑战:在处理敏感数据时,确保数据安全与合规可能颇具挑战。
解决方案:实施严格的数据治理策略,并考虑在 Power BI 报表中采用行级安全等良好安全实践。值得注意的是,为了使包含 Python 脚本的报表在发布到 Power BI 服务后能够正常运行,所有数据源必须是公开的。请权衡此要求对您的数据隐私与安全需求的影响。
6. 确保模型可解释性
挑战:某些复杂模型(如神经网络)难以解释,导致难以理解与说明结果。
解决方案:在可能的情况下,优先使用更容易解释并向相关方说明的简单模型(如决策树)。
结语
Power BI 直观的用户界面、内置算法以及全面的数据处理能力,使您能够在数据中进行分析、可视化并预测趋势与模式。Power BI 让构建预测模型变得简单,帮助您做出明智决策并领先竞争对手。
如果您对从事Power BI 数据分析师的职业感兴趣,我们的职业路径将带您全面掌握 Power BI,并为微软 PL-300 认证做好准备。
如果您已掌握 Power BI 基础,不妨查看我们整理的8 个 Power BI 项目,用于实践技能并丰富您的作品集。

Power BI 是一款功能强大的商业智能工具,可帮助您轻松分析和可视化数据。然而,使其真正从众多产品中脱颖而出的是其预测分析功能以及对 R 和 Python 的支持,借此您可以将分析提升到新的水平。
在本文中,我们将探讨如何在 Power BI 中进行预测分析、其优势,以及如何在 Power BI 中创建您的第一个预测模型。
您可以使用我们的 Power BI 速查表快速上手 Power BI——从创建您的第一个可视化到 Power Query 和 DAX 计算。
Power BI 如何用于预测分析?
预测分析涉及使用统计学和机器学习技术来对未来事件进行预测或预报。您可以在一篇单独的博文中进一步了解预测分析。
不过,Power BI 中预测分析的成效在很大程度上取决于您的数据质量以及所选模型的适用性。要高效实施预测分析,理解统计学和机器学习概念非常重要。
以下是在 Power BI 中开展预测分析的方法:
使用 DAX 进行简单预测对于更简单的预测任务,您可以在 Power BI 中使用 DAX 创建新的计算列或度量值。例如,假设两次销售之间的时间可以用来预测客户何时会再次购买。您可以创建一些 DAX 度量,分别计算每位客户及整体的平均销售间隔时间,并据此预测下一次销售可能发生的时间。
使用 R 和 Python 脚本
Power BI 支持 R 和 Python,这两种语言在数据分析和机器学习方面都非常强大。您可以直接在 Power BI 中编写预测分析脚本。运行 R 或 Python 脚本后,您可以在 Power BI 中可视化结果,并构建功能强大的仪表板,不仅呈现过去发生的情况,还能洞见未来的可能。
使用 Power BI 内置可视化
您可以使用现有的可视化(如散点图、折线图等)来展示趋势和模式。Power BI 还在这些可视化中内置了预测功能——例如从散点图中查找聚类,或在折线图中预测未来销售。
如果您立志成为数据分析师,可以通过我们的技能路径学习 Power BI 基础,了解数据可视化、DAX 以及如何转换数据。还可以观看我们关于如何借助 Power BI 成为数据分析师的网络研讨会。
在预测分析中使用 Power BI 的优势
在预测分析中使用 Power BI 有多项优势,尤其适用于已熟悉微软生态的用户。对于任何希望获得一款易用、可扩展且安全的数据分析与预测工具的人来说,Power BI 也是极佳选择。
以下是一些关键优势:
直观的用户界面
Power BI 以其用户友好的界面和拖放式报表构建器而闻名,即使不是数据科学家也能轻松上手。这简化了数据处理和可视化过程,使用户能够相对轻松地执行复杂的分析任务。
内置算法
在 Power BI 的部分可视化中,您可以直接实现诸如线性回归或聚类等机器学习模型,而无需掌握编码。这使预测分析不再只属于有预算雇佣分析团队的少数人,而是面向更广泛的用户群体。
对于高级用户,Power BI 支持 R 和 Python 自定义脚本,从而实现更复杂、更契合业务需求的预测模型。
全面的数据处理能力
Power BI 可以连接到多种数据源,包括云端和本地数据,无论数据存储在何处,都能确保开展全面的数据分析。您甚至可以直接连接第三方应用,减少对单独 ETL 软件的需求。
Power BI 还提供强大的数据转换与清洗工具,这是为预测分析准备数据的关键步骤。