

Power BI में अपना पहला प्रेडिक्टिव मॉडल बनाना
Power BI में प्रेडिक्टिव मॉडल बनाना कई चरणों में होता है—डेटा तैयार करने और R या Python का उपयोग करके मॉडल फिट करने से लेकर मॉडल को डिप्लॉय करने और बाद में मॉनिटर करने तक।
हम आपको Python और DataCamp के कस्टमर चर्न डेटासेट का उपयोग करके Power BI में अपना पहला प्रेडिक्टिव मॉडल बनाने की चरण-दर-चरण प्रक्रिया से ले चलेंगे। आप हमारा पूरा कोर्स भी देख सकते हैं: Python में कस्टमर चर्न की भविष्यवाणी, जिसमें कस्टमर चर्न और मार्केटिंग एनालिटिक्स का गहन वॉकथ्रू है।
1. सही एल्गोरिद्म का चयन
Power BI में प्रेडिक्टिव एनालिटिक्स के लिए सही एल्गोरिद्म चुनना सटीक और सार्थक परिणाम प्राप्त करने के लिए अत्यंत महत्वपूर्ण है। प्रेडिक्टिव एनालिटिक्स में कोई एक ऐसा एल्गोरिद्म नहीं है जो हर स्थिति पर फिट बैठे—सही चुनाव आपके विशेष डेटा, लक्ष्यों और बाधाओं पर निर्भर करता है।
हमारे उदाहरण में हम एक classification मॉडल बनाएँगे, क्योंकि हमारा टारगेट वेरिएबल बाइनरी है (ग्राहक चर्न करेगा या नहीं)।
यहाँ कुछ दिशानिर्देश हैं जो तय करने में मदद करेंगे कि आपके डेटा के लिए कौन सा एल्गोरिद्म उपयुक्त है:
अपने डेटा और उद्देश्यों को समझें:
- डेटा का प्रकार: अपने डेटा की प्रकृति पर विचार करें (श्रेणीबद्ध, संख्यात्मक, समय-श्रृंखला आदि)।
- व्यावसायिक उद्देश्य: पहचानें कि आप क्या पूर्वानुमान लगाना चाहते हैं (जैसे classification, regression, clustering)।
- डेटा का आकार और गुणवत्ता: आपके डेटा की मात्रा और गुणवत्ता एल्गोरिद्म के चयन को प्रभावित कर सकती है।
एल्गोरिद्म की उपयुक्तता:
- रिग्रेशन एल्गोरिद्म (जैसे linear regression) सतत आउटकम का पूर्वानुमान लगाने के लिए उपयुक्त हैं, जैसे बिक्री का फ़ोरकास्टिंग।
- क्लासिफिकेशन एल्गोरिद्म (जैसे logistic regression, decision trees, और random forest) श्रेणीबद्ध आउटकम का पूर्वानुमान लगाने के लिए उपयोग होते हैं (हमारे उदाहरण में कस्टमर चर्न की तरह)।
- क्लस्टरिंग एल्गोरिद्म (जैसे k-means) समान विशेषताओं वाले समूहों में डेटा को विभाजित करने के लिए आदर्श हैं।
- टाइम सीरीज़ विश्लेषण (जैसे ARIMA मॉडल) समय-आधारित डेटा पर आधारित पूर्वानुमान के लिए उपयोग होता है।
जटिलता और व्याख्येयता: सरल मॉडल (जैसे linear regression और decision trees) की व्याख्या करना आसान होता है और हितधारकों को समझाना सरल होता है। अधिक जटिल मॉडल (जैसे neural networks) कुछ मामलों में अधिक सटीकता दे सकते हैं, लेकिन उनकी व्याख्या कठिन होती है और अक्सर कहीं अधिक कंप्यूटेशनल संसाधनों की आवश्यकता होती है।
प्रयोग और वैलिडेशन: ऐसा मॉडल चुनना अच्छा विचार है जो न केवल लक्ष्य को सटीकता से भविष्यवाणी करे बल्कि अनदेखे डेटा पर भी अच्छी तरह सामान्यीकृत हो। आप यह कई एल्गोरिद्म के साथ प्रयोग करके और उनके प्रदर्शन मेट्रिक्स की तुलना करके कर सकते हैं।
2. अपना डेटा तैयार करना
उस डेटा को Power BI में इम्पोर्ट करके शुरू करें जिसका उपयोग आप अपने प्रेडिक्टिव मॉडल के लिए करेंगे (R और Python स्क्रिप्ट्स का उपयोग करने के लिए डेटा इम्पोर्ट किया जाना चाहिए)। अगला कदम Power Query का उपयोग करके अपने डेटा को विश्लेषण के लिए साफ़ और तैयार करना है। इसमें missing values से निपटना, फ़िल्टर लगाना, नए calculated कॉलम बनाना आदि शामिल हो सकते हैं।
3. Python स्क्रिप्ट लिखना
Power BI Desktop में आपको पहले Python स्क्रिप्टिंग सक्षम करनी होगी। इसके लिए File -> Options and Settings -> Options -> Python scripting पर जाएँ और अपना Python वातावरण सेट करें।
Power Query Editor में, आप रिबन के Transform टैब से Run Python Script चुन सकते हैं। इससे एक डायलॉग बॉक्स खुलेगा जहाँ आप अपना Python कोड दर्ज कर सकते हैं। हमारे कस्टमर चर्न मॉडल के लिए हम यह स्क्रिप्ट उपयोग कर रहे हैं:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
# Separate features from the target variable
X = dataset.drop('Churn', axis=1) # Features
y = dataset['Churn'] # Target variable
# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)
# Initialize and train the logistic regression model
model = LogisticRegression()
model.fit(X_train, y_train)
# Make predictions on the test set
y_pred = model.predict(X_test)
# Evaluate the model using various metrics like accuracy, precision, recall, etc.
# If you are happy with your model, obtain final predictions.
# Append predictions to the full dataset
dataset['Predicted_Label'] = model.predict(X)
dataset['Predicted_Probability'] = model.predict_proba(X)[:, 1]4. प्रेडिक्टिव मॉडल का विज़ुअलाइज़ेशन
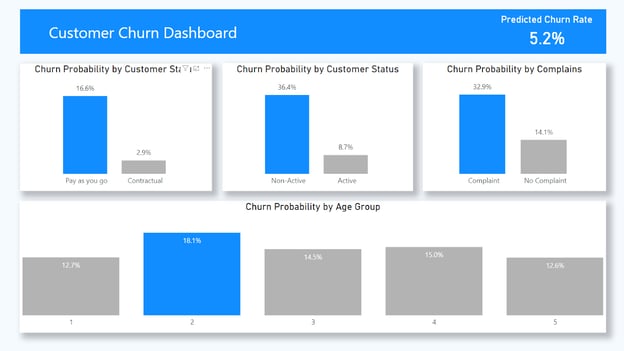
Python स्क्रिप्ट चलाने के बाद, आप आउटपुट को Power BI में विज़ुअलाइज़ कर सकते हैं। ऊपर दी गई Python स्क्रिप्ट में, हमने पूरी डेटासेट में प्रेडिक्टेड लेबल और प्रॉबेबिलिटीज़ को जोड़ा है। इससे हमें फ़ीचर वेरिएबल्स के प्रभाव को प्रॉबेबिलिटीज़ पर विज़ुअलाइज़ करने और एक ऐसा डैशबोर्ड बनाने में मदद मिलती है जो हमारे डेटा और भविष्यवाणियों के बारे में कहानी बताए।
यदि आप अपनी Power BI डेटा विज़ुअलाइज़ेशन स्किल्स को स्तर ऊपर ले जाना चाहते हैं और Power BI में प्रभावी रिपोर्ट्स बनाना सीखना चाहते हैं, तो इसके लिए हमारे पास कोर्स उपलब्ध हैं।
छवि: लेखक
5. प्रेडिक्टिव मॉडल को डिप्लॉय और मॉनिटर करना
जब आपका मॉडल तैयार हो जाए और विज़ुअलाइज़ हो जाए, तो आप Power BI रिपोर्ट को अपने संगठन में व्यापक पहुँच के लिए Power BI सर्विस पर प्रकाशित कर सकते हैं। Power BI सर्विस में आप शेड्यूल्ड रिफ्रेश सेट कर सकते हैं ताकि आपका मॉडल सबसे ताज़ा डेटा का उपयोग करे। ध्यान दें कि Python या R स्क्रिप्ट्स वाली रिपोर्ट्स को रिफ्रेश करने के लिए केवल Personal Gateway का उपयोग किया जा सकता है।
समय-समय पर अपने मॉडल के प्रदर्शन की निगरानी करें ताकि यह सुनिश्चित हो सके कि वह समय के साथ सटीक बना रहे। यदि मॉडल के प्रदर्शन में कोई बदलाव आता है या डेटा पैटर्न बदलते हैं, तो आपको Power BI Desktop में अपना मॉडल अपडेट करना चाहिए और रिपोर्ट को पुन: प्रकाशित करना चाहिए। उदाहरण के लिए, आपके मॉडल का कोई वेरिएबल अब प्रासंगिक न रह गया हो, या आपकी कंपनी उसका डेटा संग्रह करना बंद कर दे।
सामान्य चुनौतियाँ और उनसे निपटने के सर्वोत्तम अभ्यास
Power BI में प्रेडिक्टिव एनालिटिक्स, जैसे किसी भी एनालिटिक्स प्लेटफ़ॉर्म में, अपनी कुछ चुनौतियों के साथ आता है। इन चुनौतियों को समझना और सर्वोत्तम अभ्यास अपनाना संभावित समस्याओं को कम करने में मदद कर सकता है। यहाँ कुछ सामान्य चुनौतियाँ और समाधान दिए गए हैं:
1. डेटा गुणवत्ता और तैयारी
चुनौती: प्रेडिक्टिव एनालिटिक्स काफी हद तक डेटा की गुणवत्ता पर निर्भर करता है। missing values, असंगत डेटा फ़ॉर्मैट, और आउट्लायर्स जैसी समस्याएँ मॉडल की सटीकता पर गंभीर प्रभाव डाल सकती हैं।
समाधान: डेटा की गुणवत्ता और विश्वसनीयता बनाए रखने के लिए डेटा क्लीनिंग और प्रीप्रोसेसिंग की एक नियमित प्रक्रिया स्थापित करें—ताकि आपका डेटा और आपके प्रेडिक्टिव मॉडल दोनों भरोसेमंद रहें।
2. सही मॉडल का चयन
चुनौती: अनुपयुक्त प्रेडिक्टिव मॉडल चुनने से खराब भविष्यवाणियाँ हो सकती हैं, और अपने डेटा के लिए सही एल्गोरिद्म चुनना कभी-कभी चुनौतीपूर्ण होता है।
समाधान: व्यावसायिक समस्या को स्पष्ट रूप से परिभाषित करें और डेटा को समझने में समय दें—यह सबसे उपयुक्त मॉडल चुनने में मदद करेगा। आप विभिन्न मॉडलों का परीक्षण कर सकते हैं और accuracy, precision और recall जैसे मेट्रिक्स का उपयोग करके उनके प्रदर्शन की तुलना कर सकते हैं।
3. मॉडल का ओवरफ़िट होना
चुनौती: ओवरफ़िटिंग तब होता है जब कोई मॉडल बहुत जटिल होता है और ट्रेनिंग डेटा के शोर को सीख लेता है, जिससे नए डेटा पर प्रदर्शन खराब हो जाता है।
समाधान: मॉडल के प्रदर्शन को वैलिडेट करने के लिए डेटा को training और testing सेट में विभाजित करें, और ओवरफ़िटिंग रोकने के लिए मॉडल ट्रेनिंग में regularization जैसे तरीकों पर विचार करें।
4. बड़े डेटासेट्स को संभालना
चुनौती: बहुत बड़े डेटासेट्स के साथ Power BI में प्रदर्शन संबंधी समस्याएँ आ सकती हैं, खासकर R और Python स्क्रिप्ट्स चलाते समय, क्योंकि एक अतिरिक्त सीमा यह है कि 30 मिनट से अधिक चलने वाली कोई भी Python स्क्रिप्ट समय-सीमा पार होने पर बंद हो जाती है।
समाधान: केवल आवश्यक डेटा ही इम्पोर्ट करें और जहाँ संभव हो एग्रीगेशन लागू करें ताकि प्रदर्शन बेहतर हो। आप अपने प्रेडिक्टिव मॉडल्स को अलग से ट्रेन करने और केवल प्रेडिक्शंस को Power BI में इम्पोर्ट करने पर भी विचार कर सकते हैं। यह तरीका हर रिफ्रेश पर मॉडल को पुनः ट्रेन करने और बार-बार टाइम-आउट के जोखिम से बचाता है।
इसके अतिरिक्त, आप Power BI में पैरामीटर्स का उपयोग करके नियंत्रित कर सकते हैं कि मॉडल को कब पुनः ट्रेन करना है। उदाहरण के लिए, आप एक पैरामीटर सेट कर सकते हैं जो निर्धारित करे कि ट्रेनिंग कोड चलना चाहिए या नहीं, और पैरामीटर के मान के आधार पर अपना Python कोड समायोजित करें:
parameter_value = int(dataset['ModelRefreshControl'][0]) # Assuming the parameter is passed as a column in the dataset
if parameter_value == 1:
# Code to train the model
# model.fit(X_train, y_train)
else:
# Code to load the pre-trained model
# model = load_model('my_model')5. डेटा गोपनीयता और सुरक्षा
चुनौती: संवेदनशील डेटा के साथ काम करते समय डेटा सुरक्षा और अनुपालन सुनिश्चित करना चुनौतीपूर्ण हो सकता है।
समाधान: कड़े डेटा गवर्नेंस नीतियाँ लागू करें और Power BI रिपोर्ट्स में row-level security जैसी अच्छी सुरक्षा प्रथाएँ अपनाने पर विचार करें। यह ध्यान देने योग्य है कि Power BI सर्विस पर प्रकाशित होने पर Python स्क्रिप्ट वाली रिपोर्ट्स के सही ढंग से चलने के लिए सभी डेटा स्रोतों का सार्वजनिक होना आवश्यक है। इस बात का आपकी डेटा गोपनीयता और सुरक्षा आवश्यकताओं पर क्या प्रभाव पड़ेगा, उस पर विचार करें।
6. मॉडल की व्याख्येयता सुनिश्चित करना
चुनौती: कुछ जटिल मॉडल (जैसे neural networks) की व्याख्या करना कठिन हो सकता है, जिससे परिणामों को समझने और समझाने में चुनौतियाँ आती हैं।
समाधान: जहाँ संभव हो, सरल मॉडल (जैसे decision trees) का उपयोग करें जिन्हें हितधारकों को समझाना आसान होता है।
निष्कर्ष
Power BI का सहज इंटरफ़ेस, बिल्ट-इन एल्गोरिद्म और व्यापक डेटा हैंडलिंग क्षमताएँ आपको अपने डेटा में रुझानों और पैटर्न का विश्लेषण, विज़ुअलाइज़ और पूर्वानुमान लगाने में सक्षम बनाती हैं। Power BI के साथ प्रेडिक्टिव मॉडल बनाना आसान है, जो आपको सूचित निर्णय लेने और प्रतिस्पर्धा में आगे रहने में मदद कर सकता है।
यदि आप Power BI में डेटा विश्लेषक के रूप में करियर में रुचि रखते हैं, तो हमारा करियर ट्रैक आपको Power BI के हर पहलू से ले जाएगा और Microsoft PL-300 प्रमाणन के लिए तैयार करेगा।
यदि आपने पहले ही Power BI की मूल बातें सीख ली हैं, तो हमारी सूची देखें: 8 Power BI प्रोजेक्ट्स जिन पर काम करके आप अपनी स्किल्स लागू कर सकते हैं और अपना पोर्टफोलियो बना सकते हैं।

Power BI एक शक्तिशाली बिज़नेस इंटेलिजेंस टूल है जो आपके डेटा का विश्लेषण और विज़ुअलाइज़ करना आसान बनाता है। हालांकि, जो चीज़ इसे प्रतिस्पर्धियों से वास्तव में अलग करती है, वह है इसके प्रेडिक्टिव एनालिटिक्स फ़ीचर और R तथा Python का समर्थन, जिनकी मदद से आप अपने विश्लेषण को अगले स्तर तक ले जा सकते हैं।
इस पोस्ट में, हम देखेंगे कि आप Power BI का उपयोग प्रेडिक्टिव एनालिटिक्स के लिए कैसे कर सकते हैं, इसके क्या लाभ हैं, और Power BI में अपना पहला प्रेडिक्टिव मॉडल कैसे बनाएँ।
आप हमारे Power BI चीट शीट का उपयोग करके Power BI को जल्दी शुरू कर सकते हैं–पहला विज़ुअलाइज़ेशन बनाने से लेकर Power Query और DAX गणनाओं तक।
Power BI का उपयोग प्रेडिक्टिव एनालिटिक्स के लिए कैसे किया जा सकता है?
प्रेडिक्टिव एनालिटिक्स में सांख्यिकीय और मशीन लर्निंग तकनीकों का उपयोग करके भविष्य की घटनाओं के बारे में पूर्वानुमान या भविष्यवाणियाँ करना शामिल है। आप प्रेडिक्टिव एनालिटिक्स के बारे में अधिक एक अलग ब्लॉग पोस्ट में सीख सकते हैं।
हालांकि, Power BI में प्रेडिक्टिव एनालिटिक्स की सफलता काफी हद तक आपके डेटा की गुणवत्ता और आपके द्वारा चुने गए मॉडल की उपयुक्तता पर निर्भर करती है। प्रेडिक्टिव एनालिटिक्स को प्रभावी ढंग से लागू करने के लिए सांख्यिकी और मशीन लर्निंग की अवधारणाओं को समझना महत्वपूर्ण है।
यहाँ बताया गया है कि आप Power BI में प्रेडिक्टिव एनालिटिक्स कैसे कर सकते हैं:
सरल पूर्वानुमान के लिए DAX का उपयोग: सरल प्रेडिक्टिव कार्यों के लिए, आप Power BI में DAX का उपयोग करके नए calculated कॉलम या measures बना सकते हैं। उदाहरण के लिए, मान लें कि बिक्री के बीच का समय यह अनुमान लगाने में सहायक है कि कोई ग्राहक अगली खरीदारी कब करेगा। आप कुछ DAX measures बना सकते हैं जो प्रत्येक ग्राहक और समग्र स्तर पर बिक्री के बीच औसत समय की गणना करें और उसका उपयोग अगली बिक्री के संभावित समय का अनुमान लगाने में करें।
R और Python स्क्रिप्ट्स का उपयोग
Power BI R और Python का समर्थन करता है, जो डेटा विश्लेषण और मशीन लर्निंग के लिए शक्तिशाली भाषाएँ हैं। आप Power BI में सीधे प्रेडिक्टिव एनालिटिक्स के लिए स्क्रिप्ट लिख सकते हैं। अपनी R या Python स्क्रिप्ट्स चलाने के बाद, आप परिणामों को Power BI में विज़ुअलाइज़ कर सकते हैं और ऐसे शक्तिशाली डैशबोर्ड बना सकते हैं जो न केवल अतीत में क्या हुआ उसे कैद करें, बल्कि भविष्य में क्या संभव है उसकी एक झलक भी दें।
Power BI के बिल्ट-इन विज़ुअल्स का उपयोग
आप मौजूदा विज़ुअल्स जैसे स्कैटर प्लॉट, लाइन चार्ट आदि का उपयोग करके ट्रेंड और पैटर्न को विज़ुअलाइज़ कर सकते हैं। Power BI में इन विज़ुअल्स में ही प्रेडिक्टिव फ़ीचर मौजूद हैं—जैसे स्कैटर प्लॉट से क्लस्टर ढूँढना या लाइन चार्ट में भविष्य की बिक्री का पूर्वानुमान लगाना।
यदि आप उभरते हुए डेटा विश्लेषक हैं, तो हमारे स्किल ट्रैक Power BI Fundamentals में आप डेटा विज़ुअलाइज़ेशन, DAX, और डेटा ट्रांसफ़ॉर्मेशन के बारे में सीखेंगे। साथ ही हमारा वेबिनार भी देखें: Power BI के साथ डेटा विश्लेषक कैसे बनें।
प्रेडिक्टिव एनालिटिक्स के लिए Power BI का उपयोग करने के लाभ
प्रेडिक्टिव एनालिटिक्स के लिए Power BI का उपयोग कई फ़ायदे प्रदान करता है, खासकर उन उपयोगकर्ताओं के लिए जो पहले से Microsoft इकोसिस्टम से परिचित हैं। Power BI किसी भी व्यक्ति के लिए एक उत्कृष्ट विकल्प है जो एक सुलभ, स्केलेबल और सुरक्षित डेटा विश्लेषण और फ़ोरकास्टिंग टूल चाहता है।
कुछ प्रमुख लाभ इस प्रकार हैं:
सहज उपयोगकर्ता इंटरफ़ेस
Power BI अपने उपयोगकर्ता-अनुकूल इंटरफ़ेस और ड्रैग-एंड-ड्रॉप रिपोर्ट बिल्डर के लिए जाना जाता है, जिससे यह उन लोगों के लिए भी सुलभ हो जाता है जो डेटा वैज्ञानिक नहीं हैं। यह डेटा मैनिपुलेशन और विज़ुअलाइज़ेशन की प्रक्रिया को सरल बनाता है और उपयोगकर्ताओं को अपेक्षाकृत आसानी से जटिल विश्लेषणात्मक कार्य करने की अनुमति देता है।
बिल्ट-इन एल्गोरिद्म
Power BI आपको कुछ विज़ुअल्स के भीतर सीधे मशीन लर्निंग मॉडल—जैसे लीनियर रिग्रेशन या क्लस्टरिंग—लागू करने की अनुमति देता है, भले ही आपको कोडिंग न आती हो। इससे प्रेडिक्टिव एनालिटिक्स को व्यापक दर्शकों के लिए उपलब्ध कराया जा सकता है, न कि केवल उन कुछ लोगों तक जिनके पास विश्लेषकों की टीम रखने का बजट हो।
एडवांस्ड उपयोगकर्ताओं के लिए, Power BI R और Python में कस्टम स्क्रिप्ट्स का समर्थन करता है, जिससे अधिक परिष्कृत और अनुकूलित प्रेडिक्टिव मॉडल संभव होते हैं।
व्यापक डेटा हैंडलिंग क्षमताएँ
Power BI विभिन्न डेटा स्रोतों से कनेक्ट हो सकता है, जिनमें क्लाउड-आधारित और ऑन-प्रिमाइसेस डेटा शामिल हैं, जिससे यह सुनिश्चित होता है कि आपका डेटा जहाँ भी संग्रहीत हो, व्यापक डेटा विश्लेषण संभव हो। आप थर्ड-पार्टी एप्लिकेशनों से सीधे कनेक्ट भी कर सकते हैं, जिससे अलग ETL सॉफ़्टवेयर की आवश्यकता कम हो जाती है।
Power BI डेटा को ट्रांसफ़ॉर्म और क्लीन करने के लिए शक्तिशाली टूल भी प्रदान करता है, जो प्रेडिक्टिव विश्लेषण के लिए डेटा तैयार करने का एक महत्वपूर्ण चरण है।