Python ile Olasılığın Temelleri
BasicSkill Level
5 sa
16.7K learners
Bu eğitimdeki kodu çevrimiçi olarak çalıştırın ve düzenleyin
Kodu çalıştırEn basit ve kullanışlı dağılımlardan biri uniform dağılımdır. Sürekli uniform dağılımın olasılık dağılım fonksiyonu şöyledir:
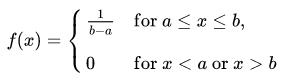
Eşit genişlikteki herhangi bir sayı aralığının gözlemlenme olasılığı eşit olduğundan, dağılımı tanımlayan eğri, aralık boyunca sabit yükseklikte ve başka yerde 0 yükseklikte bir dikdörtgendir. Eğrinin altındaki alan 1’e eşit olmalıdır; bu nedenle aralığın uzunluğu eğrinin yüksekliğini belirler. Aşağıdaki şekilde (a,b) aralığında bir uniform dağılım gösterilmektedir. Alanın $1$ olması gerektiğine dikkat edin. Yükseklik $1/(b-a)$ olarak ayarlanır.
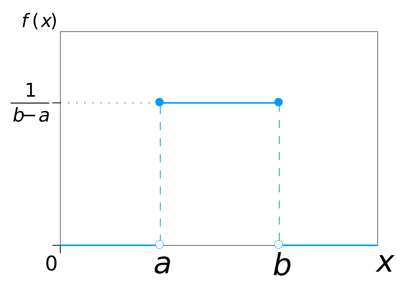
Python’da (a,b) sayı aralığı üzerinde çalışan bir rastgele sayı üreteci yardımıyla uniform dağılımı görselleştirebilirsiniz. scipy.stats modülünden uniform fonksiyonunu içe aktarmanız gerekir.
# import uniform distribution
from scipy.stats import uniform
uniform fonksiyonu, loc ve scale argümanlarıyla belirtilen aralık arasında sürekli uniform değişken üretir. Bu dağılım loc ile loc + scale arasında sabittir. size argümanı, rastgele değişken sayısını belirtir. Tekrarlanabilirliği korumak istiyorsanız, bir sayıya atanmış random_state argümanı ekleyin.
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
Az önce oluşturduğunuz dağılımın histogramını çizmek için Seaborn’un distplot fonksiyonunu kullanabilirsiniz. Seaborn’un distplot’u grafiği özelleştirmek için birden çok argüman alır. Önce bir grafik nesnesi ax oluşturursunuz. Burada histogramdaki bins sayısını belirtebilir, histogramın color’ını ayarlayabilir; kde ile yoğunluk eğrisi seçeneğini ve hist_kws ile çizgi kalınlığı seçeneğini belirtebilirsiniz. Ayrıca x ve y ekseni etiketlerini xlabel ve ylabel argümanlarıyla ayarlayabilirsiniz.
ax = sns.distplot(data_uniform,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
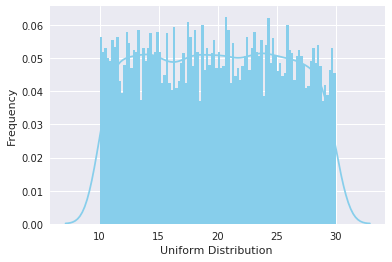
Normal dağılım, diğer adıyla Gauss dağılımı, Veri Bilimi’nde her yerde karşımıza çıkar. Özellikle istatistiksel çıkarım konularında sıkça rastlanır. Birçok veri bilimi algoritmasının da varsayımlarından biridir.
Normal dağılım, ortalaması $μ$ ve standart sapması $σ$ ile tanımlanan çan şeklinde bir yoğunluk eğrisine sahiptir. Yoğunluk eğrisi simetriktir, ortalaması etrafında merkezlenmiştir ve yayılımı standart sapma tarafından belirlenir; bu, ortalamaya yakın verilerin uçlardaki verilere göre daha sık görüldüğünü gösterir. Ortalama $μ$ ve standart sapma $σ$ olan bir normal yoğunluk eğrisinin, verilen $x$ noktasındaki olasılık dağılım fonksiyonu şöyledir:
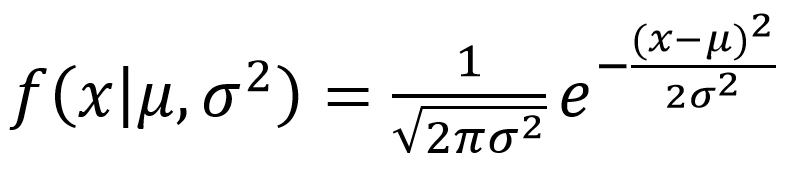
Aşağıda, dağılımın nasıl göründüğünü anlatan şekil yer almaktadır:
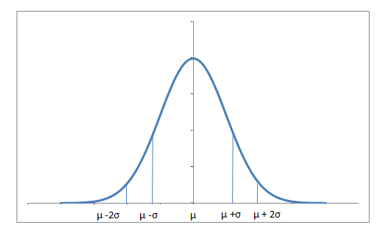
Verilerin yaklaşık %68’i ortalamadan her iki tarafta bir standart sapmalık mesafe içinde, %95’i ise iki standart sapma içinde yer alır. Ayrıca, ortalaması $0$ ve standart sapması $1$ olan dağılıma standart normal dağılım denir.
scipy.stats modülünün norm.rvs() yöntemiyle normal dağılıma sahip rastgele değişken üretebilirsiniz. loc argümanı dağılımın ortalamasına, scale standart sapmaya, size ise rastgele değişken sayısına karşılık gelir. Tekrarlanabilirliği korumak istiyorsanız, bir sayıya atanmış random_state argümanı ekleyin.
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
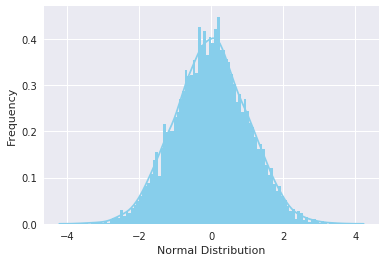
Dağılımı, uniform dağılımda yaptığınız gibi seaborn’un distplot fonksiyonunu kullanarak görselleştirebilirsiniz. Argümanların anlamı öncekiyle aynıdır.
ax = sns.distplot(data_normal,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
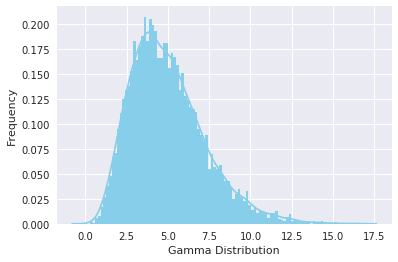
Gamma dağılımı, iki parametreli sürekli olasılık dağılımları ailesidir. Ham hâliyle nadiren kullanılsa da üstel, ki-kare, Erlang gibi yaygın dağılımlar gamma dağılımının özel hâlleridir. Gamma dağılımı, bir biçim parametresi $α = k$ ve bir ters ölçek parametresi $β = 1/θ$ (hız parametresi) ile parametrikleştirilebilir; $Γ(n)$ sembolü gamma fonksiyonudur ve $(n-1)!$ olarak tanımlanır:
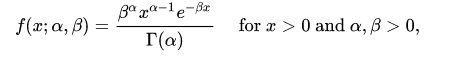
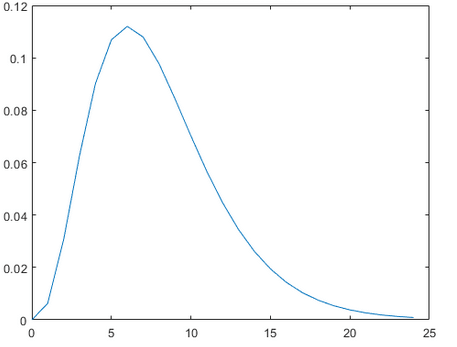
Tipik bir gamma dağılımı şu şekildedir:
scipy.stats modülünün gamma.rvs() yöntemi ile, argüman olarak biçim parametresi $a$’yı alan gamma dağılımlı rastgele değişken üretebilirsiniz. $a$ bir tamsayı olduğunda gamma, Erlang dağılımına indirgenir; $a=1$ olduğunda ise üstel dağılıma. Dağılımı kaydırmak için loc, ölçeklendirmek için scale argümanlarını kullanın; size, dağılımdaki rastgele değişken sayısını belirler. Tekrarlanabilirliği korumak istiyorsanız, bir sayıya atanmış random_state argümanı ekleyin.
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
Dağılımı, uniform dağılım bölümünde açıklandığı gibi seaborn’un distplot fonksiyonlarıyla görselleştirebilirsiniz. Argümanların anlamı aynıdır.
ax = sns.distplot(data_gamma,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
Üstel dağılım, Poisson nokta sürecindeki olaylar arasındaki süreyi tanımlar; yani olayların sabit bir ortalama hızla, sürekli ve birbirinden bağımsız gerçekleştiği bir süreç. $λ$ olarak adlandırılan bir hız parametresine sahiptir ve denklemi şöyledir:
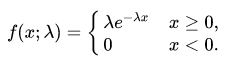
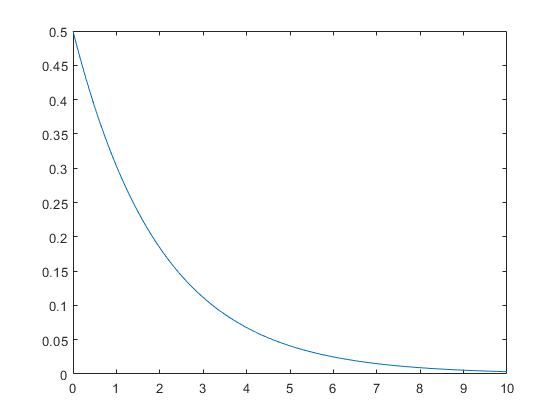
Azalan bir üstel dağılım şöyle görünür:
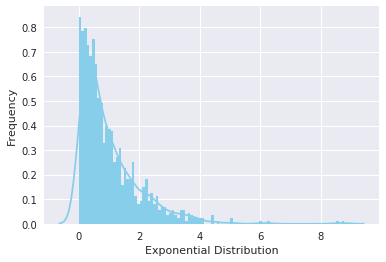
scipy.stats modülünün expon.rvs() yöntemiyle üstel dağılımlı rastgele değişken üretebilirsiniz; bu yöntem scale adlı biçim parametresini argüman olarak alır ve denklemdeki 1/lambda’dan ibarettir. Dağılımı kaydırmak için loc, size ile rastgele değişken sayısını belirleyin. Tekrarlanabilirliği korumak istiyorsanız, bir sayıya atanmış random_state argümanı ekleyin.
from scipy.stats import expon
data_expon = expon.rvs(scale=1,loc=0,size=1000)
Dağılımı yeniden seaborn ile görselleştirmek aşağıdaki eğriyi verir:
ax = sns.distplot(data_expon,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
Poisson rastgele değişkeni, genellikle bir zaman aralığında bir olayın kaç kez gerçekleştiğini modellemek için kullanılır. Örneğin, belirli bir zaman diliminde bir web sitesini ziyaret eden kullanıcı sayısı bir Poisson süreci olarak düşünülebilir. Poisson dağılımı, olayların gerçekleşme hızı ($μ$) cinsinden tanımlanır. Bir olay bir aralıkta 0, 1, 2, … kez meydana gelebilir. Bir aralıktaki ortalama olay sayısı $λ$ (lambda) ile gösterilir. Lambda, olay hızıdır ve hız parametresi olarak da adlandırılır. Bir aralıkta $k$ olay gözlemlenme olasılığı şu denklemle verilir:
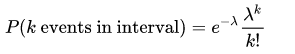
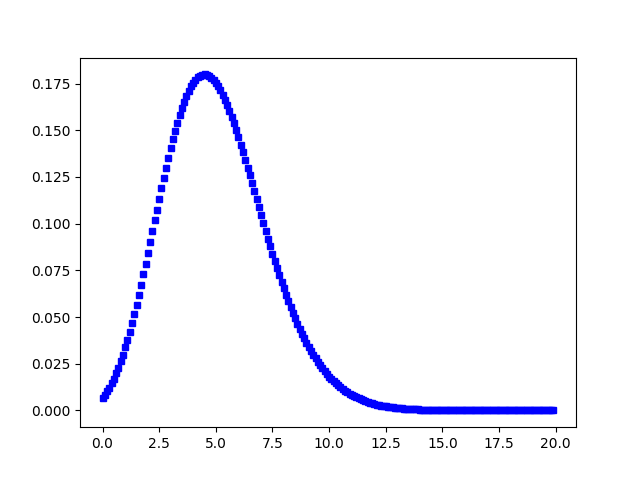
Not normal dağılım, $λ →∞$ iken Poisson dağılımının sınır hâlidir. Ayrıca, rastgele olaylar arasındaki süreler $λ$ hız parametresiyle üstel dağılıma uyuyorsa, uzunluğu $t$ olan bir zaman dilimindeki toplam olay sayısı, parametresi $λt$ olan Poisson dağılımına uyar.
Aşağıdaki şekil tipik bir Poisson dağılımını göstermektedir:
scipy.stats modülünün poisson.rvs() yöntemiyle, denklemlerdeki $λ$’ya karşılık gelen $μ$ biçim parametresini alan Poisson dağılımlı ayrık rastgele değişken üretebilirsiniz. Dağılımı kaydırmak için loc parametresini kullanın. size, dağılımdaki rastgele değişken sayısını belirler. Tekrarlanabilirliği korumak istiyorsanız, bir sayıya atanmış random_state argümanı ekleyin.
from scipy.stats import poisson
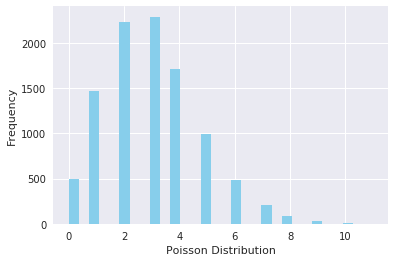
data_poisson = poisson.rvs(mu=3, size=10000)
Dağılımı, uniform dağılımda yaptığınız gibi seaborn’un distplot fonksiyonlarıyla görselleştirebilirsiniz. Argümanların anlamı aynıdır.
ax = sns.distplot(data_poisson,
                  bins=30,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
Yalnızca iki sonucun mümkün olduğu, örneğin başarı ya da başarısızlık, kazanç ya da kayıp, kazan ya da kaybet gibi ve tüm denemelerde başarı ve başarısızlık olasılığının aynı olduğu bir dağılıma Binom Dağılımı denir. Ancak sonuçların eşit olasılıklı olması gerekmez ve her deneme birbirinden bağımsızdır. Binom dağılımının parametreleri $n$ ve $p$’dir; burada $n$ toplam deneme sayısı, $p$ ise her denemedeki başarı olasılığıdır. Olasılık kütle fonksiyonu şöyledir:
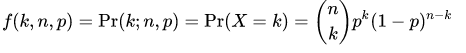
burada:
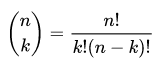
scipy.stats modülünün binom.rvs() yöntemiyle, şekil parametreleri olarak $n$ (deneme sayısı) ve $p$ (başarı olasılığı) alan binom dağılımlı ayrık rastgele değişken üretebilirsiniz. Dağılımı kaydırmak için loc parametresini kullanın. size, denemelerin kaç kez tekrarlanacağını belirler. Tekrarlanabilirliği korumak istiyorsanız, bir sayıya atanmış random_state argümanı ekleyin.
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
Seaborn’un distplot fonksiyonunu kullanarak oluşturduğunuz dağılımı görselleştirmek aşağıdaki histogramı üretir:
ax = sns.distplot(data_binom,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Binomial Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]
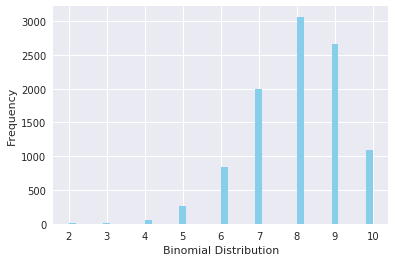
Not başarı olasılığı $0.5$’ten büyük olduğundan dağılım sağ tarafa çarpıktır. Ayrıca, aşağıdaki koşullar altında Poisson dağılımı, binom dağılımının bir sınır hâlidir:
Normal dağılım ise aşağıdaki koşullar altında binom dağılımının bir diğer sınır biçimidir:
Bernoulli dağılımında yalnızca iki olası sonuç vardır: $1$ (başarı) ve $0$ (başarısızlık); örneğin yazı-tura atışı. Dolayısıyla Bernoulli dağılımına sahip rastgele değişken $X$, başarı olasılığı $p$ ile $1$ değerini; başarısızlık olasılığı $q$ ya da $1-p$ ile $0$ değerini alabilir. Başarı ve başarısızlık olasılıklarının eşit olmasına gerek yoktur. Bernoulli dağılımı, tek bir denemenin yapıldığı ($n=1$) binom dağılımının özel bir hâlidir. Olasılık kütle fonksiyonu şöyledir:
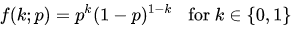
scipy.stats modülünün bernoulli.rvs() yöntemiyle, şekil parametresi olarak $p$ (başarı olasılığı) alan Bernoulli dağılımlı ayrık rastgele değişken üretebilirsiniz. Dağılımı kaydırmak için loc parametresini kullanın. size, denemelerin kaç kez tekrarlanacağını belirler. Tekrarlanabilirliği korumak istiyorsanız, bir sayıya atanmış random_state argümanı ekleyin.
from scipy.stats import bernoulli
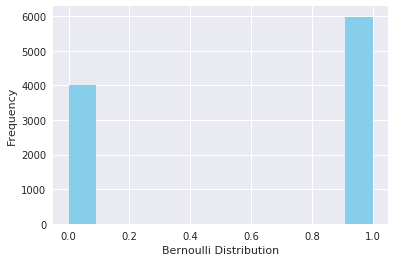
data_bern = bernoulli.rvs(size=10000,p=0.6)
Dağılımı yeniden görselleştirdiğinizde, yalnızca iki olası sonuç olduğunu gözlemleyebilirsiniz:
ax= sns.distplot(data_bern,
                 kde=False,
                 color="skyblue",
                 hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]
Tebrikler, bu eğitimin sonuna geldiniz! Bu eğitimde, yaygın olarak kullanılan bazı olasılık dağılımlarını keşfettiniz ve bunları Python’da oluşturup görselleştirmeyi öğrendiniz. Keşfedilecek başka birçok dağılım olsa da başlamak için bunlar yeterli olacaktır. Diğer faydalı istatistiksel işlevler için Python’un scipy kütüphanesini incelemeyi unutmayın. İyi keşifler!
Python’da olasılık hakkında daha fazla bilgi edinmek isterseniz, DataCamp’in Statistical Simulation in Python kursunu alın.
Python ile Poker Olasılığı ve İstatistik eğitimimize göz atın.
Python Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




