Grundlagen der Wahrscheinlichkeit in Python
BasicSkill Level
5 Std.
16.1K learners
Code aus diesem Tutorial online ausführen und bearbeiten
Code ausführenEine der einfachsten und zugleich nützlichen Verteilungen ist die Gleichverteilung. Die Wahrscheinlichkeitsdichtefunktion der stetigen Gleichverteilung lautet:
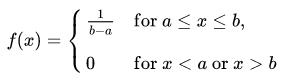
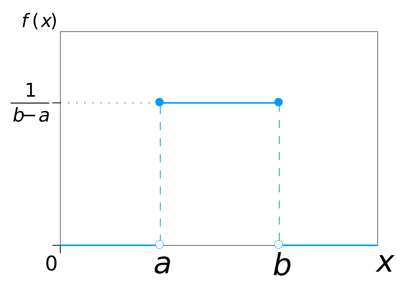
Da jedes Intervall gleicher Breite mit der gleichen Wahrscheinlichkeit beobachtet wird, ist die Kurve ein Rechteck: konstante Höhe über dem Intervall und außerhalb 0. Weil die Fläche unter der Kurve 1 sein muss, bestimmt die Intervalllänge die Höhe der Kurve. Die folgende Abbildung zeigt eine Gleichverteilung im Intervall (a,b). Da die Fläche $1$ sein muss, ist die Höhe $1/(b-a)$.
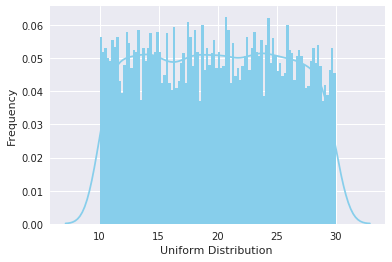
Du kannst die Gleichverteilung in Python mithilfe eines Zufallszahlengenerators über einem Intervall (a,b) visualisieren. Importiere dazu die Funktion uniform aus dem Modul scipy.stats.
# import uniform distribution
from scipy.stats import uniform
Die Funktion uniform erzeugt eine stetige Gleichverteilung im angegebenen Intervall über die Argumente loc und scale. Die Verteilung ist zwischen loc und loc + scale konstant. Mit size legst du die Anzahl der Zufallswerte fest. Für reproduzierbare Ergebnisse kannst du ein random_state setzen.
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
Mit Seaborns distplot zeichnest du ein Histogramm der erzeugten Verteilung. distplot bietet zahlreiche Argumente zur Anpassung: Du erzeugst zuerst ein Plot-Objekt ax, gibst die Anzahl der bins vor, wählst die color und aktivierst mit kde die Dichteschätzung. Über hist_kws passt du z. B. die Linienbreite an. Achsenbeschriftungen setzt du mit xlabel und ylabel.
ax = sns.distplot(data_uniform,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
Die Normalverteilung, auch Gauß-Verteilung, ist in der Data Science allgegenwärtig – besonders bei statistischer Inferenz. Viele Algorithmen setzen sie voraus.
Eine Normalverteilung hat eine glockenförmige Dichtekurve, beschrieben durch ihren Mittelwert $μ$ und ihre Standardabweichung $σ$. Die Kurve ist symmetrisch um den Mittelwert, die Streuung wird durch $σ$ bestimmt: Werte nahe dem Mittel sind häufiger als weit entfernte. Die Wahrscheinlichkeitsdichte einer Normalverteilung mit $μ$ und $σ$ an der Stelle $x$ ist gegeben durch:
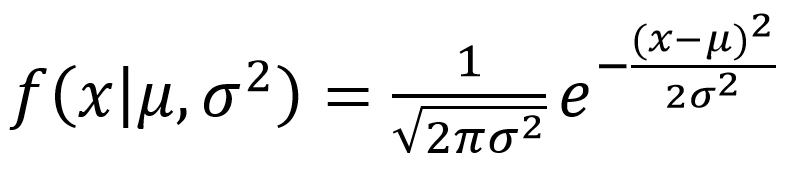
Die folgende Abbildung zeigt die Form der Verteilung:
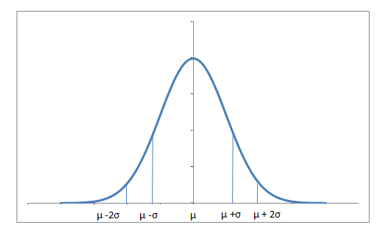
Etwa 68% der Daten liegen innerhalb einer Standardabweichung um den Mittelwert, etwa 95% innerhalb von zwei. Eine Verteilung mit Mittelwert $0$ und Standardabweichung $1$ heißt Standardnormalverteilung.
Eine normalverteilte Zufallsvariable erzeugst du mit norm.rvs() aus scipy.stats. loc entspricht dem Mittelwert, scale der Standardabweichung und size der Anzahl der Zufallswerte. Für Reproduzierbarkeit setze random_state.
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
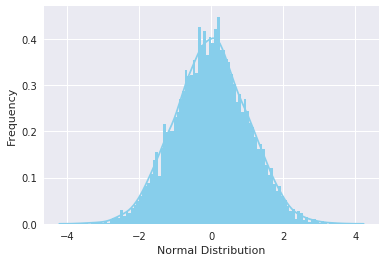
Die Visualisierung funktioniert analog zur Gleichverteilung mit Seaborns distplot. Die Argumente haben die gleiche Bedeutung.
ax = sns.distplot(data_normal,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
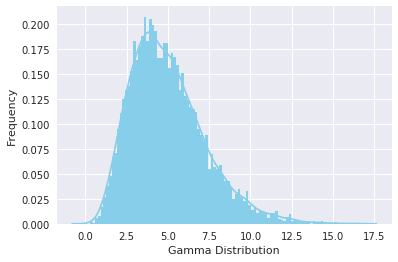
Die Gamma-Verteilung ist eine zweiparametrige Familie stetiger Verteilungen. Zwar nutzt man sie seltener direkt, doch viele verbreitete Verteilungen wie Exponential-, Chi-Quadrat- oder Erlang-Verteilung sind Spezialfälle der Gamma-Verteilung. Sie kann mit einem Formparameter $α = k$ und einem inversen Skalenparameter $β = 1/θ$ (auch Rate-Parameter) beschrieben werden. Dabei bezeichnet $Γ(n)$ die Gamma-Funktion und ist definiert als $(n-1)!$:
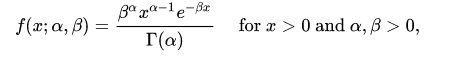
Eine typische Gamma-Verteilung sieht so aus:
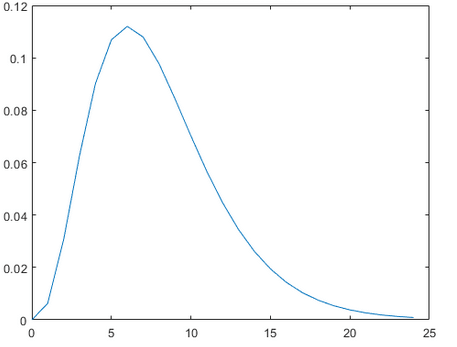
Eine gamma-verteilte Zufallsvariable erzeugst du mit gamma.rvs() aus scipy.stats; dabei ist $a$ der Formparameter. Für ganzzahliges $a$ reduziert sich die Verteilung auf Erlang; für $a=1$ auf die Exponentialverteilung. Mit loc verschiebst du die Verteilung, mit scale skalierst du sie; size legt die Anzahl der Zufallswerte fest. Für Reproduzierbarkeit setze random_state.
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
Die Visualisierung erfolgt wie bei der Gleichverteilung über Seaborns distplot. Die Argumente sind entsprechend identisch.
ax = sns.distplot(data_gamma,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
Die Exponentialverteilung beschreibt die Zeit zwischen Ereignissen in einem Poisson-Prozess, also wenn Ereignisse kontinuierlich und unabhängig mit konstanter durchschnittlicher Rate auftreten. Ihr Parameter ist $λ$ (Rate-Parameter), und die Gleichung lautet:
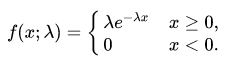
Eine abnehmende Exponentialverteilung sieht so aus:
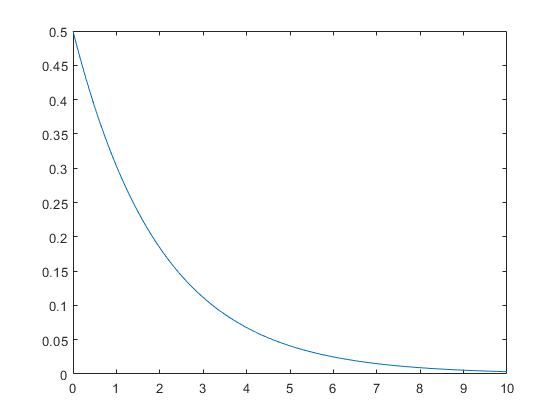
Eine exponentialverteilte Zufallsvariable erzeugst du mit expon.rvs() aus scipy.stats. Das Argument scale entspricht in der Formel 1/lambda. Mit loc verschiebst du die Verteilung, size legt die Anzahl der Zufallswerte fest. Für Reproduzierbarkeit setze random_state.
from scipy.stats import expon
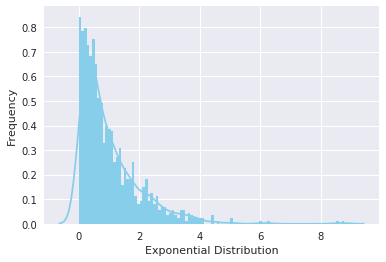
data_expon = expon.rvs(scale=1,loc=0,size=1000)
Die Visualisierung mit Seaborn liefert folgende Kurve:
ax = sns.distplot(data_expon,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
Die Poisson-Zufallsvariable wird typischerweise genutzt, um die Anzahl von Ereignissen in einem Zeitintervall zu modellieren. Beispiel: die Zahl der Website-Besuche in einem Intervall. Die Poisson-Verteilung wird durch die Rate ($μ$) der Ereignisse beschrieben. Ein Ereignis kann 0, 1, 2, … Mal im Intervall auftreten. Der erwartete Wert pro Intervall ist $λ$ (Lambda), die Ereignisrate bzw. der Rate-Parameter. Die Wahrscheinlichkeit, $k$ Ereignisse in einem Intervall zu beobachten, ist gegeben durch:
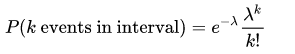
Hinweis: Die Normalverteilung ist ein Grenzfall der Poisson-Verteilung für $λ →∞$. Folgen die Zwischenzeiten zwischen zufälligen Ereignissen einer Exponentialverteilung mit Rate $λ$, dann folgt die Gesamtzahl der Ereignisse in einer Zeitspanne der Länge $t$ einer Poisson-Verteilung mit Parameter $λt$.
Die folgende Abbildung zeigt eine typische Poisson-Verteilung:
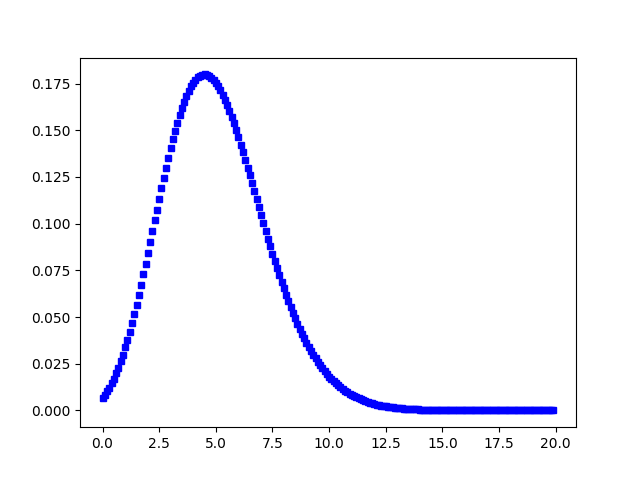
Eine Poisson-verteilte diskrete Zufallsvariable erzeugst du mit poisson.rvs() aus scipy.stats. Das Formargument ist $μ$ und entspricht dem $λ$ in der Formel. Mit loc verschiebst du die Verteilung, size legt die Anzahl der Zufallswerte fest. Für Reproduzierbarkeit setze random_state.
from scipy.stats import poisson
data_poisson = poisson.rvs(mu=3, size=10000)
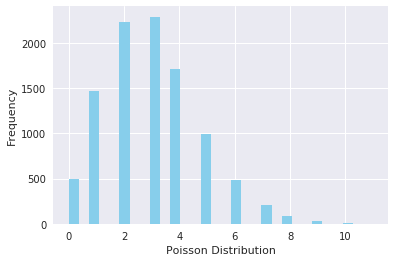
Die Visualisierung erfolgt wie bei der Gleichverteilung mit Seaborns distplot. Die Argumente bleiben gleich.
ax = sns.distplot(data_poisson,
                  bins=30,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
Eine Verteilung, bei der es nur zwei mögliche Ausgänge gibt – etwa Erfolg oder Misserfolg, Gewinn oder Verlust – und bei der die Erfolgswahrscheinlichkeit in allen Versuchen gleich ist, nennt man Binomialverteilung. Die Ausgänge müssen nicht gleich wahrscheinlich sein; zudem sind die Versuche unabhängig. Die Parameter der Binomialverteilung sind $n$ und $p$, wobei $n$ die Anzahl der Versuche und $p$ die Erfolgswahrscheinlichkeit pro Versuch ist. Die Wahrscheinlichkeitsfunktion lautet:
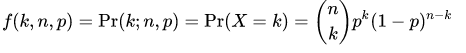
wobei gilt:
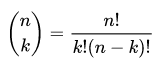
Eine binomialverteilte diskrete Zufallsvariable erzeugst du mit binom.rvs() aus scipy.stats. Die Formparameter sind $n$ (Anzahl der Versuche) und $p$ (Erfolgswahrscheinlichkeit). Mit loc verschiebst du die Verteilung; size gibt an, wie oft die Versuche wiederholt werden. Für Reproduzierbarkeit setze random_state.
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
Die Visualisierung der erzeugten Verteilung mit Seaborns distplot liefert folgendes Histogramm:
ax = sns.distplot(data_binom,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Binomial Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]
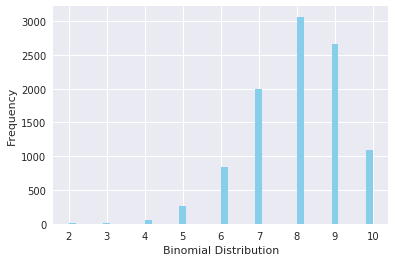
Hinweis: Da die Erfolgswahrscheinlichkeit größer als $0.5$ ist, ist die Verteilung nach rechts schief. Die Poisson-Verteilung ist ein Grenzfall der Binomialverteilung unter folgenden Bedingungen:
Die Normalverteilung ist ein weiterer Grenzfall der Binomialverteilung unter folgenden Bedingungen:
Die Bernoulli-Verteilung hat nur zwei mögliche Ausgänge, nämlich $1$ (Erfolg) und $0$ (Misserfolg), und genau einen Versuch, z. B. einen Münzwurf. Die Zufallsvariable $X$ mit Bernoulli-Verteilung nimmt den Wert $1$ mit der Erfolgswahrscheinlichkeit $p$ und den Wert $0$ mit der Misserfolgswahrscheinlichkeit $q$ bzw. $1-p$ an. Die Wahrscheinlichkeiten müssen nicht gleich groß sein. Die Bernoulli-Verteilung ist ein Spezialfall der Binomialverteilung mit einem einzelnen Versuch ($n=1$). Die Wahrscheinlichkeitsfunktion lautet:
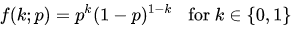
Eine Bernoulli-verteilte diskrete Zufallsvariable erzeugst du mit bernoulli.rvs() aus scipy.stats. Der Formparameter ist $p$ (Erfolgswahrscheinlichkeit). Mit loc verschiebst du die Verteilung; size legt fest, wie oft der Versuch wiederholt wird. Für Reproduzierbarkeit setze random_state.
from scipy.stats import bernoulli
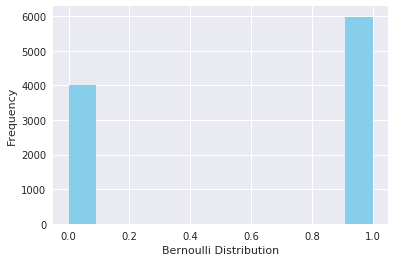
data_bern = bernoulli.rvs(size=10000,p=0.6)
Die Visualisierung zeigt, dass es genau zwei mögliche Ausgänge gibt:
ax= sns.distplot(data_bern,
                 kde=False,
                 color="skyblue",
                 hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]
Glückwunsch, du hast das Ende dieses Tutorials erreicht! Du hast einige gängige Wahrscheinlichkeitsverteilungen kennengelernt und gelernt, sie in Python zu erzeugen und zu plotten. Es gibt noch viele weitere Verteilungen zu entdecken, aber für den Einstieg reicht das aus. Schau dir unbedingt die Python-Bibliothek scipy an – sie bietet noch viele weitere nützliche Statistikfunktionen. Viel Spaß beim Entdecken!
Wenn du mehr über Wahrscheinlichkeit in Python lernen möchtest, besuche den DataCamp-Kurs Statistical Simulation in Python.
Sieh dir auch unser Tutorial Poker Probability and Statistics with Python an.
Python-Kurse
Kurs
Kurs
Kurs