

इस ट्यूटोरियल का कोड ऑनलाइन चलाएं और संपादित करें
कोड चलाएंUniform Distribution Function
शायद सबसे सरल और उपयोगी वितरणों में से एक uniform वितरण है। सतत uniform वितरण का प्रायिकता वितरण फलन इस प्रकार है:
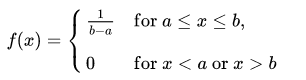
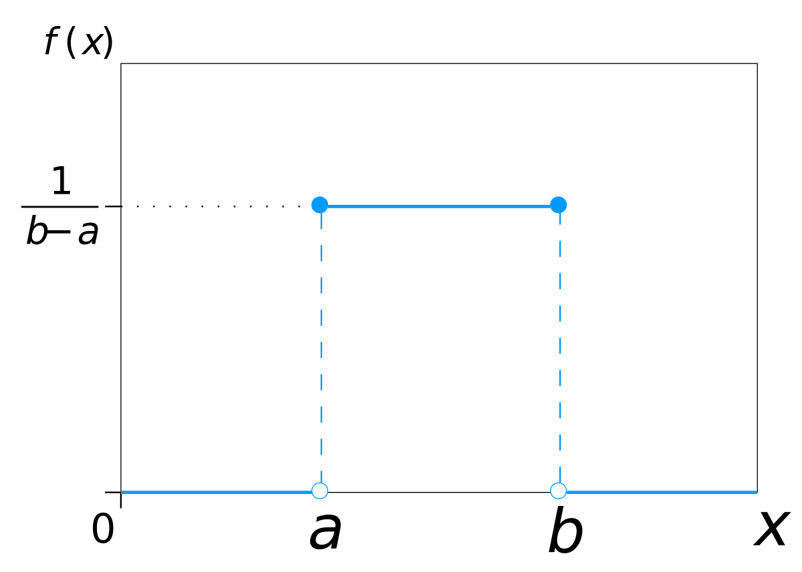
क्योंकि समान चौड़ाई वाले किसी भी अंतराल के देखे जाने की प्रायिकता समान होती है, इसलिए वितरण का वक्र एक आयत होता है, जो अंतराल के पार समान ऊँचाई रखता है और अन्यत्र 0 ऊँचाई। चूँकि वक्र के नीचे का क्षेत्रफल 1 के बराबर होना चाहिए, इसलिए अंतराल की लंबाई वक्र की ऊँचाई निर्धारित करती है। निम्न चित्र (a,b) अंतराल में uniform वितरण दिखाता है। ध्यान दें कि क्षेत्रफल $1$ होना चाहिए, इसलिए ऊँचाई $1/(b-a)$ रखी जाती है।
Python में Uniform Distribution
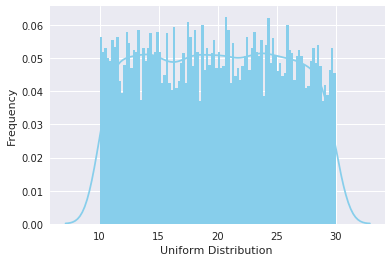
आप Python में किसी अंतराल (a,b) पर कार्य करने वाले रैंडम नंबर जनरेटर की मदद से uniform वितरण का दृश्य बना सकते हैं। आपको scipy.stats मॉड्यूल से uniform फ़ंक्शन इम्पोर्ट करना होगा।
# import uniform distribution
from scipy.stats import uniform
uniform फ़ंक्शन अपने loc और scale आर्ग्यूमेंट्स के माध्यम से निर्दिष्ट अंतराल के बीच एक सतत uniform वैरिएबल उत्पन्न करता है। यह वितरण loc और loc + scale के बीच स्थिर रहता है। size आर्ग्यूमेंट रैंडम वेरिएट्स की संख्या को दर्शाता है। यदि आप पुनरुत्पादनयोग्यता बनाए रखना चाहते हैं, तो किसी संख्या पर सेट किया हुआ random_state आर्ग्यूमेंट शामिल करें।
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
आप Seaborn के distplot का उपयोग करके अभी बनाए गए वितरण का हिस्टोग्राम प्लॉट कर सकते हैं। Seaborn का distplot प्लॉट को अनुकूलित करने के लिए कई आर्ग्यूमेंट्स लेता है। पहले आप एक प्लॉट ऑब्जेक्ट ax बनाते हैं। यहाँ आप हिस्टोग्राम में bins की संख्या, हिस्टोग्राम का color, तथा kde से density plot विकल्प और hist_kws से linewidth विकल्प निर्दिष्ट कर सकते हैं। आप xlabel और ylabel आर्ग्यूमेंट्स का उपयोग कर x और y अक्षों के लेबल भी सेट कर सकते हैं।
ax = sns.distplot(data_uniform,
bins=100,
kde=True,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
Normal Distribution Function
Normal वितरण, जिसे Gaussian वितरण भी कहा जाता है, डेटा साइंस में सर्वव्यापी है। आप इसे कई जगहों पर, विशेषकर सांख्यिकीय अनुमिति (statistical inference) के विषयों में, देखेंगे। यह कई डेटा साइंस एल्गोरिदम की धारणाओं में भी शामिल है।
एक normal वितरण में घंटी-आकार का घनत्व वक्र होता है जिसे उसके माध्य $μ$ और मानक विचलन $σ$ द्वारा वर्णित किया जाता है। घनत्व वक्र सममित होता है, अपने माध्य के इर्द-गिर्द केंद्रित, और उसका प्रसार मानक विचलन द्वारा निर्धारित होता है, जो दर्शाता है कि माध्य के पास का डेटा दूरस्थ डेटा की तुलना में अधिक बार होता है। किसी दिए गए बिंदु $x$ पर माध्य $μ$ और मानक विचलन $σ$ के साथ normal घनत्व वक्र का प्रायिकता वितरण फलन इस प्रकार है:
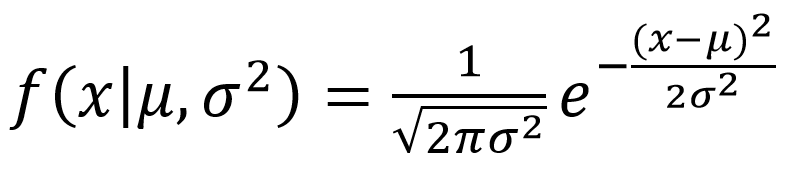
नीचे दिया गया चित्र दिखाता है कि यह वितरण कैसा दिखता है:
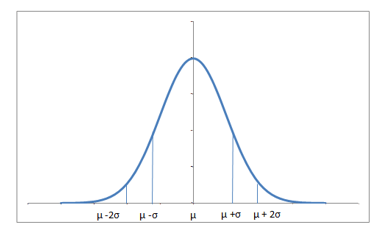
लगभग 68% डेटा, माध्य से एक मानक विचलन की दूरी के भीतर (दोनों ओर) आता है और 95% दो मानक विचलनों के भीतर। यह भी उल्लेखनीय है कि माध्य $0$ और मानक विचलन $1$ वाले वितरण को स्टैंडर्ड नॉर्मल डिस्ट्रीब्यूशन कहा जाता है।
Python में Normal Distribution
आप scipy.stats मॉड्यूल की norm.rvs() विधि का उपयोग करके सामान्य वितरण वाला रैंडम वैरिएबल उत्पन्न कर सकते हैं। loc आर्ग्यूमेंट वितरण के माध्य से मेल खाता है। scale मानक विचलन से और size रैंडम वेरिएट्स की संख्या से मेल खाता है। यदि आप पुनरुत्पादनयोग्यता बनाए रखना चाहते हैं, तो किसी संख्या पर सेट किया हुआ random_state आर्ग्यूमेंट शामिल करें।
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
आप uniform वितरण की तरह ही seaborn के distplot फ़ंक्शन का उपयोग कर वितरण का दृश्य बना सकते हैं। आर्ग्यूमेंट्स का अर्थ पिछले मामले जैसा ही रहता है।
ax = sns.distplot(data_normal,
bins=100,
kde=True,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
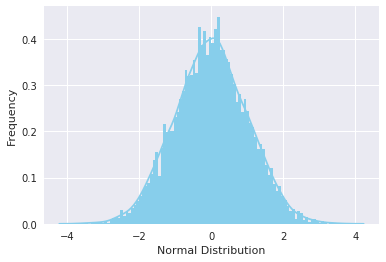
Gamma Distribution Function
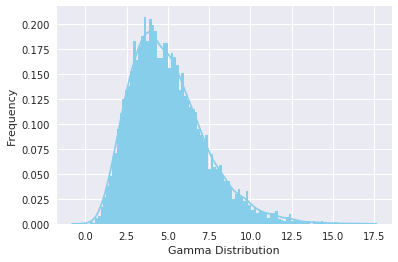
Gamma वितरण सतत प्रायिकता वितरणों का दो-पैरामीटर परिवार है। यद्यपि इसे अपने मूल रूप में कम उपयोग किया जाता है, लेकिन exponential, chi-squared, erlang जैसे अन्य लोकप्रिय वितरण gamma वितरण के विशेष मामले हैं। Gamma वितरण को एक shape पैरामीटर $α = k$ और एक inverse scale पैरामीटर $β = 1/θ$ (जिसे rate पैरामीटर कहते हैं) के रूप में पैरामीटराइज़ किया जा सकता है। प्रतीक $Γ(n)$ gamma फलन है और इसे $(n-1)!$ के रूप में परिभाषित किया जाता है:
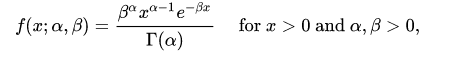
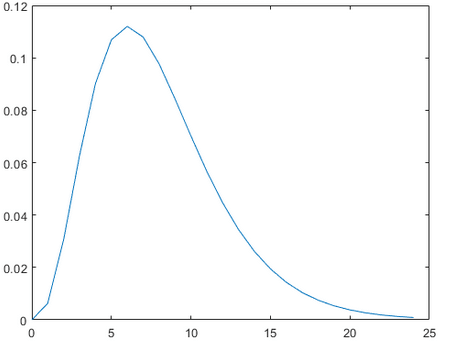
एक सामान्य gamma वितरण कुछ इस प्रकार दिखता है:
Python में Gamma Distribution
आप scipy.stats मॉड्यूल की gamma.rvs() विधि का उपयोग करके gamma-वितरित रैंडम वैरिएबल उत्पन्न कर सकते हैं, जो shape पैरामीटर $a$ लेती है। जब $a$ पूर्णांक होता है, तो gamma Erlang वितरण में बदल जाता है, और जब $a=1$ होता है, तो exponential वितरण में। वितरण को शिफ्ट करने के लिए loc आर्ग्यूमेंट, स्केल करने के लिए scale आर्ग्यूमेंट का उपयोग करें, और size वितरण में रैंडम वेरिएट्स की संख्या तय करता है। यदि आप पुनरुत्पादनयोग्यता बनाए रखना चाहते हैं, तो किसी संख्या पर सेट किया हुआ random_state आर्ग्यूमेंट शामिल करें।
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
आप uniform वितरण की तरह ही seaborn के distplot फ़ंक्शन का उपयोग कर इसका दृश्य बना सकते हैं। आर्ग्यूमेंट्स का अर्थ uniform वितरण खंड में बताए अनुसार ही रहता है।
ax = sns.distplot(data_gamma,
kde=True,
bins=100,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
Exponential Distribution Function
Exponential वितरण, Poisson पॉइंट प्रक्रिया में घटनाओं के बीच समय का वर्णन करता है, अर्थात ऐसी प्रक्रिया जिसमें घटनाएँ एक स्थिर औसत दर पर निरंतर और स्वतंत्र रूप से घटित होती हैं। इसमें $λ$ नाम का rate पैरामीटर होता है, और इसका समीकरण इस प्रकार वर्णित है:
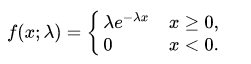
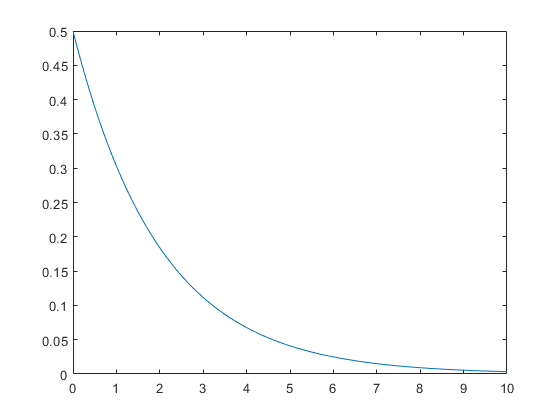
घटता हुआ exponential वितरण इस प्रकार दिखता है:
Python में Exponential Distribution
आप scipy.stats मॉड्यूल की expon.rvs() विधि का उपयोग करके घातीय रूप से वितरित रैंडम वैरिएबल उत्पन्न कर सकते हैं, जो scale नामक shape पैरामीटर लेती है, जो समीकरण में 1/lambda ही है। वितरण को शिफ्ट करने के लिए loc आर्ग्यूमेंट का उपयोग करें; size वितरण में रैंडम वेरिएट्स की संख्या तय करता है। यदि आप पुनरुत्पादनयोग्यता बनाए रखना चाहते हैं, तो किसी संख्या पर सेट किया हुआ random_state आर्ग्यूमेंट शामिल करें।
from scipy.stats import expon
data_expon = expon.rvs(scale=1,loc=0,size=1000)
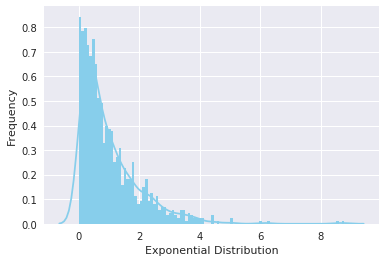
फिर से seaborn के साथ वितरण का दृश्य बनाने पर नीचे दिखाया गया वक्र प्राप्त होता है:
ax = sns.distplot(data_expon,
kde=True,
bins=100,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
Poisson Distribution
Poisson रैंडम वैरिएबल का उपयोग आमतौर पर किसी समय अंतराल में किसी घटना के घटित होने की संख्या को मॉडल करने के लिए किया जाता है। उदाहरण के लिए, किसी अंतराल में किसी वेबसाइट पर आए उपयोगकर्ताओं की संख्या को Poisson प्रक्रिया माना जा सकता है। Poisson वितरण को उन दर ($μ$) के संदर्भ में वर्णित किया जाता है जिन पर घटनाएँ घटित होती हैं। किसी अंतराल में कोई घटना 0, 1, 2, … बार घटित हो सकती है। किसी अंतराल में घटनाओं की औसत संख्या $λ$ (lambda) द्वारा निरूपित की जाती है। Lambda ही घटना दर है, जिसे rate पैरामीटर भी कहा जाता है। किसी अंतराल में $k$ घटनाएँ देखने की प्रायिकता निम्न समीकरण द्वारा दी जाती है:
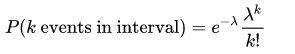
ध्यान दें कि normal वितरण, $λ →∞$ के साथ Poisson वितरण का सीमित मामला (limiting case) है। साथ ही, यदि यादृच्छिक घटनाओं के बीच के समय $λ$ दर वाले exponential वितरण का अनुसरण करते हैं, तो लंबाई $t$ की समयावधि में कुल घटनाओं की संख्या $λt$ पैरामीटर के साथ Poisson वितरण का अनुसरण करती है।
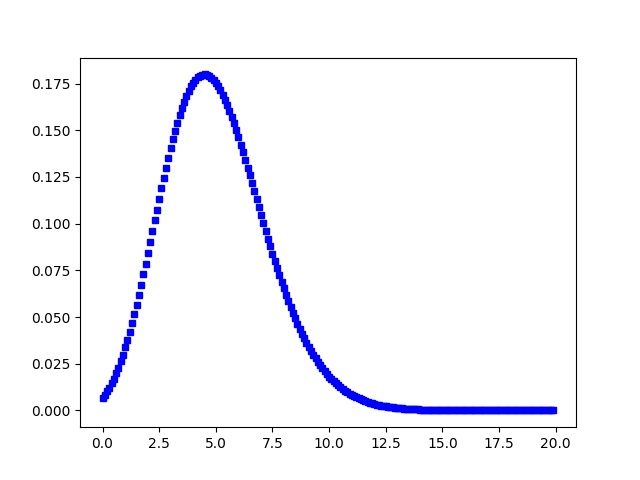
निम्न चित्र एक सामान्य Poisson वितरण दिखाता है:
Python में Poisson Distribution
आप scipy.stats मॉड्यूल की poisson.rvs() विधि का उपयोग करके Poisson-वितरित विविक्त रैंडम वैरिएबल उत्पन्न कर सकते हैं, जो $μ$ को shape पैरामीटर के रूप में लेती है और समीकरण में यही $λ$ है। वितरण को शिफ्ट करने के लिए loc पैरामीटर का उपयोग करें। size वितरण में रैंडम वेरिएट्स की संख्या तय करता है। यदि आप पुनरुत्पादनयोग्यता बनाए रखना चाहते हैं, तो किसी संख्या पर सेट किया हुआ random_state आर्ग्यूमेंट शामिल करें।
from scipy.stats import poisson
data_poisson = poisson.rvs(mu=3, size=10000)
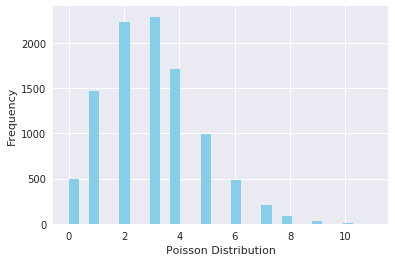
आप uniform वितरण की तरह ही seaborn के distplot फ़ंक्शन का उपयोग कर इसका दृश्य बना सकते हैं। आर्ग्यूमेंट्स का अर्थ वही रहता है।
ax = sns.distplot(data_poisson,
bins=30,
kde=False,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
Binomial Distribution Function
ऐसा वितरण जिसमें केवल दो परिणाम संभव हों, जैसे सफलता या विफलता, लाभ या हानि, जीत या हार, और जहाँ सभी परीक्षणों के लिए सफलता और विफलता की प्रायिकता समान हो, उसे Binomial वितरण कहा जाता है। हालाँकि, परिणाम समान रूप से संभावित होना आवश्यक नहीं है, और प्रत्येक परीक्षण एक-दूसरे से स्वतंत्र होता है। Binomial वितरण के पैरामीटर $n$ और $p$ होते हैं, जहाँ $n$ कुल परीक्षणों की संख्या है और $p$ प्रत्येक परीक्षण में सफलता की प्रायिकता है। इसका प्रायिकता वितरण फलन इस प्रकार है:
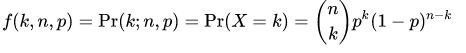
जहाँ:
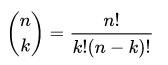
Python में Binomial Distribution
आप scipy.stats मॉड्यूल की binom.rvs() विधि का उपयोग करके बायनोमियल-वितरित विविक्त रैंडम वैरिएबल उत्पन्न कर सकते हैं, जो $n$ (परीक्षणों की संख्या) और $p$ (सफलता की प्रायिकता) को shape पैरामीटर के रूप में लेती है। वितरण को शिफ्ट करने के लिए loc पैरामीटर का उपयोग करें। size यह तय करता है कि परीक्षणों को कितनी बार दोहराया जाए। यदि आप पुनरुत्पादनयोग्यता बनाए रखना चाहते हैं, तो किसी संख्या पर सेट किया हुआ random_state आर्ग्यूमेंट शामिल करें।
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
seaborn के distplot का उपयोग कर अभी बनाए गए वितरण का दृश्य बनाने पर निम्नलिखित हिस्टोग्राम प्राप्त होता है:
ax = sns.distplot(data_binom,
kde=False,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Binomial Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]
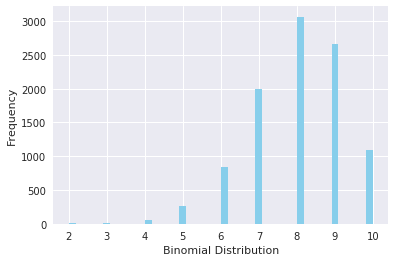
ध्यान दें कि चूँकि सफलता की प्रायिकता $0.5$ से अधिक थी, इसलिए वितरण दाईं ओर झुका हुआ है। साथ ही, निम्न शर्तों के अंतर्गत Poisson वितरण, Binomial वितरण का सीमित मामला है:
- परीक्षणों की संख्या अनिश्चित रूप से बड़ी है या $n → ∞$।
- प्रत्येक परीक्षण के लिए सफलता की प्रायिकता समान और अनिश्चित रूप से छोटी है या $p →0$।
- $np = λ$, सीमित है।
निम्न शर्तों के अंतर्गत normal वितरण, Binomial वितरण का एक अन्य सीमित रूप है:
- परीक्षणों की संख्या अनिश्चित रूप से बड़ी है, $n → ∞$।
- $p$ और $q$ दोनों अनिश्चित रूप से छोटे नहीं हैं।
Bernoulli Distribution Function
Bernoulli वितरण में केवल दो संभावित परिणाम होते हैं, अर्थात् $1$ (सफलता) और $0$ (विफलता), और केवल एक परीक्षण, उदाहरण के लिए, सिक्का उछालना। तो रैंडम वैरिएबल $X$ जिसका Bernoulli वितरण है, वह सफलता की प्रायिकता $p$ के साथ मान $1$ और विफलता की प्रायिकता $q$ या $1-p$ के साथ मान $0$ ले सकता है। सफलता और विफलता की प्रायिकताएँ समान रूप से संभावित होना आवश्यक नहीं है। Bernoulli वितरण, Binomial वितरण का विशेष मामला है जहाँ केवल एक परीक्षण संचालित किया जाता है ($n=1$)। इसका प्रायिकता द्रव्यमान फलन इस प्रकार दिया जाता है:
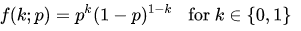
Python में Bernoulli Distribution
आप scipy.stats मॉड्यूल की bernoulli.rvs() विधि का उपयोग करके Bernoulli-वितरित विविक्त रैंडम वैरिएबल उत्पन्न कर सकते हैं, जो $p$ (सफलता की प्रायिकता) को shape पैरामीटर के रूप में लेती है। वितरण को शिफ्ट करने के लिए loc पैरामीटर का उपयोग करें। size यह तय करता है कि परीक्षणों को कितनी बार दोहराया जाए। यदि आप पुनरुत्पादनयोग्यता बनाए रखना चाहते हैं, तो किसी संख्या पर सेट किया हुआ random_state आर्ग्यूमेंट शामिल करें।
from scipy.stats import bernoulli
data_bern = bernoulli.rvs(size=10000,p=0.6)
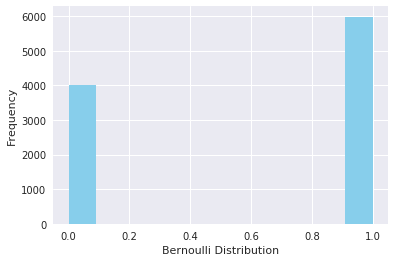
फिर से वितरण का दृश्य बनाते समय, आप देख सकते हैं कि केवल दो संभावित परिणाम हैं:
ax= sns.distplot(data_bern,
kde=False,
color="skyblue",
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]
निष्कर्ष
बधाई हो, आप इस ट्यूटोरियल के अंत तक पहुँच गए हैं! इस ट्यूटोरियल में, आपने कुछ आम प्रायिकता वितरणों का अन्वेषण किया और उन्हें Python में बनाना व प्लॉट करना सीखा। यद्यपि और भी कई वितरण खोजे जाने बाकी हैं, लेकिन शुरुआत के लिए यह पर्याप्त होगा। Python की scipy लाइब्रेरी देखना न भूलें, जिसमें अन्य रोचक सांख्यिकीय कार्यक्षमताएँ हैं। सीखते रहें, खोजते रहें!
यदि आप Python में प्रायिकता के बारे में और सीखना चाहते हैं, तो DataCamp का Statistical Simulation in Python कोर्स करें।
हमारा Poker Probability and Statistics with Python ट्यूटोरियल देखें।
परिचय
प्रायिकता (Probability) और सांख्यिकी (Statistics) डेटा साइंस की बुनियादी स्तंभ हैं। वास्तव में, मशीन लर्निंग और आर्टिफिशियल इंटेलिजेंस का आधार सांख्यिकीय गणित और रैखिक बीजगणित ही है। अक्सर, विशेषकर डेटा साइंस में, आपको ऐसे शोध पत्र पढ़ने पड़ते हैं जिनमें किसी विषय को समझने के लिए काफी गणित शामिल होता है। इसलिए यदि आप डेटा साइंस में बेहतर होना चाहते हैं, तो मजबूत गणितीय समझ होना अनिवार्य है। यह ट्यूटोरियल मशीन लर्निंग साहित्य में आमतौर पर इस्तेमाल होने वाले प्रायिकता वितरणों के बारे में है। यदि आप शुरुआत कर रहे हैं, तो यह आपके लिए सही जगह है। इस ट्यूटोरियल में, आप:
शुरू करने से पहले, आपको कुछ गणितीय शब्दावलियों से परिचित होना चाहिए, जिसकी चर्चा अगला खंड करता है।
Random Variable
रैंडम वैरिएबल वह चर है जिसके संभावित मान किसी यादृच्छिक प्रपंच (random phenomenon) के संख्यात्मक परिणाम होते हैं। रैंडम वैरिएबल दो प्रकार के होते हैं: विविक्त (discrete) और सतत (continuous)।
विविक्त रैंडम वैरिएबल ऐसा वैरिएबल है जो केवल गिनने योग्य अलग-अलग मान ले सकता है और इस तरह मात्रित किया जा सकता है। उदाहरण के लिए, आप एक रैंडम वैरिएबल $X$ को एक निष्पक्ष पासा फेंकने पर आने वाली संख्या के रूप में परिभाषित कर सकते हैं। $X$ मान ले सकता है: $[1,2,3,4,5,6]$ और इसलिए यह एक विविक्त रैंडम वैरिएबल है।
किसी विविक्त रैंडम वैरिएबल का प्रायिकता वितरण उसके प्रत्येक संभावित मान के साथ जुड़ी प्रायिकताओं की सूची होता है। इसे कभी-कभी प्रायिकता फलन या प्रायिकता द्रव्यमान फलन (probability mass function) भी कहा जाता है। गणितीय रूप से, मान लीजिए एक रैंडम वैरिएबल $X$ $k$ अलग-अलग मान ले सकता है, और $X = x_{i}$ होने की प्रायिकता $P(X = x_{i}) = p_{i}$ परिभाषित है। तब प्रायिकताएँ $p_{i}$ निम्न शर्तें संतुष्ट करती हैं:
1: प्रत्येक $i$ के लिए 0 < $p_{i}$ < 1
2: $p_{1} + p_{2} + ... + p_{k} = 1$।
विविक्त प्रायिकता वितरणों के कुछ उदाहरण हैं: Bernoulli वितरण, Binomial वितरण, Poisson वितरण आदि।
सतत रैंडम वैरिएबल वह है जो संभावित मानों की अनंत संख्या लेता है। उदाहरण के लिए, आप $X$ को किसी कक्षा में छात्रों की ऊँचाई के रूप में परिभाषित कर सकते हैं। चूंकि सतत रैंडम वैरिएबल मानों के एक अंतराल पर परिभाषित होता है, इसे किसी वक्र (या समाकल) के नीचे के क्षेत्रफल द्वारा दर्शाया जाता है।
सतत रैंडम वैरिएबल का प्रायिकता वितरण, जिसे प्रायिकता वितरण फलन कहा जाता है, ऐसे फलन होते हैं जो सतत मान लेते हैं। किसी एकल मान को देखने की प्रायिकता $0$ के बराबर होती है क्योंकि रैंडम वैरिएबल द्वारा लिए जा सकने वाले मानों की संख्या अनंत है। उदाहरण के लिए, एक रैंडम वैरिएबल $X$ वास्तविक संख्याओं के किसी अंतराल पर सभी मान ले सकता है। तब $X$ के परिणामों के समुच्चय $A$ में होने की प्रायिकता $P(A)$ को $A$ के ऊपर और किसी वक्र के नीचे के क्षेत्रफल के रूप में परिभाषित किया जाता है। यह वक्र, जो $p(x)$ फलन को दर्शाता है, निम्न शर्तें संतुष्ट करता है:
1: वक्र का कोई मान ऋणात्मक नहीं है (सभी $x$ के लिए $(p(x) > 0$))
2: वक्र के नीचे का कुल क्षेत्रफल $1$ के बराबर है।
इन शर्तों को संतुष्ट करने वाले वक्र को अक्सर घनत्व वक्र (density curve) कहा जाता है। सतत प्रायिकता वितरणों के कुछ उदाहरण हैं: normal वितरण, exponential वितरण, beta वितरण, आदि।
साहित्य में अक्सर दिखाई देने वाला एक और प्रकार का वितरण है जिसे आपको जानना चाहिए, जिसे क्यूम्युलेटिव डिस्ट्रीब्यूशन फंक्शन (cumulative distribution function) कहा जाता है। सभी रैंडम वैरिएबल्स (विविक्त और सतत) का एक संचयी वितरण फलन होता है। यह ऐसा फलन है जो प्रत्येक $x$ के मान के लिए यह प्रायिकता देता है कि रैंडम वैरिएबल $X$ $x$ से कम या उसके बराबर है। किसी विविक्त रैंडम वैरिएबल के लिए, संचयी वितरण फलन प्रायिकताओं को जोड़कर पाया जाता है।
अगले खंड में, आप कुछ महत्वपूर्ण वितरणों का अन्वेषण करेंगे और उन्हें Python में आज़माएँगे, पर उससे पहले उन सभी आवश्यक लाइब्रेरीज़ को इम्पोर्ट करें जिनका आप उपयोग करेंगे।