Fondamenti di probabilità in Python
BasicSkill Level
5 ore
16.4K learners
Esegui e modifica il codice da questo tutorial online
Esegui codiceForse una delle distribuzioni più semplici e utili è la distribuzione uniforme. La funzione di distribuzione di probabilità della distribuzione uniforme continua è:
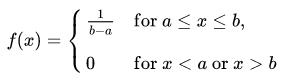
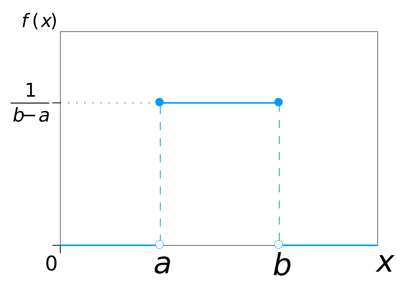
Poiché qualsiasi intervallo di numeri di uguale ampiezza ha uguale probabilità di essere osservato, la curva che descrive la distribuzione è un rettangolo, con altezza costante sull’intervallo e altezza 0 altrove. Poiché l’area sotto la curva deve essere pari a 1, la lunghezza dell’intervallo determina l’altezza della curva. La figura seguente mostra una distribuzione uniforme nell’intervallo (a,b). Nota che, poiché l’area deve essere $1$, l’altezza è impostata a $1/(b-a)$.
Puoi visualizzare la distribuzione uniforme in Python con l’aiuto di un generatore di numeri casuali che agisce su un intervallo di numeri (a,b). Devi importare la funzione uniform dal modulo scipy.stats.
# import uniform distribution
from scipy.stats import uniform
La funzione uniform genera una variabile continua uniforme tra l’intervallo specificato tramite gli argomenti loc e scale. Questa distribuzione è costante tra loc e loc + scale. L’argomento size indica il numero di variate casuali. Se vuoi mantenere la riproducibilità, includi un argomento random_state assegnato a un numero.
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
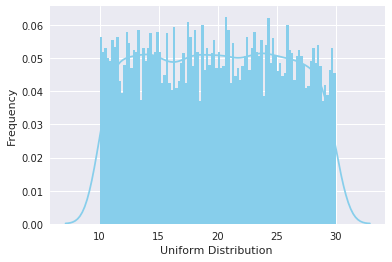
Puoi usare il distplot di Seaborn per tracciare l’istogramma della distribuzione appena creata. Il distplot di Seaborn accetta diversi argomenti per personalizzare il grafico. Per prima cosa crei un oggetto grafico ax. Qui puoi specificare il numero di bins nell’istogramma, il color dell’istogramma e l’opzione del grafico di densità con kde e lo spessore dei bordi con hist_kws. Puoi anche impostare le etichette degli assi x e y usando gli argomenti xlabel e ylabel.
ax = sns.distplot(data_uniform,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
La distribuzione normale, nota anche come distribuzione gaussiana, è onnipresente in Data Science. La incontrerai spesso, soprattutto negli argomenti di inferenza statistica. È anche un’ipotesi alla base di molti algoritmi di data science.
Una distribuzione normale ha una curva di densità a campana descritta dalla sua media $μ$ e deviazione standard $σ$. La curva di densità è simmetrica, centrata sulla sua media, con la dispersione determinata dalla deviazione standard, a indicare che i dati vicini alla media si verificano più frequentemente dei dati lontani dalla media. La funzione di distribuzione di probabilità di una curva normale con media $μ$ e deviazione standard $σ$ in un punto $x$ è data da:
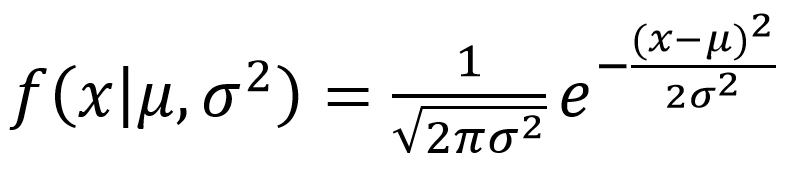
Di seguito la figura che descrive l’aspetto della distribuzione:
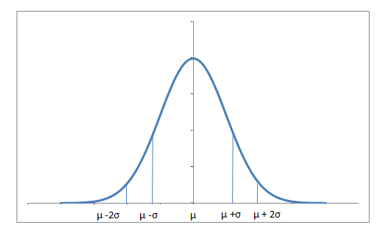
Quasi il 68% dei dati cade entro una distanza di una deviazione standard dalla media da entrambi i lati e il 95% entro due deviazioni standard. Vale anche la pena menzionare che una distribuzione con media $0$ e deviazione standard $1$ è chiamata distribuzione normale standard.
Puoi generare una variabile aleatoria normalmente distribuita usando il metodo norm.rvs() del modulo scipy.stats. L’argomento loc corrisponde alla media della distribuzione. scale corrisponde alla deviazione standard e size al numero di variate casuali. Se vuoi mantenere la riproducibilità, includi un argomento random_state assegnato a un numero.
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
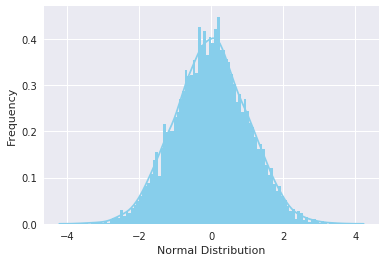
Puoi visualizzare la distribuzione proprio come hai fatto con la distribuzione uniforme, usando le funzioni distplot di Seaborn. Il significato degli argomenti rimane lo stesso del caso precedente.
ax = sns.distplot(data_normal,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
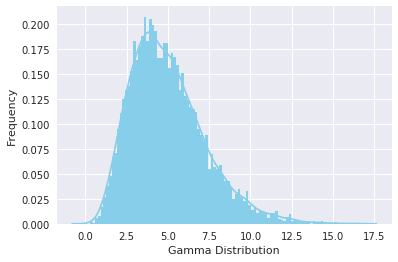
La distribuzione gamma è una famiglia a due parametri di distribuzioni di probabilità continue. Sebbene sia usata raramente nella sua forma grezza, altre distribuzioni molto utilizzate come l’esponenziale, la chi-quadro e l’erlang sono casi particolari della distribuzione gamma. La distribuzione gamma può essere parametrizzata in termini di un parametro di forma $α = k$ e di un parametro di scala inverso $β = 1/θ$, detto parametro di tasso. Il simbolo $Γ(n)$ è la funzione gamma ed è definita come $(n-1)!$ :
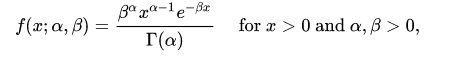
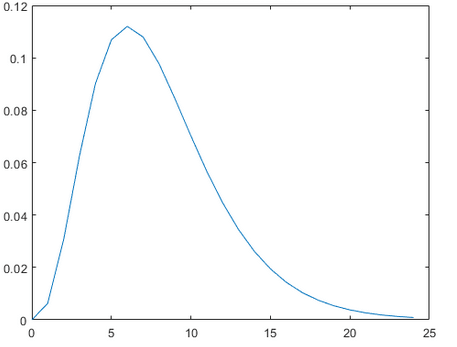
Una tipica distribuzione gamma appare così:
Puoi generare una variabile aleatoria distribuita secondo la gamma usando il metodo gamma.rvs() del modulo scipy.stats, che prende come argomento il parametro di forma $a$. Quando $a$ è un intero, la gamma si riduce alla distribuzione di Erlang, e quando $a=1$ alla distribuzione esponenziale. Per traslare la distribuzione usa l’argomento loc, per scalarla usa l’argomento scale; size determina il numero di variate casuali nella distribuzione. Se vuoi mantenere la riproducibilità, includi un argomento random_state assegnato a un numero.
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
Puoi visualizzare la distribuzione proprio come hai fatto con la distribuzione uniforme, usando le funzioni distplot di Seaborn. Il significato degli argomenti rimane lo stesso spiegato nella sezione sulla distribuzione uniforme.
ax = sns.distplot(data_gamma,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
La distribuzione esponenziale descrive il tempo tra eventi in un processo di Poisson, cioè un processo in cui gli eventi si verificano continuamente e indipendentemente a un tasso medio costante. Ha un parametro $λ$ chiamato parametro di tasso, e la sua equazione è descritta come:
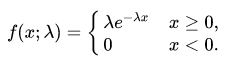
Una distribuzione esponenziale decrescente appare così:
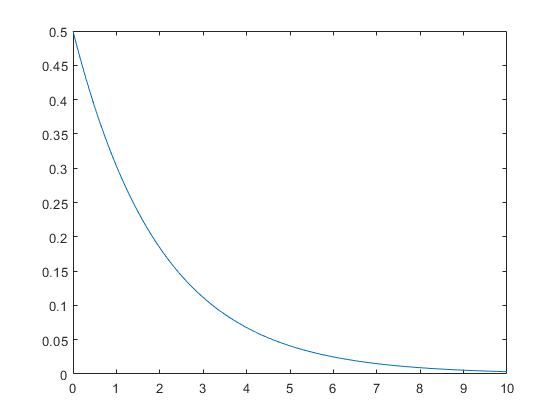
Puoi generare una variabile aleatoria distribuita esponenzialmente usando il metodo expon.rvs() del modulo scipy.stats, che prende come argomento il parametro di forma scale, che non è altro che 1/lambda nell’equazione. Per traslare la distribuzione usa l’argomento loc; size determina il numero di variate casuali nella distribuzione. Se vuoi mantenere la riproducibilità, includi un argomento random_state assegnato a un numero.
from scipy.stats import expon
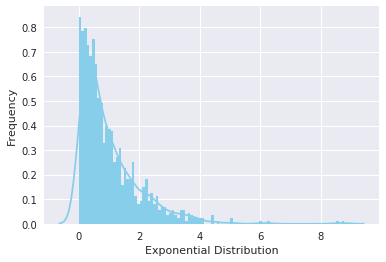
data_expon = expon.rvs(scale=1,loc=0,size=1000)
Ancora una volta, la visualizzazione della distribuzione con Seaborn produce la curva mostrata di seguito:
ax = sns.distplot(data_expon,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
La variabile aleatoria di Poisson è tipicamente usata per modellare il numero di volte in cui un evento accade in un intervallo di tempo. Ad esempio, il numero di utenti che visitano un sito web in un intervallo può essere pensato come un processo di Poisson. La distribuzione di Poisson è descritta in termini del tasso ($μ$) con cui gli eventi accadono. Un evento può verificarsi 0, 1, 2, … volte in un intervallo. Il numero medio di eventi in un intervallo è indicato con $λ$ (lambda). Lambda è il tasso degli eventi, detto anche parametro di tasso. La probabilità di osservare $k$ eventi in un intervallo è data dall’equazione:
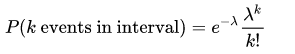
Nota che la distribuzione normale è un caso limite della distribuzione di Poisson con il parametro $λ →∞$. Inoltre, se i tempi tra eventi casuali seguono una distribuzione esponenziale con tasso $λ$, allora il numero totale di eventi in un periodo di tempo di lunghezza $t$ segue la distribuzione di Poisson con parametro $λt$.
La figura seguente mostra una tipica distribuzione di Poisson:
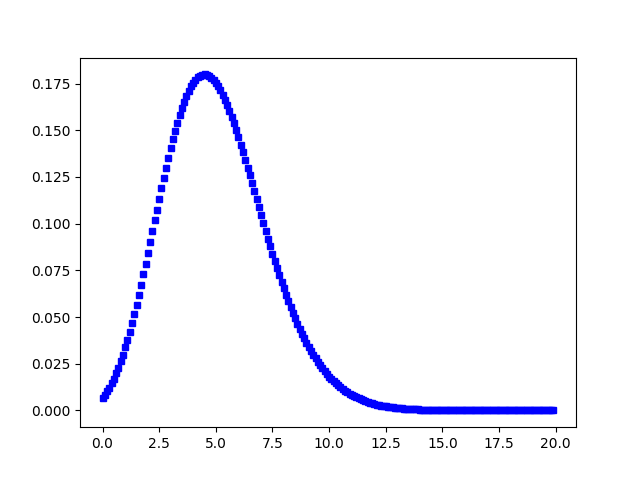
Puoi generare una variabile aleatoria discreta distribuita secondo Poisson usando il metodo poisson.rvs() del modulo scipy.stats, che prende $μ$ come parametro di forma e non è altro che $λ$ nell’equazione. Per traslare la distribuzione usa il parametro loc. size determina il numero di variate casuali nella distribuzione. Se vuoi mantenere la riproducibilità, includi un argomento random_state assegnato a un numero.
from scipy.stats import poisson
data_poisson = poisson.rvs(mu=3, size=10000)
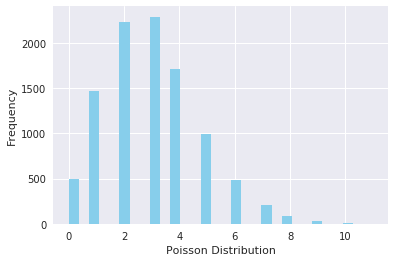
Puoi visualizzare la distribuzione proprio come hai fatto con la distribuzione uniforme, usando le funzioni distplot di Seaborn. Il significato degli argomenti rimane lo stesso.
ax = sns.distplot(data_poisson,
                  bins=30,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
Una distribuzione in cui sono possibili solo due esiti, come successo o fallimento, guadagno o perdita, vittoria o sconfitta, e in cui la probabilità di successo e fallimento è la stessa per tutte le prove, è chiamata distribuzione binomiale. Tuttavia, gli esiti non devono essere necessariamente equiprobabili, e ogni prova è indipendente dalle altre. I parametri di una distribuzione binomiale sono $n$ e $p$, dove $n$ è il numero totale di prove e $p$ è la probabilità di successo in ciascuna prova. La sua funzione di distribuzione di probabilità è data da:
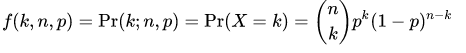
dove:
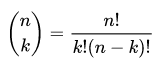
Puoi generare una variabile aleatoria discreta distribuita secondo la binomiale usando il metodo binom.rvs() del modulo scipy.stats, che prende $n$ (numero di prove) e $p$ (probabilità di successo) come parametri di forma. Per traslare la distribuzione usa il parametro loc. size decide quante volte ripetere le prove. Se vuoi mantenere la riproducibilità, includi un argomento random_state assegnato a un numero.
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
La visualizzazione della distribuzione appena creata con il distplot di Seaborn restituisce il seguente istogramma:
ax = sns.distplot(data_binom,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Binomial Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]
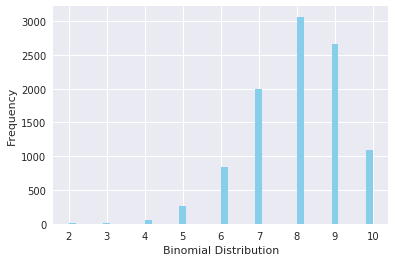
Nota che, poiché la probabilità di successo era maggiore di $0.5$, la distribuzione è asimmetrica verso destra. Inoltre, la distribuzione di Poisson è un caso limite di una distribuzione binomiale nelle seguenti condizioni:
La distribuzione normale è un’altra forma limite della distribuzione binomiale nelle seguenti condizioni:
Una distribuzione di Bernoulli ha solo due possibili esiti, cioè $1$ (successo) e $0$ (fallimento), e una sola prova, per esempio il lancio di una moneta. Quindi la variabile aleatoria $X$ che ha una distribuzione di Bernoulli può assumere valore $1$ con probabilità di successo $p$, e valore $0$ con probabilità di fallimento $q$ ovvero $1-p$. Le probabilità di successo e fallimento non devono essere necessariamente uguali. La distribuzione di Bernoulli è un caso particolare della distribuzione binomiale in cui si effettua una sola prova ($n=1$). La sua funzione di massa di probabilità è data da:
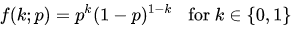
Puoi generare una variabile aleatoria discreta distribuita secondo Bernoulli usando il metodo bernoulli.rvs() del modulo scipy.stats, che prende $p$ (probabilità di successo) come parametro di forma. Per traslare la distribuzione usa il parametro loc. size decide quante volte ripetere le prove. Se vuoi mantenere la riproducibilità, includi un argomento random_state assegnato a un numero.
from scipy.stats import bernoulli
data_bern = bernoulli.rvs(size=10000,p=0.6)
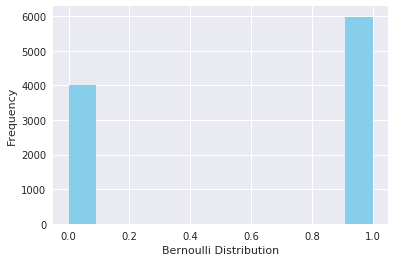
Visualizzando di nuovo la distribuzione, puoi osservare che hai solo due possibili esiti:
ax= sns.distplot(data_bern,
                 kde=False,
                 color="skyblue",
                 hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]
Congratulazioni, sei arrivato alla fine di questo tutorial! In questo percorso hai esplorato alcune distribuzioni di probabilità comunemente usate e hai imparato a crearle e tracciarle in Python. Anche se ci sono molte altre distribuzioni da esplorare, questo è sufficiente per iniziare. Non dimenticare di dare un’occhiata alla libreria scipy di Python, che include molte altre funzionalità statistiche interessanti. Buona esplorazione!
Se vuoi approfondire la probabilità in Python, segui il corso di DataCamp Statistical Simulation in Python.
Dai un’occhiata anche al nostro tutorial Probabilità e statistica del poker con Python.
Corsi Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



