

Execute e edite o código deste tutorial online
Executar códigoFunção da distribuição uniforme
Uma das distribuições mais simples e úteis é a uniforme. A função de distribuição de probabilidade da distribuição uniforme contínua é:
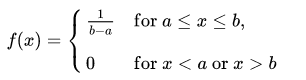
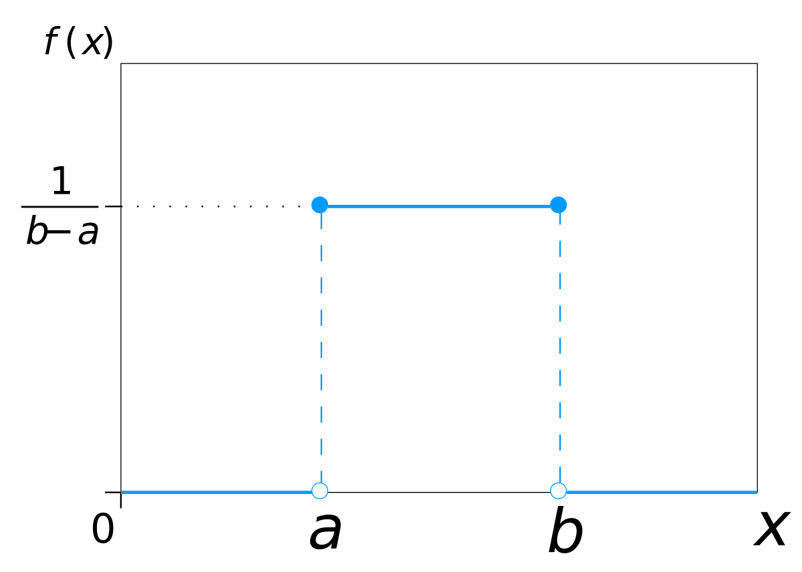
Como qualquer intervalo de mesma largura tem a mesma probabilidade de ser observado, a curva que descreve a distribuição é um retângulo: altura constante no intervalo e 0 fora dele. Como a área sob a curva deve ser 1, o comprimento do intervalo define a altura da curva. A figura a seguir mostra uma distribuição uniforme no intervalo (a,b). Note que, como a área precisa ser $1$, a altura é $1/(b-a)$.
Distribuição uniforme em Python
Você pode visualizar a distribuição uniforme em Python usando um gerador de números aleatórios em um intervalo (a,b). Importe a função uniform do módulo scipy.stats.
# import uniform distribution
from scipy.stats import uniform
A função uniform gera uma variável contínua uniforme entre o intervalo especificado via os argumentos loc e scale. A distribuição é constante entre loc e loc + scale. O argumento size indica a quantidade de variáveis aleatórias. Para reprodutibilidade, inclua um random_state com um número fixo.
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
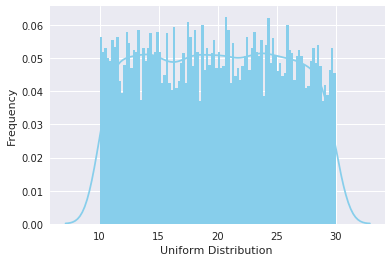
Você pode usar o distplot do Seaborn para plotar o histograma da distribuição criada. O distplot aceita vários argumentos para personalização. Primeiro, crie um objeto de plotagem ax. Nele, você pode definir o número de bins do histograma, a color do gráfico, ativar a densidade com kde e ajustar a largura de linha com hist_kws. Também dá para definir os rótulos dos eixos x e y com xlabel e ylabel.
ax = sns.distplot(data_uniform,
bins=100,
kde=True,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
Função da distribuição normal
A distribuição normal, também chamada de Gaussiana, é onipresente em ciência de dados. Você vai encontrá-la em vários tópicos de inferência estatística. Ela também é suposição de muitos algoritmos.
Uma distribuição normal tem formato de sino, descrita por sua média $μ$ e desvio padrão $σ$. A curva é simétrica, centrada na média, e a dispersão é determinada pelo desvio padrão, mostrando que valores próximos da média ocorrem com mais frequência que valores distantes dela. A função de distribuição de probabilidade de uma curva normal com média $μ$ e desvio padrão $σ$ em um ponto $x$ é dada por:
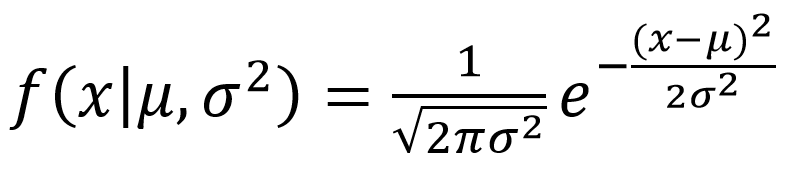
Abaixo, uma figura ilustrando o aspecto da distribuição:
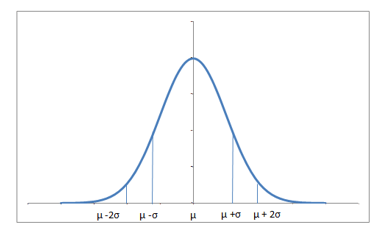
Quase 68% dos dados ficam a uma distância de um desvio padrão da média (para ambos os lados) e 95% dentro de dois desvios padrão. Vale citar que a distribuição com média $0$ e desvio padrão $1$ é a normal padrão.
Distribuição normal em Python
Você pode gerar uma variável aleatória normal usando o método norm.rvs() do módulo scipy.stats. O argumento loc corresponde à média; scale, ao desvio padrão; e size, à quantidade de amostras. Para reprodutibilidade, inclua random_state com um número.
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
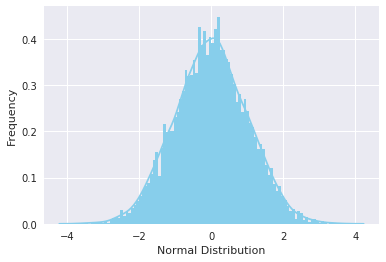
A visualização é análoga à da distribuição uniforme, usando o distplot do Seaborn. Os argumentos têm o mesmo significado.
ax = sns.distplot(data_normal,
bins=100,
kde=True,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
Função da distribuição gama
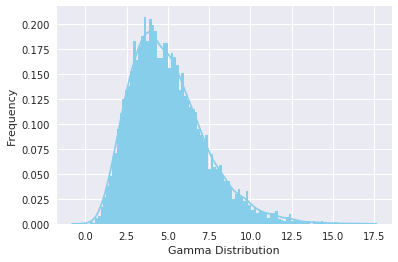
A distribuição gama é uma família de distribuições contínuas de dois parâmetros. Embora raramente usada em sua forma bruta, outras distribuições populares — como exponencial, qui-quadrado e Erlang — são casos especiais da gama. Ela pode ser parametrizada por um parâmetro de forma $α = k$ e um parâmetro de escala inversa $β = 1/θ$, chamado de taxa. O símbolo $Γ(n)$ é a função gama e é definida como $(n-1)!$ :
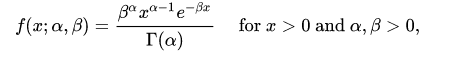
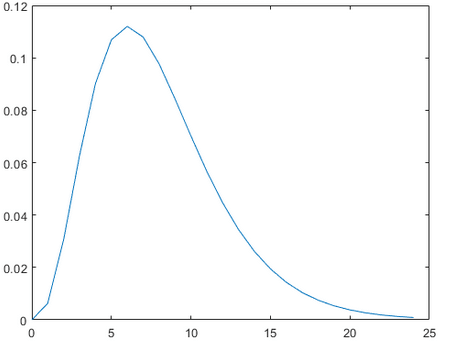
Uma distribuição gama típica se parece com isto:
Distribuição gama em Python
Você pode gerar uma variável aleatória com distribuição gama usando o método gamma.rvs() do módulo scipy.stats, que recebe o parâmetro de forma $a$. Quando $a$ é inteiro, a gama se reduz à distribuição de Erlang; quando $a=1$, à distribuição exponencial. Para deslocar a distribuição, use loc; para escalá-la, scale; size define o número de amostras. Para reprodutibilidade, inclua random_state com um número.
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
A visualização segue o mesmo padrão da seção de distribuição uniforme, usando o distplot do Seaborn. Os argumentos têm o mesmo significado.
ax = sns.distplot(data_gamma,
kde=True,
bins=100,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
Função da distribuição exponencial
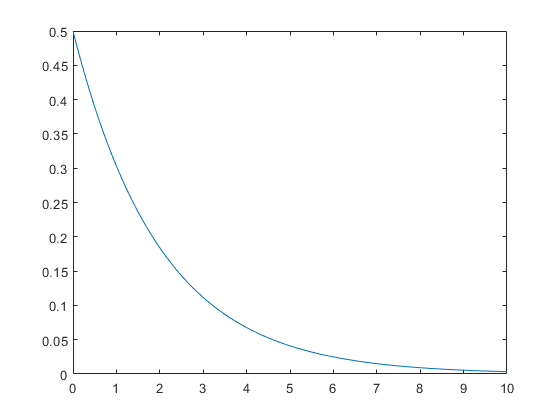
A distribuição exponencial descreve o tempo entre eventos em um processo de Poisson, isto é, um processo no qual eventos ocorrem continuamente e de forma independente a uma taxa média constante. Ela tem um parâmetro $λ$, chamado de taxa, e sua equação é:
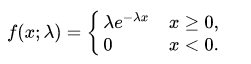
Uma distribuição exponencial decrescente se parece com isto:
Distribuição exponencial em Python
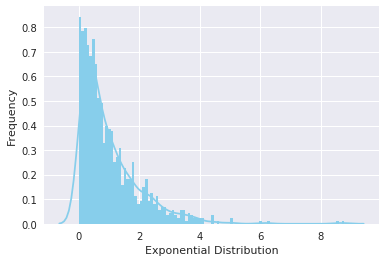
Você pode gerar uma variável aleatória exponencial usando o método expon.rvs() do módulo scipy.stats, que recebe o parâmetro scale, equivalente a 1/lambda na equação. Para deslocar a distribuição, use loc; size define o número de amostras. Para reprodutibilidade, inclua random_state com um número.
from scipy.stats import expon
data_expon = expon.rvs(scale=1,loc=0,size=1000)
Visualizando a distribuição com Seaborn, obtemos a curva abaixo:
ax = sns.distplot(data_expon,
kde=True,
bins=100,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
Distribuição de Poisson
A variável aleatória de Poisson é tipicamente usada para modelar o número de vezes que um evento ocorre em um intervalo de tempo. Por exemplo, o número de usuários que visitam um site em um intervalo pode ser modelado por um processo de Poisson. A distribuição de Poisson é descrita em termos da taxa ($μ$) a que os eventos acontecem. Um evento pode ocorrer 0, 1, 2, … vezes em um intervalo. O número médio de eventos no intervalo é designado por $λ$ (lambda). Lambda é a taxa do evento, também chamada de parâmetro de taxa. A probabilidade de observar $k$ eventos em um intervalo é dada por:
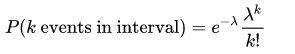
Observação: a distribuição normal é um caso limite da Poisson quando $λ →∞$. Além disso, se os tempos entre eventos aleatórios seguem uma distribuição exponencial com taxa $λ$, então o número total de eventos em um período de duração $t$ segue a distribuição de Poisson com parâmetro $λt$.
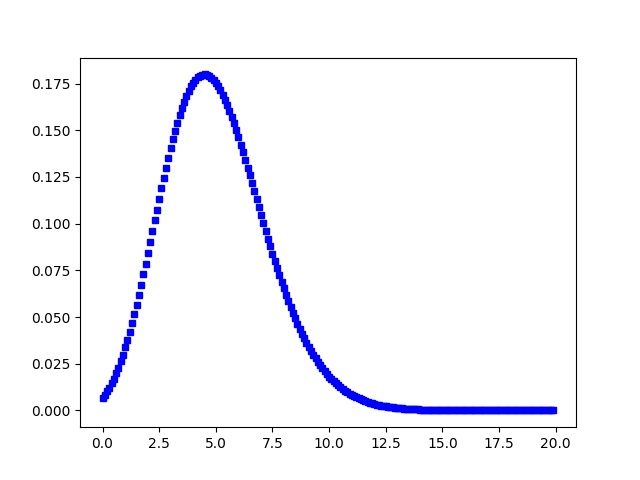
A figura a seguir mostra uma distribuição de Poisson típica:
Distribuição de Poisson em Python
Você pode gerar uma variável aleatória discreta de Poisson usando o método poisson.rvs() do módulo scipy.stats, que recebe $μ$ como parâmetro de forma (equivalente a $λ$ na fórmula). Para deslocar a distribuição, use loc. size define o número de amostras. Para reprodutibilidade, inclua random_state com um número.
from scipy.stats import poisson
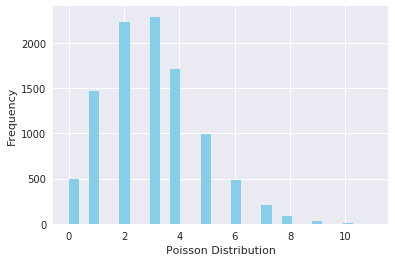
data_poisson = poisson.rvs(mu=3, size=10000)
A visualização segue o mesmo padrão da distribuição uniforme, usando o distplot do Seaborn. Os argumentos têm o mesmo significado.
ax = sns.distplot(data_poisson,
bins=30,
kde=False,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
Função da distribuição binomial
Uma distribuição em que só existem dois resultados possíveis — por exemplo, sucesso ou fracasso, ganho ou perda, vitória ou derrota — e em que a probabilidade de sucesso e fracasso é a mesma em todas as tentativas é chamada de distribuição binomial. No entanto, os resultados não precisam ser equiprováveis, e cada tentativa é independente das demais. Os parâmetros da binomial são $n$ e $p$, onde $n$ é o número total de tentativas e $p$ é a probabilidade de sucesso em cada uma. Sua função de distribuição de probabilidade é:
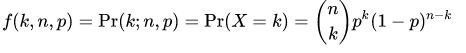
em que:
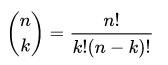
Distribuição binomial em Python
Você pode gerar uma variável aleatória discreta binomial usando o método binom.rvs() do módulo scipy.stats, que recebe $n$ (número de tentativas) e $p$ (probabilidade de sucesso) como parâmetros de forma. Para deslocar a distribuição, use loc. size define quantas vezes repetir as tentativas. Para reprodutibilidade, inclua random_state com um número.
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
Visualizando a distribuição criada com o distplot do Seaborn, obtemos o histograma abaixo:
ax = sns.distplot(data_binom,
kde=False,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Binomial Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]
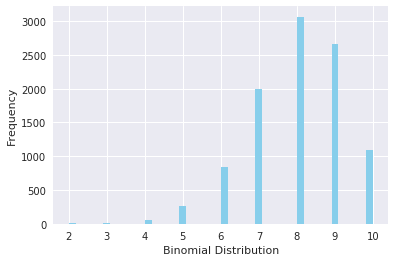
Observação: como a probabilidade de sucesso foi maior que $0.5$, a distribuição é inclinada para a direita. Além disso, a distribuição de Poisson é um caso limite da binomial sob as condições:
- O número de tentativas é indefinidamente grande, $n → ∞$.
- A probabilidade de sucesso em cada tentativa é a mesma e indefinidamente pequena, $p → 0$.
- $np = λ$ é finito.
A distribuição normal é outro caso limite da binomial quando:
- O número de tentativas é indefinidamente grande, $n → ∞$.
- Ambos $p$ e $q$ não são indefinidamente pequenos.
Função da distribuição de Bernoulli
Uma distribuição de Bernoulli tem apenas dois resultados possíveis, $1$ (sucesso) e $0$ (fracasso), e uma única tentativa — por exemplo, o lançamento de uma moeda. Assim, a variável aleatória $X$ com distribuição de Bernoulli pode assumir valor $1$ com probabilidade de sucesso $p$, e valor $0$ com probabilidade de fracasso $q$ ou $1-p$. As probabilidades de sucesso e fracasso não precisam ser iguais. A distribuição de Bernoulli é um caso especial da binomial em que há uma única tentativa ($n=1$). Sua função massa de probabilidade é:
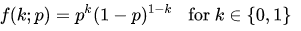
Distribuição de Bernoulli em Python
Você pode gerar uma variável aleatória discreta de Bernoulli usando o método bernoulli.rvs() do módulo scipy.stats, que recebe $p$ (probabilidade de sucesso) como parâmetro de forma. Para deslocar a distribuição, use loc. size define quantas vezes repetir as tentativas. Para reprodutibilidade, inclua random_state com um número.
from scipy.stats import bernoulli
data_bern = bernoulli.rvs(size=10000,p=0.6)
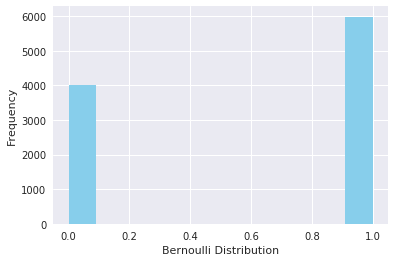
Visualizando a distribuição, dá para observar que existem apenas dois possíveis resultados:
ax= sns.distplot(data_bern,
kde=False,
color="skyblue",
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]
Conclusão
Parabéns por chegar até o fim! Neste tutorial, você explorou distribuições de probabilidade muito usadas e aprendeu a criá-las e plotá-las em Python. Embora existam muitas outras, isso já é suficiente para começar. Não deixe de conferir a biblioteca scipy do Python, que traz vários recursos estatísticos interessantes. Boa exploração!
Se quiser se aprofundar em probabilidade com Python, faça o curso Statistical Simulation in Python da DataCamp.
Confira também nosso tutorial Poker Probability and Statistics with Python.







Introdução
Probabilidade e Estatística são os pilares da ciência de dados. Na prática, a base de machine learning e inteligência artificial é matemática estatística e álgebra linear. Com frequência, especialmente em ciência de dados, você vai se deparar com artigos científicos cheios de matemática para entender um determinado tema; por isso, se você quer evoluir na área, é fundamental ter uma base matemática sólida. Este tutorial apresenta as distribuições de probabilidade mais usadas na literatura de machine learning. Se você está começando, este é um ótimo ponto de partida. Neste tutorial, você vai:
Antes de começar, vale se familiarizar com alguns termos matemáticos — é o que a próxima seção cobre.
Variável aleatória
Uma variável aleatória é uma variável cujos possíveis valores são resultados numéricos de um fenômeno aleatório. Existem dois tipos: discretas e contínuas.
Uma variável aleatória discreta assume apenas um número contável de valores distintos e, portanto, pode ser quantificada. Por exemplo, defina a variável aleatória $X$ como o número que sai ao lançar um dado justo. $X$ pode assumir os valores $[1,2,3,4,5,6]$ e, portanto, é discreta.
A distribuição de probabilidade de uma variável aleatória discreta é uma lista de probabilidades associadas a cada um de seus possíveis valores. Ela também é chamada de função de probabilidade ou função massa de probabilidade. Em termos matemáticos, suponha que uma variável aleatória $X$ possa assumir $k$ valores diferentes, com a probabilidade de $X = x_{i}$ definida como $P(X = x_{i}) = p_{i}$. Então as probabilidades $p_{i}$ devem satisfazer:
1: 0 < $p_{i}$ < 1 para cada $i$
2: $p_{1} + p_{2} + ... + p_{k} = 1$.
Alguns exemplos de distribuições discretas: Bernoulli, Binomial, Poisson etc.
Uma variável aleatória contínua assume um número infinito de valores possíveis. Por exemplo, defina $X$ como a altura dos alunos de uma turma. Como a variável contínua é definida em um intervalo de valores, ela é representada pela área sob uma curva (ou integral).
A distribuição de probabilidade de uma variável aleatória contínua, conhecida como função de distribuição de probabilidade, é uma função que assume valores contínuos. A probabilidade de observar um único valor é igual a $0$, já que o número de valores possíveis é infinito. Por exemplo, $X$ pode assumir todos os valores em um intervalo de números reais. Então a probabilidade de $X$ estar no conjunto de resultados $A$, $P(A)$, é definida como a área acima de $A$ e sob uma curva. A curva, que representa uma função $p(x)$, deve satisfazer:
1: A curva não tem valores negativos $(p(x) > 0$ para todo $x$)
2: A área total sob a curva é igual a $1$.
Uma curva que atende a esses requisitos é conhecida como curva de densidade. Exemplos de distribuições contínuas: normal, exponencial, beta, entre outras.
Há ainda outro tipo de função muito comum na literatura: a função de distribuição acumulada (CDF). Toda variável aleatória (discreta ou contínua) possui uma CDF. Ela fornece a probabilidade de a variável aleatória $X$ ser menor ou igual a $x$, para cada valor $x$. Para variáveis discretas, a CDF é obtida somando as probabilidades.
Na próxima seção, você vai explorar algumas distribuições importantes e trabalhar com elas em Python. Antes, importe as bibliotecas necessárias.