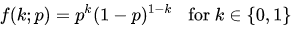Fundamentos de probabilidad en Python
BasicSkill Level
5 h
16.1K learners
Ejecuta y edita el código de este tutorial en línea
Ejecutar códigoQuizá una de las distribuciones más sencillas y útiles es la uniforme. La función de distribución de probabilidad de la distribución uniforme continua es:
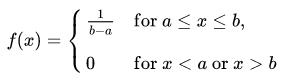
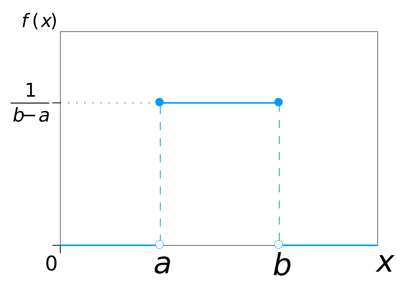
Dado que cualquier intervalo de igual anchura tiene la misma probabilidad de observarse, la curva que describe la distribución es un rectángulo, con altura constante en el intervalo y 0 fuera de él. Como el área bajo la curva debe ser 1, la longitud del intervalo determina la altura. La siguiente figura muestra una distribución uniforme en el intervalo (a,b). Observa que, como el área debe ser $1$, la altura es $1/(b-a)$.
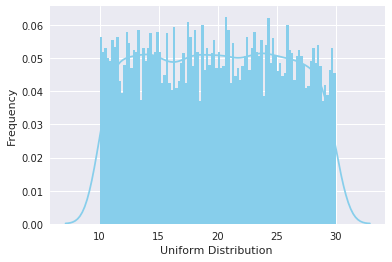
Puedes visualizar la distribución uniforme en Python con un generador de números aleatorios sobre un intervalo (a,b). Tienes que importar la función uniform del módulo scipy.stats.
# import uniform distribution
from scipy.stats import uniform
La función uniform genera una variable continua uniforme entre el intervalo especificado mediante los argumentos loc y scale. Esta distribución es constante entre loc y loc + scale. El argumento size indica cuántas variables aleatorias generar. Si quieres reproducibilidad, pasa un random_state con un número fijo.
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
Puedes usar distplot de Seaborn para representar el histograma de la distribución que acabas de crear. distplot acepta múltiples argumentos para personalizar la gráfica. Primero creas un objeto de gráfico ax. Aquí puedes indicar el número de bins del histograma, el color, activar la densidad con kde y ajustar el grosor de línea con hist_kws. También puedes establecer etiquetas de los ejes x e y con xlabel y ylabel.
ax = sns.distplot(data_uniform,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
La distribución normal, también conocida como gaussiana, es omnipresente en ciencia de datos. Te la encontrarás en muchos sitios, especialmente en inferencia estadística. Además, es uno de los supuestos de muchos algoritmos.
Una distribución normal tiene una curva de densidad en forma de campana descrita por su media $μ$ y su desviación estándar $σ$. La curva es simétrica y está centrada en su media; la dispersión viene determinada por la desviación estándar, mostrando que los datos cercanos a la media son más frecuentes que los alejados. La función de densidad de una normal con media $μ$ y desviación estándar $σ$ en un punto $x$ viene dada por:
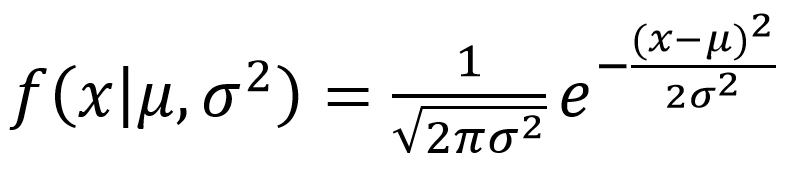
A continuación se muestra el aspecto de la distribución:
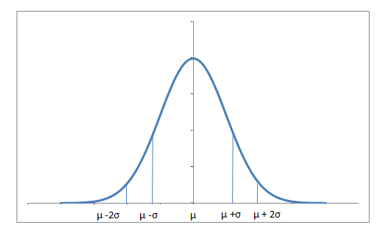
Casi el 68% de los datos cae a una distancia de una desviación estándar de la media a ambos lados y el 95% dentro de dos desviaciones estándar. También conviene mencionar que una distribución con media $0$ y desviación estándar $1$ se denomina distribución normal estándar.
Puedes generar una variable aleatoria normalmente distribuida con el método norm.rvs() del módulo scipy.stats. El argumento loc corresponde a la media, scale a la desviación estándar y size al número de valores. Si quieres reproducibilidad, pasa un random_state con un número fijo.
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
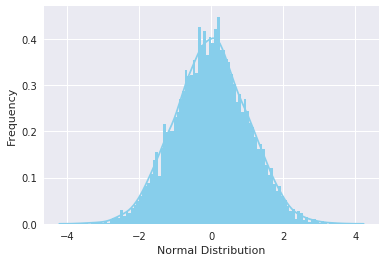
Puedes visualizar la distribución igual que con la uniforme, usando distplot de Seaborn. El significado de los argumentos es el mismo que antes.
ax = sns.distplot(data_normal,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
La distribución gamma es una familia de distribuciones continuas con dos parámetros. Aunque rara vez se usa tal cual, otras distribuciones muy populares, como la exponencial, la ji cuadrado o la de Erlang, son casos particulares de la gamma. La distribución gamma se puede parametrizar con un parámetro de forma $α = k$ y un parámetro de escala inversa $β = 1/θ$, llamado parámetro de tasa. El símbolo $Γ(n)$ es la función gamma y se define como $(n-1)!$ :
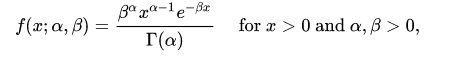
Una distribución gamma típica tiene este aspecto:
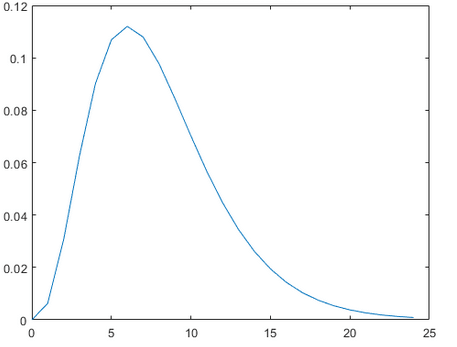
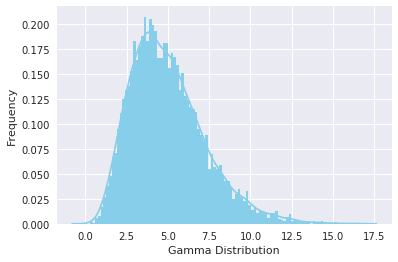
Puedes generar una variable aleatoria gamma con el método gamma.rvs() del módulo scipy.stats, que recibe el parámetro de forma $a$. Cuando $a$ es un entero, gamma se reduce a la distribución de Erlang; y cuando $a=1$, a la distribución exponencial. Para desplazar la distribución usa loc; para escalar, scale; size decide el número de valores. Si quieres reproducibilidad, pasa un random_state con un número fijo.
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
Puedes visualizar la distribución igual que con la uniforme, usando distplot de Seaborn. El significado de los argumentos es el mismo que se explicó en la sección de distribución uniforme.
ax = sns.distplot(data_gamma,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
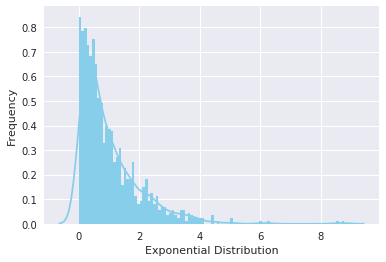
La distribución exponencial describe el tiempo entre eventos en un proceso de Poisson, es decir, un proceso en el que los eventos ocurren de forma continua e independiente a una tasa media constante. Tiene un parámetro $λ$ llamado parámetro de tasa, y su expresión es:
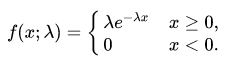
Una distribución exponencial decreciente tiene este aspecto:
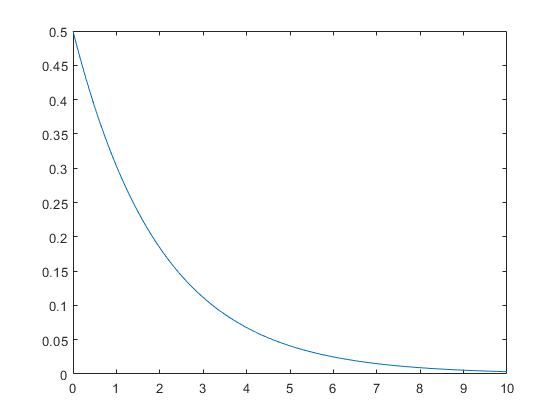
Puedes generar una variable aleatoria exponencial con el método expon.rvs() del módulo scipy.stats, que recibe el parámetro de forma scale, que no es más que 1/lambda en la fórmula. Para desplazar la distribución usa loc; size decide cuántos valores generar. Si quieres reproducibilidad, pasa un random_state con un número fijo.
from scipy.stats import expon
data_expon = expon.rvs(scale=1,loc=0,size=1000)
Al visualizar la distribución con Seaborn obtendrás la siguiente curva:
ax = sns.distplot(data_expon,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
La variable aleatoria de Poisson se usa típicamente para modelar el número de veces que sucede un evento en un intervalo de tiempo. Por ejemplo, el número de usuarios que visitan una web en un intervalo se puede modelar como un proceso de Poisson. La distribución de Poisson se describe en términos de la tasa ($μ$) a la que ocurren los eventos. Un evento puede ocurrir 0, 1, 2, … veces en un intervalo. El número medio de eventos en un intervalo se denota por $λ$ (lambda). Lambda es la tasa de eventos, también llamada parámetro de tasa. La probabilidad de observar $k$ eventos en un intervalo viene dada por:
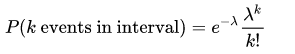
Nota: la distribución normal es un caso límite de la de Poisson cuando el parámetro $λ →∞$. Además, si los tiempos entre eventos aleatorios siguen una exponencial de tasa $λ$, entonces el número total de eventos en un periodo de longitud $t$ sigue una Poisson con parámetro $λt$.
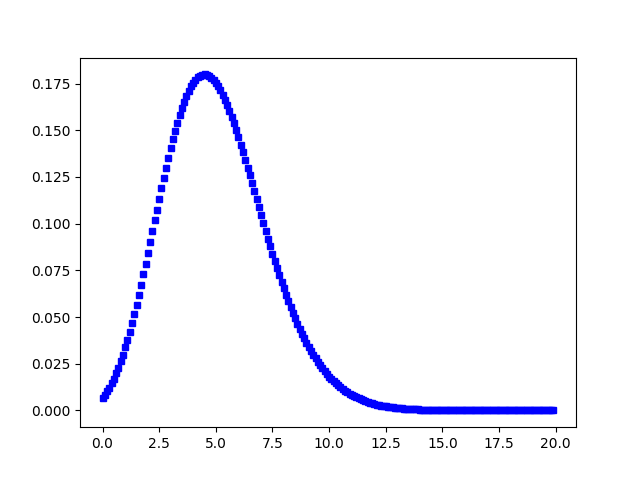
La siguiente figura muestra una distribución de Poisson típica:
Puedes generar una variable aleatoria discreta de Poisson con el método poisson.rvs() del módulo scipy.stats, que recibe $μ$ como parámetro de forma y que no es más que el $λ$ de la expresión. Para desplazar la distribución usa loc. size decide cuántos valores generar. Si quieres reproducibilidad, pasa un random_state con un número fijo.
from scipy.stats import poisson
data_poisson = poisson.rvs(mu=3, size=10000)
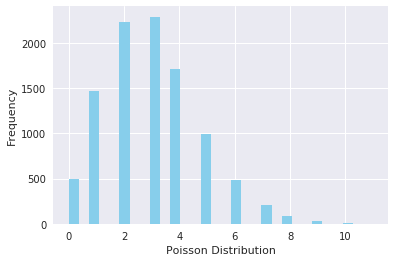
Puedes visualizar la distribución igual que con la uniforme, usando distplot de Seaborn. El significado de los argumentos es el mismo.
ax = sns.distplot(data_poisson,
                  bins=30,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
Una distribución en la que solo hay dos resultados posibles, como éxito o fracaso, ganar o perder, y donde la probabilidad de éxito y fracaso es la misma para todos los ensayos, se llama distribución binomial. Sin embargo, los resultados no tienen por qué ser equiprobables, y cada ensayo es independiente. Los parámetros de una binomial son $n$ y $p$, donde $n$ es el número total de ensayos y $p$ la probabilidad de éxito en cada uno. Su función de probabilidad es:
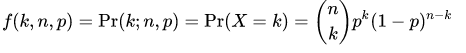
donde:
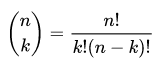
Puedes generar una variable aleatoria discreta binomial con el método binom.rvs() del módulo scipy.stats, que recibe $n$ (número de ensayos) y $p$ (probabilidad de éxito) como parámetros de forma. Para desplazar la distribución usa loc. size indica cuántas veces repetir los ensayos. Si quieres reproducibilidad, pasa un random_state con un número fijo.
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
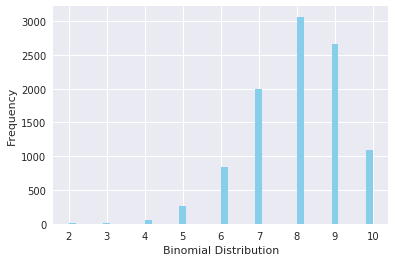
Al visualizar la distribución con distplot de Seaborn, obtendrás el siguiente histograma:
ax = sns.distplot(data_binom, kde=False, color='skyblue', hist_kws={"linewidth": 15,'alpha':1}) ax.set(xlabel='Binomial Distribution', ylabel='Frequency')[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]Nota: como la probabilidad de éxito era mayor que $0.5$, la distribución se sesga hacia la derecha. Además, la distribución de Poisson es un caso límite de la binomial bajo las siguientes condiciones:
- El número de ensayos es indefinidamente grande, $n → ∞$.
- La probabilidad de éxito en cada ensayo es la misma y tiende a ser muy pequeña, $p →0$.
- $np = λ$ es finito.
La normal es otra forma límite de la binomial bajo estas condiciones:
- El número de ensayos es indefinidamente grande, $n → ∞$.
- Ni $p$ ni $q$ son extremadamente pequeños.
Función de distribución de Bernoulli
Una distribución de Bernoulli solo tiene dos posibles resultados, $1$ (éxito) y $0$ (fracaso), y un único ensayo; por ejemplo, lanzar una moneda. Así, la variable aleatoria $X$ con distribución de Bernoulli puede tomar el valor $1$ con probabilidad de éxito $p$, y el valor $0$ con probabilidad de fracaso $q$ o $1-p$. Las probabilidades de éxito y fracaso no tienen por qué ser iguales. La de Bernoulli es un caso particular de la binomial donde se realiza un único ensayo ($n=1$). Su función de masa de probabilidad es:
Distribución de Bernoulli en Python
Puedes generar una variable aleatoria discreta de Bernoulli con el método
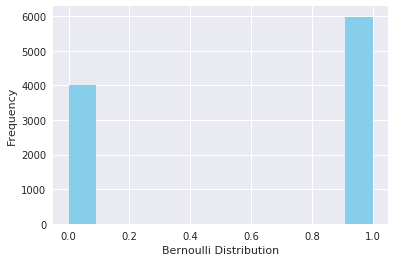
bernoulli.rvs()del móduloscipy.stats, que recibe $p$ (probabilidad de éxito) como parámetro de forma. Para desplazar la distribución usaloc.sizeindica cuántas veces repetir los ensayos. Si quieres reproducibilidad, pasa unrandom_statecon un número fijo.from scipy.stats import bernoulli data_bern = bernoulli.rvs(size=10000,p=0.6)Al visualizar la distribución, observarás que solo hay dos resultados posibles:
ax= sns.distplot(data_bern, kde=False, color="skyblue", hist_kws={"linewidth": 15,'alpha':1}) ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]Conclusión
¡Enhorabuena, has llegado al final del tutorial! Aquí has visto algunas distribuciones de probabilidad habituales y has aprendido a crearlas y representarlas en Python. Aunque hay muchas más por explorar, esto es suficiente para empezar. No olvides echar un vistazo a la librería
scipyde Python, que incluye otras funcionalidades estadísticas muy útiles. ¡A explorar!Si quieres aprender más sobre probabilidad en Python, haz el curso Statistical Simulation in Python de DataCamp.
Consulta también nuestro tutorial Poker Probability and Statistics with Python.
Referencias
Cursos de Python
Curso
Curso
Curso
Tutorial
DataCamp Team
13 min
Tutorial
Karlijn Willems
14 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Avinash Navlani
12 min
Tutorial
Moez Ali
14 min
Tutorial
Duong Vu
11 min