Dasar-Dasar Probabilitas di Python
BasicSkill Level
5 jam
16.3K learners
Jalankan dan edit kode dari Tutorial ini secara online
Jalankan kodeMungkin salah satu distribusi yang paling sederhana dan berguna adalah distribusi seragam. Fungsi distribusi probabilitas dari distribusi seragam kontinu adalah:
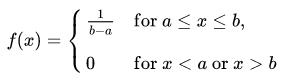
Karena setiap interval bilangan dengan lebar yang sama memiliki probabilitas yang sama untuk diamati, kurva yang menggambarkan distribusi berbentuk persegi panjang, dengan tinggi konstan di sepanjang interval dan tinggi 0 di tempat lain. Karena luas di bawah kurva harus sama dengan 1, panjang interval menentukan tinggi kurva. Gambar berikut menunjukkan distribusi seragam pada interval (a,b). Perhatikan karena luasnya harus $1$. Tingginya ditetapkan sebesar $1/(b-a)$.
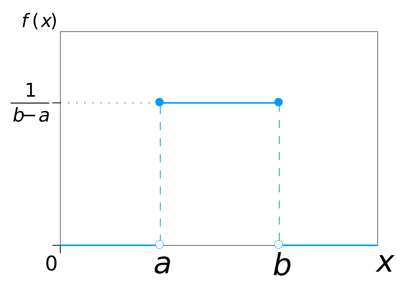
Anda dapat memvisualisasikan distribusi seragam di Python dengan bantuan generator angka acak yang bekerja pada suatu interval bilangan (a,b). Anda perlu mengimpor fungsi uniform dari modul scipy.stats.
# import uniform distribution
from scipy.stats import uniform
Fungsi uniform menghasilkan peubah kontinu seragam di antara interval yang ditentukan melalui argumen loc dan scale. Distribusi ini konstan antara loc dan loc + scale. Argumen size menyatakan jumlah variat acak. Jika Anda ingin menjaga reprodusibilitas, sertakan argumen random_state yang diisi dengan sebuah angka.
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
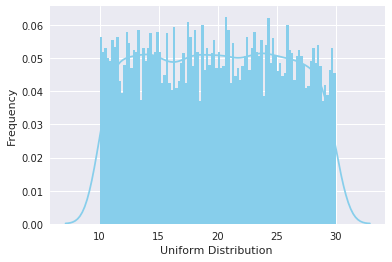
Anda dapat menggunakan distplot dari Seaborn untuk memplot histogram dari distribusi yang baru Anda buat. distplot Seaborn menerima banyak argumen untuk menyesuaikan plot. Pertama, Anda membuat objek plot ax. Di sini, Anda dapat menentukan jumlah bins pada histogram, menentukan color histogram, serta opsi plot kerapatan dengan kde dan opsi lebar garis dengan hist_kws. Anda juga dapat mengatur label sumbu x dan y menggunakan argumen xlabel dan ylabel.
ax = sns.distplot(data_uniform,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
Distribusi Normal, juga dikenal sebagai distribusi Gaussian, sangat umum dalam Data Science. Anda akan menemuinya di banyak tempat terutama dalam topik inferensi statistik. Ini juga menjadi salah satu asumsi dari banyak algoritma data science.
Distribusi normal memiliki kurva kerapatan berbentuk lonceng yang dideskripsikan oleh mean $μ$ dan simpangan baku $σ$. Kurva kerapatan bersifat simetris, berpusat pada meannya, dengan sebaran yang ditentukan oleh simpangan bakunya, menunjukkan bahwa data di dekat mean lebih sering muncul dibanding data yang jauh dari mean. Fungsi distribusi probabilitas dari kurva kerapatan normal dengan mean $μ$ dan simpangan baku $σ$ pada titik $x$ tertentu diberikan oleh:
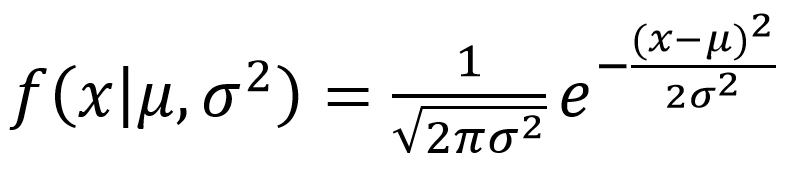
Di bawah ini adalah gambar yang menggambarkan seperti apa distribusinya:
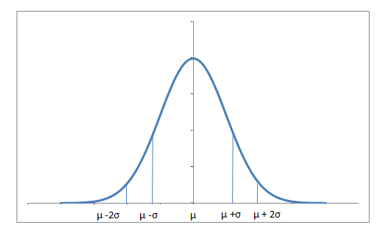
Hampir 68% data berada dalam jarak satu simpangan baku dari mean di kedua sisi dan 95% dalam dua simpangan baku. Perlu juga disebutkan bahwa distribusi dengan mean $0$ dan simpangan baku $1$ disebut distribusi normal baku.
Anda dapat menghasilkan peubah acak berdistribusi normal menggunakan metode norm.rvs() dari modul scipy.stats. Argumen loc berkaitan dengan mean distribusi. scale berkaitan dengan simpangan baku dan size dengan jumlah variat acak. Jika Anda ingin menjaga reprodusibilitas, sertakan argumen random_state yang diisi dengan sebuah angka.
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
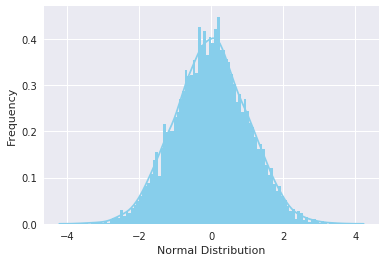
Anda dapat memvisualisasikan distribusi seperti yang Anda lakukan pada distribusi seragam, menggunakan fungsi distplot dari seaborn. Makna argumennya sama seperti pada kasus sebelumnya.
ax = sns.distplot(data_normal,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
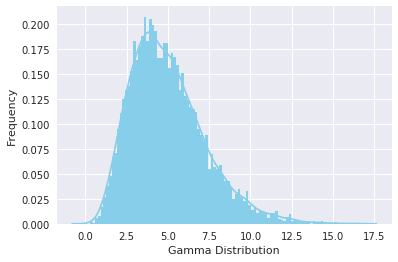
Distribusi gamma adalah keluarga dua-parameter dari distribusi probabilitas kontinu. Meskipun jarang digunakan dalam bentuk mentahnya, distribusi lain yang populer seperti eksponensial, chi-kuadrat, erlang merupakan kasus khusus dari distribusi gamma. Distribusi gamma dapat diparameterkan dalam bentuk parameter bentuk $α = k$ dan parameter skala invers $β = 1/θ$, yang disebut parameter laju. Simbol $Γ(n)$ adalah fungsi gamma dan didefinisikan sebagai $(n-1)!$ :
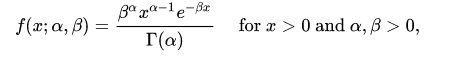
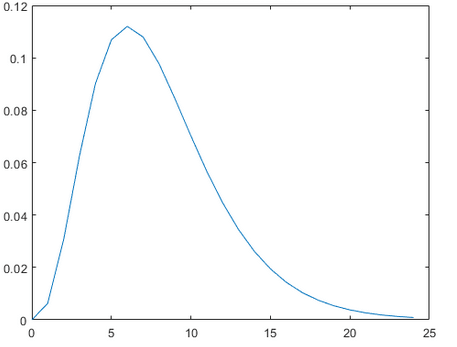
Distribusi gamma tipikal terlihat seperti:
Anda dapat menghasilkan peubah acak berdistribusi gamma menggunakan metode gamma.rvs() dari modul scipy.stats yang menerima parameter bentuk $a$ sebagai argumennya. Ketika $a$ adalah bilangan bulat, gamma tereduksi menjadi distribusi Erlang, dan ketika $a=1$ menjadi distribusi eksponensial. Untuk menggeser distribusi gunakan argumen loc, untuk penskalaan gunakan argumen scale, size menentukan jumlah variat acak dalam distribusi. Jika Anda ingin menjaga reprodusibilitas, sertakan argumen random_state yang diisi dengan sebuah angka.
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
Anda dapat memvisualisasikan distribusi seperti yang Anda lakukan pada distribusi seragam, menggunakan fungsi distplot dari seaborn. Makna argumennya tetap sama seperti dijelaskan pada bagian distribusi seragam.
ax = sns.distplot(data_gamma,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
Distribusi eksponensial menggambarkan waktu antar kejadian dalam suatu proses titik Poisson, yaitu proses di mana kejadian terjadi secara kontinu dan independen pada laju rata-rata konstan. Distribusi ini memiliki parameter $λ$ yang disebut parameter laju, dan persamaannya dideskripsikan sebagai:
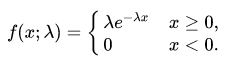
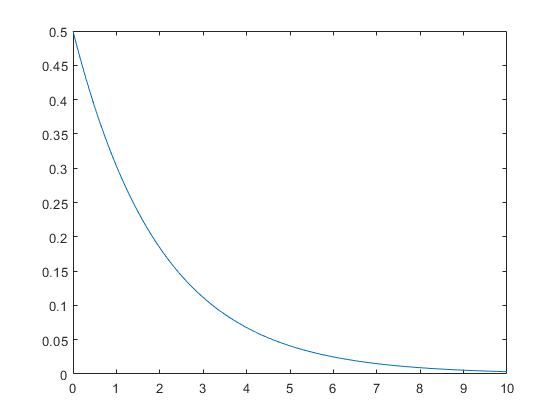
Distribusi eksponensial yang menurun terlihat seperti:
Anda dapat menghasilkan peubah acak berdistribusi eksponensial menggunakan metode expon.rvs() dari modul scipy.stats yang menerima parameter bentuk scale sebagai argumennya yang tidak lain adalah 1/lambda pada persamaan. Untuk menggeser distribusi gunakan argumen loc, size menentukan jumlah variat acak dalam distribusi. Jika Anda ingin menjaga reprodusibilitas, sertakan argumen random_state yang diisi dengan sebuah angka.
from scipy.stats import expon
data_expon = expon.rvs(scale=1,loc=0,size=1000)
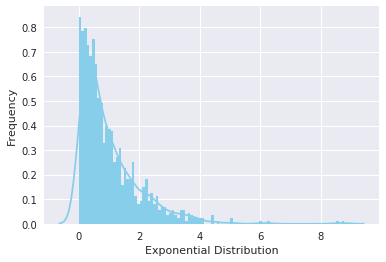
Kembali memvisualisasikan distribusi dengan seaborn menghasilkan kurva seperti di bawah ini:
ax = sns.distplot(data_expon,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
Peubah acak Poisson biasanya digunakan untuk memodelkan jumlah kejadian yang terjadi dalam suatu interval waktu. Misalnya, jumlah pengguna yang mengunjungi sebuah situs web dalam suatu interval dapat dipandang sebagai proses Poisson. Distribusi Poisson dideskripsikan dalam hal laju ($μ$) terjadinya peristiwa. Suatu peristiwa dapat terjadi 0, 1, 2, … kali dalam suatu interval. Rata-rata jumlah peristiwa dalam suatu interval dinyatakan sebagai $λ$ (lambda). Lambda adalah laju kejadian, juga disebut parameter laju. Probabilitas mengamati $k$ kejadian dalam sebuah interval diberikan oleh persamaan:
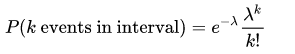
Catatan bahwa distribusi normal adalah bentuk batas dari distribusi Poisson dengan parameter $λ →∞$. Juga, jika waktu antar kejadian acak mengikuti distribusi eksponensial dengan laju $λ$, maka jumlah total kejadian dalam periode waktu sepanjang $t$ mengikuti distribusi Poisson dengan parameter $λt$.
Gambar berikut menunjukkan distribusi Poisson yang khas:
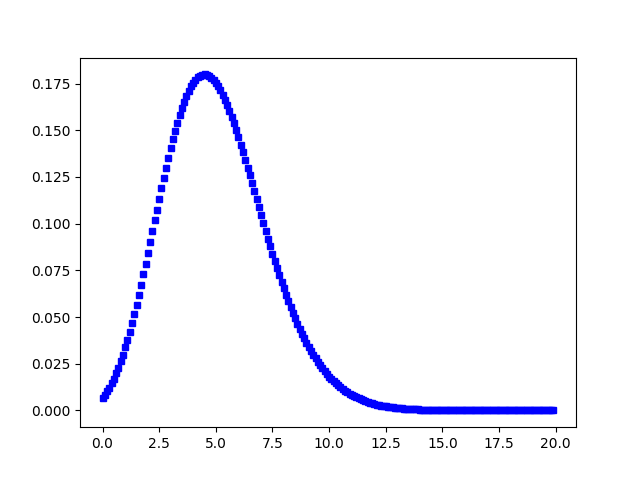
Anda dapat menghasilkan peubah acak diskret berdistribusi Poisson menggunakan metode poisson.rvs() dari modul scipy.stats yang menerima $μ$ sebagai parameter bentuk dan tidak lain adalah $λ$ pada persamaan. Untuk menggeser distribusi gunakan parameter loc. size menentukan jumlah variat acak dalam distribusi. Jika Anda ingin menjaga reprodusibilitas, sertakan argumen random_state yang diisi dengan sebuah angka.
from scipy.stats import poisson
data_poisson = poisson.rvs(mu=3, size=10000)
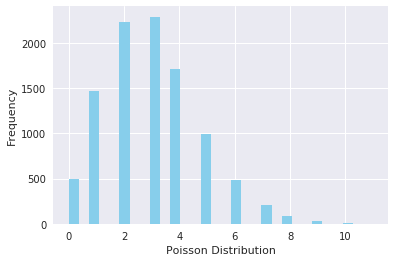
Anda dapat memvisualisasikan distribusi seperti yang Anda lakukan pada distribusi seragam, menggunakan fungsi distplot dari seaborn. Makna argumennya tetap sama.
ax = sns.distplot(data_poisson,
                  bins=30,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
Distribusi di mana hanya ada dua keluaran yang mungkin, seperti sukses atau gagal, untung atau rugi, menang atau kalah dan di mana probabilitas sukses dan gagal sama untuk semua percobaan disebut Distribusi Binomial. Namun, keluaran tidak harus sama kemungkinannya, dan setiap percobaan saling independen. Parameter distribusi binomial adalah $n$ dan $p$ di mana $n$ adalah jumlah total percobaan, dan $p$ adalah probabilitas sukses pada setiap percobaan. Fungsi distribusi probabilitasnya diberikan oleh:
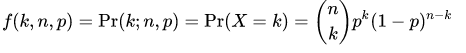
di mana:
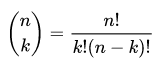
Anda dapat menghasilkan peubah acak diskret berdistribusi binomial menggunakan metode binom.rvs() dari modul scipy.stats yang menerima $n$ (jumlah percobaan) dan $p$ (probabilitas sukses) sebagai parameter bentuk. Untuk menggeser distribusi gunakan parameter loc. size menentukan berapa kali mengulangi percobaan. Jika Anda ingin menjaga reprodusibilitas, sertakan argumen random_state yang diisi dengan sebuah angka.
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
Memvisualisasikan distribusi yang baru Anda buat menggunakan distplot dari seaborn menghasilkan histogram berikut:
ax = sns.distplot(data_binom,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Binomial Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]
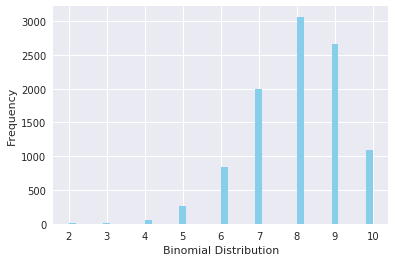
Catatan bahwa karena probabilitas sukses lebih besar dari $0.5$ distribusi menjadi miring ke sisi kanan. Selain itu, distribusi Poisson adalah bentuk batas dari distribusi binomial dengan syarat-syarat berikut:
Distribusi normal adalah bentuk batas lain dari distribusi binomial dengan syarat-syarat berikut:
Distribusi Bernoulli hanya memiliki dua kemungkinan keluaran, yaitu $1$ (sukses) dan $0$ (gagal), dan satu percobaan, misalnya lempar koin. Jadi peubah acak $X$ yang memiliki distribusi Bernoulli dapat bernilai $1$ dengan probabilitas sukses, $p$, dan bernilai $0$ dengan probabilitas gagal, $q$ atau $1-p$. Probabilitas sukses dan gagal tidak harus sama kemungkinannya. Distribusi Bernoulli adalah kasus khusus dari distribusi binomial di mana hanya dilakukan satu percobaan ($n=1$). Fungsi massa probabilitasnya diberikan oleh:
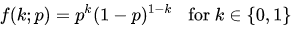
Anda dapat menghasilkan peubah acak diskret berdistribusi Bernoulli menggunakan metode bernoulli.rvs() dari modul scipy.stats yang menerima $p$ (probabilitas sukses) sebagai parameter bentuk. Untuk menggeser distribusi gunakan parameter loc. size menentukan berapa kali mengulangi percobaan. Jika Anda ingin menjaga reprodusibilitas, sertakan argumen random_state yang diisi dengan sebuah angka.
from scipy.stats import bernoulli
data_bern = bernoulli.rvs(size=10000,p=0.6)
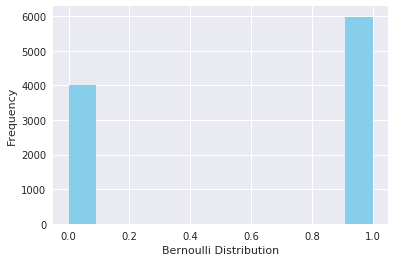
Kembali memvisualisasikan distribusi, Anda dapat mengamati bahwa hanya ada dua keluaran yang mungkin:
ax= sns.distplot(data_bern,
                 kde=False,
                 color="skyblue",
                 hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]
Selamat, Anda telah sampai di akhir tutorial ini! Dalam tutorial ini, Anda menelusuri beberapa distribusi probabilitas yang umum digunakan dan belajar membuat serta memplotnya di Python. Meskipun masih banyak distribusi lain untuk dieksplorasi, ini sudah cukup untuk memulai. Jangan lupa untuk mengecek pustaka scipy di Python yang memiliki berbagai fungsi statistik menarik lainnya. Selamat mengeksplorasi!
Jika Anda ingin mempelajari lebih lanjut tentang probabilitas di Python, ikuti kursus Statistical Simulation in Python dari DataCamp.
Lihat juga tutorial kami Poker Probability and Statistics with Python.
Kursus Python
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



