Basis van kansrekening in Python
BasicSkill Level
{hours} uur
16.6K learners
Voer de code van deze tutorial online uit en bewerk deze
Code uitvoerenEen van de eenvoudigste en nuttigste verdelingen is misschien wel de uniforme verdeling. De kansdichtheidsfunctie van de continue uniforme verdeling is:
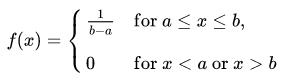
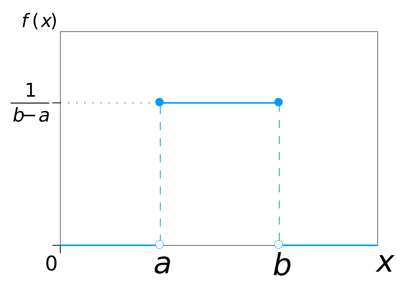
Omdat elk interval met gelijke breedte een gelijke kans heeft om geobserveerd te worden, is de kromme die de verdeling beschrijft een rechthoek, met constante hoogte over het interval en hoogte 0 daarbuiten. Omdat de oppervlakte onder de kromme gelijk moet zijn aan 1, bepaalt de lengte van het interval de hoogte van de kromme. De volgende figuur toont een uniforme verdeling op het interval (a,b). Merk op dat de oppervlakte $1$ moet zijn. De hoogte is daarom $1/(b-a)$.
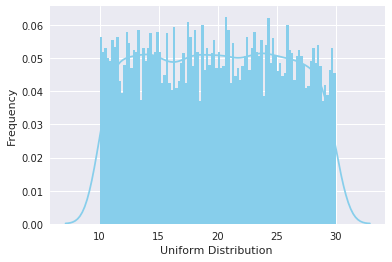
Je kunt een uniforme verdeling in Python visualiseren met behulp van een generator van willekeurige getallen over een interval (a,b). Je moet de functie uniform importeren uit de module scipy.stats.
# import uniform distribution
from scipy.stats import uniform
De functie uniform genereert een continue uniforme variabele tussen het opgegeven interval via de argumenten loc en scale. Deze verdeling is constant tussen loc en loc + scale. Het argument size geeft het aantal willekeurige variaten aan. Als je reproduceerbaarheid wilt behouden, voeg dan een argument random_state toe met een getal.
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
Je kunt Seaborns distplot gebruiken om het histogram van de zojuist gemaakte verdeling te plotten. Seaborns distplot accepteert meerdere argumenten om de plot aan te passen. Je maakt eerst een plotobject ax. Hier kun je het aantal bins in het histogram opgeven, de color van het histogram aangeven en de dichtheidsplot met kde en de lijndikte met hist_kws instellen. Je kunt ook labels voor de x- en y-as instellen met de argumenten xlabel en ylabel.
ax = sns.distplot(data_uniform,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
De normale verdeling, ook wel Gaussverdeling, is alomtegenwoordig in data science. Je komt haar op veel plekken tegen, vooral bij statistische inferentie. Het is ook een aanname van veel data-sciencealgoritmen.
Een normale verdeling heeft een klokvormige dichtheidskromme die wordt beschreven door het gemiddelde $μ$ en de standaardafwijking $σ$. De dichtheidskromme is symmetrisch en gecentreerd rond het gemiddelde, met de spreiding bepaald door de standaardafwijking: data dicht bij het gemiddelde komen vaker voor dan data ver daarvandaan. De kansdichtheidsfunctie van een normale kromme met gemiddelde $μ$ en standaardafwijking $σ$ op een gegeven punt $x$ is gegeven door:
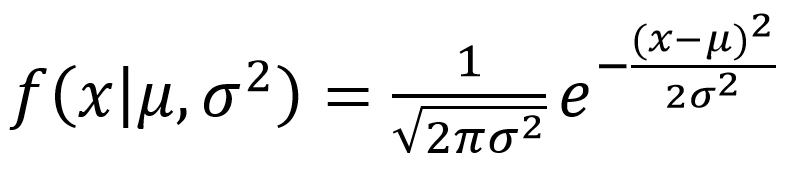
Hieronder zie je hoe de verdeling eruitziet:
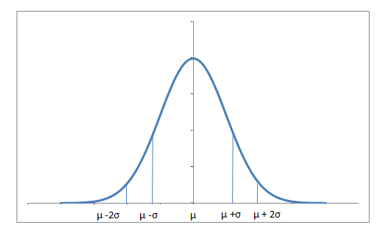
Ongeveer 68% van de data valt binnen één standaardafwijking van het gemiddelde aan beide kanten en 95% binnen twee standaardafwijkingen. Het is ook vermeldenswaard dat een verdeling met gemiddelde $0$ en standaardafwijking $1$ een standaardnormale verdeling wordt genoemd.
Je kunt een normaal verdeelde toevalsvariabele genereren met de methode norm.rvs() uit de module scipy.stats. Het argument loc komt overeen met het gemiddelde van de verdeling. scale komt overeen met de standaardafwijking en size met het aantal willekeurige variaten. Als je reproduceerbaarheid wilt behouden, voeg dan een argument random_state toe met een getal.
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
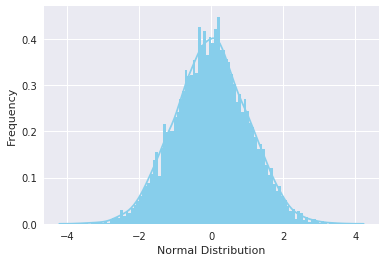
Je kunt de verdeling visualiseren zoals je bij de uniforme verdeling deed, met de functie distplot van Seaborn. De betekenis van de argumenten blijft hetzelfde als in het vorige geval.
ax = sns.distplot(data_normal,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
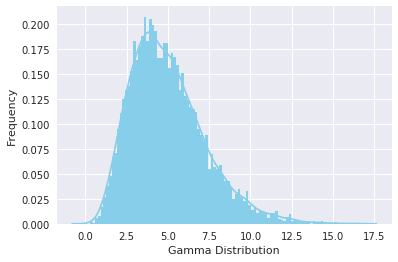
De gammaverdeling is een twee-parameterfamilie van continue kansverdelingen. Hoewel ze zelden in ruwe vorm wordt gebruikt, zijn andere veelgebruikte verdelingen zoals de exponentiële, chi-kwadraat- en Erlangverdeling speciale gevallen van de gammaverdeling. De gammaverdeling kan worden geparametriseerd in termen van een vormparameter $α = k$ en een inverse schaalparameter $β = 1/θ$, ook wel de snelheid (rate) genoemd. Het symbool $Γ(n)$ is de gammafunctie en is gedefinieerd als $(n-1)!$ :
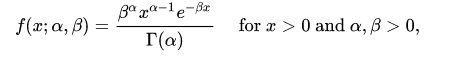
Een typische gammaverdeling ziet er als volgt uit:
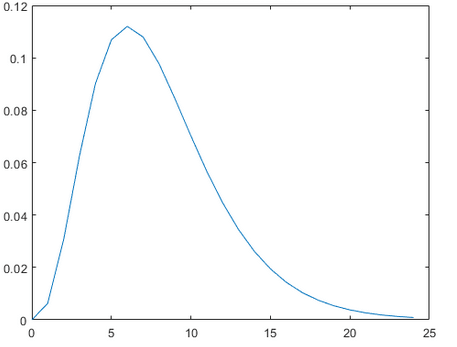
Je kunt een gamma-verdeelde toevalsvariabele genereren met de methode gamma.rvs() uit de module scipy.stats, die de vormparameter $a$ als argument neemt. Als $a$ een geheel getal is, reduceert de gamma tot de Erlangverdeling, en als $a=1$ tot de exponentiële verdeling. Gebruik het argument loc om de verdeling te verschuiven, scale om te schalen, en size voor het aantal variaten. Als je reproduceerbaarheid wilt behouden, voeg dan een argument random_state toe met een getal.
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
Je kunt de verdeling visualiseren zoals bij de uniforme verdeling, met Seaborns distplot-functie. De betekenis van de argumenten blijft hetzelfde als uitgelegd bij de uniforme verdeling.
ax = sns.distplot(data_gamma,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
De exponentiële verdeling beschrijft de tijd tussen gebeurtenissen in een Poissonpuntproces, d.w.z. een proces waarin gebeurtenissen continu en onafhankelijk plaatsvinden met een constante gemiddelde snelheid. Ze heeft een parameter $λ$, de snelheid (rate), en de vergelijking is als volgt beschreven:
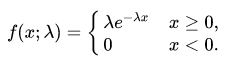
Een dalende exponentiële verdeling ziet er als volgt uit:
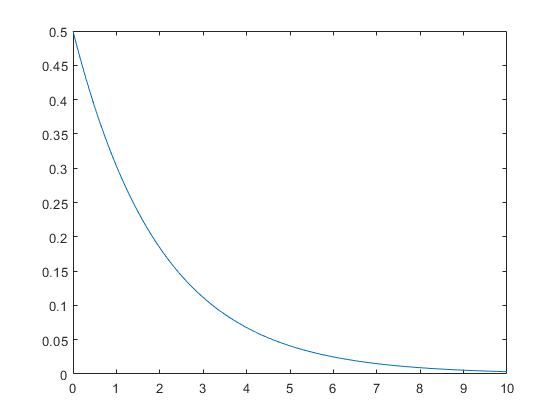
Je kunt een exponentieel verdeelde toevalsvariabele genereren met de methode expon.rvs() uit de module scipy.stats, die de parameter scale als argument neemt, wat in de vergelijking gelijk is aan 1/lambda. Gebruik het argument loc om de verdeling te verschuiven; size bepaalt het aantal variaten. Als je reproduceerbaarheid wilt behouden, voeg dan een argument random_state toe met een getal.
from scipy.stats import expon
data_expon = expon.rvs(scale=1,loc=0,size=1000)
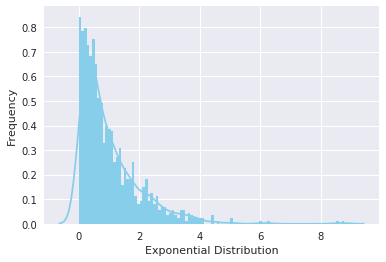
Ook hier levert visualiseren met Seaborn de onderstaande kromme op:
ax = sns.distplot(data_expon,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
Een Poisson-toevalsvariabele wordt meestal gebruikt om het aantal keren te modelleren dat een gebeurtenis voorkomt in een tijdsinterval. Het aantal gebruikers dat in een bepaald interval een website bezoekt kun je bijvoorbeeld zien als een Poissonproces. De Poissonverdeling wordt beschreven in termen van de snelheid ($μ$) waarmee gebeurtenissen plaatsvinden. Een gebeurtenis kan 0, 1, 2, … keer in een interval optreden. Het gemiddelde aantal gebeurtenissen in een interval wordt aangeduid met $λ$ (lambda). Lambda is de eventsnelheid, ook wel de rate-parameter genoemd. De kans om $k$ gebeurtenissen in een interval te observeren is gegeven door de vergelijking:
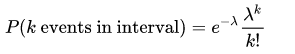
Let op dat de normale verdeling een grensgeval is van de Poissonverdeling met parameter $λ →∞$. Ook geldt: als de tijden tussen willekeurige gebeurtenissen een exponentiële verdeling met parameter $λ$ volgen, dan volgt het totale aantal gebeurtenissen in een periode van lengte $t$ een Poissonverdeling met parameter $λt$.
De volgende figuur toont een typische Poissonverdeling:
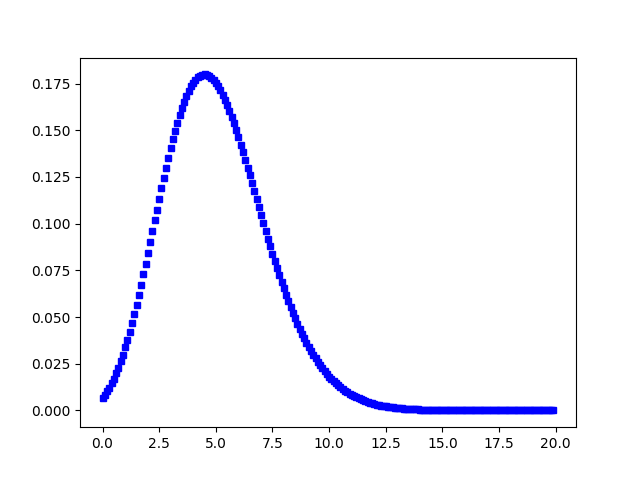
Je kunt een Poisson-verdeelde discrete toevalsvariabele genereren met de methode poisson.rvs() uit de module scipy.stats, die $μ$ als vormparameter neemt en dat is hetzelfde als $λ$ in de vergelijking. Gebruik de parameter loc om de verdeling te verschuiven. size bepaalt het aantal variaten. Als je reproduceerbaarheid wilt behouden, voeg dan een argument random_state toe met een getal.
from scipy.stats import poisson
data_poisson = poisson.rvs(mu=3, size=10000)
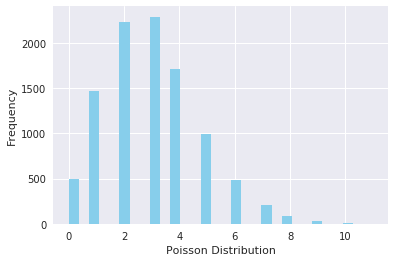
Je kunt de verdeling visualiseren zoals bij de uniforme verdeling, met Seaborns distplot-functie. De betekenis van de argumenten blijft hetzelfde.
ax = sns.distplot(data_poisson,
                  bins=30,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
Een verdeling waarbij slechts twee uitkomsten mogelijk zijn, zoals succes of mislukking, winst of verlies, winnen of verliezen, en waarbij de kans op succes en mislukking voor alle pogingen hetzelfde is, heet een binomiale verdeling. De uitkomsten hoeven echter niet even waarschijnlijk te zijn en elke proef is onafhankelijk van de andere. De parameters van een binomiale verdeling zijn $n$ en $p$, waarbij $n$ het totale aantal proeven is en $p$ de kans op succes per proef. De kansfunctie is gegeven door:
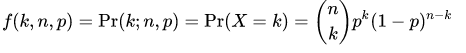
waarbij:
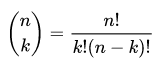
Je kunt een binomiaal verdeelde discrete toevalsvariabele genereren met de methode binom.rvs() uit de module scipy.stats, die $n$ (aantal proeven) en $p$ (kans op succes) als vormparameters neemt. Gebruik de parameter loc om de verdeling te verschuiven. size bepaalt hoe vaak de proeven worden herhaald. Als je reproduceerbaarheid wilt behouden, voeg dan een argument random_state toe met een getal.
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
Visualisatie van de zojuist gemaakte verdeling met Seaborns distplot levert het volgende histogram op:
ax = sns.distplot(data_binom,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Binomial Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]
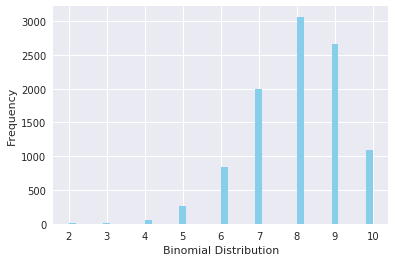
Let op dat, omdat de kans op succes groter was dan $0.5$, de verdeling naar rechts scheef is. De Poissonverdeling is ook een grensgeval van een binomiale verdeling onder de volgende voorwaarden:
De normale verdeling is een ander limietgeval van de binomiale verdeling onder de volgende voorwaarden:
Een Bernoulliverdeling heeft slechts twee mogelijke uitkomsten, namelijk $1$ (succes) en $0$ (mislukking), en één enkele proef, bijvoorbeeld een muntworp. De toevalsvariabele $X$ met een Bernoulliverdeling kan dus de waarde $1$ aannemen met de succeskans $p$, en de waarde $0$ met de kans op mislukking $q$ ofwel $1-p$. De kansen op succes en mislukking hoeven niet even groot te zijn. De Bernoulliverdeling is een speciaal geval van de binomiale verdeling waarbij één enkele proef wordt uitgevoerd ($n=1$). De kansmassa-functie is gegeven door:
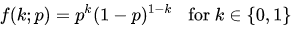
Je kunt een Bernoulli-verdeelde discrete toevalsvariabele genereren met de methode bernoulli.rvs() uit de module scipy.stats, die $p$ (kans op succes) als vormparameter neemt. Gebruik de parameter loc om de verdeling te verschuiven. size bepaalt hoe vaak de proeven worden herhaald. Als je reproduceerbaarheid wilt behouden, voeg dan een argument random_state toe met een getal.
from scipy.stats import bernoulli
data_bern = bernoulli.rvs(size=10000,p=0.6)
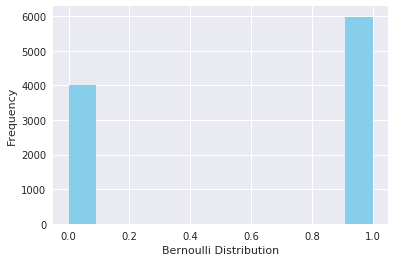
Als je de verdeling opnieuw visualiseert, zie je dat er slechts twee mogelijke uitkomsten zijn:
ax= sns.distplot(data_bern,
                 kde=False,
                 color="skyblue",
                 hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]
Gefeliciteerd, je bent aan het einde van deze tutorial gekomen! In deze tutorial heb je een aantal veelgebruikte kansverdelingen verkend en geleerd hoe je ze in Python maakt en plot. Hoewel er nog veel andere verdelingen zijn om te onderzoeken, is dit voldoende om te beginnen. Vergeet niet de Python-bibliotheek scipy te bekijken, die nog meer handige statistische functionaliteit bevat. Veel plezier met ontdekken!
Wil je meer leren over kansrekening in Python? Volg dan de cursus Statistical Simulation in Python van DataCamp.
Bekijk ook onze tutorial Poker Probability and Statistics with Python.
Python-cursussen
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

