Nền tảng Xác suất trong Python
BasicSkill Level
5 giờ
16.7K learners
Chạy và chỉnh sửa mã từ hướng dẫn trực tuyến này
Chạy mãCó lẽ một trong những phân phối đơn giản và hữu ích nhất là phân phối đều. Hàm phân phối xác suất của phân phối đều liên tục là:
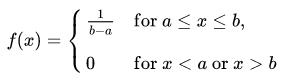
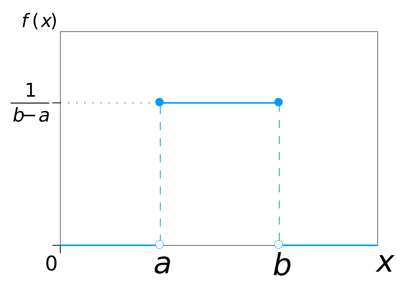
Vì mọi khoảng số có bề rộng bằng nhau đều có xác suất được quan sát bằng nhau, đường cong mô tả phân phối là một hình chữ nhật, có chiều cao không đổi trên khoảng và bằng 0 ở nơi khác. Do diện tích dưới đường cong phải bằng 1, độ dài của khoảng sẽ quyết định chiều cao của đường cong. Hình sau minh họa phân phối đều trên khoảng (a,b). Lưu ý vì diện tích cần bằng $1$, nên chiều cao được đặt là $1/(b-a)$.
Bạn có thể trực quan hóa phân phối đều trong Python với sự trợ giúp của bộ tạo số ngẫu nhiên hoạt động trên một khoảng số (a,b). Bạn cần nhập hàm uniform từ mô-đun scipy.stats.
# import uniform distribution
from scipy.stats import uniform
Hàm uniform sinh biến ngẫu nhiên liên tục đều trong khoảng chỉ định thông qua các tham số loc và scale. Phân phối này là hằng giữa loc và loc + scale. Tham số size mô tả số lượng biến ngẫu nhiên. Nếu bạn muốn tái lập kết quả, hãy thêm tham số random_state gán một con số.
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
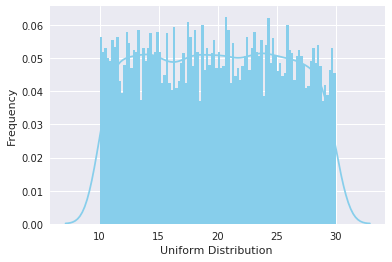
Bạn có thể dùng distplot của Seaborn để vẽ biểu đồ tần suất (histogram) của phân phối vừa tạo. distplot của Seaborn nhận nhiều tham số để tùy chỉnh biểu đồ. Trước hết bạn tạo một đối tượng biểu đồ ax. Tại đây, bạn có thể chỉ định số lượng bins trong histogram, chỉ định color cho histogram và bật tùy chọn đường mật độ với kde cùng tùy chọn độ dày nét với hist_kws. Bạn cũng có thể đặt nhãn cho trục x và y bằng các tham số xlabel và ylabel.
ax = sns.distplot(data_uniform,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
Phân phối chuẩn, còn gọi là phân phối Gauss, xuất hiện khắp nơi trong Khoa học Dữ liệu. Bạn sẽ gặp nó ở nhiều chỗ, đặc biệt trong các chủ đề về suy luận thống kê. Nó cũng là giả định của nhiều thuật toán khoa học dữ liệu.
Một phân phối chuẩn có đường cong mật độ hình chuông được mô tả bởi trung bình $μ$ và độ lệch chuẩn $σ$. Đường cong mật độ đối xứng, lấy trung bình làm tâm, độ trải rộng được quyết định bởi độ lệch chuẩn, cho thấy dữ liệu gần trung bình xuất hiện thường xuyên hơn dữ liệu xa trung bình. Hàm phân phối xác suất của đường cong mật độ chuẩn với trung bình $μ$ và độ lệch chuẩn $σ$ tại một điểm $x$ được cho bởi:
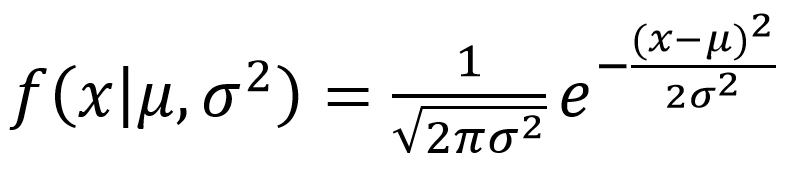
Hình dưới mô tả phân phối trông như thế nào:
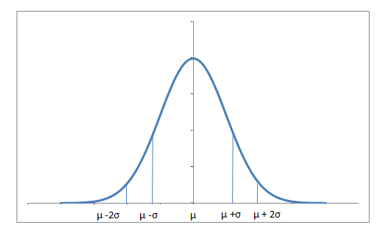
Gần 68% dữ liệu nằm trong khoảng cách một độ lệch chuẩn tính từ trung bình về hai phía và 95% trong hai độ lệch chuẩn. Cũng đáng lưu ý rằng phân phối có trung bình $0$ và độ lệch chuẩn $1$ được gọi là phân phối chuẩn tắc.
Bạn có thể sinh biến ngẫu nhiên phân phối chuẩn bằng phương thức norm.rvs() của mô-đun scipy.stats. Tham số loc tương ứng với trung bình của phân phối. scale tương ứng với độ lệch chuẩn và size là số lượng biến ngẫu nhiên. Nếu muốn tái lập kết quả, hãy thêm tham số random_state gán một con số.
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
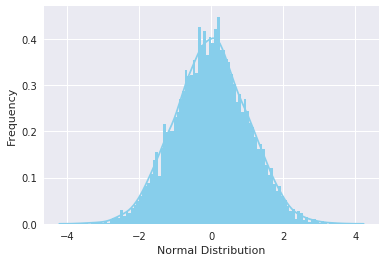
Bạn có thể trực quan hóa phân phối giống như với phân phối đều, sử dụng hàm distplot của seaborn. Ý nghĩa các tham số giữ nguyên như ở trường hợp trước.
ax = sns.distplot(data_normal,
                  bins=100,
                  kde=True,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
Phân phối gamma là một họ hai tham số của các phân phối xác suất liên tục. Dù hiếm khi được dùng ở dạng gốc, nhưng các phân phối phổ biến khác như phân phối mũ, khi bình phương, Erlang là các trường hợp đặc biệt của phân phối gamma. Phân phối gamma có thể được tham số hóa theo tham số hình dạng $α = k$ và tham số nghịch đảo tỷ lệ $β = 1/θ$, gọi là tham số tốc độ; ký hiệu $Γ(n)$ là hàm gamma và được định nghĩa là $(n-1)!$ :
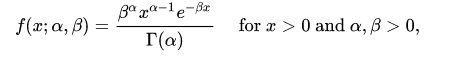
Một phân phối gamma điển hình trông như sau:
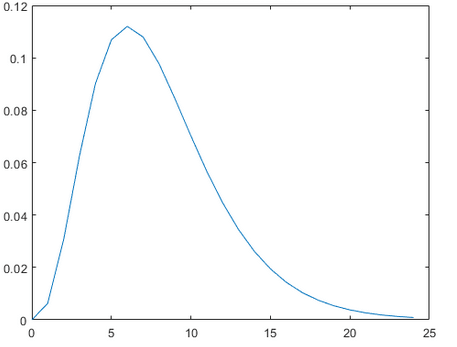
Bạn có thể sinh biến ngẫu nhiên phân phối gamma bằng phương thức gamma.rvs() của mô-đun scipy.stats, nhận tham số hình dạng $a$ làm đối số. Khi $a$ là số nguyên, gamma trở thành phân phối Erlang, và khi $a=1$ thành phân phối mũ. Để tịnh tiến phân phối dùng tham số loc, để co giãn dùng scale, size quyết định số lượng biến ngẫu nhiên. Nếu muốn tái lập kết quả, thêm tham số random_state gán một con số.
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
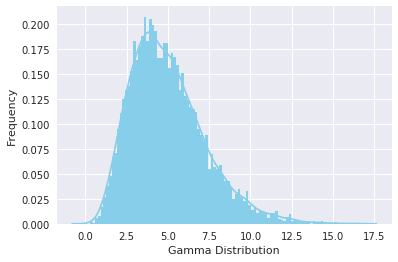
Bạn có thể trực quan hóa phân phối giống như với phân phối đều, sử dụng hàm distplot của seaborn. Ý nghĩa các tham số giống như đã giải thích ở phần phân phối đều.
ax = sns.distplot(data_gamma,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
Phân phối mũ mô tả thời gian giữa các sự kiện trong một quá trình điểm Poisson, tức một quá trình trong đó các sự kiện xảy ra liên tục và độc lập với tốc độ trung bình không đổi. Nó có tham số $λ$ gọi là tham số tốc độ, và phương trình của nó được mô tả như sau:
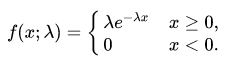
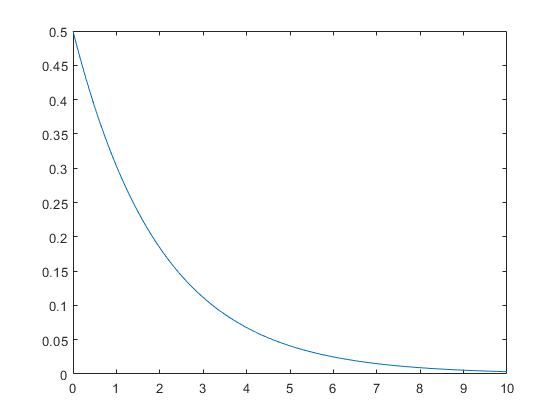
Một phân phối mũ giảm dần trông như sau:
Bạn có thể sinh biến ngẫu nhiên phân phối mũ bằng phương thức expon.rvs() của mô-đun scipy.stats, nhận tham số hình dạng scale làm đối số, vốn chính là 1/lambda trong phương trình. Để tịnh tiến phân phối dùng tham số loc, size quyết định số lượng biến ngẫu nhiên. Nếu muốn tái lập kết quả, thêm tham số random_state gán một con số.
from scipy.stats import expon
data_expon = expon.rvs(scale=1,loc=0,size=1000)
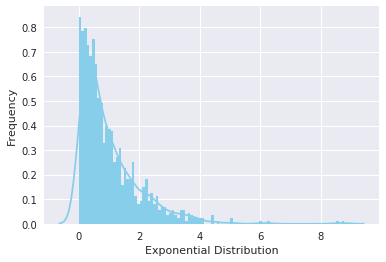
Một lần nữa, trực quan hóa phân phối với seaborn cho ra đường cong như dưới đây:
ax = sns.distplot(data_expon,
                  kde=True,
                  bins=100,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
Biến ngẫu nhiên Poisson thường được dùng để mô hình hóa số lần một sự kiện xảy ra trong một khoảng thời gian. Ví dụ, số lượng người dùng truy cập một trang web trong một khoảng có thể được coi là một quá trình Poisson. Phân phối Poisson được mô tả theo tốc độ ($μ$) mà các sự kiện xảy ra. Một sự kiện có thể xảy ra 0, 1, 2, … lần trong một khoảng. Số sự kiện trung bình trong một khoảng được ký hiệu là $λ$ (lambda). Lambda là tốc độ sự kiện, còn gọi là tham số tốc độ. Xác suất quan sát $k$ sự kiện trong một khoảng được cho bởi phương trình:
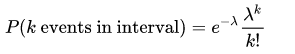
Lưu ý rằng phân phối chuẩn là trường hợp giới hạn của phân phối Poisson khi tham số $λ →∞$. Ngoài ra, nếu thời gian giữa các sự kiện ngẫu nhiên tuân theo phân phối mũ với tốc độ $λ$, thì tổng số sự kiện trong một khoảng thời gian độ dài $t$ tuân theo phân phối Poisson với tham số $λt$.
Hình dưới đây cho thấy một phân phối Poisson điển hình:
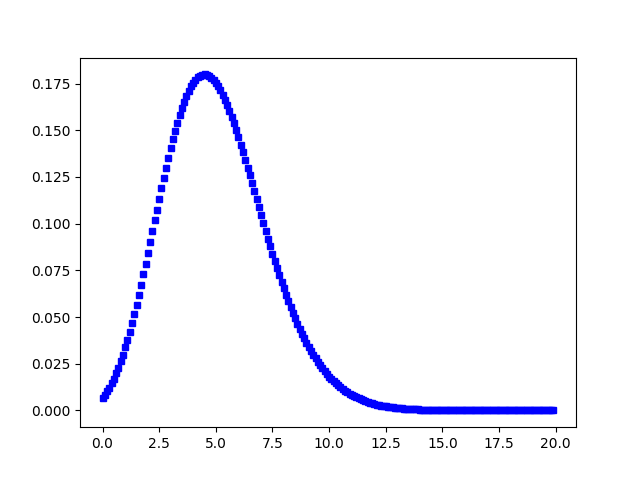
Bạn có thể sinh biến ngẫu nhiên rời rạc phân phối Poisson bằng phương thức poisson.rvs() của mô-đun scipy.stats, nhận $μ$ làm tham số hình dạng, cũng chính là $λ$ trong phương trình. Để tịnh tiến phân phối dùng tham số loc. size quyết định số lượng biến ngẫu nhiên. Nếu muốn tái lập kết quả, thêm tham số random_state gán một con số.
from scipy.stats import poisson
data_poisson = poisson.rvs(mu=3, size=10000)
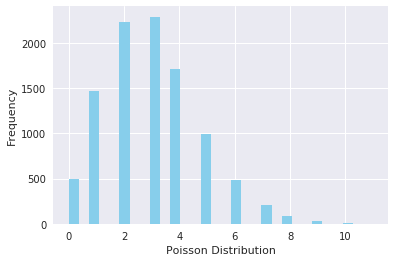
Bạn có thể trực quan hóa phân phối giống như với phân phối đều, sử dụng hàm distplot của seaborn. Ý nghĩa các tham số giữ nguyên.
ax = sns.distplot(data_poisson,
                  bins=30,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
Một phân phối mà chỉ có hai kết quả có thể, chẳng hạn thành công hoặc thất bại, lãi hoặc lỗ, thắng hoặc thua và trong đó xác suất thành công và thất bại là như nhau cho mọi phép thử, được gọi là phân phối Nhị thức. Tuy nhiên, các kết quả không nhất thiết có khả năng như nhau, và mỗi phép thử là độc lập với nhau. Các tham số của phân phối nhị thức là $n$ và $p$ trong đó $n$ là tổng số phép thử, và $p$ là xác suất thành công trong mỗi phép thử. Hàm phân phối xác suất của nó được cho bởi:
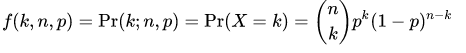
trong đó:
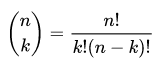
Bạn có thể sinh biến ngẫu nhiên rời rạc phân phối nhị thức bằng phương thức binom.rvs() của mô-đun scipy.stats, nhận $n$ (số phép thử) và $p$ (xác suất thành công) làm các tham số hình dạng. Để tịnh tiến phân phối dùng tham số loc. size quyết định số lần lặp các phép thử. Nếu muốn tái lập kết quả, thêm tham số random_state gán một con số.
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
Trực quan hóa phân phối vừa tạo bằng distplot của seaborn cho ra histogram sau:
ax = sns.distplot(data_binom,
                  kde=False,
                  color='skyblue',
                  hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Binomial Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]
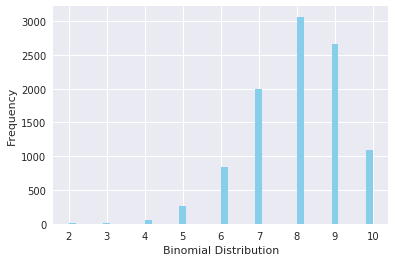
Lưu ý rằng vì xác suất thành công lớn hơn $0.5$ nên phân phối bị lệch về phía bên phải. Ngoài ra, phân phối Poisson là trường hợp giới hạn của phân phối nhị thức dưới các điều kiện sau:
Phân phối chuẩn là một dạng giới hạn khác của phân phối nhị thức dưới các điều kiện sau:
Một phân phối Bernoulli chỉ có hai kết quả có thể, cụ thể là $1$ (thành công) và $0$ (thất bại), và chỉ một phép thử, ví dụ tung đồng xu. Do đó biến ngẫu nhiên $X$ có phân phối Bernoulli có thể nhận giá trị $1$ với xác suất thành công $p$, và giá trị $0$ với xác suất thất bại $q$ hay $1-p$. Xác suất thành công và thất bại không nhất thiết như nhau. Phân phối Bernoulli là trường hợp đặc biệt của phân phối nhị thức khi chỉ thực hiện một phép thử ($n=1$). Hàm khối xác suất của nó được cho bởi:
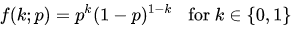
Bạn có thể sinh biến ngẫu nhiên rời rạc phân phối Bernoulli bằng phương thức bernoulli.rvs() của mô-đun scipy.stats, nhận $p$ (xác suất thành công) làm tham số hình dạng. Để tịnh tiến phân phối dùng tham số loc. size quyết định số lần lặp các phép thử. Nếu muốn tái lập kết quả, thêm tham số random_state gán một con số.
from scipy.stats import bernoulli
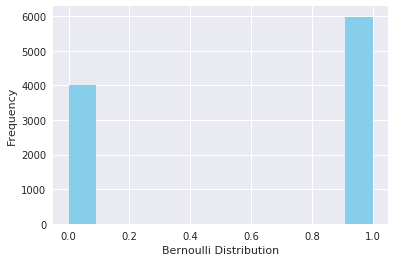
data_bern = bernoulli.rvs(size=10000,p=0.6)
Một lần nữa khi trực quan hóa phân phối, bạn có thể quan sát rằng chỉ có hai kết quả có thể:
ax= sns.distplot(data_bern,
                 kde=False,
                 color="skyblue",
                 hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]
Chúc mừng bạn đã đi đến cuối hướng dẫn! Trong hướng dẫn này, bạn đã khám phá một số phân phối xác suất thường dùng và học cách tạo, vẽ chúng trong Python. Dù còn nhiều phân phối khác để tìm hiểu, bấy nhiêu là đủ để bạn bắt đầu. Đừng quên xem thư viện scipy của Python, nơi có nhiều chức năng thống kê thú vị khác. Chúc bạn khám phá vui vẻ!
Nếu bạn muốn tìm hiểu thêm về xác suất trong Python, hãy học khóa Statistical Simulation in Python của DataCamp.
Xem thêm hướng dẫn Xác suất và Thống kê Poker với Python của chúng tôi.
Khóa học Python
Khóa học
Khóa học
Khóa học