
Program
Yapay Zeka Uygulamaları Geliştirme
21 sa
Özünde prompt caching, istemleri ve bunlara karşılık gelen yanıtları bir önbellekte saklayarak çalışır. Aynı ya da benzer bir istem tekrar gönderildiğinde, sistem yeni bir yanıt üretmek yerine önbelleğe alınmış yanıtı çağırır. Bu, tekrarlayan hesaplamayı önler, yanıt sürelerini hızlandırır ve maliyetleri düşürür.
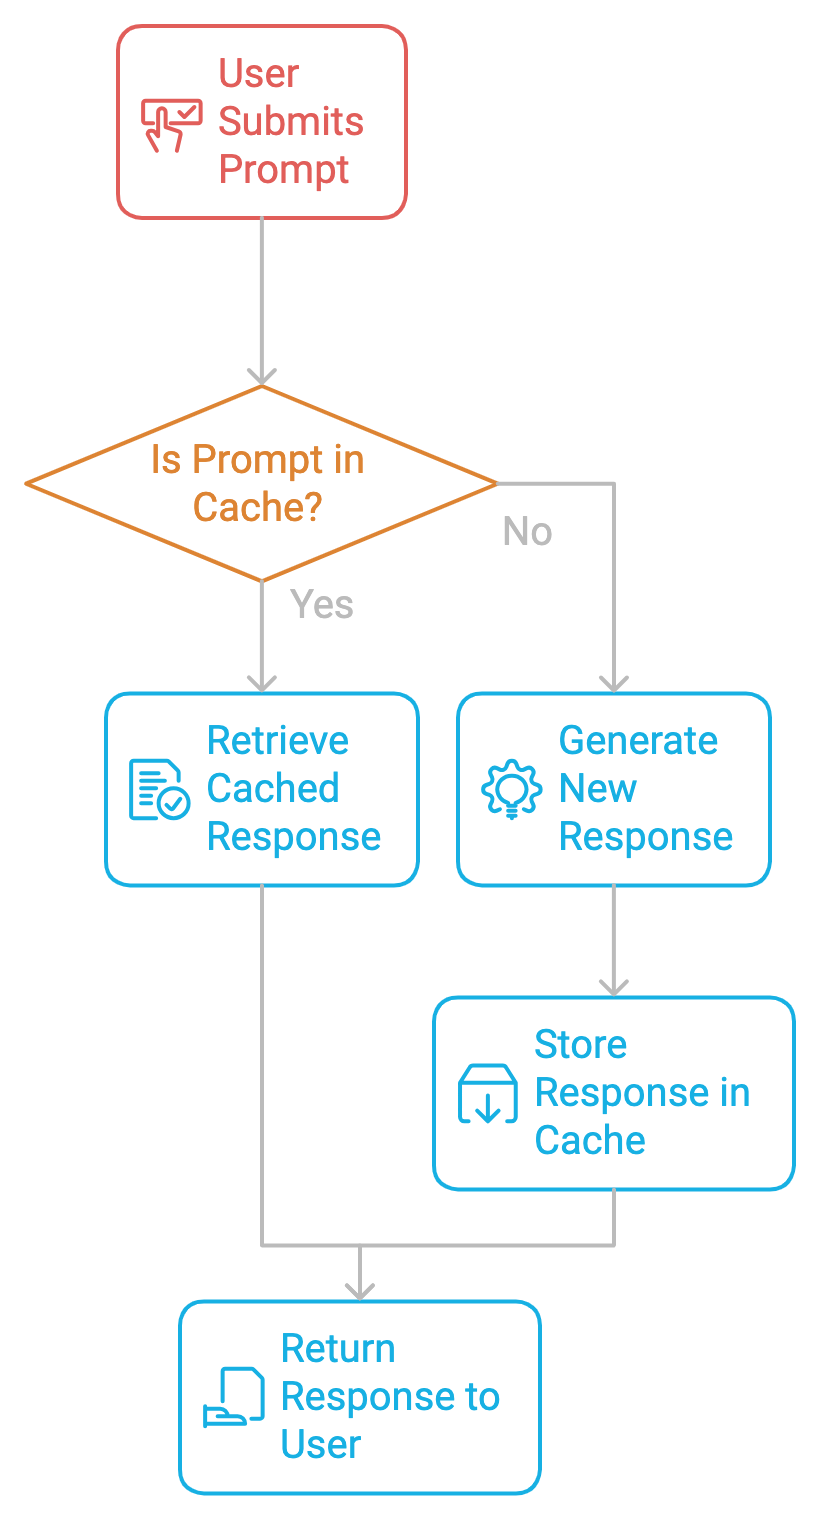
Prompt caching’in birkaç faydası vardır:
Prompt caching’i uygulamaya geçmeden önce akılda tutulması gereken bazı hususlar vardır.
Veri tazeliğini sağlamak için, önbelleğe alınan her yanıtın bellekte bir Yaşam Süresi (TTL) olmalıdır. TTL, önbellekteki bir yanıtın ne kadar süreyle geçerli kabul edileceğini belirler. TTL süresi dolduğunda, önbellek girdisi kaldırılır veya güncellenir; ilgili istem bir sonraki istekte yeniden hesaplanır.
Bu mekanizma, önbellekte eski bilginin tutulmamasını sağlar. Hukuki belgeler veya ürün kılavuzları gibi statik ya da seyrek güncellenen içerikler için daha uzun bir TTL, veri bayatlaması riski olmadan yeniden hesaplamayı azaltmaya yardımcı olabilir. Bu nedenle, TTL değerlerini doğru ayarlamak, veri tazeliği ile hesaplama verimliliği arasında denge kurmak için kritiktir.
Bazen iki istem benzerdir ancak birebir aynı değildir. Yeni bir istemin mevcut önbellektekine ne kadar yakın olduğunu belirlemek, etkili önbellekleme için kritik öneme sahiptir. İstem benzerliğini uygulamak için bulanık eşleştirme veya semantik arama gibi teknikler gerekir; sistem, istemleri vektör gömme (embedding) temsilleriyle ifade eder ve benzerliklerini karşılaştırır.
Benzer istemlere verilen yanıtları önbelleğe alarak, sistemler yeniden hesaplamayı azaltırken yüksek yanıt doğruluğunu koruyabilir. Ancak benzerlik eşiğinin çok gevşek ayarlanması eşleşme hatalarına, çok sıkı ayarlanması ise önbellekleme fırsatlarının kaçmasına yol açabilir.
En Son Kullanılanı Çıkar (LRU) gibi stratejiler, önbellek boyutunu yönetmeye yardımcı olur. LRU yöntemi, önbellek kapasitesine ulaşıldığında en az erişilen veriyi kaldırır. Bu strateji, belirli istemlerin daha popüler olduğu ve önbellekte kalması gerektiği; daha az rastlanan sorguların ise yeni istekler için yer açmak üzere kaldırılabileceği senaryolarda iyi çalışır.
Prompt caching iki aşamalı bir süreçtir.
Prompt caching uygulamasındaki ilk adım, sistemde sık tekrarlanan istemleri belirlemektir. Bir sohbet botu, kodlama asistanı veya belge işleyici inşa ediyor olalım; hangi istemlerin tekrarlandığını izlememiz gerekir. Belirlendiklerinde, bunlar gereksiz hesaplamayı önlemek için önbelleğe alınabilir.
Bir istem tanımlandıktan sonra, yanıtı TTL (yaşam süresi), önbellek isabet/kaçırma oranları gibi meta verilerle birlikte önbelleğe kaydedilir. Bir kullanıcı aynı istemi yeniden gönderdiğinde, sistem maliyetli üretim sürecini atlayarak önbellekteki yanıtı çağırır.
Tüm bu teorik bilginin ardından, yerel bir ortamda önbelleklemenin etkisini görmek için Ollama kullanarak pratik bir örneğe geçelim. Burada, web’de barındırılan bir derin öğrenme kitabından ve yerel modellerden yararlanarak kitabın ilk sayfalarını özetleyeceğiz. Llama3 dahil olmak üzere Gemma2 ve Llama2 gibi birden çok LLM ile deneyerek performanslarını karşılaştıracağız.
Bu uygulamalı örnek için, hatalı işaretleme içerenler de dahil HTML ve XML belgelerini ayrıştıran bir Python paketi olan BeautifulSoup kullanacağız. BeautifulSoup’u kurmak için şunu çalıştırın:
!pip install BeautifulSoupKullanacağımız bir diğer araç Ollama. Yerel sistemlerde büyük dil modellerinin kurulumu ve yönetimini basitleştirir.
Başlamak için Ollama’yı indirin ve bilgisayarınıza kurun. Model adını gereksinimlerimize göre değiştirebiliriz. Ollama’nın resmi sitesindeki model kütüphanesine göz atarak Ollama’nın desteklediği farklı modellere bakın. Terminalde aşağıdaki kodu çalıştırın:
ollama run llama3.1 Her şey hazır. Başlayalım!
Şu içe aktarmalarla başlıyoruz:
time önbellekli ve önbelleksiz kod için çıkarım süresini izlemekrequests web sayfalarından veri almak ve HTTP istekleri yapmakBeautifulSoup HTML içeriğini ayrıştırıp temizlemekOllama LLM’leri yerelde kullanmakimport time
import requests
from bs4 import BeautifulSoup
import ollamaAşağıdaki kodda, verilen bir URL’den metin içeriğini alan ve temizleyen fetch_article_content adlı bir fonksiyon tanımlıyoruz. Ağ hataları veya sunucu sorunları gibi başarısızlıklar durumunda en fazla üç denemeyle requests kütüphanesini kullanarak web sayfası içeriğini getirmeye çalışır.
Fonksiyon, HTML içeriğini ayrıştırmak için BeautifulSoup kullanır ve gereksiz <script> ve <style> etiketlerini kaldırır. Metin, baştaki ve sondaki boşluklar ayıklanarak satırlara bölünür ve temiz paragraflar halinde yeniden birleştirilir. Bir içerik sınırı belirtilirse, metin bu sınıra göre kırpılır. Tüm denemeler başarısız olursa, denemeler arasında kısa bir gecikmeyle istisna yükseltilir.
İşte anlaşılması gereken birkaç anahtar parametre:
BeautifulSoup kullanarak <script> ve <style> gibi gereksiz öğeleri kaldırır.def fetch_article_content(url, retries=3, content_limit=None):
attempt = 0
while attempt < retries:
try:
response = requests.get(url, timeout=30) # Add timeout to prevent hanging
response.raise_for_status() # Raise an error for bad responses (4xx, 5xx)
soup = BeautifulSoup(response.content, 'html.parser')
# Remove script and style elements
for script in soup(["script", "style"]):
script.decompose()
# Get text
text = soup.get_text()
# Break into lines and remove leading and trailing space on each
lines = (line.strip() for line in text.splitlines())
chunks = (phrase.strip() for line in lines for phrase in line.split(" "))
text = '\n'.join(chunk for chunk in chunks if chunk)
# Limit content if specified
if content_limit:
text = text[:content_limit]
return text
except (requests.exceptions.RequestException, requests.exceptions.ChunkedEncodingError) as e:
attempt += 1
print(f"Attempt {attempt} failed: {e}")
if attempt >= retries:
raise
time.sleep(2) # Wait before retryingSırada çıkarım için bir kitaptan içerik çekmek var. Burada, Ian Goodfellow, Yoshua Bengio ve Aaron Courville’in derin öğrenme kitabına ait bir URL kullanarak fetch_article_content fonksiyonuyla ilk 200.000 karakteri çıkarıyoruz. Ön izleme olarak ilk 500 karakteri yazdırıyoruz.
book_url = "https://www.deeplearningbook.org/contents/intro.html"
book_content = fetch_article_content(book_url, content_limit=200000)
print(f"Fetched {len(book_content)} characters from the book.")
print("First 500 characters:")
print(book_content[:500])Artık verileri çıkardık ve temizledik. Sırada, Ollama üzerinden Llama3 kullanarak önbelleksiz çıkarım yapmak var. Yerelde denemek için Ollama üzerinden birçok dil modeli mevcuttur.
Önbelleksiz çıkarım için, kitabın bir özetini önbellekleme olmadan üretiyoruz. Başlangıç zamanını ayarlayıp ollama.generate() fonksiyonunu kullanarak bir yanıt üretiyoruz. Yanıt üretildikten sonra, yanıtı kontrol etmek ve özeti çıkarmak için response.get() fonksiyonunu kullanıyoruz.
Not: Yalnızca yanıtın üretilmesi için geçen süreyi dikkate alıyoruz (yani generate() fonksiyonundan önce ve sonra).
def make_non_cached_inference(prompt):
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure
    print(f"Full response: {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    return generated_summary, end_time - start_time
Yukarıdaki kod için birkaç kilit nokta:
llama3) gönderir ve yanıt alır..get() kullanarak KeyError önlenir).Önbelleksiz çıkarımdan sonra, önbellekli çıkarımı deniyoruz. Aşağıdaki fonksiyon, varsa önbelleğe alınmış sonucu kullanarak bir kitap özeti üretir. Önceki adımda olduğu gibi yanıtı aynı kodla üretiriz. Tek fark, istimin hâlihazırda önbellekte olup olmadığını kontrol eden erken bir kontroldür. Varsa, model çıkarım yapmaz ve önbellekteki yanıtı kullanır; yoksa, sonucu gelecekteki kullanımlar için önbelleğe kaydeder.
def make_cached_inference(prompt, cache):
    if prompt in cache:
        print("Using cached result...")
        return cache[prompt], 0  # Return cached response with 0 latency
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure (if needed)
    print(f"Full response (cached call): {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    cache[prompt] = generated_summary  # Store result in cache
    return generated_summary, end_time - start_time
Yukarıdaki koddan birkaç kilit nokta:
Tüm fonksiyonlar hazır olduğuna göre, üzerinde çalışacağımız istem aşağıdadır. Deneyip eğlenmekten çekinmeyin. Kitabın ilk 10.000 karakterini kullanır ve modelden bir özet üretmesini ister.
prompt = f"<book>{book_content[:10000]}</book>\nPlease provide a summary of this book."Şimdi hem önbelleksiz hem de önbellekli çıkarım çağrılarını gerçekleştirip her bir teknik için geçen süreyi ve özeti gösteriyoruz. Sonuç önbellekteyse, sıfır gecikmeyle önbellekteki özet döner; değilse, sonuç gelecekteki kullanım için önbelleğe kaydedilir.
non_cached_response, non_cached_time = make_non_cached_inference(prompt)
print(f"Non-cached inference time: {non_cached_time:.2f} seconds")
print(f"Non-cached summary: {non_cached_response}")
cache = {}

# Cached inference to generate a summary
cached_response, cached_time = make_cached_inference(prompt, cache)
print(f"Cached inference time: {cached_time:.2f} seconds")
print(f"Cached summary: {cached_response}")
Kod, sonuçları gelecekteki sorgular için saklayarak gereksiz hesaplamaların nasıl önlendiğini gösterir. Önbelleğe alınmış sonuçlar, tekrarlanan istemlerde gecikmeyi önemli ölçüde azaltır; bunu bir sonraki bölümde gözlemleyeceğiz.
Yukarıdaki kodla, yukarıda tanımlanan veriler üzerinde dört farklı modelle denemeler yaptık.
|
Model |
Önbelleksiz çıkarım süresi |
Önbellekli çıkarım süresi |
|
Llama2 |
143.98 saniye |
65.84 saniye |
|
Llama3 |
151.79 saniye |
42.48 saniye |
|
Gemma2 |
170.43 saniye |
61.84 saniye |
|
Phi3 |
239.55 saniye |
100.86 saniye |
Bu dört modelle yaptığımız deneylerdeki çıkarım sürelerine dayanarak, önbellekli çıkarımın çıkarım süresini belirgin ölçüde azalttığı açıktır.
Önbellekleme sistem belleğinizi kullandığından, maliyeti ve bellek gereksinimlerini azaltmaya yardımcı olacak bazı uygulamaları göz önünde bulundurmak önemlidir.
Aynı ya da benzer istemlerin tekrar tekrar kullanıldığı uygulama alanlarını belirleyin. Bu, “ATM PIN’imi nasıl değiştiririm?” gibi yaygın müşteri hizmetleri soruları, “Python’da Hello World nasıl yazılır?” gibi sık görülen kodlama soruları veya sık sık tekrar bakılan “bu kitabı/makale özetle” gibi uzun belgelerin bölümlerini içerebilir. Bu istemlere verilen yanıtları önbelleğe almak verimliliği en üst düzeye çıkarır.
İstemleri bir LLM’ye gönderirken tutarlı bir yapı korumak, önbellek isabet oranlarını iyileştirmeye yardımcı olur. Uygun bir format yapısı, özlü bir kullanıcı girdisini örneklerle takip edebilir. Yönergeleriniz tutarlıysa, eşleşen ya da benzer önbelleğe alınmış istemleri bulma olasılığı artar.
İyi yönetilen bir önbellek, belleği ve maliyeti şişirmeden bellek kısıtları ile performans ihtiyaçları arasında denge kurar. Uygulamanın gereksinimlerine bağlı olarak, en uygun önbellek boyutu ve tahliye politikası (ör. LRU) belirlemek, bellek kullanımını şişirmeden verimli performans sağlar.
Önbellek isabet oranlarını izlemek, önbellekleme stratejisinin etkinliğini değerlendirmek için kritiktir. İsabet oranı düşükse, benzerlik eşiklerini ayarlamayı, önbellek boyutunu artırmayı veya istem tutarlılığını iyileştirmeyi düşünün.
Yukarıdaki önbellekleme uygulamaları, uygulamaları en uygun seviyelerde çalıştırmak için bazı en iyi depolama pratikleriyle bütünleştirilir. Sırada bazı önbellek depolama ve paylaşım tekniklerini incelemek var.
Önbelleğe alınmış istemler yerelde (tek bir makinede) veya birden çok sunucuya dağıtılmış şekilde saklanabilir. Yerel önbelleklerin yönetimi daha basittir ancak büyük ölçekli uygulamalarda zorlanabilir. Buna karşın, dağıtık önbellekler çok daha geniş bir kullanıcı kitlesine hizmet verebilir ve daha yüksek yükleri kaldırabilir; ancak ek karmaşıklık ve maliyet getirir.
Birden fazla kullanıcıya veya uygulamaya sahip kurumlarda, önbelleğe alınmış istemleri sistemler arasında paylaşmak, cihazlar ve kullanıcılar genelinde merkezi erişim sağlayarak maliyetleri azaltmaya ve performansı artırmaya yardımcı olabilir. Önbelleği merkezileştirerek, tüm kullanıcılar daha önce saklanan yanıtlardan faydalanır ve gereksiz hesaplamalardan kaçınılır.
Gizlilik, özellikle kullanıcı girdileri ve yanıtları gibi önbelleğe alınmış veriler saklanırken temel bir endişedir. Hassas veriler şifrelenmeli ve yalnızca yetkili kullanıcıların önbelleğe erişmesini sağlayacak erişim kontrolleri uygulanmalıdır. Kullanıcı verilerini güvende tutmak için birden fazla şifreleme algoritması kullanılır. Son dönemde öne çıkan bir diğer yaygın uygulama da hesaplamaları yerel cihazlarda gerçekleştirmektir; böylece veriler cihazı asla terk etmez.
Önbelleğe alınmış istemlerin birden çok kullanıcı veya uygulama arasında paylaşıldığı ortamlarda, önbellek ısındırma ve canlı tutma (keep-alive) pingleri gibi teknikler, paylaşılan verilerin kullanılabilirliğini ve tazeliğini korumaya yardımcı olur; önbellek kaçırma olasılığını azaltır ve ağ genelinde tutarlı, hızlı bir kullanıcı deneyimi sağlar. Bu teknikleri daha iyi anlayalım.
Önbelleğin her zaman ilgili verilerle dolu olmasını sağlamanın bir yolu, sık kullanılan istemlerle “ısındırmak” yani onu önceden doldurmaktır. Bu teknik, sistem başlatıldıktan sonraki ilk etkileşimlerde gecikmeyi azaltmak için faydalıdır. Örneğin bir e-ticaret sohbet botunda “İade politikalarınız nedir?” veya “Siparişim nerede?” gibi sık sorulan sorular baştan önbelleğe alınarak ilk andan itibaren anında yanıt sağlanabilir. Önbellek ısındırma, sistem yeniden başlatmalarından, güncellemelerden veya dağıtımlardan sonra da faydalıdır; zira önbelleğin boş olduğu ve başlangıçta yanıtların daha yavaş kaldığı soğuk başlangıcı önlemeye yardımcı olur.
Önbellek girdilerinin atıl kaldığı için süresinin dolmasını önlemek amacıyla, popüler önbellek girdilerinin daha uzun süre taze ve erişilebilir kalmasını sağlayan periyodik canlı tutma pingleri gönderilebilir. Bu pingler, özellikle yüksek değerli veya sık talep edilen istemlere bağlı belirli önbellek girdilerini düzenli olarak yenileyerek, yakın zamanda kullanılmamış olsalar bile taze ve erişilebilir kalmalarını sağlar.
Bu, e-ticaret sorgularında mevsimsel artışlar veya yoğun saatlerde müşteri desteği etkileşimleri gibi döngüsel trafik desenlerine sahip uygulamalarda özellikle kullanışlıdır.
Maliyet optimizasyonu, API çağrısı sayısından toplam bellek kullanımına kadar her yapay zekâ tabanlı uygulamanın merkezinde yer alır.
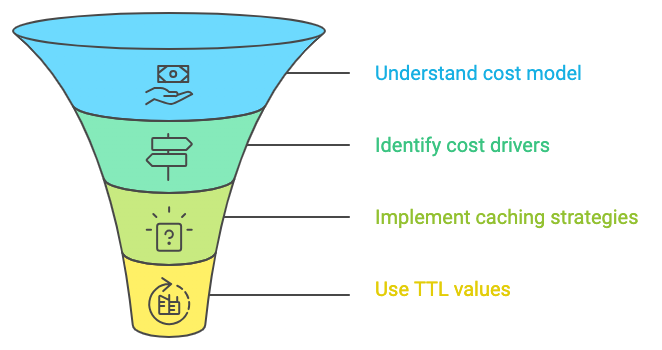
Çok sayıda önbellekleme örneğiyle çalışırken, kolay düzeltme gerektiren bazı sorunlarla karşılaşabiliriz. Bunlardan birkaçı şunlardır:
Bir istem önbellekte bulunamadığında önbellek kaçırma meydana gelir. Bu, tutarsız istem yapıları veya aşırı kısıtlayıcı benzerlik eşikleri nedeniyle olabilir. Bunu düzeltmek için, istemlerin tutarlılığını gözden geçirmemiz ve küçük varyasyonlara izin verecek şekilde benzerlik eşiğini ayarlamamız gerekir. Örneğin, bir müşteri hizmeti sohbet botu sıkça “İade politikanız nedir?” istemini alıp yanıtını önbelleğe alıyorsa; bir kullanıcı “İade/geri ödeme politikanız hakkında bilgi verir misiniz?” diye sorduğunda sistemin benzerlik eşiği çok sıkıysa bunu benzer istem olarak tanımaz ve önbellek kaçırma olur.
Temel veri veya model değiştiğinde önbelleğin geçersiz kılınması gerekir. Önbellek girdilerini yenilemek için otomatik geçersiz kılma politikaları kurabilir veya gerekirse belirli girdiler için manuel geçersiz kılma uygulayabilirsiniz. Örneğin bir finans uygulaması vergi mevzuatına ilişkin yanıtları önbelleğe alıyorsa, vergi yasaları değiştiğinde önceden önbelleğe alınmış yanıtlar güncelliğini yitirir. Sistem, düzenleyici bir güncellemeden sonra önbelleği yenileyen veya temizleyen otomatik bir geçersiz kılma politikasıyla yapılandırılabilir.
Bu yazıda, prompt caching kavramını ve Ollama kullanarak nasıl uygulanacağını ele aldık. Prompt caching’in, LLM’lerle ilişkili çıkarım süresini ve maliyetleri kayda değer biçimde azaltabileceğini gösterdik.
Bu kurslarla yapay zekâyı öğrenin!
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



