
लर्निंग पाथ
एआई अनुप्रयोग विकसित करना
21 घंटा
मूल रूप से, प्रॉम्प्ट कैशिंग प्रॉम्प्ट्स और उनके उत्तरों को कैश में संग्रहीत करके काम करती है। जब वही या मिलता-जुलता प्रॉम्प्ट फिर आता है, तो सिस्टम नया उत्तर जनरेट करने के बजाय कैश्ड उत्तर ले आता है। इससे दोहराव वाली गणना से बचा जा सकता है, प्रतिक्रिया समय तेज़ होता है और लागत घटती है।
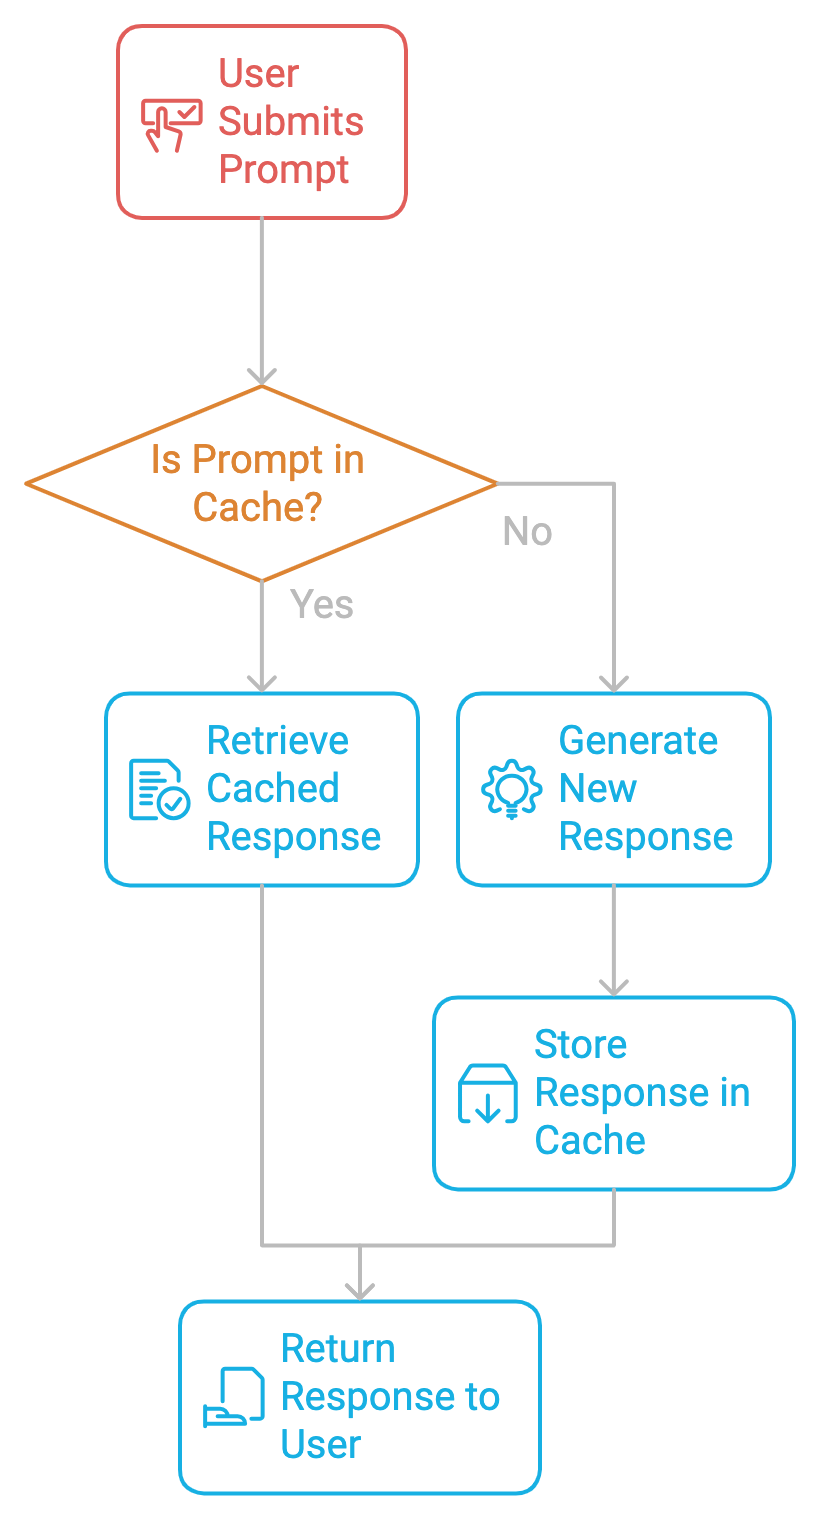
प्रॉम्प्ट कैशिंग के कई लाभ हैं:
प्रॉम्प्ट कैशिंग लागू करने से पहले कुछ बातों का ध्यान रखना ज़रूरी है।
डेटा की ताज़गी बनाए रखने के लिए, हर कैश्ड उत्तर के साथ मेमोरी में एक Time-to-Live (TTL) होना चाहिए। TTL तय करता है कि कोई कैश्ड उत्तर कितने समय तक वैध माना जाएगा। TTL समाप्त होने पर एंट्री हटाई या अपडेट की जाती है, और अगली बार प्रॉम्प्ट आने पर उसे दोबारा कंप्यूट किया जाता है।
यह तंत्र सुनिश्चित करता है कि कैश में पुरानी जानकारी न रहे। स्थिर या कम अपडेट होने वाली सामग्री, जैसे कानूनी दस्तावेज़ या उत्पाद मैनुअल, के लिए लंबा TTL पुन:गणना घटाने में मदद कर सकता है बिना डेटा बासी होने का जोखिम बढ़ाए। इसलिए, TTL मानों को सही तरह ट्यून करना डेटा ताज़गी और कम्प्यूटेशनल दक्षता में संतुलन के लिए अहम है।
कभी-कभी दो प्रॉम्प्ट्स समान होते हैं, एक जैसे नहीं। किसी नए प्रॉम्प्ट का मौजूदा कैश्ड प्रॉम्प्ट से कितना मेल है, यह तय करना प्रभावी कैशिंग के लिए महत्वपूर्ण है। प्रॉम्प्ट समानता लागू करने के लिए फज़ी मैचिंग या सेमान्टिक सर्च जैसी तकनीकों की ज़रूरत होती है, जहाँ सिस्टम वेक्टर एम्बेडिंग्स का उपयोग करके प्रॉम्प्ट्स का निरूपण करता है और उनकी समानता की तुलना करता है।
मिलते-जुलते प्रॉम्प्ट्स के उत्तर कैश करके, सिस्टम पुन:गणना घटा सकते हैं जबकि उत्तर की सटीकता ऊँची बनाए रख सकते हैं। हालाँकि, समानता सीमा बहुत ढीली रखने पर मिलान गलत हो सकते हैं, और बहुत सख्त रखने पर कैशिंग के मौक़े छूट सकते हैं।
Least Recently Used (LRU) जैसी रणनीतियाँ कैश आकार प्रबंधित करने में मदद करती हैं। LRU कैश भरने पर सबसे कम एक्सेस्ड डेटा हटाती है। यह तब अच्छा काम करती है जब कुछ प्रॉम्प्ट्स अधिक लोकप्रिय हों और कैश में बने रहने चाहिए, जबकि कम सामान्य क्वेरीज़ को नई रिक्वेस्ट्स के लिए जगह बनाने हेतु हटाया जा सकता है।
प्रॉम्प्ट कैशिंग लागू करना दो चरणों की प्रक्रिया है।
पहला चरण सिस्टम में बार-बार दोहराए जाने वाले प्रॉम्प्ट्स की पहचान करना है। चाहे हम चैटबॉट, कोडिंग असिस्टेंट या डॉक्युमेंट प्रोसेसर बना रहे हों, हमें मॉनिटर करना होगा कि कौन से प्रॉम्प्ट्स बार-बार आते हैं। पहचान होने पर, उन्हें कैश करके अनावश्यक गणना से बचा जा सकता है।
प्रॉम्प्ट पहचानने के बाद, उसका उत्तर TTL, कैश हिट/मिस रेट आदि जैसे मेटाडाटा के साथ कैश में रखा जाता है। जब भी वही प्रॉम्प्ट फिर सबमिट होता है, सिस्टम महँगी जनरेशन प्रक्रिया छोड़कर कैश्ड उत्तर ले आता है।
सैद्धांतिक समझ के बाद, आइए स्थानीय वातावरण में Ollama का उपयोग करते हुए कैशिंग बनाम नो-कैशिंग के प्रभाव का व्यावहारिक उदाहरण देखें। यहाँ हम एक वेब-होस्टेड डीप लर्निंग पुस्तक और स्थानीय मॉडलों का उपयोग करके पुस्तक के शुरुआती पन्नों का सार लिखवाते हैं। हम Gemma2, Llama2 और Llama3 सहित कई LLMs के साथ प्रदर्शन की तुलना करेंगे।
इस हैंड्स-ऑन उदाहरण के लिए हम BeautifulSoup का उपयोग करेंगे, जो HTML और XML दस्तावेज़ों (खराब मार्कअप वाले भी) को पार्स करने वाला एक Python पैकेज है। BeautifulSoup इंस्टॉल करने के लिए यह चलाएँ:
!pip install BeautifulSoupएक और टूल जिसका हम उपयोग करेंगे वह है Ollama। यह लोकल सिस्टम्स पर बड़े लैंग्वेज मॉडल्स की इंस्टॉलेशन और मैनेजमेंट को सरल बनाता है।
शुरू करने के लिए, Ollama डाउनलोड करें और अपने डेस्कटॉप पर इंस्टॉल करें। हम अपनी ज़रूरत के अनुसार मॉडल नाम बदल सकते हैं। Ollama की आधिकारिक वेबसाइट पर मॉडल लाइब्रेरी देखें ताकि Ollama द्वारा समर्थित अलग-अलग मॉडल मिल सकें। टर्मिनल में यह कोड चलाएँ:
ollama run llama3.1 हम तैयार हैं। शुरू करते हैं!
हम निम्नलिखित इम्पोर्ट से शुरू करते हैं:
time कैशिंग और नो-कैशिंग कोड के लिए इन्फ़रेंस समय ट्रैक करने हेतुrequests HTTP रिक्वेस्ट करने और वेब पेजों से डेटा लाने के लिएBeautifulSoup HTML सामग्री पार्स और साफ़ करने के लिएOllama LLMs को लोकली उपयोग करने के लिएimport time
import requests
from bs4 import BeautifulSoup
import ollamaनिम्न कोड में, हम fetch_article_content फ़ंक्शन परिभाषित करते हैं जो दिए गए URL से टेक्स्ट सामग्री लाकर साफ़ करता है। यह requests लाइब्रेरी का उपयोग करके वेबपेज लाने की कोशिश करता है और नेटवर्क या सर्वर समस्याओं पर अधिकतम तीन बार पुनः प्रयास करता है।
फ़ंक्शन BeautifulSoup से HTML पार्स करता है और अनावश्यक <script> और <style> टैग हटाता है। आगे टेक्स्ट से अग्र/पश्च स्पेस हटाकर, लाइनों में बाँटकर, और उन्हें साफ़ पैराग्राफ़ में जोड़कर प्रोसेस करता है। यदि कंटेंट लिमिट दी गई है तो टेक्स्ट उसी तक सीमित कर देता है। सभी प्रयास विफल होने पर, यह हर प्रयास के बीच थोड़ी देरी के बाद अपवाद उठाता है।
समझने के लिए कुछ प्रमुख पैरामीटर्स:
BeautifulSoup से <script> और <style> जैसे अनावश्यक तत्व हटाता है।def fetch_article_content(url, retries=3, content_limit=None):
attempt = 0
while attempt < retries:
try:
response = requests.get(url, timeout=30) # Add timeout to prevent hanging
response.raise_for_status() # Raise an error for bad responses (4xx, 5xx)
soup = BeautifulSoup(response.content, 'html.parser')
# Remove script and style elements
for script in soup(["script", "style"]):
script.decompose()
# Get text
text = soup.get_text()
# Break into lines and remove leading and trailing space on each
lines = (line.strip() for line in text.splitlines())
chunks = (phrase.strip() for line in lines for phrase in line.split(" "))
text = '\n'.join(chunk for chunk in chunks if chunk)
# Limit content if specified
if content_limit:
text = text[:content_limit]
return text
except (requests.exceptions.RequestException, requests.exceptions.ChunkedEncodingError) as e:
attempt += 1
print(f"Attempt {attempt} failed: {e}")
if attempt >= retries:
raise
time.sleep(2) # Wait before retryingअगले चरण में, हम इन्फ़रेंस के लिए पुस्तक की सामग्री लाते हैं। यहाँ हम Ian Goodfellow, Yoshua Bengio, और Aaron Courville की डीप लर्निंग पुस्तक का URL लेकर fetch_article_content फ़ंक्शन से पहले 200,000 कैरेक्टर्स निकालते हैं। प्रीव्यू के तौर पर पहले 500 कैरेक्टर्स प्रिंट करते हैं।
book_url = "https://www.deeplearningbook.org/contents/intro.html"
book_content = fetch_article_content(book_url, content_limit=200000)
print(f"Fetched {len(book_content)} characters from the book.")
print("First 500 characters:")
print(book_content[:500])अब डेटा एक्सट्रैक्ट और साफ़ हो चुका है। अगला कदम है Ollama के जरिए Llama3 पर बिना कैश के इन्फ़रेंस करना। Ollama पर लोकली प्रयोग के लिए कई लैंग्वेज मॉडल उपलब्ध हैं।
बिना कैश के इन्फ़रेंस में, हम पुस्तक का सार बिना कैशिंग के जनरेट करते हैं। हम स्टार्ट टाइम सेट करते हैं और ollama.generate() फ़ंक्शन से उत्तर बनवाते हैं। उत्तर मिलने पर, response.get() से उत्तर जाँचकर सार निकालते हैं।
नोट: हम केवल उत्तर जनरेट करने में लगा समय गिनते हैं (यानी generate() फ़ंक्शन से पहले और बाद का)।
def make_non_cached_inference(prompt):
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure
    print(f"Full response: {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    return generated_summary, end_time - start_time
ऊपर दिए कोड के कुछ मुख्य बिंदु:
llama3) को भेजता है और उत्तर पाता है।.get() का उपयोग करके KeyError से बचाव)।बिना कैश के इन्फ़रेंस के बाद, हम कैश्ड इन्फ़रेंस पर प्रयोग करते हैं। यह फ़ंक्शन उपलब्ध होने पर कैश्ड परिणाम से पुस्तक का सार बनाता है। पिछले चरण जैसा ही कोड है; फ़र्क केवल शुरुआती जाँच का है जो देखती है कि प्रॉम्प्ट पहले से कैश में है या नहीं। यदि है, तो मॉडल इन्फ़रेंस नहीं करता और मौजूदा कैश्ड उत्तर ही लौटाता है; अन्यथा, परिणाम को भविष्य के लिए कैश में सहेज देता है।
def make_cached_inference(prompt, cache):
    if prompt in cache:
        print("Using cached result...")
        return cache[prompt], 0  # Return cached response with 0 latency
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure (if needed)
    print(f"Full response (cached call): {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    cache[prompt] = generated_summary  # Store result in cache
    return generated_summary, end_time - start_time
ऊपर के कोड के कुछ मुख्य बिंदु:
अब जबकि सभी फ़ंक्शंस सेट हैं, यहाँ वह प्रॉम्प्ट है जिस पर हम काम करेंगे। आप चाहें तो इसके साथ प्रयोग कर सकते हैं। यह पुस्तक के पहले 10,000 कैरेक्टर्स का उपयोग करता है और मॉडल से सार माँगता है।
prompt = f"<book>{book_content[:10000]}</book>\nPlease provide a summary of this book."अब हम दोनों—बिना कैश और कैश्ड—इन्फ़रेंस कॉल करके सार बनवाते हैं और दोनों तकनीकों के लिए लगा समय और सार दिखाते हैं। यदि परिणाम कैश्ड है, तो शून्य विलंबता के साथ कैश्ड सार लौटता है; अन्यथा, भविष्य के लिए परिणाम कैश हो जाता है।
non_cached_response, non_cached_time = make_non_cached_inference(prompt)
print(f"Non-cached inference time: {non_cached_time:.2f} seconds")
print(f"Non-cached summary: {non_cached_response}")
cache = {}

# Cached inference to generate a summary
cached_response, cached_time = make_cached_inference(prompt, cache)
print(f"Cached inference time: {cached_time:.2f} seconds")
print(f"Cached summary: {cached_response}")
यह कोड दिखाता है कि कैशिंग कैसे भविष्य की क्वेरीज़ के लिए परिणाम सहेजकर अनावश्यक गणनाओं से बचाती है। दोहराए गए प्रॉम्प्ट्स पर कैश्ड परिणाम विलंबता को उल्लेखनीय रूप से घटाते हैं, जिसे हम अगले खंड में देखेंगे।
ऊपर दिए कोड के साथ, हमने इसी डेटा पर चार अलग-अलग मॉडलों से प्रयोग किया।
|
मॉडल |
बिना कैश के इन्फ़रेंस समय |
कैश्ड इन्फ़रेंस समय |
|
Llama2 |
143.98 सेकंड |
65.84 सेकंड |
|
Llama3 |
151.79 सेकंड |
42.48 सेकंड |
|
Gemma2 |
170.43 सेकंड |
61.84 सेकंड |
|
Phi3 |
239.55 सेकंड |
100.86 सेकंड |
इन चार मॉडलों पर हमारे प्रयोगों के इन्फ़रेंस समय के आधार पर स्पष्ट है कि कैश्ड इन्फ़रेंस, इन्फ़रेंस समय को बड़े पैमाने पर कम करता है।
क्योंकि कैशिंग आपके सिस्टम की मेमोरी उपयोग करती है, इसलिए कुछ ऐसी प्रथाओं पर विचार करना महत्वपूर्ण है जो लागत और मेमोरी की माँग घटा सकें।
एप्लिकेशन के वे हिस्से पहचानें जहाँ एक जैसे या मिलते-जुलते प्रॉम्प्ट्स बार-बार आते हैं। इसमें सामान्य कस्टमर सर्विस प्रश्न जैसे “मैं अपना ATM PIN कैसे बदलूँ?”, सामान्य कोडिंग प्रश्न जैसे “Python में Hello World कैसे लिखें?”, या लंबे दस्तावेज़ों के वे हिस्से जैसे “इस किताब/पेपर का सार बताएँ” शामिल हो सकते हैं जिन पर बार-बार लौटा जाता है। ऐसे प्रॉम्प्ट्स के उत्तर कैश करके दक्षता अधिकतम होगी।
LLM को प्रॉम्प्ट्स सबमिट करते समय सुसंगत संरचना बनाए रखने से कैश हिट रेट बेहतर होती है। एक अच्छा फ़ॉर्मेट संक्षिप्त यूज़र इनपुट के बाद उदाहरणों से बना हो सकता है। यदि आपके निर्देश सुसंगत हैं, तो मिलते-जुलते या मेल खाते कैश्ड प्रॉम्प्ट्स मिलने की संभावना बढ़ती है।
अच्छी तरह प्रबंधित कैश मेमोरी सीमाओं और प्रदर्शन आवश्यकताओं का संतुलन बनाए रखता है, बिना मेमोरी और लागत फुलाए। एप्लिकेशन की ज़रूरतों के अनुसार इष्टतम कैश आकार और एविक्शन पॉलिसी (जैसे LRU) सेट करना प्रभावी प्रदर्शन सुनिश्चित करता है।
कैश हिट रेट मॉनिटर करना कैशिंग रणनीति की प्रभावशीलता आँकने के लिए महत्वपूर्ण है। यदि हिट रेट कम है, तो समानता सीमाएँ समायोजित करें, कैश आकार बढ़ाएँ, या प्रॉम्प्ट सुसंगतता को परिष्कृत करें ताकि इनपुट प्रॉम्प्ट के लिए बेहतर मेल मिल सके।
उपर्युक्त कैशिंग प्रथाएँ कुछ सर्वोत्तम स्टोरेज प्रथाओं के साथ मिलकर एप्लिकेशंस को इष्टतम स्तर पर चलाने में सहायक होती हैं। आगे हम कुछ कैश स्टोरेज और शेयरिंग तकनीकों की पड़ताल करेंगे।
कैश्ड प्रॉम्प्ट्स लोकली (एक मशीन पर) या कई सर्वरों पर वितरित रूप में संग्रहीत किए जा सकते हैं। लोकल कैश को मैनेज करना सरल है, पर बड़े पैमाने के एप्लिकेशंस में सीमित हो सकता है। इसके विपरीत, वितरित कैश बड़ी उपयोगकर्ता संख्या को सेवा दे सकता है और अधिक लोड सँभाल सकता है, पर इसमें अतिरिक्त जटिलता और लागत जुड़ती है।
कई उपयोगकर्ताओं या एप्लिकेशंस वाली संस्थाओं के लिए, सिस्टम्स के बीच कैश्ड प्रॉम्प्ट्स साझा करना लागत घटाने और प्रदर्शन सुधारने में मदद कर सकता है, क्योंकि डिवाइसों और उपयोगकर्ताओं में केंद्रीकृत एक्सेस कम लागत पर उपलब्ध होता है। कैश को केंद्रीकृत करने से सभी उपयोगकर्ता पहले से सहेजे उत्तरों का लाभ उठा सकते हैं और अनावश्यक गणनाओं से बचा जा सकता है।
गोपनीयता कैश्ड डेटा—खासकर उपयोगकर्ता इनपुट और उत्तर—को संग्रहीत करते समय प्रमुख चिंता है। संवेदनशील डेटा को एन्क्रिप्ट किया जाना चाहिए, और एक्सेस कंट्रोल्स होने चाहिए ताकि केवल अधिकृत उपयोगकर्ता ही कैश तक पहुँच सकें। उपयोगकर्ता डेटा सुरक्षित रखने के लिए कई एन्क्रिप्शन एल्गोरिद्म उपयोग किए जाते हैं। हाल की एक सामान्य प्रथा यह भी है कि गणनाएँ लोकल डिवाइस पर ही की जाएँ ताकि डेटा डिवाइस से बाहर न जाए।
जहाँ कैश्ड प्रॉम्प्ट्स कई उपयोगकर्ताओं या एप्लिकेशंस में साझा होते हैं, वहाँ कैश वार्म-अप और कीप-अलाइव पिंग्स जैसी तकनीकें साझा डेटा की उपलब्धता और ताज़गी बनाए रखने में मदद करती हैं, कैश मिस की संभावना घटाती हैं और नेटवर्क पर तेज़, सुसंगत अनुभव सुनिश्चित करती हैं। आइए इन तकनीकों को समझें।
यह सुनिश्चित करने का एक तरीका कि कैश हमेशा प्रासंगिक डेटा से भरा रहे, उसे "वार्म अप" करना है—अर्थात सामान्यत: उपयोग होने वाले प्रॉम्प्ट्स से पहले से भरना। यह तकनीक सिस्टम लॉन्च होने के बाद शुरुआती इंटरैक्शंस में विलंबता घटाने में कारगर है। उदाहरण के लिए, ई-कॉमर्स चैटबॉट में “आपकी रिटर्न पॉलिसी क्या है?” या “मेरा ऑर्डर कहाँ है?” जैसे सवालों को पहले से कैश करके आरंभ से ही त्वरित उत्तर दिए जा सकते हैं। सिस्टम रीस्टार्ट, अपडेट या डिप्लॉयमेंट के बाद भी कैश वार्म-अप फायदेमंद है ताकि कोल्ड स्टार्ट से बचा जा सके, जब कैश खाली होता है और शुरुआती उत्तर धीमे हो सकते हैं।
निष्क्रियता के कारण कैश एंट्रीज़ की एक्सपायरी रोकने के लिए, समय-समय पर कीप-अलाइव पिंग्स भेजे जा सकते हैं ताकि लोकप्रिय कैश्ड प्रॉम्प्ट्स लंबे समय तक ताज़ा और उपलब्ध रहें। कीप-अलाइव पिंग्स उच्च-मूल्य या आमतौर पर माँगे जाने वाले प्रॉम्प्ट्स से जुड़ी एंट्रीज़ को समय-समय पर रिफ्रेश करते हैं, ताकि वे हाल में उपयोग न होने पर भी ताज़ा और उपलब्ध रहें।
यह विशेष रूप से उन एप्लिकेशंस में उपयोगी है जिनमें चक्रीय ट्रैफ़िक पैटर्न होते हैं—जैसे ई-कॉमर्स क्वेरीज़ में मौसमी उछाल या पीक-ऑवर कस्टमर सपोर्ट इंटरैक्शंस।
लागत अनुकूलन किसी भी AI-आधारित एप्लिकेशन के केंद्र में होता है—API कॉल्स की संख्या से लेकर कुल मेमोरी उपयोग तक।
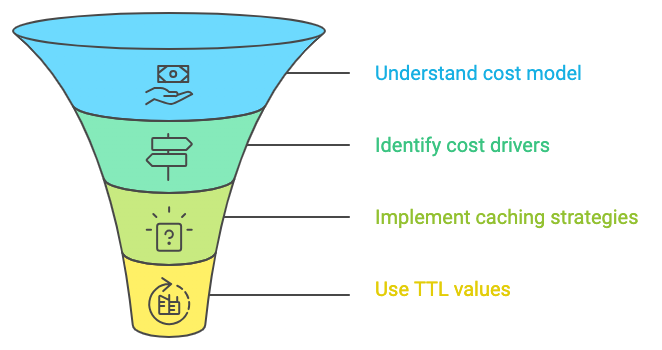
कई कैशिंग उदाहरणों पर काम करते समय कुछ समस्याएँ आ सकती हैं जिनके आसान समाधान हैं। उनमें से कुछ इस प्रकार हैं:
कैश मिस तब होती है जब प्रॉम्प्ट कैश में नहीं मिलता। यह असंगत प्रॉम्प्ट संरचनाओं या बहुत सख़्त समानता सीमाओं के कारण हो सकता है। इसे ठीक करने के लिए, प्रॉम्प्ट्स की सुसंगतता की समीक्षा करें और समानता सीमा को इस तरह समायोजित करें कि मामूली भिन्नताओं को अनुमति मिले। कल्पना करें कि कस्टमर सर्विस चैटबॉट को अक्सर “What is your refund policy?” प्रॉम्प्ट मिलता है और उसका उत्तर कैश है। लेकिन यदि कोई उपयोगकर्ता “Can you tell me about your return policy?” पूछे और सिस्टम की समानता सीमा बहुत सख़्त हो, तो इसे समान प्रॉम्प्ट के रूप में नहीं पहचानेगा और कैश मिस होगी।
जब आधारभूत डेटा या मॉडल बदलते हैं, तो कैश इनवैलिडेशन आवश्यक है। आप स्वचालित इनवैलिडेशन नीतियाँ सेट कर सकते हैं जो कैश एंट्रीज़ को रिफ्रेश करें, या ज़रूरत पड़ने पर विशिष्ट एंट्रीज़ के लिए मैन्युअल इनवैलिडेशन कर सकते हैं। मान लें कि कोई फ़ाइनेंस एप्लिकेशन टैक्स नियमों से जुड़े उत्तर कैश करता है। टैक्स कानून बदलने पर पहले से कैश्ड उत्तर पुराने हो जाते हैं। सिस्टम को इस तरह कॉन्फ़िगर किया जा सकता है कि नियामकीय अपडेट के बाद कैश अपने-आप रिफ्रेश या साफ़ हो जाए।
इस आलेख में, हमने प्रॉम्प्ट कैशिंग की अवधारणा और Ollama का उपयोग करके उसके इम्प्लीमेंटेशन की पड़ताल की। हमने दिखाया कि प्रॉम्प्ट कैशिंग LLMs से जुड़े इन्फ़रेंस समय और लागत को उल्लेखनीय रूप से घटा सकती है।
इन कोर्सेज़ के साथ AI सीखें!
लर्निंग पाथ
कोर्स
कोर्स