
Programma
Sviluppare applicazioni AI
21 ore
Alla base, il prompt caching funziona memorizzando i prompt e le relative risposte in una cache. Quando viene inviato di nuovo lo stesso prompt o uno simile, il sistema recupera la risposta in cache invece di generarne una nuova. Questo evita calcoli ripetitivi, accelera i tempi di risposta e riduce i costi.
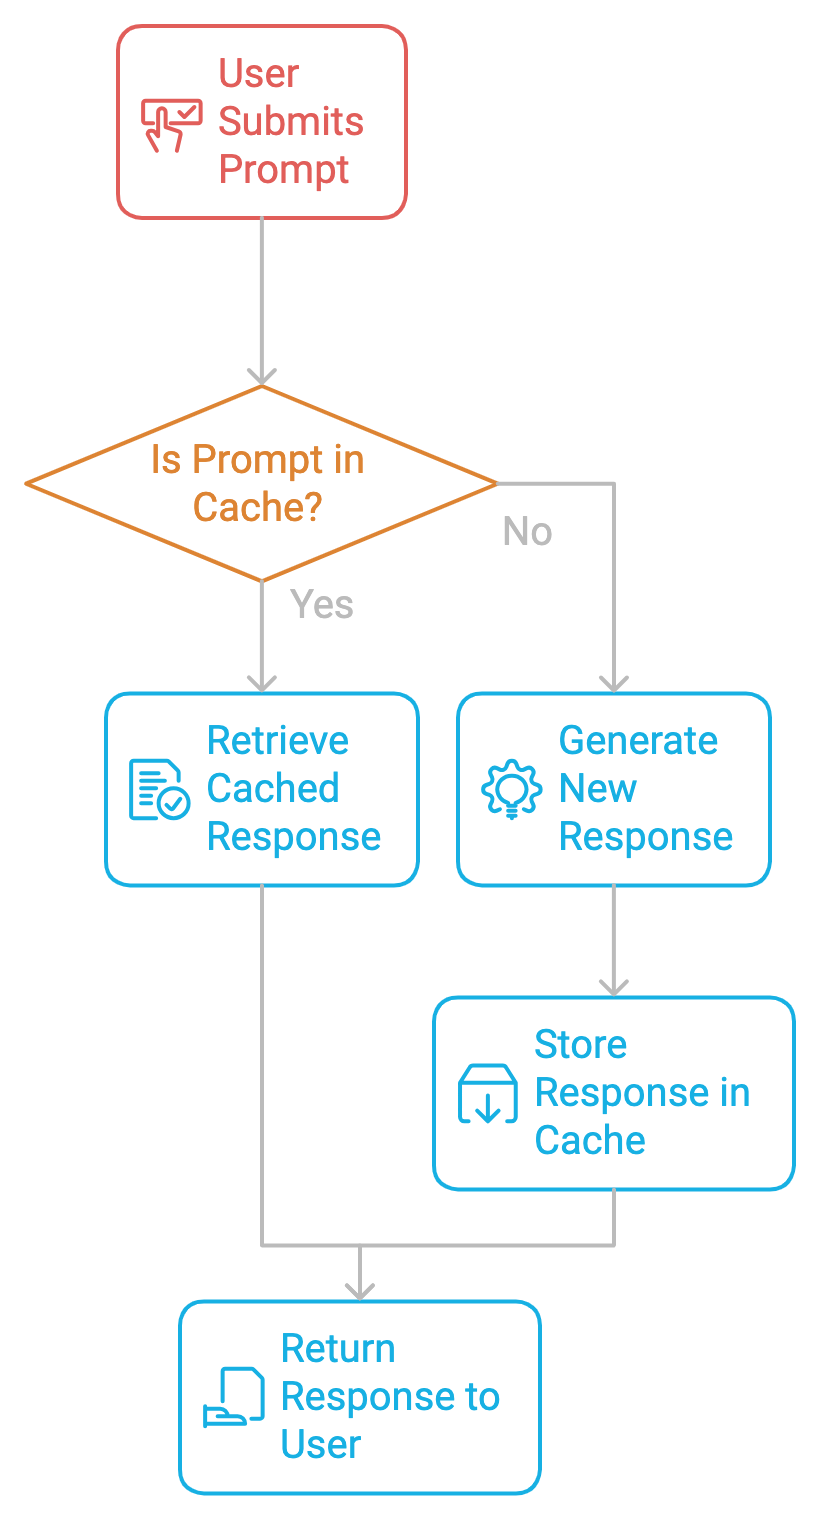
Il prompt caching offre diversi vantaggi:
Prima di addentrarci nell’implementazione del prompt caching, è bene tenere a mente alcune considerazioni.
Per garantire la freschezza dei dati, ogni risposta in cache dovrebbe avere un TTL (Time-to-Live) in memoria. Il TTL determina per quanto tempo una risposta in cache è considerata valida. Alla scadenza, la voce viene rimossa o aggiornata e il prompt corrispondente viene ricalcolato alla successiva richiesta.
Questo meccanismo evita che la cache conservi informazioni obsolete. Per contenuti statici o aggiornati di rado, come documenti legali o manuali di prodotto, un TTL più lungo riduce i ricalcoli senza rischiare l’obsolescenza dei dati. Sintonizzare correttamente i valori TTL è quindi essenziale per bilanciare freschezza dei dati ed efficienza computazionale.
A volte due prompt sono simili ma non identici. Stabilire quanto un nuovo prompt sia vicino a uno già in cache è cruciale per un caching efficace. La similarità tra prompt richiede tecniche come fuzzy matching o ricerca semantica, dove il sistema usa embedding vettoriali per rappresentare i prompt e confrontarne la somiglianza.
Mettendo in cache le risposte per prompt simili, si riducono i ricalcoli mantenendo un’alta accuratezza. Tuttavia, una soglia di similarità troppo permissiva può causare abbinamenti errati, mentre una troppo rigida può far perdere opportunità di caching.
Strategie come LRU (Least Recently Used) aiutano a gestire la dimensione della cache. LRU rimuove i dati meno consultati quando la cache raggiunge la capacità. Funziona bene quando certi prompt sono più popolari e devono restare in cache, mentre le query meno comuni possono essere rimosse per fare spazio a richieste più recenti.
Implementare il prompt caching richiede due passaggi.
Il primo passo è individuare i prompt ripetitivi più frequenti nel sistema. Che si tratti di un chatbot, un assistente di codifica o un processore di documenti, bisogna monitorare quali prompt si ripetono. Una volta identificati, si possono mettere in cache per evitare calcoli ridondanti.
Una volta identificato il prompt, la sua risposta viene salvata in cache insieme a metadati come TTL, tassi di cache hit/miss e altro. Ogni volta che l’utente invia di nuovo lo stesso prompt, il sistema recupera la risposta in cache, saltando il costoso processo di generazione.
Dopo la teoria, passiamo a un esempio pratico con Ollama per confrontare caching e non caching in locale. Usiamo dati da un libro di deep learning ospitato sul web e modelli locali per riassumere le prime pagine del libro. Sperimenteremo con più LLM, tra cui Gemma2, Llama2 e Llama3, per confrontarne le prestazioni.
Per questo esempio pratico useremo BeautifulSoup, un pacchetto Python che analizza documenti HTML e XML, anche con markup non valido. Per installare BeautifulSoup, esegui:
!pip install BeautifulSoupUn altro strumento che useremo è Ollama. Semplifica l’installazione e la gestione di large language model su sistemi locali.
Per iniziare, scarica e installa Ollama sul tuo desktop. Possiamo variare il nome del modello in base alle esigenze. Consulta la libreria sul sito ufficiale di Ollama per i vari modelli supportati. Esegui il seguente comando nel terminale:
ollama run llama3.1 Tutto pronto. Iniziamo!
Partiamo con i seguenti import:
time per misurare i tempi di inferenza del codice con e senza cacherequests per effettuare richieste HTTP e recuperare dati dalle pagine webBeautifulSoup per analizzare e ripulire contenuti HTMLOllama per usare LLM in localeimport time
import requests
from bs4 import BeautifulSoup
import ollamaNel codice seguente definiamo una funzione fetch_article_content che recupera e pulisce il testo da un URL. Prova a scaricare il contenuto della pagina tramite la libreria requests, con fino a tre tentativi in caso di errori di rete o del server.
La funzione usa BeautifulSoup per analizzare l’HTML e rimuove i tag <script> e <style> superflui. Il testo viene poi ripulito rimuovendo spazi iniziali e finali, spezzando le righe e ricombinandole in paragrafi puliti. Se è impostato un limite, il testo viene troncato. Se tutti i tentativi falliscono, la funzione solleva un’eccezione dopo una breve attesa tra un tentativo e l’altro.
Ecco alcuni parametri chiave da conoscere:
BeautifulSoup per rimuovere elementi non necessari come i tag <script> e <style>.def fetch_article_content(url, retries=3, content_limit=None):
attempt = 0
while attempt < retries:
try:
response = requests.get(url, timeout=30) # Add timeout to prevent hanging
response.raise_for_status() # Raise an error for bad responses (4xx, 5xx)
soup = BeautifulSoup(response.content, 'html.parser')
# Remove script and style elements
for script in soup(["script", "style"]):
script.decompose()
# Get text
text = soup.get_text()
# Break into lines and remove leading and trailing space on each
lines = (line.strip() for line in text.splitlines())
chunks = (phrase.strip() for line in lines for phrase in line.split(" "))
text = '\n'.join(chunk for chunk in chunks if chunk)
# Limit content if specified
if content_limit:
text = text[:content_limit]
return text
except (requests.exceptions.RequestException, requests.exceptions.ChunkedEncodingError) as e:
attempt += 1
print(f"Attempt {attempt} failed: {e}")
if attempt >= retries:
raise
time.sleep(2) # Wait before retryingOra recuperiamo il contenuto di un libro per l’inferenza. Usiamo un URL del libro di deep learning di Ian Goodfellow, Yoshua Bengio e Aaron Courville con la funzione fetch_article_content per estrarre i primi 200.000 caratteri. Stampiamo i primi 500 caratteri come anteprima.
book_url = "https://www.deeplearningbook.org/contents/intro.html"
book_content = fetch_article_content(book_url, content_limit=200000)
print(f"Fetched {len(book_content)} characters from the book.")
print("First 500 characters:")
print(book_content[:500])Ora che i dati sono stati estratti e ripuliti, eseguiamo un’inferenza senza cache usando Llama3 tramite Ollama. Sono disponibili diversi modelli linguistici su Ollama per sperimentare in locale.
Per l’inferenza senza cache, generiamo un riassunto del libro senza caching. Impostiamo un orario di inizio e generiamo una risposta con la funzione ollama.generate(). Una volta generata, usiamo response.get() per controllare la risposta ed estrarre il riassunto.
Nota: consideriamo solo il tempo necessario a generare la risposta (cioè prima e dopo la funzione generate()).
def make_non_cached_inference(prompt):
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure
    print(f"Full response: {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    return generated_summary, end_time - start_time
Ecco alcuni punti chiave del codice sopra:
llama3) e ottiene la risposta..get() per evitare KeyError).Dopo l’inferenza senza cache, proviamo l’inferenza con cache. La funzione seguente genera un riassunto del libro usando un risultato in cache se disponibile. Come nel passaggio precedente, produciamo la risposta con lo stesso codice. La differenza è un controllo iniziale che verifica se il prompt è già in cache. In tal caso, il modello non esegue l’inferenza ma usa la risposta in cache; altrimenti, salva il risultato in cache per utilizzi futuri.
def make_cached_inference(prompt, cache):
    if prompt in cache:
        print("Using cached result...")
        return cache[prompt], 0  # Return cached response with 0 latency
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure (if needed)
    print(f"Full response (cached call): {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    cache[prompt] = generated_summary  # Store result in cache
    return generated_summary, end_time - start_time
Ecco alcuni punti chiave del codice sopra:
Visto che tutte le funzioni sono pronte, ecco il prompt con cui lavoreremo. Sentiti libero di sperimentare: usa i primi 10.000 caratteri del libro e chiedi al modello di generare un riassunto.
prompt = f"<book>{book_content[:10000]}</book>\nPlease provide a summary of this book."Ora eseguiamo entrambe le chiamate, senza e con cache, per generare il riassunto e mostrare il tempo impiegato e il riassunto per ciascuna tecnica. Se il risultato è in cache, restituisce il riassunto in cache con latenza zero; altrimenti, salva il risultato in cache per usi futuri.
non_cached_response, non_cached_time = make_non_cached_inference(prompt)
print(f"Non-cached inference time: {non_cached_time:.2f} seconds")
print(f"Non-cached summary: {non_cached_response}")
cache = {}

# Cached inference to generate a summary
cached_response, cached_time = make_cached_inference(prompt, cache)
print(f"Cached inference time: {cached_time:.2f} seconds")
print(f"Cached summary: {cached_response}")
Il codice mostra come il caching eviti computazioni ridondanti memorizzando i risultati per query future. Le risposte in cache riducono notevolmente la latenza per i prompt ripetuti, come vedremo nella prossima sezione.
Con il codice sopra, abbiamo sperimentato quattro modelli diversi sui dati definiti.
|
Modello |
Tempo di inferenza senza cache |
Tempo di inferenza con cache |
|
Llama2 |
143,98 secondi |
65,84 secondi |
|
Llama3 |
151,79 secondi |
42,48 secondi |
|
Gemma2 |
170,43 secondi |
61,84 secondi |
|
Phi3 |
239,55 secondi |
100,86 secondi |
Sulla base dei tempi di inferenza dei quattro modelli, è evidente che l’inferenza con cache riduce sensibilmente i tempi principali.
Poiché il caching utilizza la memoria del sistema, è importante adottare alcune pratiche che possano ridurre costi e requisiti di memoria.
Individua le aree dell’applicazione in cui vengono usati ripetutamente gli stessi prompt o prompt simili. Questo include domande tipiche dell’assistenza clienti come “Come cambio il PIN del bancomat?”, domande di coding frequenti come “Come scrivere Hello World in Python?” o parti di documenti lunghi come “riassumi questo libro/articolo” consultate spesso. Mettere in cache le risposte a questi prompt massimizzerà l’efficienza.
Mantenere una struttura coerente quando invii prompt a un LLM aiuta a migliorare il tasso di cache hit. Un buon formato può includere un input conciso seguito da esempi. Se le istruzioni sono coerenti, aumenta la probabilità di trovare prompt in cache uguali o simili.
Una cache ben gestita bilancia vincoli di memoria e necessità prestazionali senza gonfiare memoria e costi. In base ai requisiti dell’applicazione, impostare una dimensione ottimale e una politica di espulsione (come LRU) garantisce efficienza senza sprechi di memoria.
Monitorare i tassi di cache hit è fondamentale per valutare l’efficacia della strategia di caching. Se il tasso è basso, considera di regolare le soglie di similarità, aumentare la dimensione della cache o rendere più coerenti i prompt per adattarli meglio all’input.
Le pratiche di caching di cui sopra si integrano con le migliori pratiche di archiviazione per far girare le applicazioni in modo ottimale. Vediamo ora alcune tecniche di archiviazione e condivisione della cache.
I prompt in cache possono essere archiviati localmente (su una singola macchina) o distribuiti su più server. Le cache locali sono più semplici da gestire ma possono faticare su larga scala. Al contrario, le cache distribuite possono servire un’utenza molto più ampia e gestire carichi maggiori, a fronte però di maggiore complessità e costi.
Per organizzazioni con più utenti o applicazioni, condividere i prompt in cache tra sistemi può ridurre i costi e migliorare le prestazioni offrendo accesso centralizzato su dispositivi e utenti a costi minimi. Centralizzando la cache, tutti possono beneficiare di risposte già memorizzate, evitando calcoli ridondanti.
La privacy è un aspetto chiave quando si memorizzano dati in cache, in particolare input e risposte degli utenti. I dati sensibili dovrebbero essere cifrati e dovrebbero esistere controlli di accesso per garantire che solo gli utenti autorizzati possano accedere alla cache. Si utilizzano vari algoritmi di cifratura per proteggere i dati dell’utente. Un’altra pratica sempre più diffusa è svolgere i calcoli su dispositivi locali, così che i dati non lascino mai il device.
In ambienti in cui i prompt in cache sono condivisi tra più utenti o applicazioni, tecniche come cache warm-up e keep-alive ping aiutano a mantenere disponibilità e freschezza dei dati condivisi, riducendo le probabilità di cache miss e garantendo un’esperienza utente rapida e coerente sulla rete. Vediamole meglio.
Un modo per assicurarsi che la cache sia sempre popolata con dati rilevanti è “riscaldarla” pre-popolandola con prompt comuni. È utile per ridurre la latenza nelle prime interazioni dopo l’avvio del sistema. Per esempio, in un chatbot e-commerce, domande frequenti come “Qual è la vostra politica sui resi?” o “Dov’è il mio ordine?” possono essere precaricate per risposte istantanee fin da subito. Il cache warm-up è utile anche dopo riavvii, aggiornamenti o deploy, per evitare il cold start in cui la cache è vuota e le risposte iniziali sono più lente.
Per evitare che le voci in cache scadano per inattività, si possono inviare periodicamente keep-alive ping per mantenere freschi e disponibili più a lungo i prompt popolari. I keep-alive ping aggiornano periodicamente voci specifiche, in particolare quelle legate a prompt di alto valore o molto richiesti, così che restino fresche e disponibili anche se non sono state usate di recente.
Questo è particolarmente utile in applicazioni con picchi ciclici di traffico, come aumenti stagionali nelle richieste e-commerce o picchi orari nell’assistenza clienti.
L’ottimizzazione dei costi è centrale in qualsiasi applicazione basata su IA, dal numero di chiamate API all’uso complessivo di memoria.
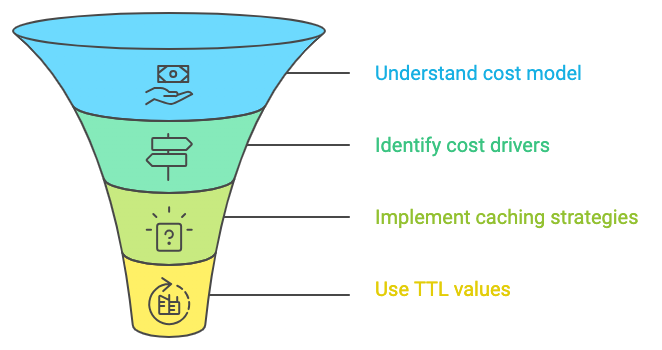
Nel lavorare con numerosi esempi di caching, potremmo imbatterci in alcuni problemi risolvibili facilmente. Eccone alcuni:
Un cache miss si verifica quando un prompt non si trova in cache. Può accadere per strutture di prompt incoerenti o soglie di similarità troppo restrittive. Per risolvere, rivedi i prompt per coerenza e regola la soglia di similarità per consentire piccole variazioni. Immagina un chatbot di assistenza clienti che riceve spesso “Qual è la vostra politica di rimborso?” e mette in cache la risposta. Se un utente chiede “Mi parli della vostra politica sui resi?” e la soglia è troppo rigida, il sistema non riconoscerà la similarità, causando un cache miss.
L’invalidazione è necessaria quando cambiano i dati sottostanti o il modello. Puoi impostare politiche di invalidazione automatica per aggiornare le voci in cache o implementare invalidazioni manuali per voci specifiche quando serve. Per esempio, un’app finanziaria mette in cache risposte relative alle normative fiscali. Se le leggi cambiano, le risposte in cache diventano obsolete. Il sistema può avere una politica di invalidazione automatica che aggiorna o svuota la cache dopo un aggiornamento normativo.
In questo articolo abbiamo esplorato il concetto di prompt caching e la sua implementazione con Ollama. Abbiamo mostrato come il prompt caching possa ridurre in modo significativo i tempi di inferenza e i costi associati agli LLM.
Impara l’IA con questi corsi!
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



