
Last chance! 50% off DataCamp Premium
Sale ends in
Về cốt lõi, prompt caching hoạt động bằng cách lưu prompt và phản hồi tương ứng vào bộ nhớ đệm. Khi cùng một prompt hoặc prompt tương tự được gửi lại, hệ thống sẽ truy xuất phản hồi đã cache thay vì tạo mới. Điều này tránh tính toán lặp lại, tăng tốc thời gian phản hồi và giảm chi phí.
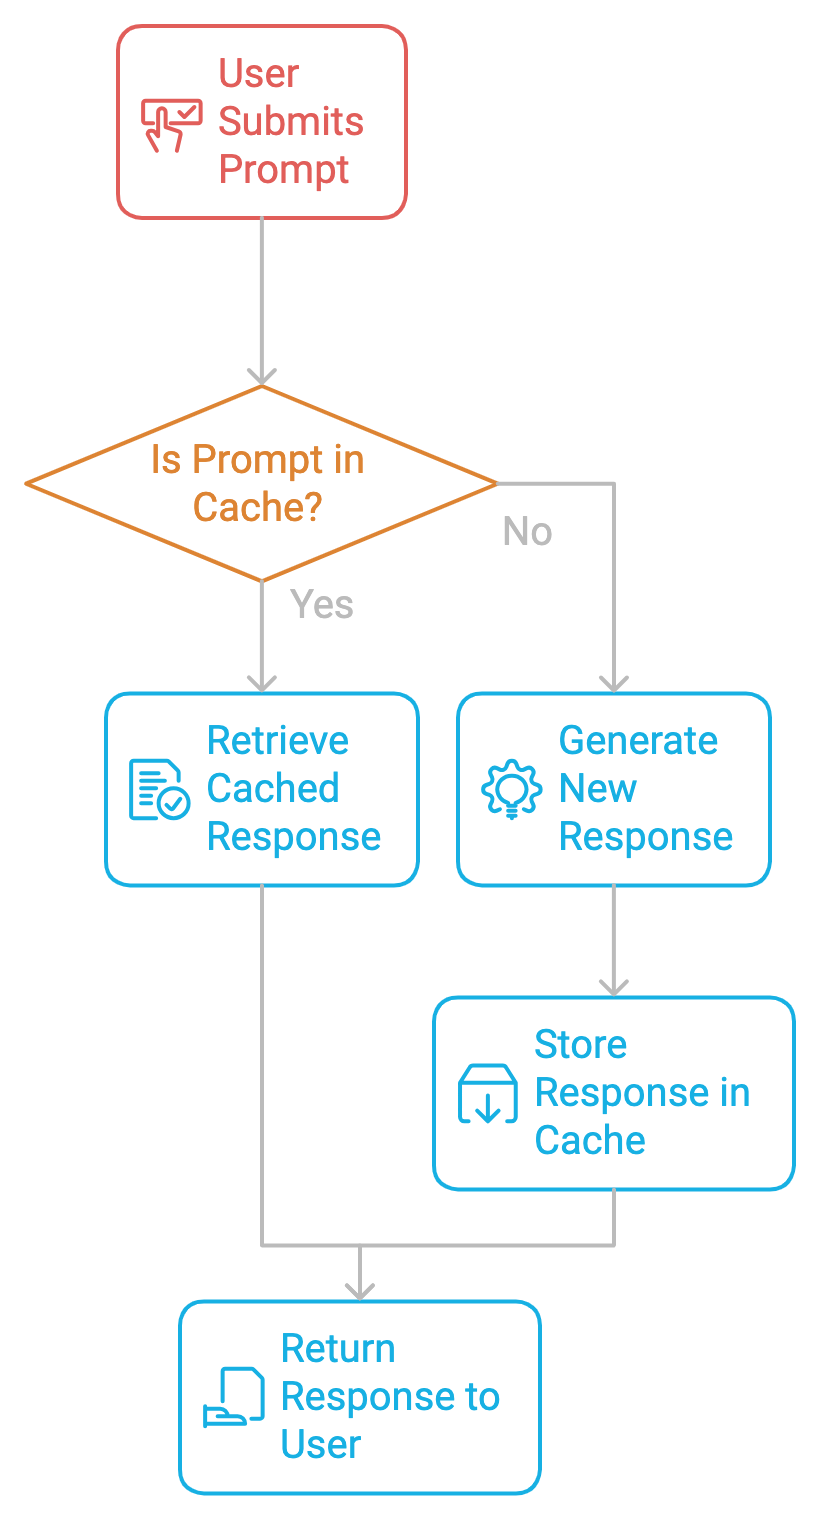
Prompt caching có một số lợi ích:
Trước khi đi sâu vào triển khai prompt caching, chúng ta cần ghi nhớ một vài điểm.
Để đảm bảo tính mới của dữ liệu, mỗi phản hồi được cache nên có thời gian sống (Time-to-Live, TTL) trong bộ nhớ. TTL xác định khoảng thời gian phản hồi cache được coi là hợp lệ. Khi TTL hết hạn, mục cache bị xóa hoặc cập nhật, và prompt tương ứng sẽ được tính toán lại lần tới khi được yêu cầu.
Cơ chế này bảo đảm cache không lưu thông tin lỗi thời. Với nội dung tĩnh hoặc ít cập nhật, như tài liệu pháp lý hay sổ tay sản phẩm, TTL dài hơn có thể giúp giảm tái tính toán mà không làm dữ liệu cũ. Vì vậy, tinh chỉnh TTL phù hợp là thiết yếu để cân bằng giữa độ tươi dữ liệu và hiệu quả tính toán.
Đôi khi hai prompt tương tự nhưng không giống hệt. Xác định mức độ gần của prompt mới với prompt đã cache là then chốt để cache hiệu quả. Triển khai độ tương tự prompt cần các kỹ thuật như fuzzy matching hoặc tìm kiếm ngữ nghĩa, nơi hệ thống dùng vector embedding để biểu diễn prompt và so sánh mức tương tự.
Bằng cách cache phản hồi cho các prompt tương tự, hệ thống có thể giảm tái tính toán trong khi vẫn đảm bảo độ chính xác cao. Tuy nhiên, đặt ngưỡng tương tự quá lỏng có thể gây sai khớp, còn quá chặt có thể bỏ lỡ cơ hội cache.
Các chiến lược như Least Recently Used (LRU) giúp quản lý kích thước cache. LRU loại bỏ dữ liệu ít được truy cập nhất khi cache đạt dung lượng. Chiến lược này phù hợp khi một số prompt phổ biến cần được giữ lại, còn truy vấn ít gặp có thể loại bỏ để nhường chỗ cho yêu cầu mới.
Triển khai prompt caching gồm hai bước.
Bước đầu là xác định các prompt lặp lại thường xuyên trong hệ thống. Dù xây dựng chatbot, trợ lý lập trình hay bộ xử lý tài liệu, chúng ta cần theo dõi prompt nào bị lặp. Khi đã xác định, có thể cache để tránh tính toán dư thừa.
Khi một prompt được nhận diện, phản hồi của nó sẽ được lưu vào cache cùng siêu dữ liệu như thời gian sống (TTL), tỷ lệ trúng/trượt cache, v.v. Bất cứ khi nào người dùng gửi lại cùng prompt, hệ thống sẽ truy xuất phản hồi đã cache, bỏ qua quá trình sinh tốn kém.
Sau phần lý thuyết, hãy đi vào ví dụ thực hành với Ollama để khám phá tác động của việc có cache so với không cache trong môi trường cục bộ. Ở đây, chúng ta dùng dữ liệu từ một cuốn sách deep learning được lưu trữ trên web và các mô hình cục bộ để tóm tắt vài trang đầu. Chúng ta sẽ thử nghiệm với nhiều LLM, gồm Gemma2, Llama2 và Llama3, để so sánh hiệu năng.
Trong ví dụ thực hành này, chúng ta sẽ dùng BeautifulSoup, một gói Python để phân tích tài liệu HTML và XML, kể cả khi đánh dấu bị lỗi. Để cài đặt BeautifulSoup, chạy lệnh sau:
!pip install BeautifulSoupMột công cụ khác chúng ta sẽ dùng là Ollama. Nó đơn giản hóa việc cài đặt và quản lý các mô hình ngôn ngữ lớn trên hệ thống cục bộ.
Để bắt đầu, tải về và cài đặt Ollama trên máy tính của bạn. Chúng ta có thể thay đổi tên mô hình theo nhu cầu. Xem thư viện trên trang chính thức của Ollama để tìm các mô hình được hỗ trợ. Chạy đoạn mã sau trong terminal:
ollama run llama3.1 Mọi thứ đã sẵn sàng. Bắt đầu thôi!
Chúng ta bắt đầu với các import sau:
time để theo dõi thời gian suy luận cho mã có cache và không cacherequests để gửi yêu cầu HTTP và lấy dữ liệu từ trang webBeautifulSoup để phân tích và làm sạch nội dung HTMLOllama để dùng LLM cục bộimport time
import requests
from bs4 import BeautifulSoup
import ollamaTrong đoạn mã dưới đây, chúng ta định nghĩa hàm fetch_article_content để truy xuất và làm sạch văn bản từ một URL cho trước. Hàm cố gắng lấy nội dung trang bằng thư viện requests, với tối đa ba lần thử phòng trường hợp lỗi mạng hoặc sự cố máy chủ.
Hàm dùng BeautifulSoup để phân tích nội dung HTML và loại bỏ các thẻ <script> và <style> không cần thiết. Văn bản tiếp tục được xử lý bằng cách loại bỏ khoảng trắng đầu/cuối, tách dòng và ghép lại thành các đoạn sạch. Nếu đặt giới hạn nội dung, hàm sẽ cắt văn bản theo giới hạn đó. Nếu tất cả lần thử đều thất bại, hàm ném ngoại lệ sau khoảng dừng ngắn giữa các lần thử.
Một vài tham số chính cần hiểu:
BeautifulSoup để loại bỏ các phần tử như thẻ <script> và <style>.def fetch_article_content(url, retries=3, content_limit=None):
attempt = 0
while attempt < retries:
try:
response = requests.get(url, timeout=30) # Add timeout to prevent hanging
response.raise_for_status() # Raise an error for bad responses (4xx, 5xx)
soup = BeautifulSoup(response.content, 'html.parser')
# Remove script and style elements
for script in soup(["script", "style"]):
script.decompose()
# Get text
text = soup.get_text()
# Break into lines and remove leading and trailing space on each
lines = (line.strip() for line in text.splitlines())
chunks = (phrase.strip() for line in lines for phrase in line.split(" "))
text = '\n'.join(chunk for chunk in chunks if chunk)
# Limit content if specified
if content_limit:
text = text[:content_limit]
return text
except (requests.exceptions.RequestException, requests.exceptions.ChunkedEncodingError) as e:
attempt += 1
print(f"Attempt {attempt} failed: {e}")
if attempt >= retries:
raise
time.sleep(2) # Wait before retryingTiếp theo, chúng ta lấy nội dung từ một cuốn sách để suy luận. Ở đây, dùng URL của sách deep learning của Ian Goodfellow, Yoshua Bengio và Aaron Courville với hàm fetch_article_content để trích 200.000 ký tự đầu. Ta in ra 500 ký tự đầu làm bản xem trước.
book_url = "https://www.deeplearningbook.org/contents/intro.html"
book_content = fetch_article_content(book_url, content_limit=200000)
print(f"Fetched {len(book_content)} characters from the book.")
print("First 500 characters:")
print(book_content[:500])Giờ đây dữ liệu đã được trích xuất và làm sạch. Tiếp theo, chúng ta thực hiện suy luận không cache bằng Llama3 qua Ollama. Có nhiều mô hình ngôn ngữ qua Ollama để thử nghiệm cục bộ.
Với suy luận không cache, chúng ta tạo bản tóm tắt sách mà không dùng cache. Bắt đầu bằng cách đặt thời điểm bắt đầu và sinh phản hồi bằng hàm ollama.generate(). Khi phản hồi được tạo, dùng hàm response.get() để kiểm tra và trích tóm tắt.
Lưu ý: Chúng ta chỉ tính thời gian tạo phản hồi (tức là trước và sau hàm generate()).
def make_non_cached_inference(prompt):
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure
    print(f"Full response: {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    return generated_summary, end_time - start_time
Một vài điểm chính từ đoạn mã trên:
llama3) và nhận phản hồi..get() để tránh KeyError).Sau phần không cache, chúng ta thử suy luận có cache. Hàm sau đây tạo bản tóm tắt sách bằng kết quả đã cache nếu có. Giống bước trước, ta tạo phản hồi bằng cùng đoạn mã. Điểm khác biệt là kiểm tra sớm xem prompt đã có trong cache chưa. Nếu rồi, mô hình không suy luận mà dùng phản hồi cache; nếu chưa, lưu kết quả vào cache để dùng sau.
def make_cached_inference(prompt, cache):
    if prompt in cache:
        print("Using cached result...")
        return cache[prompt], 0  # Return cached response with 0 latency
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure (if needed)
    print(f"Full response (cached call): {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    cache[prompt] = generated_summary  # Store result in cache
    return generated_summary, end_time - start_time
Một vài điểm chính từ đoạn mã trên:
Vì các hàm đã sẵn sàng, dưới đây là prompt mà chúng ta sẽ dùng. Bạn có thể thoải mái thử nghiệm. Prompt sử dụng 10.000 ký tự đầu của cuốn sách và yêu cầu mô hình tạo bản tóm tắt.
prompt = f"<book>{book_content[:10000]}</book>\nPlease provide a summary of this book."Giờ chúng ta thực hiện cả hai lời gọi suy luận không cache và có cache để tạo bản tóm tắt và hiển thị thời gian cùng kết quả cho mỗi kỹ thuật. Nếu kết quả đã cache, sẽ trả về tóm tắt với độ trễ bằng không; nếu chưa, lưu kết quả vào cache cho lần sau.
non_cached_response, non_cached_time = make_non_cached_inference(prompt)
print(f"Non-cached inference time: {non_cached_time:.2f} seconds")
print(f"Non-cached summary: {non_cached_response}")
cache = {}

# Cached inference to generate a summary
cached_response, cached_time = make_cached_inference(prompt, cache)
print(f"Cached inference time: {cached_time:.2f} seconds")
print(f"Cached summary: {cached_response}")
Đoạn mã minh họa cách cache giúp tránh tính toán lặp bằng cách lưu kết quả cho các truy vấn sau. Kết quả đã cache dẫn tới độ trễ giảm đáng kể cho prompt lặp lại, điều mà chúng ta sẽ quan sát ở phần tiếp theo.
Với đoạn mã trên, chúng ta đã thử nghiệm bốn mô hình khác nhau trên tập dữ liệu đã định.
|
Mô hình |
Thời gian suy luận không cache |
Thời gian suy luận có cache |
|
Llama2 |
143,98 giây |
65,84 giây |
|
Llama3 |
151,79 giây |
42,48 giây |
|
Gemma2 |
170,43 giây |
61,84 giây |
|
Phi3 |
239,55 giây |
100,86 giây |
Dựa trên thời gian suy luận từ các thí nghiệm với bốn mô hình này, có thể thấy suy luận có cache làm giảm thời gian suy luận một cách rõ rệt.
Vì cache tiêu tốn bộ nhớ hệ thống, cần cân nhắc một số thực hành giúp giảm chi phí và yêu cầu bộ nhớ.
Xác định khu vực ứng dụng nơi các prompt giống nhau hoặc tương tự được dùng lặp lại. Điều này có thể gồm các câu hỏi CSKH phổ biến như “Cách đổi mã PIN ATM?”, câu hỏi lập trình thường gặp như “Cách viết Hello World trong Python?”, hoặc các phần của tài liệu dài như “tóm tắt cuốn sách/bài báo này” thường xuyên được xem lại. Cache phản hồi cho các prompt này sẽ tối đa hóa hiệu quả.
Duy trì cấu trúc nhất quán khi gửi prompt tới LLM giúp cải thiện tỷ lệ trúng cache. Một cấu trúc chuẩn có thể gồm đầu vào ngắn gọn của người dùng kèm ví dụ. Nếu hướng dẫn nhất quán, khả năng tìm thấy prompt đã cache khớp hoặc tương tự sẽ tăng.
Một cache được quản lý tốt cân bằng ràng buộc bộ nhớ và nhu cầu hiệu năng mà không phình to chi phí. Tùy yêu cầu ứng dụng, đặt kích thước cache tối ưu và chính sách loại bỏ (như LRU) sẽ đảm bảo hiệu năng mà không lãng phí bộ nhớ.
Theo dõi tỷ lệ trúng cache là yếu tố then chốt để đánh giá hiệu quả chiến lược cache. Nếu tỷ lệ thấp, hãy cân nhắc điều chỉnh ngưỡng tương tự, tăng kích thước cache hoặc cải thiện tính nhất quán của prompt để phù hợp hơn với đầu vào.
Các thực hành cache trên được tích hợp với một số thực hành lưu trữ tốt để vận hành ứng dụng ở mức tối ưu. Tiếp theo, chúng ta sẽ khám phá một số kỹ thuật lưu trữ và chia sẻ cache.
Prompt đã cache có thể lưu cục bộ (trên một máy) hoặc phân tán trên nhiều máy chủ. Cache cục bộ dễ quản lý hơn nhưng có thể gặp khó với ứng dụng quy mô lớn. Ngược lại, cache phân tán có thể phục vụ lượng người dùng lớn hơn và tải cao hơn nhưng đi kèm độ phức tạp và chi phí tăng.
Với các tổ chức có nhiều người dùng hoặc ứng dụng, chia sẻ prompt đã cache giữa các hệ thống có thể giúp giảm chi phí và cải thiện hiệu năng bằng cách cung cấp truy cập tập trung trên thiết bị và người dùng với chi phí tối thiểu. Bằng cách tập trung cache, mọi người dùng có thể hưởng lợi từ phản hồi lưu trước, tránh tính toán lặp.
Quyền riêng tư là mối quan tâm chính khi lưu dữ liệu cache, đặc biệt là đầu vào và phản hồi của người dùng. Dữ liệu nhạy cảm nên được mã hóa và có kiểm soát truy cập để chỉ người có thẩm quyền mới truy cập được cache. Nhiều thuật toán mã hóa được dùng để bảo vệ dữ liệu người dùng. Một thực hành phổ biến khác gần đây là thực hiện tính toán trên thiết bị cục bộ để dữ liệu không rời khỏi thiết bị.
Trong môi trường nơi prompt được cache được chia sẻ giữa nhiều người dùng hoặc ứng dụng, các kỹ thuật như làm ấm cache và keep-alive ping giúp duy trì tính sẵn sàng và độ tươi của dữ liệu chia sẻ, giảm khả năng trượt cache và đảm bảo trải nghiệm người dùng nhanh, nhất quán trên mạng. Hãy cùng hiểu rõ hơn các kỹ thuật này.
Một cách để đảm bảo cache luôn được điền sẵn dữ liệu phù hợp là “làm ấm” cache bằng cách tiền điền các prompt thường dùng. Kỹ thuật này hữu ích để giảm độ trễ trong vài tương tác đầu sau khi hệ thống khởi chạy. Ví dụ, trong chatbot thương mại điện tử, các câu hỏi thường gặp như “Chính sách đổi trả của bạn là gì?” hoặc “Đơn hàng của tôi ở đâu?” có thể được cache trước để phản hồi tức thì ngay từ đầu. Làm ấm cache cũng hữu ích sau khi khởi động lại hệ thống, cập nhật hoặc triển khai, vì giúp tránh tình trạng khởi động lạnh khi cache trống khiến phản hồi ban đầu chậm hơn.
Để ngăn mục cache hết hạn do không hoạt động, có thể gửi keep-alive ping định kỳ để đảm bảo các prompt đã cache phổ biến vẫn tươi và sẵn sàng trong thời gian dài hơn. Keep-alive ping làm mới định kỳ các mục cache cụ thể, đặc biệt là những mục gắn với prompt giá trị cao hoặc thường được yêu cầu, để hệ thống đảm bảo chúng luôn tươi và sẵn dùng, ngay cả khi gần đây chưa được dùng.
Điều này đặc biệt hữu ích trong các ứng dụng có mẫu lưu lượng theo chu kỳ, như cao điểm theo mùa trong truy vấn thương mại điện tử hoặc giờ cao điểm cho hỗ trợ khách hàng.
Tối ưu chi phí là trọng tâm của mọi ứng dụng dựa trên AI, từ số lượng cuộc gọi API đến tổng bộ nhớ sử dụng.
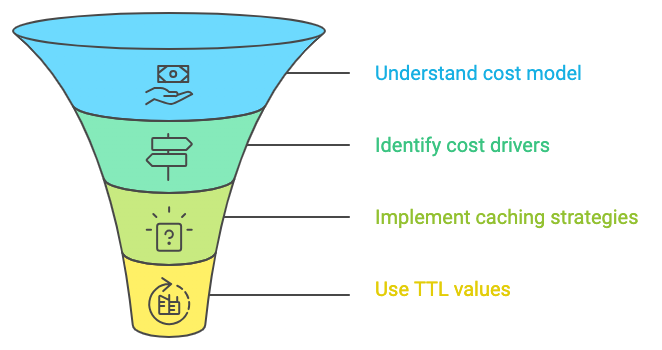
Khi làm việc với nhiều ví dụ về cache, chúng ta có thể gặp một số vấn đề cần cách khắc phục đơn giản. Một vài vấn đề như sau:
Trượt cache xảy ra khi một prompt không tìm thấy trong cache. Điều này có thể do cấu trúc prompt không nhất quán hoặc ngưỡng tương tự quá chặt. Để khắc phục, cần xem lại sự nhất quán của prompt và điều chỉnh ngưỡng tương tự để cho phép biến thể nhỏ. Hãy hình dung chatbot CSKH thường xuyên nhận prompt: "Chính sách hoàn tiền của bạn là gì?" và đã cache phản hồi. Tuy nhiên, nếu người dùng hỏi "Bạn có thể cho tôi biết về chính sách đổi trả không?" và ngưỡng tương tự quá chặt, hệ thống sẽ không nhận ra đây là prompt tương tự, dẫn tới trượt cache.
Cần vô hiệu hóa cache khi dữ liệu nền hoặc mô hình thay đổi. Bạn có thể thiết lập chính sách vô hiệu hóa tự động để làm mới mục cache hoặc triển khai vô hiệu hóa thủ công cho mục cụ thể khi cần. Giả sử một ứng dụng tài chính cache phản hồi liên quan đến quy định thuế. Nếu luật thuế thay đổi, phản hồi đã cache trước đó trở nên lỗi thời. Hệ thống có thể được cấu hình với chính sách vô hiệu hóa tự động, làm mới hoặc xóa cache sau cập nhật quy định.
Trong bài viết này, chúng ta đã khám phá khái niệm prompt caching và cách triển khai với Ollama. Chúng tôi đã chứng minh prompt caching có thể giảm đáng kể thời gian suy luận và chi phí liên quan đến LLM.
Học AI với các khóa này!
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút

