

रैंडम फॉरेस्ट क्लासिफिकेशन कैसे काम करता है
मान लीजिए आपके पास हल करने के लिए एक जटिल समस्या है, और आप विभिन्न क्षेत्रों के विशेषज्ञों का एक समूह उनकी राय देने के लिए एकत्र करते हैं। हर विशेषज्ञ अपनी विशेषज्ञता और अनुभव के आधार पर राय देता है। फिर विशेषज्ञ अंतिम निर्णय तक पहुँचने के लिए मतदान करेंगे।
रैंडम फॉरेस्ट क्लासिफिकेशन में, डेटा और फीचर्स के अलग-अलग रैंडम सबसेट्स का उपयोग करके कई डिसीजन ट्री बनाए जाते हैं। हर डिसीजन ट्री एक विशेषज्ञ की तरह होता है, जो डेटा को कैसे वर्गीकृत करना है इस पर अपनी राय देता है। भविष्यवाणियाँ प्रत्येक डिसीजन ट्री की प्रेडिक्शन निकालकर और फिर सबसे लोकप्रिय नतीजे को चुनकर की जाती हैं। (रिग्रेशन के लिए, भविष्यवाणियाँ औसत निकालने की तकनीक से की जाती हैं।)
नीचे के चित्र में, हमारे पास n डिसीजन ट्री वाला एक रैंडम फॉरेस्ट है, और हमने पहले 5 ट्री उनके पूर्वानुमानों (या तो “Dog” या “Cat”) के साथ दिखाए हैं। हर ट्री को मूल डेटासेट के अलग-अलग फीचर्स और अलग-अलग सैंपल्स दिखते हैं, इसलिए हर ट्री अलग हो सकता है। हर ट्री एक प्रेडिक्शन करता है।
पहले 5 ट्री देखते हुए, हम पाते हैं कि 4/5 ने सैंपल को Cat बताया। हरे गोल घेरों से वह परिकल्पित पथ दिखाया गया है जिससे ट्री अपने निर्णय तक पहुँचा। रैंडम फॉरेस्ट Cat और Dog के लिए डिसीजन ट्री की प्रेडिक्शनों की संख्या गिनेगा और सबसे लोकप्रिय प्रेडिक्शन चुनेगा।
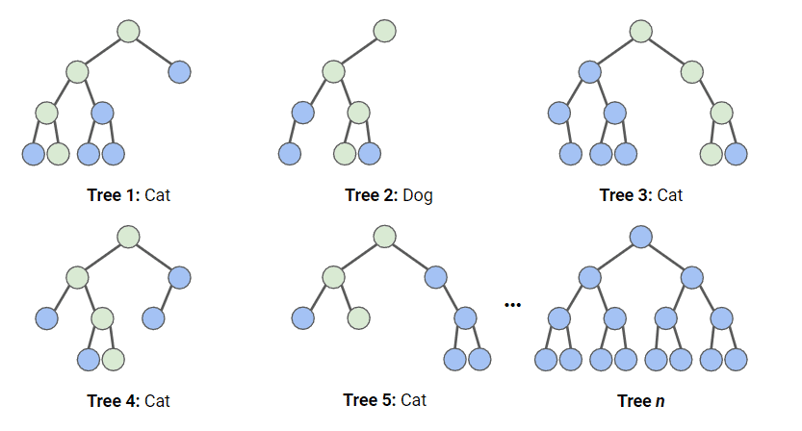 रैंडम फॉरेस्ट क्लासिफिकेशन कैसे काम करता है का चित्रण। छवि: लेखक
डेटासेट लोड करें
यह डेटासेट पुर्तगाल के एक बैंकिंग संस्थान के फोन कॉल द्वारा किए गए डायरेक्ट मार्केटिंग अभियानों से बना है। अभियानों का उद्देश्य बैंक टर्म डिपॉजिट की सदस्यता बेचना था। हम इस डेटासेट को bank_data नामक वेरिएबल में स्टोर करेंगे। जिन कॉलमों का हम उपयोग करेंगे, वे हैं:
-
age: उस व्यक्ति की आयु जिसे फोन कॉल मिला -
default: क्या व्यक्ति के पास डिफ़ॉल्ट में क्रेडिट है -
cons.price.idx: कॉल के समय उपभोक्ता मूल्य सूचकांक स्कोर -
cons.conf.idx: कॉल के समय उपभोक्ता विश्वास सूचकांक स्कोर -
y: क्या व्यक्ति ने सदस्यता ली (यही वह है जिसे हम प्रेडिक्ट करना चाह रहे हैं)
पैकेज इम्पोर्ट करें
इस ट्यूटोरियल में निम्नलिखित पैकेज और फ़ंक्शन्स का उपयोग किया गया है:
# Data Processing
import pandas as pd
import numpy as np
# Modelling
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, confusion_matrix, precision_score, recall_score, ConfusionMatrixDisplay
from sklearn.model_selection import RandomizedSearchCV, train_test_split
from scipy.stats import randint
# Tree Visualisation
from sklearn.tree import export_graphviz
from IPython.display import Image
import graphvizरैंडम फॉरेस्ट वर्कफ़्लो
इस मॉडल को फिट और ट्रेन करने के लिए, हम The Machine Learning Workflow इन्फ़ोग्राफ़िक का अनुसरण करेंगे; हालाँकि, हमारा डेटा काफ़ी साफ़ है, इसलिए हम हर चरण नहीं करेंगे। हम निम्नलिखित करेंगे:
- फ़ीचर इंजीनियरिंग
- डेटा को विभाजित करना
- मॉडल को ट्रेन करना
- हाइपरपैरामीटर ट्यूनिंग
- मॉडल प्रदर्शन का आकलन
हमारे रैंडम फॉरेस्ट क्लासिफायर के लिए डेटा का प्रीप्रोसेसिंग
ट्री-आधारित मॉडल, लीनियर मॉडलों की तुलना में आउटलाईयर्स के प्रति अधिक मज़बूत होते हैं, और इन्हें काम करने के लिए वेरिएबल्स का नॉर्मलाइज़ होना आवश्यक नहीं है। इसलिए हमें अपने डेटा पर बहुत कम प्रीप्रोसेसिंग करनी है।
-
हम अपने
defaultकॉलम, जिसमेंnoऔरyesहैं, को क्रमशः0और1में मैप करेंगे। इस उदाहरण में हमunknownमानों कोnoमानेंगे। -
हम अपने टारगेट
yको भी1और0में मैप करेंगे।
bank_data['default'] = bank_data['default'].map({'no':0,'yes':1,'unknown':0})
bank_data['y'] = bank_data['y'].map({'no':0,'yes':1})डेटा को विभाजित करना
किसी भी सुपरवाइज़्ड लर्निंग मॉडल को ट्रेन करते समय, डेटा को ट्रेनिंग और टेस्ट डेटा में बाँटना महत्वपूर्ण है। ट्रेनिंग डेटा का उपयोग मॉडल को फिट करने के लिए किया जाता है। एल्गोरिथ्म फीचर्स और टारगेट के बीच संबंध सीखने के लिए ट्रेनिंग डेटा का उपयोग करता है। टेस्ट डेटा का उपयोग मॉडल के प्रदर्शन का मूल्यांकन करने के लिए किया जाता है।
नीचे दिया गया कोड फीचर्स और टारगेट के लिए डेटा को अलग-अलग वेरिएबल्स में विभाजित करता है, फिर उन्हें ट्रेनिंग और टेस्ट डेटा में बाँटता है।
# Split the data into features (X) and target (y)
X = bank_data.drop('y', axis=1)
y = bank_data['y']
# Split the data into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y)रैंडम फॉरेस्ट मॉडल को फिट करना और मूल्यांकन करना
हम पहले डिफ़ॉल्ट पैरामीटर्स के साथ रैंडम फॉरेस्ट मॉडल का एक इंस्टेंस बनाते हैं। फिर इसे अपने ट्रेनिंग डेटा पर फिट करते हैं। हम फीचर्स और टारगेट वेरिएबल दोनों पास करते हैं ताकि मॉडल सीख सके।
rf = RandomForestClassifier()
rf.fit(X_train, y_train)इस बिंदु पर, हमारे पास एक प्रशिक्षित रैंडम फॉरेस्ट मॉडल है, लेकिन हमें यह पता लगाना है कि क्या यह सटीक भविष्यवाणियाँ करता है।
y_pred = rf.predict(X_test)इस मॉडल का मूल्यांकन करने का सबसे सरल तरीका एक्युरेसी का उपयोग करना है; हम प्रेडिक्शनों की तुलना टेस्ट सेट में वास्तविक मूल्यों से करते हैं और गिनते हैं कि मॉडल ने कितने सही बताए।
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)आउटपुट:
Accuracy: 0.888यह काफ़ी अच्छा स्कोर है! हालाँकि, हम अपने हाइपरपैरामीटर्स का अनुकूलन करके और बेहतर कर सकते हैं।
नोट: केवल एक्युरेसी असंतुलित डेटा पर भ्रामक हो सकती है। फ़ॉल्स-पॉज़िटिव और फ़ॉल्स-नेगेटिव के बीच संतुलन समझने के लिए हमेशा प्रिसीज़न और रिकॉल भी जाँचें।
परिणामों का विज़ुअलाइज़ेशन
हम निम्नलिखित कोड का उपयोग करके अपने पहले 3 ट्रीज़ को विज़ुअलाइज़ कर सकते हैं।
# Export the first three decision trees from the forest
for i in range(3):
tree = rf.estimators_[i]
dot_data = export_graphviz(tree,
feature_names=X_train.columns,
filled=True,
max_depth=2,
impurity=False,
proportion=True)
graph = graphviz.Source(dot_data)
display(graph)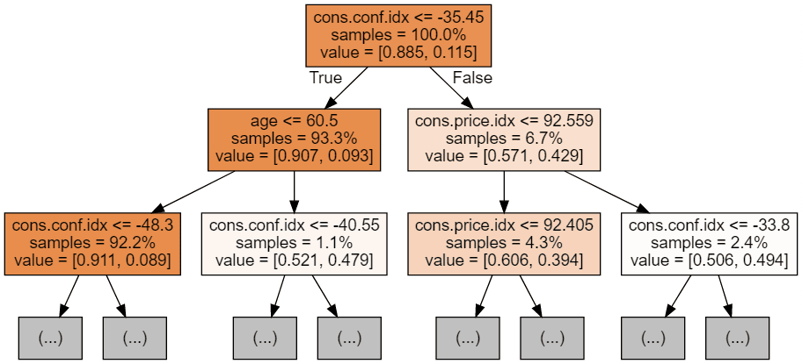
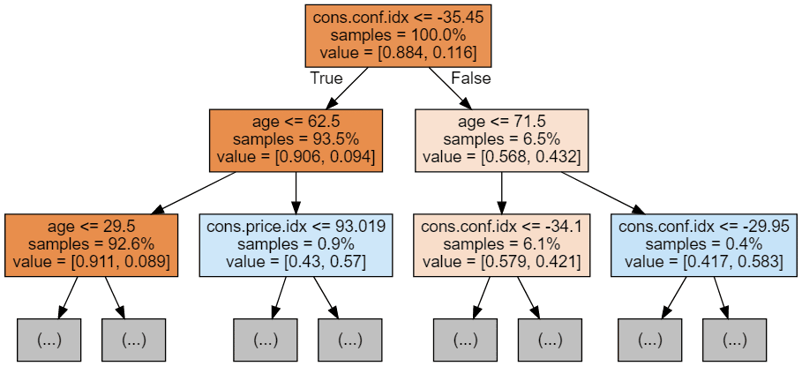
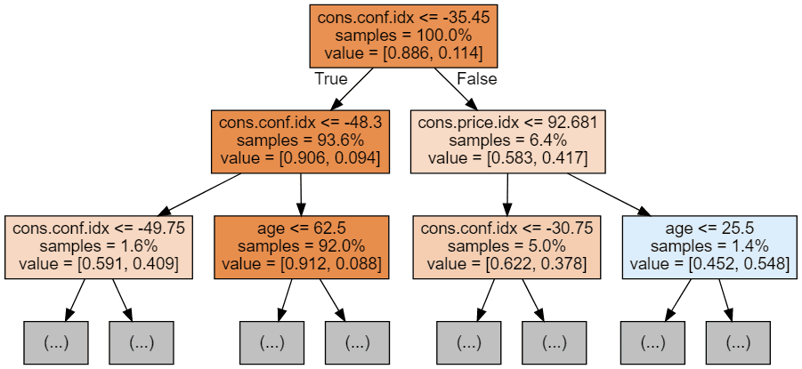
प्रत्येक ट्री की छवि केवल शुरुआती कुछ नोड्स तक सीमित है। ये ट्री बहुत बड़े और विज़ुअलाइज़ करने में कठिन हो सकते हैं। रंग हर नोड (बॉक्स) की बहुसंख्यक क्लास को दर्शाते हैं, जहाँ लाल रंग बहुसंख्यक 0 (नो सब्सक्रिप्शन) और नीला रंग बहुसंख्यक 1 (सब्सक्रिप्शन) को इंगित करता है। नोड जितना पूर्ण रूप से 0 या 1 के करीब होता है, रंग उतना गहरा होता जाता है। प्रत्येक नोड में निम्नलिखित जानकारी भी होती है:
- स्प्लिटिंग के लिए उपयोग किया गया वेरिएबल नाम और मान
- हर स्प्लिट में कुल सैंपल का %
- हर स्प्लिट में क्लासों के बीच % विभाजन
हाइपरपैरामीटर ट्यूनिंग
नीचे दिया गया कोड Scikit-Learn के RandomizedSearchCV का उपयोग करता है, जो प्रति हाइपरपैरामीटर एक रेंज के भीतर रैंडम रूप से पैरामीटर्स खोजेगा। हम param_dist डिक्शनरी में उपयोग करने के लिए हाइपरपैरामीटर्स और उनकी रेंज परिभाषित करते हैं। हमारे मामले में, हम उपयोग कर रहे हैं:
-
n_estimators: फॉरेस्ट में डिसीजन ट्री की संख्या। इसे बढ़ाने से आम तौर पर मॉडल का प्रदर्शन बेहतर होता है, लेकिन ट्रेनिंग और प्रेडिक्शन की संगणना लागत भी बढ़ती है।
-
max_depth: फॉरेस्ट में प्रत्येक डिसीजन ट्री की अधिकतम गहराई।
max_depthका मान बहुत अधिक रखने से ओवरफिटिंग हो सकती है, जबकि बहुत कम रखने से अंडरफिटिंग हो सकती है।
param_dist = {
'n_estimators': randint(100, 500),
'max_depth': randint(3, 15),
'min_samples_split': randint(2, 10),
'min_samples_leaf': randint(1, 5)
}
# Create a random forest classifier
rf = RandomForestClassifier(random_state=42, n_jobs=-1)
# Use random search to find the best hyperparameters
rand_search = RandomizedSearchCV(
rf, param_distributions=param_dist,
n_iter=10, cv=5, scoring='accuracy',
n_jobs=-1, random_state=42
RandomizedSearchCV कई मॉडलों को ट्रेन करेगा (जिसे n_iter_ द्वारा परिभाषित किया गया है) और प्रत्येक को एक वेरिएबल के रूप में सेव करेगा। नीचे दिया गया कोड सर्वश्रेष्ठ मॉडल के लिए एक वेरिएबल बनाता है और हाइपरपैरामीटर्स प्रिंट करता है।
इस मामले में, हमने फ़ंक्शन को कोई स्कोरिंग सिस्टम पास नहीं किया है, इसलिए यह डिफ़ॉल्ट रूप से एक्युरेसी लेता है। यह फ़ंक्शन क्रॉस-वैलिडेशन का भी उपयोग करता है, यानी यह डेटा को पाँच समान आकार के समूहों में बाँटता है और 4 पर ट्रेन करता है तथा 1 पर नतीजा टेस्ट करता है। यह प्रत्येक समूह के लिए लूप करेगा और एक्युरेसी स्कोर देगा, जिसे औसत कर सर्वश्रेष्ठ मॉडल निकाला जाता है।
# Create a variable for the best model
best_rf = rand_search.best_estimator_
# Print the best hyperparameters
print('Best hyperparameters:', rand_search.best_params_)आउटपुट:
Best hyperparameters: {'max_depth': 5, 'n_estimators': 260}अधिक रैंडम फॉरेस्ट मूल्यांकन मेट्रिक्स
आइए कन्फ्यूज़न मैट्रिक्स देखें। यह दर्शाता है कि मॉडल ने क्या प्रेडिक्ट किया बनाम सही प्रेडिक्शन क्या था। हम इसका उपयोग फ़ॉल्स पॉज़िटिव (ऊपर दाएँ) और फ़ॉल्स नेगेटिव (नीचे बाएँ) के बीच संतुलन समझने के लिए कर सकते हैं। हम निम्न कोड का उपयोग करके कन्फ्यूज़न मैट्रिक्स प्लॉट कर सकते हैं:
# Generate predictions with the best model
y_pred = best_rf.predict(X_test)
# Create the confusion matrix
cm = confusion_matrix(y_test, y_pred)
ConfusionMatrixDisplay(confusion_matrix=cm).plot();आउटपुट:
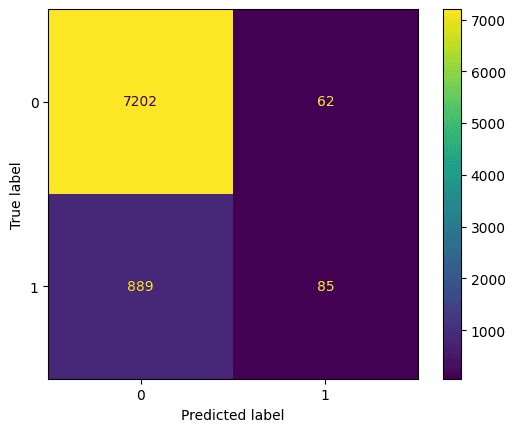
कन्फ्यूज़न मैट्रिक्स का उपयोग करके रैंडम फॉरेस्ट क्लासिफायर मूल्यांकन। छवि: लेखक
हमें सर्वश्रेष्ठ मॉडल का एक्युरेसी, प्रिसीज़न, और रिकॉल से भी मूल्यांकन करना चाहिए (ध्यान दें कि रैंडमाइज़ेशन के कारण आपके परिणाम भिन्न हो सकते हैं)
y_pred = knn.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
print("Accuracy:", accuracy)
print("Precision:", precision)
print("Recall:", recall)आउटपुट:
Accuracy: 0.885
Precision: 0.578
Recall: 0.0873नीचे दिया गया कोड प्रत्येक फीचर के महत्व को प्लॉट करता है, जो मॉडल के आंतरिक स्कोर का उपयोग करके हर डिसीजन ट्री के भीतर डेटा को बाँटने के सर्वोत्तम तरीकों का पता लगाता है।
# Create a series containing feature importances from the model and feature names from the training data
importances = pd.Series(best_rf.feature_importances_, index=X_train.columns)
importances.sort_values(ascending=False).plot.bar()
यह बताता है कि कॉल के समय उपभोक्ता विश्वास सूचकांक यह भविष्यवाणी करने में सबसे बड़ा कारक था कि व्यक्ति ने सदस्यता ली या नहीं।
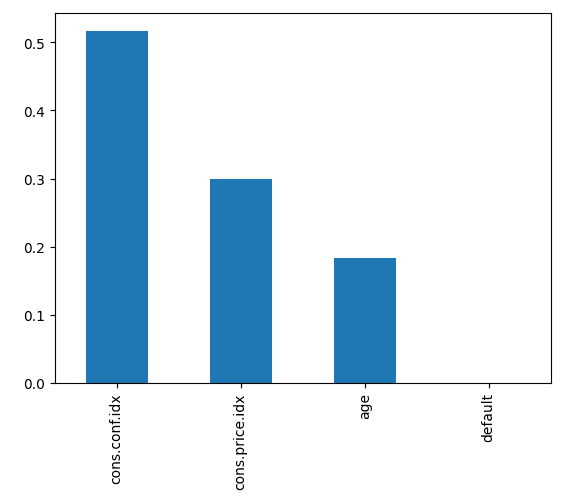
रैंडम फॉरेस्ट क्लासिफायर के फीचर्स, महत्व के क्रम में। छवि: लेखक
रैंडम फॉरेस्ट कब उपयोग करें (और कब नहीं)
जब आपको एक मज़बूत बेसलाइन मॉडल चाहिए जो बॉक्स से बाहर ही अच्छे से काम करे, तो रैंडम फॉरेस्ट बेहतरीन विकल्प है। यह संख्यात्मक और श्रेणीबद्ध दोनों फीचर्स संभालता है, मिसिंग वैल्यूज़ को सहजता से मैनेज करता है, और अकेले डिसीजन ट्री की तुलना में ओवरफिटिंग की प्रवृत्ति कम होती है।
रैंडम फॉरेस्ट का उपयोग करें जब:
- आपके पास टैबुलर डेटा हो जिसमें मिश्रित फीचर प्रकार हों
- आप बिना भारी फीचर स्केलिंग या प्रीप्रोसेसिंग के मज़बूत मॉडल चाहते हों
- व्याख्येयता (फ़ीचर इम्पॉर्टेंस के माध्यम से) आपके उपयोग के लिए महत्वपूर्ण हो
हालाँकि, रैंडम फॉरेस्ट आदर्श नहीं हो सकता जब:
- आपको रीयल-टाइम प्रेडिक्शंस चाहिए; ये एकल मॉडलों की तुलना में धीमे हो सकते हैं
- आप बहुत उच्च-आयामी डेटा (जैसे, टेक्स्ट या इमेज) से निपट रहे हों
- आप संरचित डेटा पर स्टेट-ऑफ़-द-आर्ट एक्युरेसी चाहते हों, जहाँ ग्रेडिएंट बूस्टिंग विधियाँ जैसे XGBoost या LightGBM अक्सर इन्हें पीछे छोड़ देती हैं
अगले स्तर पर जाएँ
Python में सुपरवाइज़्ड मशीन लर्निंग शुरू करने के लिए, Supervised Learning with scikit-learn लें। रैंडम फॉरेस्ट और अन्य ट्री-आधारित मशीन लर्निंग मॉडलों के बारे में अधिक जानने के लिए हमारे Machine Learning with Tree-Based Models in Python और Ensemble Methods in Python कोर्स देखें।
रैंडम फॉरेस्ट FAQs
रैंडम फॉरेस्ट क्लासिफिकेशन क्या है?
रैंडम फॉरेस्ट क्लासिफिकेशन एक एंसेंबल मशीन लर्निंग एल्गोरिथ्म है जो डेटा को वर्गीकृत करने के लिए कई डिसीजन ट्री का उपयोग करता है। विभिन्न डिसीजन ट्री की प्रेडिक्शनों को एकत्र करके, यह ओवरफिटिंग को कम करता है और एक्युरेसी में सुधार करता है।
रैंडम फॉरेस्ट ओवरफिटिंग को कैसे रोकता है?
रैंडम फॉरेस्ट डेटा और फीचर्स के अलग-अलग सबसेट्स का उपयोग करके कई डिसीजन ट्री बनाकर ओवरफिटिंग को कम करता है। फिर यह प्रेडिक्शनों का औसत/वोट लेता है, जिससे मॉडल अधिक सामान्यीकरण योग्य बनता है और ट्रेनिंग डेटा के शोर पर फिट होने की संभावना घटती है।
रैंडम फॉरेस्ट क्लासिफिकेशन में किन प्रमुख हाइपरपैरामीटर्स को ट्यून करना चाहिए?
रैंडम फॉरेस्ट के लिए प्रमुख हाइपरपैरामीटर्स में ट्री की संख्या, प्रत्येक ट्री की अधिकतम गहराई, किसी नोड को स्प्लिट करने के लिए आवश्यक न्यूनतम सैंपल्स, और हर स्प्लिट के लिए विचार किए जाने वाले फीचर्स की संख्या शामिल हैं।
रैंडम फॉरेस्ट क्लासिफिकेशन का उपयोग करने के क्या फायदे हैं?
रैंडम फॉरेस्ट क्लासिफिकेशन ओवरफिटिंग के प्रति मज़बूत है, बड़े डेटासेट्स पर अच्छा प्रदर्शन करता है, संख्यात्मक और श्रेणीबद्ध दोनों फीचर्स को संभाल सकता है, और न्यूरल नेटवर्क जैसे अन्य एल्गोरिथ्म की तुलना में हाइपरपैरामीटर ट्यूनिंग के प्रति कम संवेदनशील है।
यह ट्यूटोरियल बताता है कि Python में क्लासिफिकेशन के लिए रैंडम फॉरेस्ट एल्गोरिथ्म का उपयोग कैसे करें। आप सीखेंगे:
इस लेख से अधिकतम लाभ पाने के लिए, आपको Python, pandas, और scikit-learn का बुनियादी ज्ञान होना चाहिए। यह समझना उपयोगी है कि क्लासिफिकेशन के लिए डिसीजन ट्री कैसे उपयोग किए जाते हैं, इसलिए पहले हमारा Decision Tree Classification in Python Tutorial पढ़ने पर विचार करें। यदि आप scikit-learn के साथ अभी शुरुआत कर रहे हैं, तो Kaggle Tutorial: Your First Machine Learning Model देखें।
हालाँकि रैंडम फॉरेस्ट का उपयोग क्लासिफिकेशन और रिग्रेशन दोनों के लिए किया जा सकता है, यह लेख क्लासिफिकेशन मॉडल बनाने पर केंद्रित है। इस ट्यूटोरियल के कोड के साथ आसानी से प्रयोग करने के लिए, संबंधित DataLab वर्कबुक पर जाएँ। आखिर में, हमारा Model Validation in Python कोर्स आज़माएँ, जिसमें आप
tic_tac_toeडेटासेट का उपयोग करके रैंडम फॉरेस्ट क्लासिफिकेशन का अभ्यास कर सकते हैं।रैंडम फॉरेस्ट क्या हैं?
रैंडम फॉरेस्ट एक लोकप्रिय सुपरवाइज़्ड मशीन लर्निंग एल्गोरिथ्म है जो रिग्रेशन और क्लासिफिकेशन दोनों कार्यों को संभाल सकता है। नीचे रैंडम फॉरेस्ट की कुछ मुख्य विशेषताएँ दी गई हैं: