
लर्निंग पाथ
बड़े भाषा मॉडल विकसित करना
16 घंटा
उच्च RAM, GPU, और प्रोसेसिंग पावर की ज़रूरतों के कारण Llama 3 को लोकली चलाना कठिन लग सकता है। फिर भी, फ़्रेमवर्क्स और मॉडल ऑप्टिमाइज़ेशन में प्रगति ने इसे पहले से कहीं अधिक सुलभ बना दिया है। यहाँ कारण हैं कि आपको इसे क्यों आज़माना चाहिए:
हमारा लेख क्लाउड में बड़े भाषा मॉडल (LLMs) उपयोग करने बनाम लोकली चलाने के फायदे और नुकसान पढ़ें ताकि आप तय कर सकें कि लोकली LLMs उपयोग करना आपके लिए उपयुक्त है या नहीं।
GPT4ALL एक ओपन-सोर्स सॉफ़्टवेयर है जो आपको लोकप्रिय बड़े भाषा मॉडल्स को आपकी स्थानीय मशीन पर, बिना GPU के भी, चलाने देता है। यह उपयोगकर्ता-हितैषी है, इसलिए गैर-तकनीकी पृष्ठभूमि वाले लोग भी इसे आसानी से अपना सकते हैं।
हम आधिकारिक डाउनलोड पेज पर जाकर Windows के लिए GPT4ALL डाउनलोड और इंस्टॉल करने से शुरू करेंगे।
एप्लिकेशन इंस्टॉल करने के बाद, इसे लॉन्च करें और मॉडल्स मेन्यू खोलने के लिए “Downloads” बटन पर क्लिक करें। वहाँ नीचे स्क्रॉल करके “Llama 3 Instruct” मॉडल चुनें, फिर “Download” बटन दबाएँ।
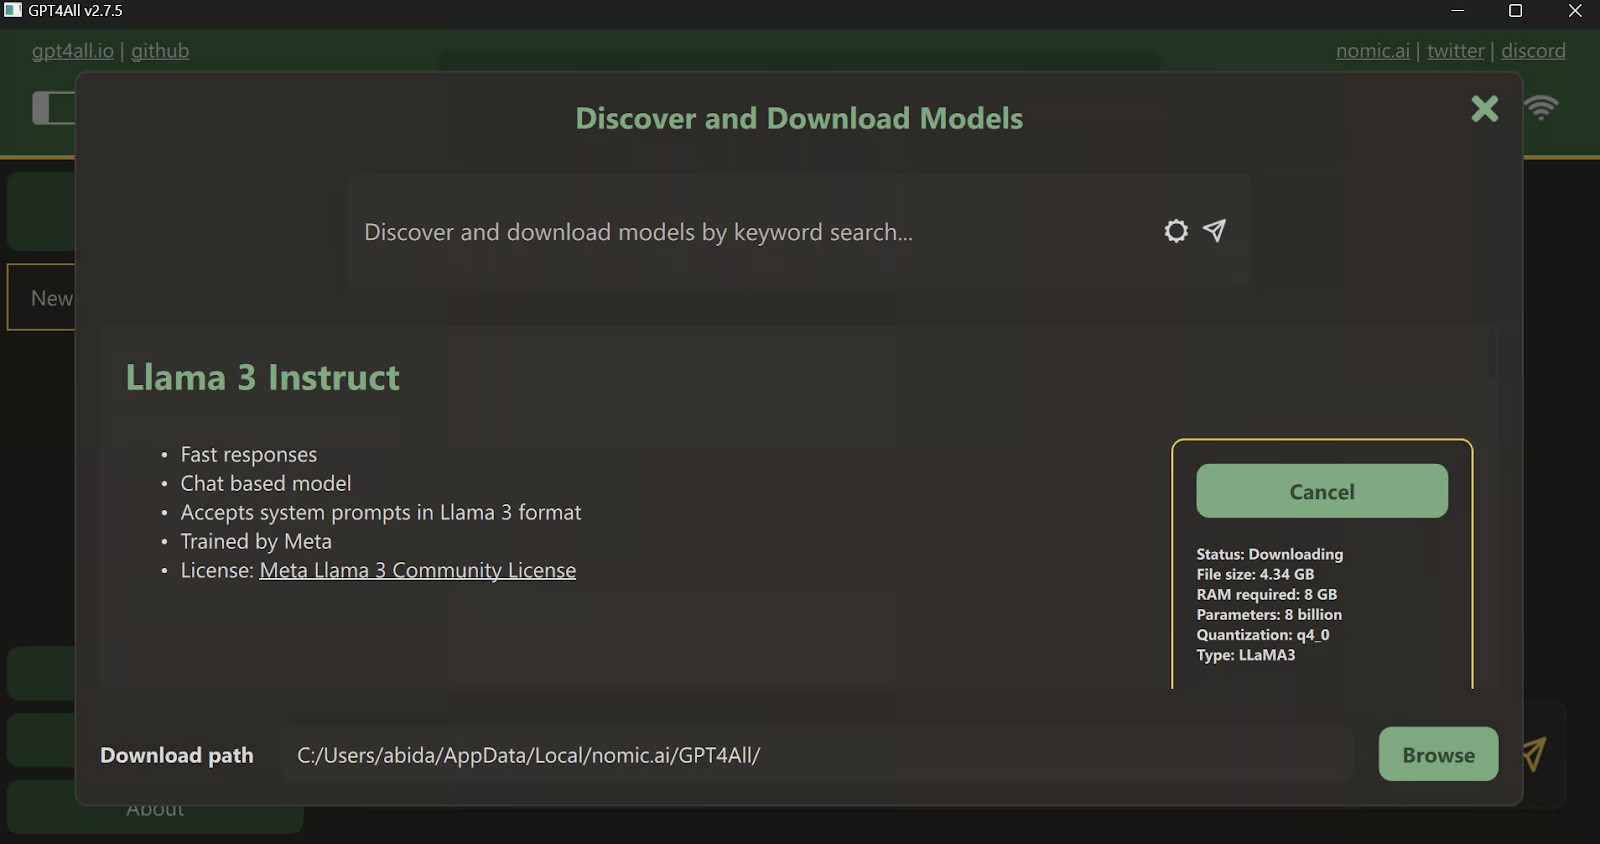
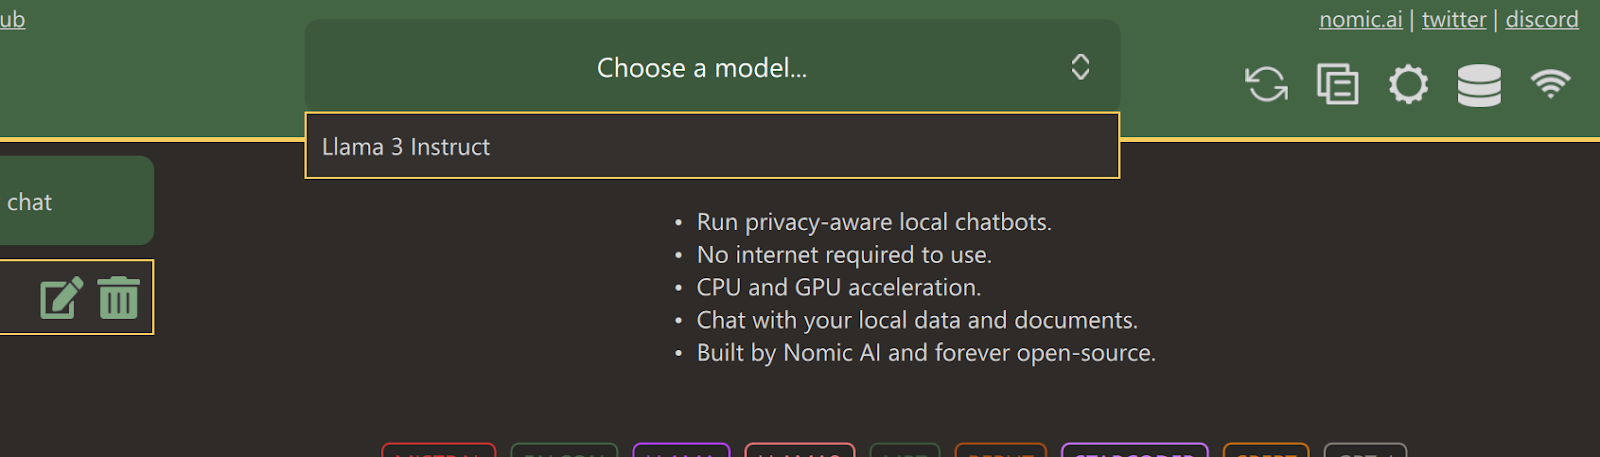
डाउनलोड पूरा होने के बाद, टैब बंद करें और “Choose a model” ड्रॉपडाउन मेन्यू में क्लिक करके Llama 3 Instruct मॉडल चुनें।
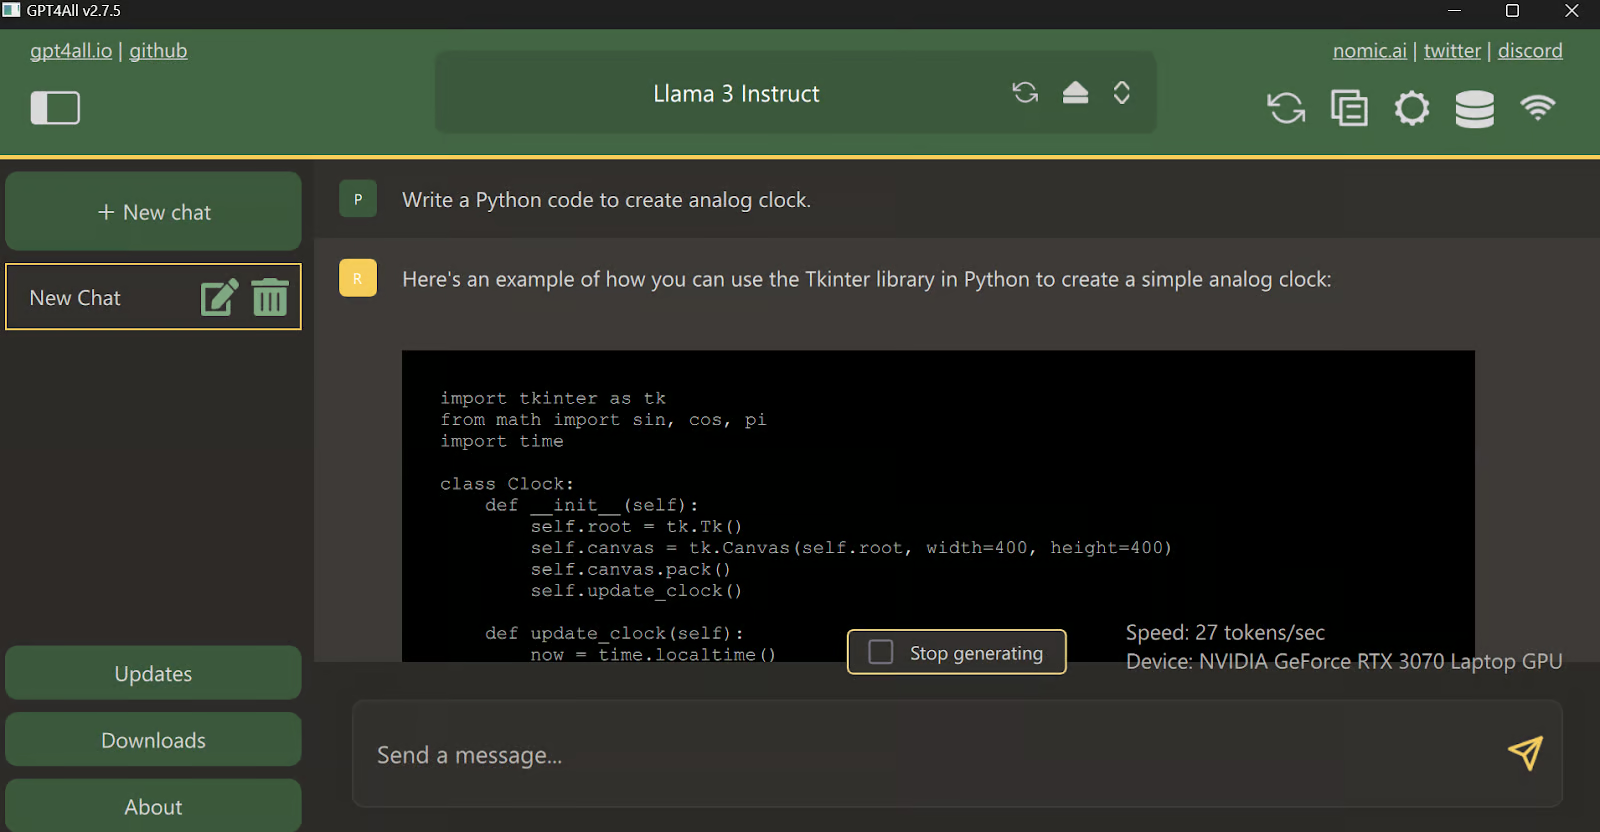
एक प्रॉम्प्ट टाइप करें और इसे ChatGPT की तरह उपयोग करना शुरू करें। सिस्टम में CUDA टूलकिट इंस्टॉल है, इसलिए यह तेज़ प्रतिक्रिया के लिए GPU का उपयोग करता है।
अब, Ollama डाउनलोड और इंस्टॉल करके Llama 3 को लोकली उपयोग करने का सबसे आसान तरीका आज़माते हैं।
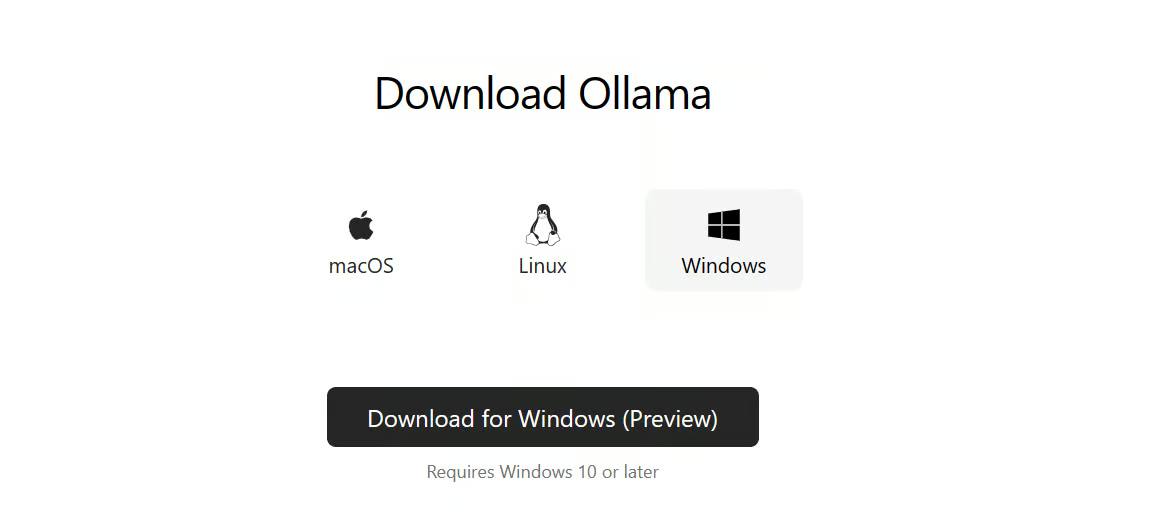
Ollama एक शक्तिशाली टूल है जो आपको LLMs को लोकली चलाने देता है। यह तेज़ है और ढेरों फीचर्स के साथ आता है।
अपने सिस्टम पर Ollama इंस्टॉल करने के बाद, टर्मिनल/PowerShell लॉन्च करें और यह कमांड टाइप करें।
ollama run llama3नोट: मॉडल फ़ाइल डाउनलोड करना और टर्मिनल के भीतर चैटबॉट शुरू करना कुछ मिनट ले सकता है।
प्रॉम्प्ट लिखें या प्रश्न पूछना शुरू करें, और Ollama आपके टर्मिनल में ही प्रतिक्रिया जनरेट करेगा। चैट प्रतिक्रिया बेहद तेज़ है, और आप गहराई से विषय में जाने के लिए फॉलो-अप प्रश्न पूछते रह सकते हैं।
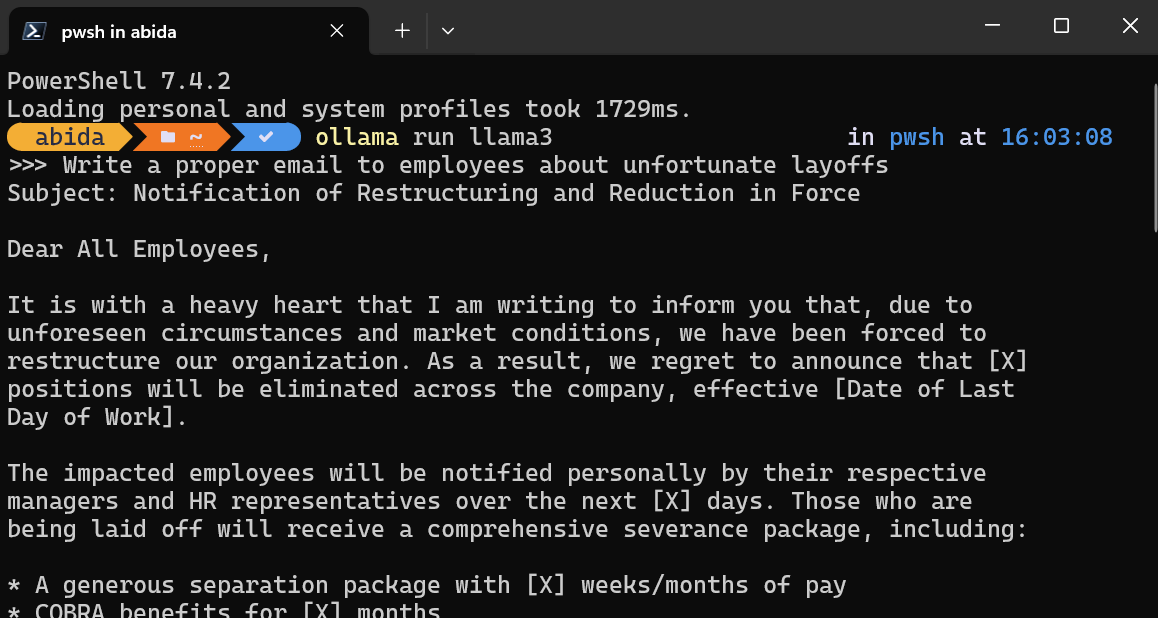
चैटबॉट से बाहर निकलने के लिए, बस /bye टाइप करें।
इन दो सॉफ़्टवेयर के अलावा, आप और एप्लिकेशंस व फ़्रेमवर्क्स जानने के लिए Run LLMs Locally: 7 Simple Methods गाइड देख सकते हैं।
स्थानीय सर्वर चलाने से आप Llama 3 को अन्य एप्लिकेशनों में इंटीग्रेट कर सकते हैं और विशेष कार्यों के लिए अपना खुद का एप्लिकेशन बना सकते हैं।
टर्मिनल में निम्न कमांड टाइप करके लोकल मॉडल इन्फरेंस सर्वर शुरू करें।
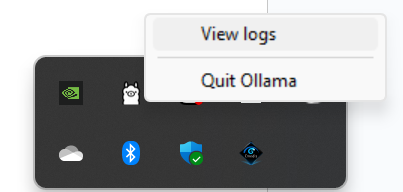
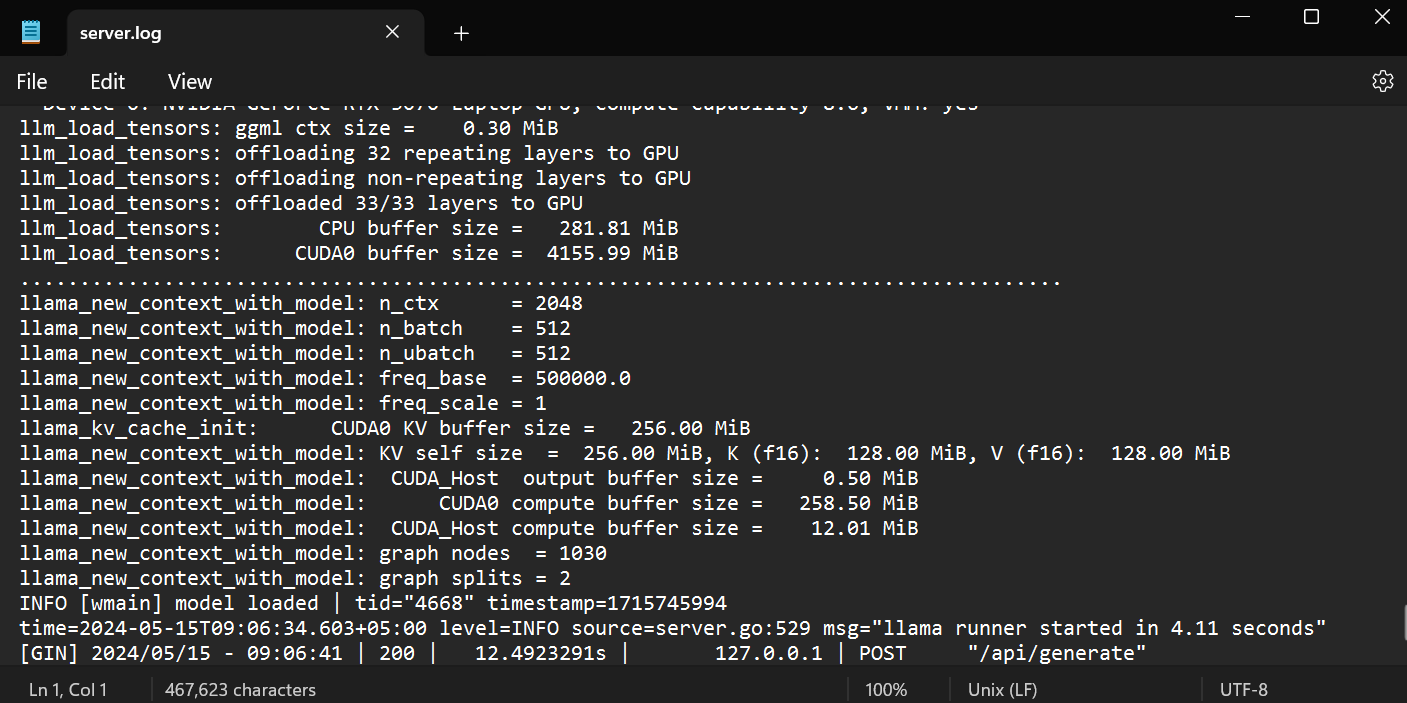
ollama serveयह जाँंचने के लिए कि सर्वर सही से चल रहा है या नहीं, सिस्टम ट्रे में जाएँ, Ollama आइकन ढूँढ़ें, और लॉग्स देखने के लिए राइट-क्लिक करें।
यह आपको Ollama फ़ोल्डर में ले जाएगा, जहाँ आप `server.log` फ़ाइल खोलकर APIs के जरिए आने वाले सर्वर रिक्वेस्ट्स और समय-चिह्न सहित सर्वर जानकारी देख सकते हैं।
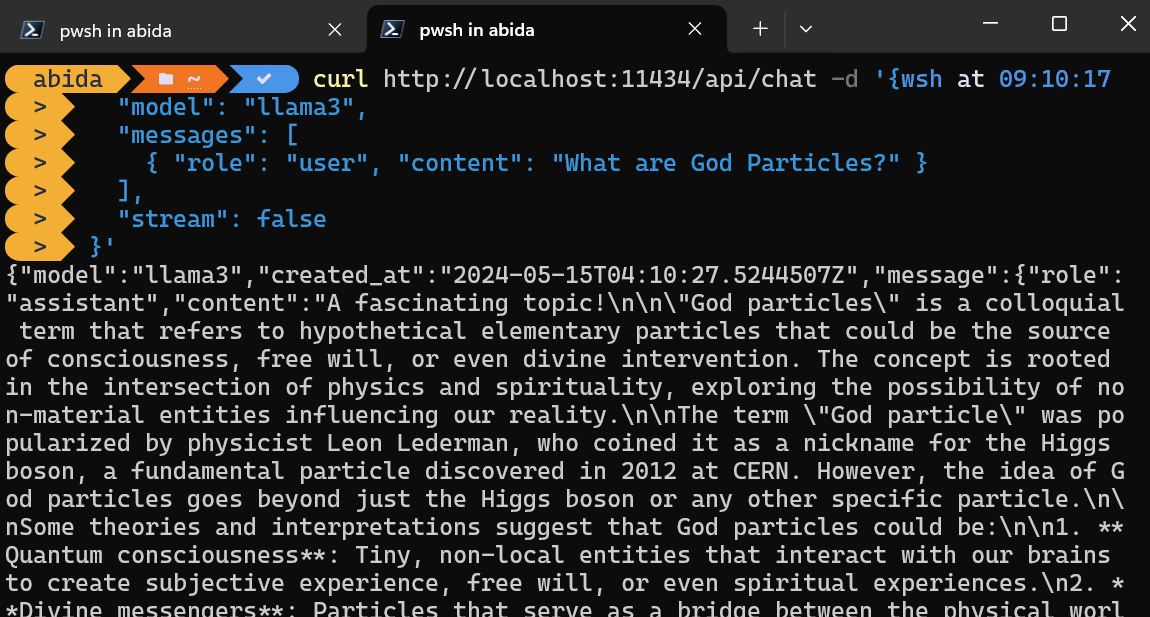
आप CURL कमांड का उपयोग करके इन्फरेंस सर्वर को सीधे एक्सेस कर सकते हैं।
बस मॉडल का नाम और प्रॉम्प्ट दें, और पूर्ण संदेश पाने के लिए सुनिश्चित करें कि स्ट्रीमिंग बंद हो।
curl http://localhost:11434/api/chat -d '{
  "model": "llama3",
  "messages": [
    { "role": "user", "content": "What are God Particles?" }
  ],
  "stream": false
}'
CURL कमांड Linux में नैटिव है, लेकिन आप इसे Windows PowerShell में भी उपयोग कर सकते हैं, जैसा कि नीचे दिखाया गया है।
आप PIP से Ollama Python पैकेज इंस्टॉल करके भी इन्फरेंस सर्वर एक्सेस कर सकते हैं।
pip install ollamaPython में API एक्सेस करने से आप AI-पावर्ड एप्लिकेशन और टूल्स बना सकते हैं, और इसका उपयोग करना बेहद आसान है।
बस `ollama.chat` फ़ंक्शन को मॉडल का नाम और संदेश दें, और यह प्रतिक्रिया जनरेट कर देगा।
नोट: message आर्गुमेंट में आप सिस्टम प्रॉम्प्ट और असिस्टेंट प्रॉम्प्ट भी जोड़कर संदर्भ दे सकते हैं।
import ollama

response = ollama.chat(
    model="llama3",
    messages=[
        {
            "role": "user",
            "content": "Tell me an interesting fact about elephants",
        },
    ],
)
print(response["message"]["content"])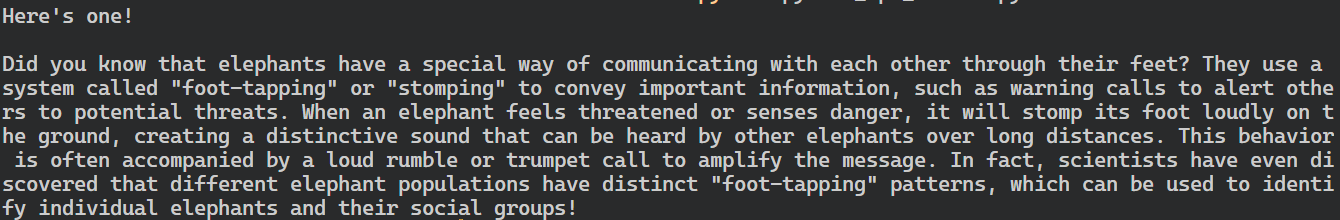
Ollama Python पैकेज असिंक्रोनस कॉल्स और स्ट्रीमिंग जैसी सुविधाएँ भी देता है, जो API रिक्वेस्ट्स को प्रभावी ढंग से मैनेज करने और मॉडल की प्रत्यक्ष गति बढ़ाने में मदद करती हैं।
OpenAI API की तरह, आप एक असिंक्रोनस चैट फ़ंक्शन बना सकते हैं और फिर async फ़ंक्शन के साथ स्ट्रीमिंग कोड लिख सकते हैं, जिससे मॉडल के साथ कुशल और तेज़ इंटरैक्शन संभव हो जाता है।
import asyncio
from ollama import AsyncClient

async def chat():
    """
    Stream a chat from Llama using the AsyncClient.
    """
    message = {
        "role": "user",
        "content": "Tell me an interesting fact about elephants"
    }
    async for part in await AsyncClient().chat(
        model="llama3", messages=[message], stream=True
    ):
        print(part["message"]["content"], end="", flush=True)


asyncio.run(chat())
जैसा कि आप देख सकते हैं, मॉडल टोकन उसी समय प्रदर्शित करता जाता है जैसे वे जनरेट होते हैं।
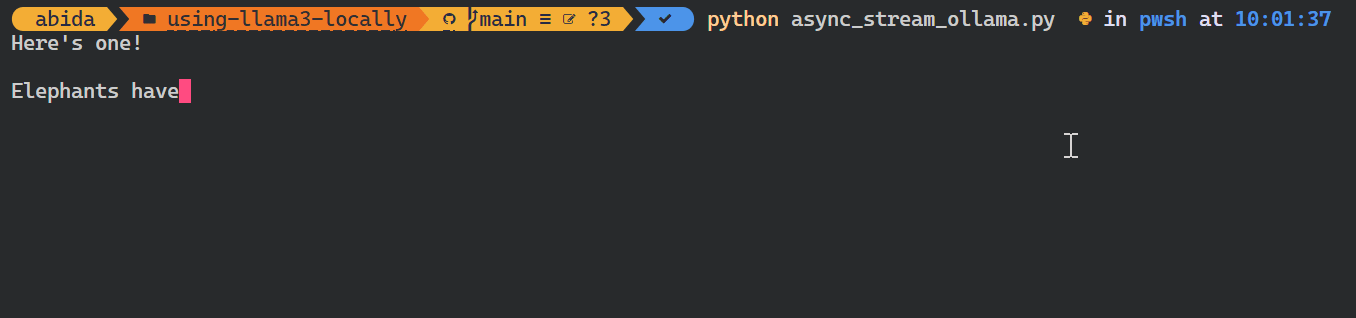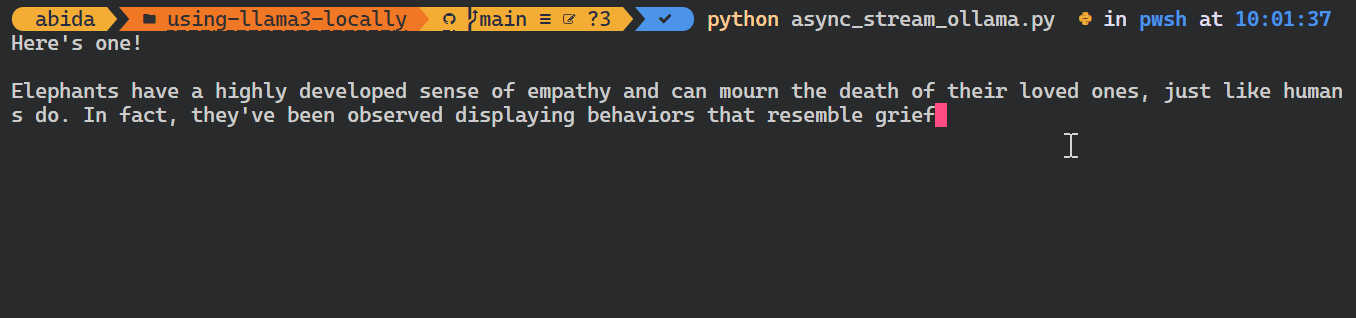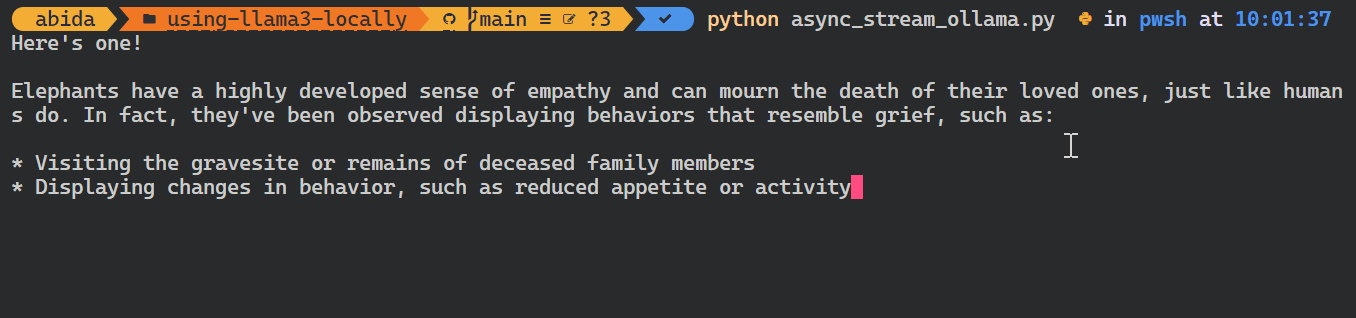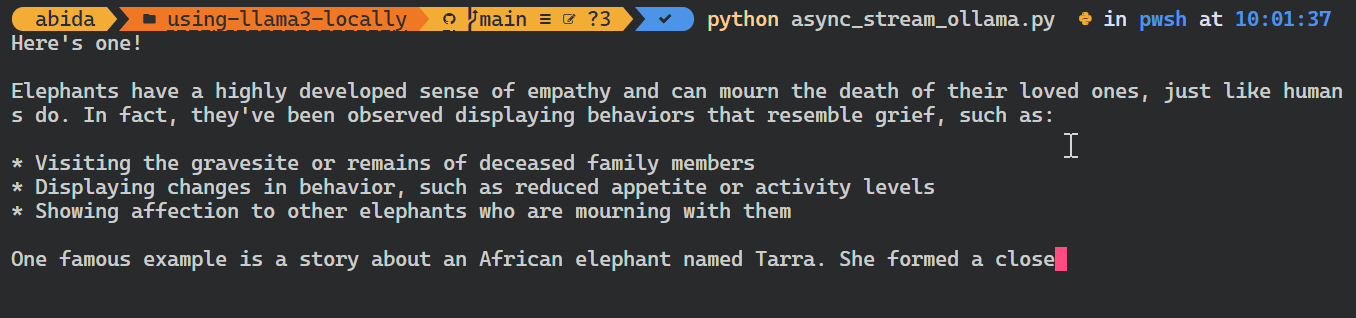
आप Python API का उपयोग करके कस्टम मॉडल बनाना, टेक्स्ट को एम्बेडिंग्स में बदलना, और एरर हैंडलिंग भी कर सकते हैं। आप मॉडल्स की कॉपी, डिलीट, पुल और पुश भी कर सकते हैं।
Ollama को चैटबॉट या प्रतिक्रियाएँ जनरेट करने के अलावा, आप इसे VSCode में इंटीग्रेट कर सकते हैं और Llama 3 का उपयोग ऑटोकंप्लीशन, संदर्भ-सचेत कोड सजेशन, कोड लेखन, डॉक्स्ट्रिंग जनरेशन, यूनिट टेस्टिंग आदि के लिए कर सकते हैं।
1. पहले, हमें टर्मिनल में निम्न कमांड टाइप करके Ollama इन्फरेंस सर्वर को इनिशियलाइज़ करना होगा।
ollama serve2. VSCode एक्सटेंशन्स में जाएँ, "CodeGPT" टूल खोजें और इंस्टॉल करें। CodeGPT आपको किसी भी मॉडल प्रोवाइडर को API कुंजी के जरिए कनेक्ट करने देता है।
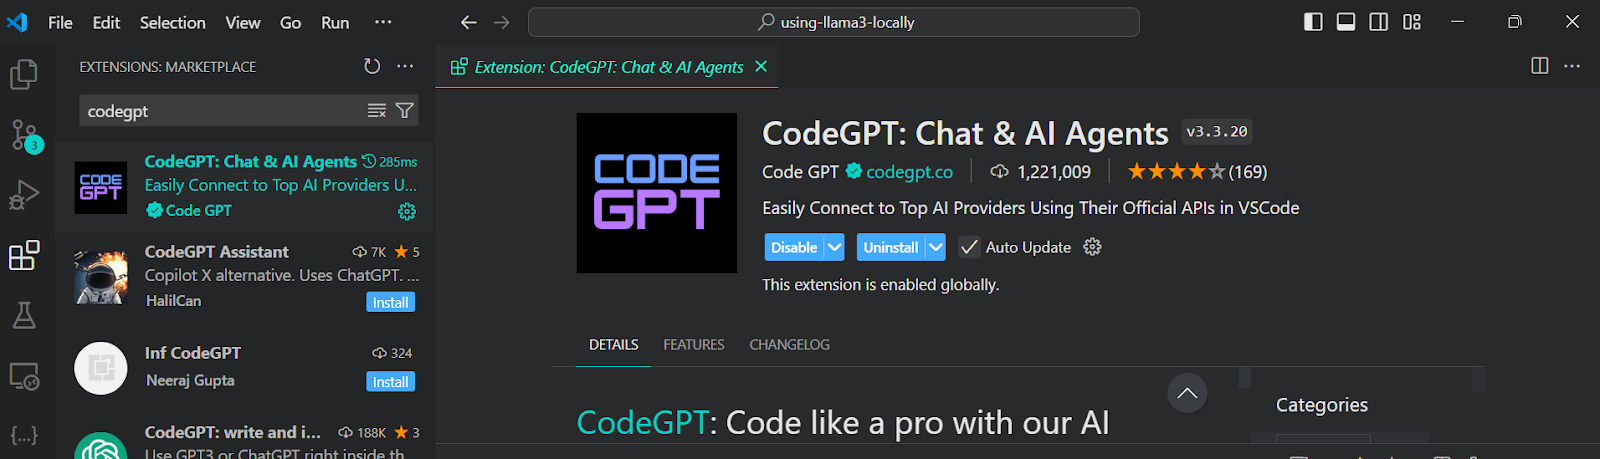
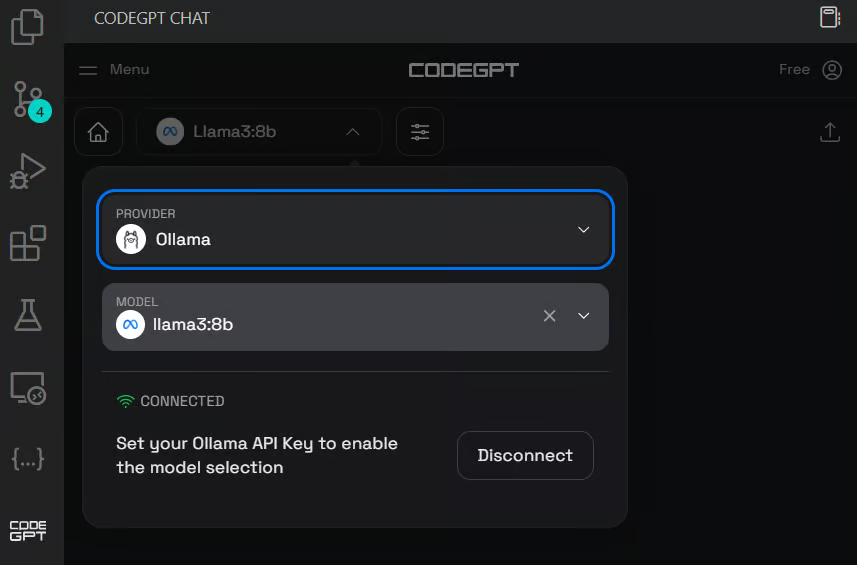
3. बाएँ पैनल पर CodeGPT चैट आइकन पर क्लिक करके CodeGPT सेट अप करें। मॉडल प्रोवाइडर को Ollama में बदलें और llama3:8b मॉडल चुनें। आपको API कुंजी देने की आवश्यकता नहीं है, क्योंकि हम इसे लोकली चला रहे हैं।
4. Python कोड जनरेट करने के लिए प्रॉम्प्ट लिखें और फिर "Insert the code" बटन पर क्लिक करके कोड को अपने Python फ़ाइल में ट्रांसफ़र करें। आप कोड सुधारने के लिए फॉलो-अप निर्देश भी दे सकते हैं।
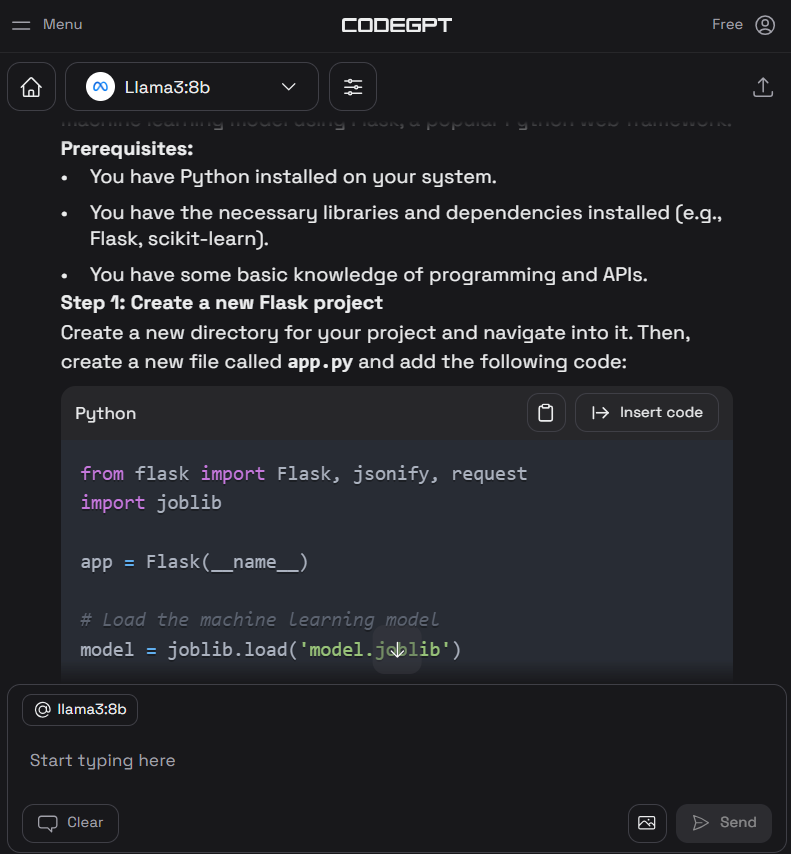
5. कोडिंग असिस्टेंट के अलावा, आप CodeGPT से कोड समझ सकते हैं, उसे रिफैक्टर कर सकते हैं, डॉक्यूमेंट कर सकते हैं, यूनिट टेस्ट जनरेट कर सकते हैं और समस्याएँ हल कर सकते हैं।
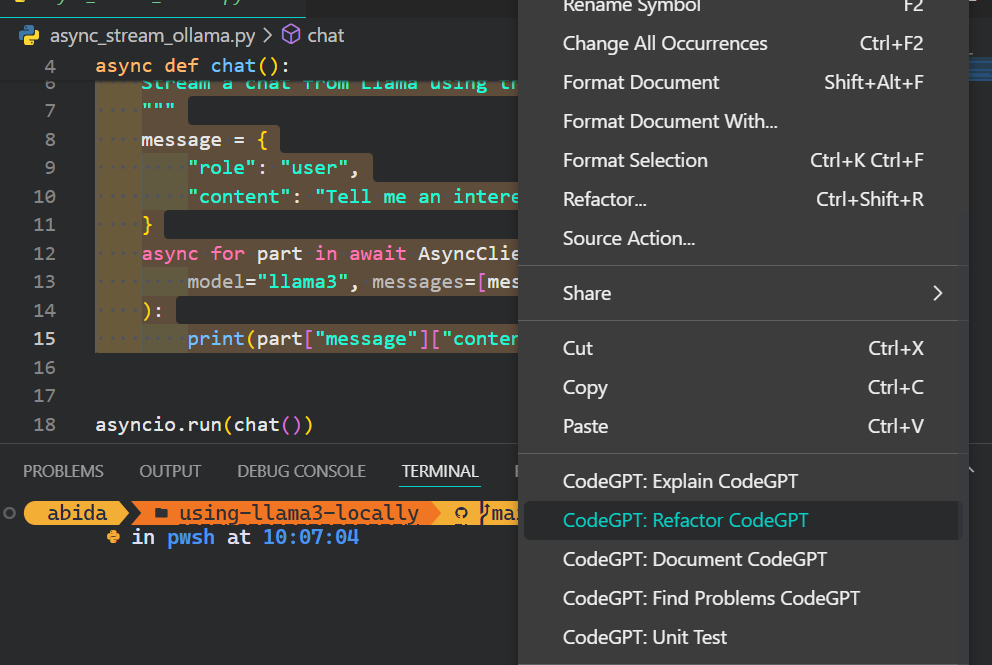
यदि आप अपने आपको Python प्रो जैसा महसूस करना चाहते हैं, तो VSCode की मुख्य विशेषताओं के बारे में जानने और उसे अपनी ज़रूरत के अनुसार कस्टमाइज़ करने के लिए Setting Up VSCode For Python गाइड देखें।
इस सेक्शन में, हम एक AI-पावर्ड एप्लिकेशन विकसित करेंगे जो किसी निर्दिष्ट फ़ोल्डर से docx फ़ाइलें पढ़ेगा, उन्हें एम्बेडिंग्स में बदलेगा और उन्हें एक वेक्टर स्टोर में सहेजेगा।
इसके बाद, हम समानता खोज (similarity search) का उपयोग करके प्रासंगिक अर्थ निकालेंगे और आपके प्रश्नों के संदर्भित उत्तर प्रदान करेंगे।
यह एप्लिकेशन आपको किताबों की मूल भावना को तेज़ी से समझने और चरित्र विकास में गहराई तक जाने में सक्षम बनाएगा।
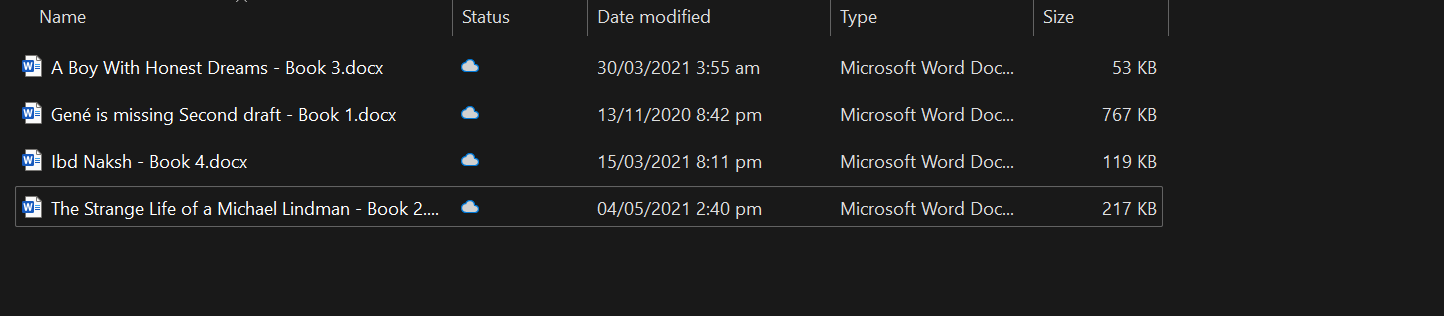
सबसे पहले, हम डॉक्युमेंट्स लोड करने, वेक्टर स्टोर और LLM फ़्रेमवर्क्स के लिए सभी आवश्यक Python पैकेज इंस्टॉल करेंगे।
pip install unstructured[docx] langchain langchainhub langchain_community langchain-chromaफिर, Ollama इन्फरेंस सर्वर शुरू करें।
ollama serveएप बनाने से पहले Jupyter Notebook में अपना कोड विकसित और टेस्ट करना एक अच्छी प्रैक्टिस है।
हम DirectoryLoader का उपयोग करके फ़ोल्डर से सभी docx फ़ाइलें लोड करेंगे।
from langchain_community.document_loaders import DirectoryLoader

loader = DirectoryLoader("C:/Users/abida/Desktop/Books", glob="**/*.docx")
books = loader.load()
len(books)4आप Chatbot Development with ChatGPT & LangChain: A Context-Aware Approach ट्यूटोरियल का अनुसरण करके अपना संदर्भ-सचेत चैटबॉट बना सकते हैं।
पूरी किताब को मॉडल में भेजना संभव नहीं है, क्योंकि इससे उसका कॉन्टेक्स्ट विंडो पार हो जाएगा। इस सीमा से निपटने के लिए, हमें टेक्स्ट को छोटे, अधिक प्रबंधनीय हिस्सों में बाँटना होगा, जो मॉडल के कॉन्टेक्स्ट विंडो में आराम से समा जाएँ।
हमारे मामले में, हम सभी चार किताबों को 500 कैरेक्टर के चंक साइज में बदलेंगे।
from langchain_text_splitters import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=0)
all_splits = text_splitter.split_documents(books)
हम टेक्स्ट को एम्बेडिंग्स में बदलने और उन्हें Chroma डेटाबेस में स्टोर करने के लिए Langchain का उपयोग करेंगे।
हम एम्बेडिंग मॉडल के रूप में Ollama Llama 3 मॉडल का उपयोग कर रहे हैं।
from langchain_chroma import Chroma
from langchain_community.embeddings import OllamaEmbeddings

vectorstore = Chroma.from_documents(
    documents=all_splits,
    embedding=OllamaEmbeddings(model="llama3", show_progress=True),
    persist_directory="./chroma_db",
)
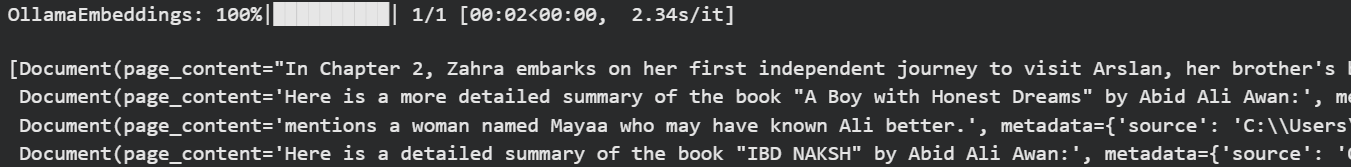
OllamaEmbeddings: 100%|██████████| 23/23 [01:00<00:00, 2.63s/it]आइए कुछ समानता खोज करके अपने वेक्टर डेटाबेस का परीक्षण करें।
question = "Who is Zahra?"
docs = vectorstore.similarity_search(question)
docs
हमें प्रश्न से मिलते-जुलते चार परिणाम मिले।
वेक्टर डेटाबेस और Chroma DB की दुनिया में गहराई से जाने के लिए यह ट्यूटोरियल पढ़ें: Learn How to Use Chroma DB: A Step-by-Step Guide।
एक उचित प्रश्न-उत्तर रिट्रीवल सिस्टम बनाने के लिए, हम Langchain चेन्स का उपयोग करेंगे और मॉड्यूल जोड़ना शुरू करेंगे।
हमारी Q&A चेन में, हम
सरल शब्दों में, Llama 3 मॉडल से गुज़रने से पहले, आपकी क्वेरी को समानता खोज और RAG प्रॉम्प्ट के जरिए संदर्भ दिया जाएगा।
from langchain import hub
from langchain_community.llms import Ollama
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

llm = Ollama(model="llama3")

retriever = vectorstore.as_retriever()


def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)


rag_prompt = hub.pull("rlm/rag-prompt")
qa_chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
आप LLamaIndex का उपयोग करके भी इसी तरह का एप्लिकेशन बना सकते हैं। ऐसा करने के लिए LlamaIndex: A Data Framework for the Large Language Models (LLMs) based applications ट्यूटोरियल देखें।
कहानी के बारे में अधिक समझने के लिए किताबों पर प्रासंगिक प्रश्न पूछें।
question = "What is the story of the 'Gené is Missing' book?"
qa_chain.invoke(question)
जैसा कि हम देख सकते हैं, संदर्भ के रूप में किताबों का उपयोग करने से सटीक प्रतिक्रिया मिलती है।
'Based on the provided context, "Gené is Missing" appears to be a mystery novel that revolves around uncovering the truth about Gené\'s life and potential involvement in murders. The story follows different perspectives, including Simon trying to prove his innocence, flashbacks of Gené\'s past, and detective Jacob investigating the case.'अब किसी पात्र के बारे में प्रश्न पूछते हैं।
question = "Who is Arslan?"
qa_chain.invoke(question)
एक सटीक उत्तर जनरेट हुआ।
'Arslan is Zahra\'s brother\'s best friend. He is someone that Zahra visits in the book "A Boy with Honest Dreams" by Abid Ali Awan to gather information about Ali.'टर्मिनल में बिना रुकावट चलने वाला एक पूर्ण AI एप्लिकेशन बनाने के लिए, हम पिछली सेक्शन्स के सभी कोड्स को एक सिंगल Python फ़ाइल में जोड़ेंगे।
code AI_app.pyआगे, हम कोड को बेहतर बनाएँगे ताकि इंटरैक्टिव क्वेरींग संभव हो सके, जिससे आप तब तक बार-बार ऐप से प्रश्न पूछ सकें जब तक आप 'exit' टाइप करके सत्र को समाप्त न कर दें।
from langchain_chroma import Chroma
from langchain_community.embeddings import OllamaEmbeddings
from langchain import hub
from langchain_community.llms import Ollama
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

# loading the vectorstore
vectorstore = Chroma(persist_directory="./chroma_db", embedding_function=OllamaEmbeddings(model="llama3"))

# loading the Llama3 model
llm = Ollama(model="llama3")

# using the vectorstore as the retriever
retriever = vectorstore.as_retriever()

# formating the docs
def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

# loading the QA chain from langchain hub
rag_prompt = hub.pull("rlm/rag-prompt")

# creating the QA chain
qa_chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)

# running the QA chain in a loop until the user types "exit"
while True:
    question = input("Question: ")
    if question.lower() == "exit":
        break
    answer = qa_chain.invoke(question)

    print(f"\nAnswer: {answer}\n")
टर्मिनल में `Python` और फ़ाइल का नाम लिखकर एप्लिकेशन चलाएँ।
python AI_app.pyयह बढ़िया है। हमने कुछ ही लाइनों के कोड में अपना स्थानीय RAG AI एप्लिकेशन बना लिया है।
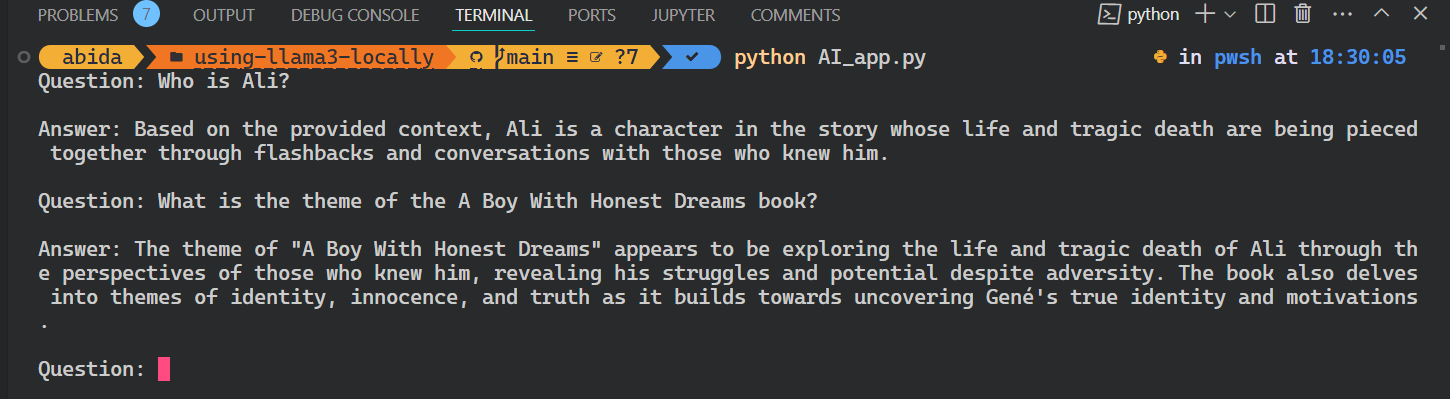
इस ट्यूटोरियल का सारा सोर्स कोड GitHub रिपॉज़िटरी kingabzpro/using-llama3-locally पर उपलब्ध है। कृपया देखें और रिपॉज़िटरी को ⭐ देना न भूलें।
इस ट्यूटोरियल में, हमने लैपटॉप पर लोकली Llama 3 का उपयोग करना सीखा। हमने इन्फरेंस सर्वर के बारे में भी जाना और इसे VSCode में इंटीग्रेट करने का तरीका सीखा।
अंततः, हमने Langchain, Chroma और Ollama का उपयोग करके Q&A रिट्रीवल सिस्टम बनाया। डेटा कभी भी स्थानीय सिस्टम से बाहर नहीं गया, और आपको इसे बनाने के लिए एक डॉलर भी खर्च नहीं करना पड़ा। सरल एप्लिकेशंस के अलावा, आप इन्हीं टूल्स से जटिल सिस्टम भी बना सकते हैं।
अधिक जानने के लिए, मैं ये ट्यूटोरियल्स सुझाता/सुझाती हूँ:
DataCamp के साथ AI सीखें!
लर्निंग पाथ
कोर्स
लर्निंग पाथ