Vai al contenuto principale

Tutorial sulle Support Vector Machines con Scikit-learn

In questo tutorial imparerai a conoscere le Support Vector Machines, uno degli algoritmi di apprendimento supervisionato più popolari e utilizzati.
Aggiornato 29 set 2026  · 15 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Le SVM offrono un’accuratezza molto alta rispetto ad altri classificatori come la regressione logistica e gli alberi decisionali. Sono note per il “kernel trick” che consente di gestire spazi di input non lineari. Vengono usate in una varietà di applicazioni come il rilevamento facciale, l’intrusion detection, la classificazione di email, articoli di notizie e pagine web, la classificazione di geni e il riconoscimento della scrittura a mano.

In questo tutorial userai scikit-learn in Python. Se vuoi saperne di più su questo pacchetto Python, ti consiglio di dare un’occhiata al nostro corso Supervised Learning with scikit-learn.

Le SVM sono un algoritmo interessante e i concetti sono relativamente semplici. Il classificatore separa i punti dati usando un iperpiano con il margine più ampio possibile. Per questo un classificatore SVM è noto anche come classificatore discriminativo. L’SVM trova un iperpiano ottimale che aiuta a classificare nuovi punti dati.

In questo tutorial, tratterai i seguenti argomenti:

Guarda e approfondisci le Support Vector Machines con Scikit-learn in questo video tratto dal nostro corso.

Support Vector Machines

In generale, le Support Vector Machines sono considerate un approccio di classificazione, ma possono essere impiegate sia per problemi di classificazione sia di regressione. Possono gestire facilmente più variabili continue e categoriche. Le SVM costruiscono un iperpiano in uno spazio multidimensionale per separare classi diverse. Generano l’iperpiano ottimale in modo iterativo, con l’obiettivo di minimizzare l’errore. L’idea centrale delle SVM è trovare un iperpiano a margine massimo (MMH) che divida al meglio il dataset in classi.
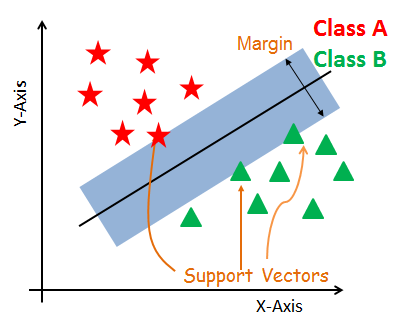
Support Vectors

Support vectors

I support vectors sono i punti dati più vicini all’iperpiano. Questi punti definiscono meglio la linea di separazione tramite il calcolo dei margini. Sono i punti più rilevanti per la costruzione del classificatore.

Iperpiano

Un iperpiano è un piano decisionale che separa un insieme di oggetti con appartenenze di classe diverse.

Margine

Il margine è lo spazio tra le due linee sui punti della classe più vicina. Si calcola come distanza perpendicolare dalla linea ai support vectors o ai punti più vicini. Se il margine tra le classi è più ampio, è considerato un buon margine; un margine più piccolo è un margine scarso.

Come funziona l’SVM?

L’obiettivo principale è separare il dataset nel modo migliore possibile. La distanza tra i punti più vicini è detta margine. L’obiettivo è selezionare un iperpiano con il margine massimo possibile tra i support vectors nel dataset. L’SVM cerca l’iperpiano a margine massimo con i seguenti passaggi:

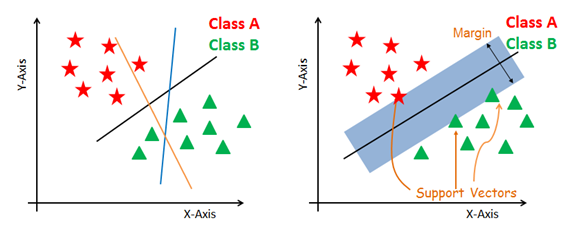
  1. Generare iperpiani che separino al meglio le classi. La figura a sinistra mostra tre iperpiani: nero, blu e arancione. Qui blu e arancione hanno un errore di classificazione più alto, mentre il nero separa correttamente le due classi.

  2. Selezionare l’iperpiano giusto con la massima separazione rispetto ai punti dati più vicini, come mostrato nella figura a destra.
Linear Separator

Gestire piani non lineari e non separabili

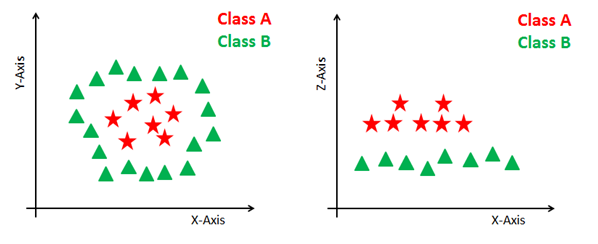
Alcuni problemi non possono essere risolti usando un iperpiano lineare, come mostrato nella figura sotto (a sinistra).

In tali situazioni, l’SVM usa il kernel trick per trasformare lo spazio di input in uno spazio a dimensionalità superiore, come mostrato a destra. I punti dati sono rappresentati sugli assi x e z (Z è la somma dei quadrati di x e y: z=x^2=y^2). Ora puoi separare facilmente questi punti con una separazione lineare.
Higher Dimension

Kernel SVM

L’algoritmo SVM viene implementato nella pratica usando un kernel. Un kernel trasforma lo spazio dei dati di input nella forma richiesta. L’SVM utilizza una tecnica chiamata kernel trick. Qui il kernel prende uno spazio di input a bassa dimensionalità e lo trasforma in uno spazio a dimensionalità maggiore. In altre parole, converte un problema non separabile in uno separabile aggiungendo dimensioni. È particolarmente utile nei problemi di separazione non lineare. Il kernel trick ti aiuta a costruire un classificatore più accurato.

  • Kernel lineare Un kernel lineare può essere usato come normale prodotto scalare tra due osservazioni. Il prodotto tra due vettori è la somma della moltiplicazione di ciascuna coppia di valori in input.
K(x, xi) = sum(x * xi)
  • Kernel polinomiale Un kernel polinomiale è una forma più generalizzata del kernel lineare. Il kernel polinomiale può distinguere spazi di input curvi o non lineari.
K(x,xi) = 1 + sum(x * xi)^d

Dove d è il grado del polinomio. d=1 è simile alla trasformazione lineare. Il grado deve essere specificato manualmente nell’algoritmo di apprendimento.

  • Kernel a base radiale Il kernel a base radiale (RBF) è un kernel popolare comunemente usato nella classificazione con support vector machine. L’RBF può mappare uno spazio di input in uno spazio di dimensione infinita.
K(x,xi) = exp(-gamma * sum((x – xi^2))

Qui gamma è un parametro che varia da 0 a 1. Un valore più alto di gamma adatterà perfettamente il dataset di training, causando overfitting. Gamma=0.1 è considerato un buon valore predefinito. Il valore di gamma deve essere specificato manualmente nell’algoritmo di apprendimento.

Creare un classificatore in Scikit-learn

Finora hai visto la teoria alla base delle SVM. Ora vedrai come implementarle in Python usando scikit-learn.

Nella parte di costruzione del modello, puoi usare il dataset sul cancro, un famoso problema di classificazione multi-classe. Questo dataset è ottenuto da un’immagine digitalizzata di un agoaspirato (FNA) di una massa al seno. Descrive le caratteristiche dei nuclei cellulari presenti nell’immagine.

Il dataset comprende 30 feature (raggio medio, tessitura media, perimetro medio, area media, levigatezza media, compattezza media, concavità media, punti concavi medi, simmetria media, dimensione frattale media, errore del raggio, errore della tessitura, errore del perimetro, errore dell’area, errore della levigatezza, errore della compattezza, errore della concavità, errore dei punti concavi, errore della simmetria, errore della dimensione frattale, raggio peggiore, tessitura peggiore, perimetro peggiore, area peggiore, levigatezza peggiore, compattezza peggiore, concavità peggiore, punti concavi peggiori, simmetria peggiore e dimensione frattale peggiore) e un target (tipo di tumore).

Questo dataset ha due tipi di classi tumorali: maligne (dannose) e benigne (non dannose). Qui puoi costruire un modello per classificare il tipo di tumore. Il dataset è disponibile nella libreria scikit-learn oppure puoi scaricarlo dalla UCI Machine Learning Library.

Esegui e modifica il codice da questo tutorial online

Esegui codice

Caricamento dei dati

Per prima cosa, carichiamo il dataset necessario che userai.

#Import scikit-learn dataset library
from sklearn import datasets

#Load dataset
cancer = datasets.load_breast_cancer()

Esplorazione dei dati

Dopo aver caricato il dataset, potresti voler saperne un po’ di più. Puoi controllare i nomi delle feature e del target.

# print the names of the 13 features
print("Features: ", cancer.feature_names)

# print the label type of cancer('malignant' 'benign')
print("Labels: ", cancer.target_names)
Features:  ['mean radius' 'mean texture' 'mean perimeter' 'mean area'
 'mean smoothness' 'mean compactness' 'mean concavity'
 'mean concave points' 'mean symmetry' 'mean fractal dimension'
 'radius error' 'texture error' 'perimeter error' 'area error'
 'smoothness error' 'compactness error' 'concavity error'
 'concave points error' 'symmetry error' 'fractal dimension error'
 'worst radius' 'worst texture' 'worst perimeter' 'worst area'
 'worst smoothness' 'worst compactness' 'worst concavity'
 'worst concave points' 'worst symmetry' 'worst fractal dimension']
Labels:  ['malignant' 'benign']

Esploriamolo un po’ di più. Puoi anche controllare la forma del dataset usando shape.

# print data(feature)shape
cancer.data.shape
(569, 30)

Diamo un’occhiata alle prime 5 righe del set di feature.

# print the cancer data features (top 5 records)
print(cancer.data[0:5])
[[1.799e+01 1.038e+01 1.228e+02 1.001e+03 1.184e-01 2.776e-01 3.001e-01
  1.471e-01 2.419e-01 7.871e-02 1.095e+00 9.053e-01 8.589e+00 1.534e+02
  6.399e-03 4.904e-02 5.373e-02 1.587e-02 3.003e-02 6.193e-03 2.538e+01
  1.733e+01 1.846e+02 2.019e+03 1.622e-01 6.656e-01 7.119e-01 2.654e-01
  4.601e-01 1.189e-01]
 [2.057e+01 1.777e+01 1.329e+02 1.326e+03 8.474e-02 7.864e-02 8.690e-02
  7.017e-02 1.812e-01 5.667e-02 5.435e-01 7.339e-01 3.398e+00 7.408e+01
  5.225e-03 1.308e-02 1.860e-02 1.340e-02 1.389e-02 3.532e-03 2.499e+01
  2.341e+01 1.588e+02 1.956e+03 1.238e-01 1.866e-01 2.416e-01 1.860e-01
  2.750e-01 8.902e-02]
 [1.969e+01 2.125e+01 1.300e+02 1.203e+03 1.096e-01 1.599e-01 1.974e-01
  1.279e-01 2.069e-01 5.999e-02 7.456e-01 7.869e-01 4.585e+00 9.403e+01
  6.150e-03 4.006e-02 3.832e-02 2.058e-02 2.250e-02 4.571e-03 2.357e+01
  2.553e+01 1.525e+02 1.709e+03 1.444e-01 4.245e-01 4.504e-01 2.430e-01
  3.613e-01 8.758e-02]
 [1.142e+01 2.038e+01 7.758e+01 3.861e+02 1.425e-01 2.839e-01 2.414e-01
  1.052e-01 2.597e-01 9.744e-02 4.956e-01 1.156e+00 3.445e+00 2.723e+01
  9.110e-03 7.458e-02 5.661e-02 1.867e-02 5.963e-02 9.208e-03 1.491e+01
  2.650e+01 9.887e+01 5.677e+02 2.098e-01 8.663e-01 6.869e-01 2.575e-01
  6.638e-01 1.730e-01]
 [2.029e+01 1.434e+01 1.351e+02 1.297e+03 1.003e-01 1.328e-01 1.980e-01
  1.043e-01 1.809e-01 5.883e-02 7.572e-01 7.813e-01 5.438e+00 9.444e+01
  1.149e-02 2.461e-02 5.688e-02 1.885e-02 1.756e-02 5.115e-03 2.254e+01
  1.667e+01 1.522e+02 1.575e+03 1.374e-01 2.050e-01 4.000e-01 1.625e-01
  2.364e-01 7.678e-02]]

Diamo un’occhiata al set di target.

# print the cancer labels (0:malignant, 1:benign)
print(cancer.target)
[0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
 1 0 0 0 0 0 0 0 0 1 0 1 1 1 1 1 0 0 1 0 0 1 1 1 1 0 1 0 0 1 1 1 1 0 1 0 0
 1 0 1 0 0 1 1 1 0 0 1 0 0 0 1 1 1 0 1 1 0 0 1 1 1 0 0 1 1 1 1 0 1 1 0 1 1
 1 1 1 1 1 1 0 0 0 1 0 0 1 1 1 0 0 1 0 1 0 0 1 0 0 1 1 0 1 1 0 1 1 1 1 0 1
 1 1 1 1 1 1 1 1 0 1 1 1 1 0 0 1 0 1 1 0 0 1 1 0 0 1 1 1 1 0 1 1 0 0 0 1 0
 1 0 1 1 1 0 1 1 0 0 1 0 0 0 0 1 0 0 0 1 0 1 0 1 1 0 1 0 0 0 0 1 1 0 0 1 1
 1 0 1 1 1 1 1 0 0 1 1 0 1 1 0 0 1 0 1 1 1 1 0 1 1 1 1 1 0 1 0 0 0 0 0 0 0
 0 0 0 0 0 0 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1
 1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0 1 0 1 1 1 1 0 0 0 1 1
 1 1 0 1 0 1 0 1 1 1 0 1 1 1 1 1 1 1 0 0 0 1 1 1 1 1 1 1 1 1 1 1 0 0 1 0 0
 0 1 0 0 1 1 1 1 1 0 1 1 1 1 1 0 1 1 1 0 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1
 1 0 1 1 1 1 1 0 1 1 0 1 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 0 1 1 1 1 1 0 1 1
 0 1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1 1 1 1 1 0 1
 1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 0 0 1 0 1 0 1 1 1 1 1 0 1 1 0 1 0 1 0 0
 1 1 1 0 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
 1 1 1 1 1 1 1 0 0 0 0 0 0 1]

Suddivisione dei dati

Per valutare le prestazioni del modello, dividere il dataset in training set e test set è una buona strategia.

Dividi il dataset usando la funzione train_test_split(). Devi passare 3 parametri: feature, target e dimensione del test set. Inoltre, puoi usare random_state per selezionare i record in modo casuale.

# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(cancer.data, cancer.target, test_size=0.3,random_state=109) # 70% training and 30% test

Generazione del modello

Costruiamo un modello di support vector machine. Per prima cosa, importa il modulo SVM e crea un oggetto support vector classifier passando come argomento il kernel lineare nella funzione SVC().

Poi addestra il modello sul training set usando fit() ed esegui la previsione sul test set usando predict().

#Import svm model
from sklearn import svm

#Create a svm Classifier
clf = svm.SVC(kernel='linear') # Linear Kernel

#Train the model using the training sets
clf.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = clf.predict(X_test)

Valutazione del modello

Stimiamo con quanta accuratezza il classificatore o modello può prevedere il tumore al seno delle pazienti.

L’accuratezza può essere calcolata confrontando i valori reali del test set con i valori previsti.

#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics

# Model Accuracy: how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
Accuracy: 0.9649122807017544

Hai ottenuto un tasso di classificazione del 96,49%, considerato un’ottima accuratezza.

Per una valutazione ulteriore, puoi anche controllare precision e recall del modello.

# Model Precision: what percentage of positive tuples are labeled as such?
print("Precision:",metrics.precision_score(y_test, y_pred))

# Model Recall: what percentage of positive tuples are labelled as such?
print("Recall:",metrics.recall_score(y_test, y_pred))
Precision: 0.9811320754716981
Recall: 0.9629629629629629

Hai ottenuto una precision del 98% e un recall del 96%, valori considerati molto buoni.

Tuning degli iperparametri

  • Kernel: La funzione principale del kernel è trasformare i dati di input del dataset nella forma richiesta. Esistono vari tipi di funzioni come lineare, polinomiale e radial basis function (RBF). Polinomiale e RBF sono utili per iperpiani non lineari. I kernel polinomiale e RBF calcolano la linea di separazione in dimensioni superiori. In alcune applicazioni, è consigliabile usare un kernel più complesso per separare classi curve o non lineari. Questa trasformazione può portare a classificatori più accurati.
  • Regolarizzazione: Il parametro di regolarizzazione C in Scikit-learn per Python è usato per mantenere la regolarizzazione. Qui C è il parametro di penalizzazione, che rappresenta la misclassificazione o il termine di errore. Il termine di misclassificazione o errore indica all’ottimizzazione SVM quanta parte di errore è tollerabile. È così che puoi controllare il trade-off tra limite decisionale e termine di misclassificazione. Un valore piccolo di C crea un iperpiano a margine piccolo e un valore grande di C crea un iperpiano a margine grande.
  • Gamma: Un valore basso di gamma adatterà debolmente il dataset di training, mentre un valore alto di gamma lo adatterà esattamente, causando overfitting. In altre parole, un valore basso di gamma considera solo i punti vicini nel calcolo della linea di separazione, mentre un valore alto di gamma considera tutti i punti dati nel calcolo della linea di separazione.

Vantaggi

I classificatori SVM offrono buona accuratezza ed eseguono previsioni più veloci rispetto all’algoritmo di Naïve Bayes. Usano anche meno memoria perché impiegano un sottoinsieme di punti di training nella fase decisionale. Le SVM funzionano bene con un chiaro margine di separazione e in spazi ad alta dimensionalità.

Svantaggi

Le SVM non sono adatte a dataset di grandi dimensioni a causa dell’elevato tempo di addestramento e richiedono più tempo di training rispetto a Naïve Bayes. Lavorano male con classi sovrapposte e sono sensibili al tipo di kernel utilizzato.

Conclusione

Congratulazioni, sei arrivato alla fine di questo tutorial!

In questo tutorial hai visto molto sulle Support Vector Machines: come funzionano, i kernel, il tuning degli iperparametri, la costruzione del modello e la valutazione sul dataset del cancro al seno usando il pacchetto Scikit-learn. Hai anche visto vantaggi e svantaggi. Spero tu abbia imparato qualcosa di utile!

Per saperne di più su questo tipo di classificatori, dai un’occhiata al nostro corso Linear Classifiers in Python. Introduce altri tipi di regressione e funzioni di perdita, oltre alle Support Vector Machines.

Attendo i tuoi feedback o domande. Puoi lasciare un commento e farò del mio meglio per risponderti.

Argomenti
Machine Learning
Data Science
Python

Corsi su Scikit-learn

Corso

Apprendimento non supervisionato in Python

4 ore
185.3K
Impara a raggruppare, trasformare, visualizzare ed estrarre informazioni utili da set di dati non etichettati usando scikit-learn e scipy.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

Mostra AltroMostra Altro

