

SVM एक रोमांचक एल्गोरिदम है और इसके सिद्धांत अपेक्षाकृत सरल हैं। क्लासिफायर सबसे बड़े मार्जिन वाले हाइपरप्लेन का उपयोग करके डेटा पॉइंट्स को अलग करता है। इसी कारण SVM क्लासिफायर को डिस्क्रिमिनेटिव क्लासिफायर भी कहा जाता है। SVM एक ऑप्टिमल हाइपरप्लेन ढूंढता है जो नए डेटा पॉइंट्स को वर्गीकृत करने में मदद करता है।
इस ट्यूटोरियल में, आप निम्नलिखित विषयों को कवर करने जा रहे हैं:
- सपोर्ट वेक्टर मशीनें
- यह कैसे काम करता है?
- कर्नेल्स
- Scikit-learn में क्लासिफायर बनाना
- हाइपरपैरामीटर ट्यूनिंग
- फायदे और नुकसान
Scikit-learn के साथ सपोर्ट वेक्टर मशीनों पर हमारे कोर्स के इस वीडियो में और अधिक देखें और सीखें।
सपोर्ट वेक्टर मशीनें
आम तौर पर, सपोर्ट वेक्टर मशीनों को एक क्लासिफिकेशन दृष्टिकोण माना जाता है, लेकिन इसे क्लासिफिकेशन और रिग्रेशन दोनों प्रकार की समस्याओं में लागू किया जा सकता है। यह कई सतत और श्रेणीबद्ध चर को आसानी से संभाल सकता है। SVM बहु-आयामी स्पेस में अलग-अलग क्लासों को अलग करने के लिए एक हाइपरप्लेन बनाता है। SVM एक इटरटिव तरीके से ऑप्टिमल हाइपरप्लेन जनरेट करता है, जिसका उपयोग त्रुटि को न्यूनतम करने के लिए किया जाता है। SVM का मूल विचार अधिकतम मार्जिनल हाइपरप्लेन (MMH) ढूंढना है जो डेटासेट को क्लासों में सबसे अच्छे तरीके से विभाजित करे।
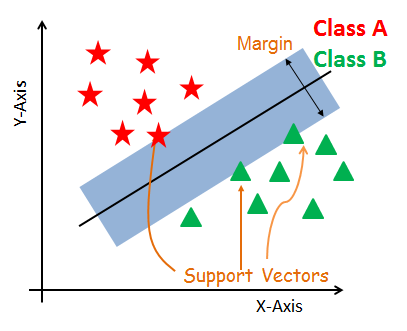
सपोर्ट वेक्टर
सपोर्ट वेक्टर वे डेटा पॉइंट्स हैं जो हाइपरप्लेन के सबसे करीब होते हैं। ये पॉइंट्स मार्जिन की गणना करके पृथक्करण रेखा को बेहतर तरीके से परिभाषित करते हैं। ये पॉइंट्स क्लासिफायर के निर्माण में अधिक प्रासंगिक होते हैं।
हाइपरप्लेन
हाइपरप्लेन एक निर्णय प्लेन है जो अलग-अलग क्लास सदस्यताओं वाले ऑब्जेक्ट्स के सेट के बीच विभाजन करता है।
मार्जिन
मार्जिन निकटतम क्लास पॉइंट्स पर दो रेखाओं के बीच का अंतराल है। इसे रेखा से सपोर्ट वेक्टर या निकटतम बिंदुओं तक के लम्बवत दूरी के रूप में गणना किया जाता है। यदि क्लासों के बीच मार्जिन बड़ा है, तो इसे अच्छा मार्जिन माना जाता है; छोटा मार्जिन खराब मार्जिन है।
SVM कैसे काम करता है?
मुख्य उद्देश्य दिए गए डेटासेट को संभवतः सबसे अच्छे तरीके से अलग करना है। दोनों ओर के निकटतम बिंदुओं के बीच की दूरी को मार्जिन कहा जाता है। उद्देश्य यह है कि दिए गए डेटासेट में सपोर्ट वेक्टर के बीच अधिकतम संभव मार्जिन वाला हाइपरप्लेन चुना जाए। SVM निम्नलिखित चरणों में अधिकतम मार्जिनल हाइपरप्लेन खोजता है:
-
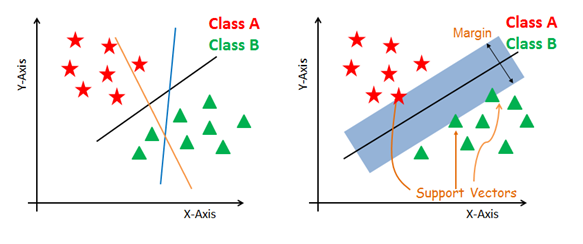
ऐसे हाइपरप्लेन जनरेट करें जो क्लासों को सबसे अच्छे तरीके से अलग करें। बाएँ चित्र में काले, नीले और नारंगी तीन हाइपरप्लेन दिखाए गए हैं। यहाँ, नीले और नारंगी में उच्च क्लासिफिकेशन त्रुटि है, लेकिन काला दोनों क्लासों को सही तरीके से अलग कर रहा है।
-
दाएँ चित्र में दिखाए अनुसार, दोनों ओर के निकटतम डेटा पॉइंट्स से अधिकतम पृथक्करण वाला सही हाइपरप्लेन चुनें।
नॉन-लीनियर और इनसीपेरेबल प्लेनों से निपटना
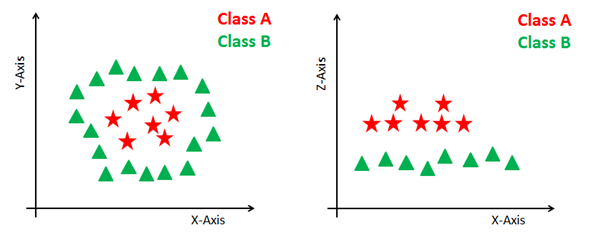
कुछ समस्याओं को नीचे दिए गए चित्र (बाईं ओर) में दिखाए अनुसार लीनियर हाइपरप्लेन का उपयोग करके हल नहीं किया जा सकता।
ऐसी स्थिति में, SVM इनपुट स्पेस को अधिक आयामी स्पेस में बदलने के लिए कर्नेल ट्रिक का उपयोग करता है जैसा कि दाईं ओर दिखाया गया है। डेटा पॉइंट्स को x-अक्ष और z-अक्ष पर प्लॉट किया जाता है (Z x और y दोनों का वर्गों का योग है: z=x^2=y^2)। अब आप इन बिंदुओं को लीनियर सेपरेशन का उपयोग करके आसानी से अलग कर सकते हैं।
SVM कर्नेल्स
SVM एल्गोरिदम को व्यावहारिक रूप से कर्नेल का उपयोग करके लागू किया जाता है। कर्नेल इनपुट डेटा स्पेस को आवश्यक रूप में बदलता है। SVM एक तकनीक का उपयोग करता है जिसे कर्नेल ट्रिक कहा जाता है। यहाँ, कर्नेल कम-आयामी इनपुट स्पेस को उच्च आयामी स्पेस में बदलता है। अन्य शब्दों में, आप कह सकते हैं कि यह नॉन-सेपेरेबल समस्या को उसमें और आयाम जोड़कर सेपेरेबल समस्या में बदल देता है। यह विशेष रूप से नॉन-लीनियर सेपरेशन समस्याओं में उपयोगी है। कर्नेल ट्रिक आपको अधिक सटीक क्लासिफायर बनाने में मदद करती है।
- लीनियर कर्नेल लीनियर कर्नेल को किसी भी दो दिए गए ऑब्जर्वेशनों के बीच सामान्य डॉट प्रोडक्ट की तरह उपयोग किया जा सकता है। दो वेक्टरों के बीच प्रोडक्ट प्रत्येक इनपुट मानों की जोड़ी के गुणनफल के योग के बराबर होता है।
K(x, xi) = sum(x * xi)
- पॉलीनोमियल कर्नेल पॉलीनोमियल कर्नेल लीनियर कर्नेल का एक अधिक सामान्यीकृत रूप है। पॉलीनोमियल कर्नेल वक्र या नॉन-लीनियर इनपुट स्पेस को अलग कर सकता है।
K(x,xi) = 1 + sum(x * xi)^d
जहाँ d पॉलीनोमियल की डिग्री है। d=1 लीनियर ट्रांसफॉर्मेशन के समान है। डिग्री को लर्निंग एल्गोरिदम में मैन्युअली निर्दिष्ट करना होता है।
- रेडियल बेसिस फंक्शन कर्नेल रेडियल बेसिस फंक्शन कर्नेल एक लोकप्रिय कर्नेल फंक्शन है जो आमतौर पर सपोर्ट वेक्टर मशीन क्लासिफिकेशन में उपयोग किया जाता है। RBF इनपुट स्पेस को अनंत आयामी स्पेस में मैप कर सकता है।
K(x,xi) = exp(-gamma * sum((x – xi^2))
यहाँ gamma एक पैरामीटर है, जिसकी रेंज 0 से 1 तक होती है। gamma का उच्च मान प्रशिक्षण डेटासेट को पूरी तरह फिट करेगा, जिससे ओवर-फिटिंग होती है। Gamma=0.1 एक अच्छा डिफ़ॉल्ट मान माना जाता है। gamma का मान लर्निंग एल्गोरिदम में मैन्युअली निर्दिष्ट करना होता है।
Scikit-learn में क्लासिफायर बनाना
अभी तक, आपने SVM की थिअरी के बारे में सीखा है। अब आप Python में scikit-learn का उपयोग करके इसके इम्प्लीमेंटेशन के बारे में सीखेंगे।
मॉडल बिल्डिंग भाग में, आप कैंसर डेटासेट का उपयोग कर सकते हैं, जो एक बहुत प्रसिद्ध मल्टी-क्लास क्लासिफिकेशन समस्या है। यह डेटासेट ब्रेस्ट मास के फाइन नीडल एस्पिरेट (FNA) की डिजिटाइज्ड इमेज से संगणित किया गया है। ये इमेज में मौजूद सेल न्यूक्लिआई की विशेषताओं का वर्णन करते हैं।
डेटासेट में 30 फीचर्स (mean radius, mean texture, mean perimeter, mean area, mean smoothness, mean compactness, mean concavity, mean concave points, mean symmetry, mean fractal dimension, radius error, texture error, perimeter error, area error, smoothness error, compactness error, concavity error, concave points error, symmetry error, fractal dimension error, worst radius, worst texture, worst perimeter, worst area, worst smoothness, worst compactness, worst concavity, worst concave points, worst symmetry, और worst fractal dimension) और एक टारगेट (कैंसर का प्रकार) शामिल हैं।
इस डेटा में कैंसर की दो प्रकार की क्लासें हैं: malignant (हानिकारक) और benign (हानिकारक नहीं)। यहाँ, आप कैंसर के प्रकार को वर्गीकृत करने के लिए एक मॉडल बना सकते हैं। यह डेटासेट scikit-learn लाइब्रेरी में उपलब्ध है या आप इसे UCI Machine Learning Library से भी डाउनलोड कर सकते हैं।
इस ट्यूटोरियल का कोड ऑनलाइन चलाएं और संपादित करें
कोड चलाएंडेटा लोड करना
चलिए पहले आवश्यक डेटासेट लोड करते हैं जिसका आप उपयोग करेंगे।
#Import scikit-learn dataset library
from sklearn import datasets
#Load dataset
cancer = datasets.load_breast_cancer()
डेटा का अन्वेषण
डेटासेट लोड करने के बाद, आप इसके बारे में थोड़ा और जानना चाहेंगे। आप फीचर और टारगेट के नाम देख सकते हैं।
# print the names of the 13 features
print("Features: ", cancer.feature_names)
# print the label type of cancer('malignant' 'benign')
print("Labels: ", cancer.target_names)
Features: ['mean radius' 'mean texture' 'mean perimeter' 'mean area'
'mean smoothness' 'mean compactness' 'mean concavity'
'mean concave points' 'mean symmetry' 'mean fractal dimension'
'radius error' 'texture error' 'perimeter error' 'area error'
'smoothness error' 'compactness error' 'concavity error'
'concave points error' 'symmetry error' 'fractal dimension error'
'worst radius' 'worst texture' 'worst perimeter' 'worst area'
'worst smoothness' 'worst compactness' 'worst concavity'
'worst concave points' 'worst symmetry' 'worst fractal dimension']
Labels: ['malignant' 'benign']
आइए इसे और थोड़ा देखें। आप shape का उपयोग करके डेटासेट का आकार भी देख सकते हैं।
# print data(feature)shape
cancer.data.shape
(569, 30)
आइए फीचर सेट के शीर्ष 5 रिकॉर्ड देखते हैं।
# print the cancer data features (top 5 records)
print(cancer.data[0:5])
[[1.799e+01 1.038e+01 1.228e+02 1.001e+03 1.184e-01 2.776e-01 3.001e-01
1.471e-01 2.419e-01 7.871e-02 1.095e+00 9.053e-01 8.589e+00 1.534e+02
6.399e-03 4.904e-02 5.373e-02 1.587e-02 3.003e-02 6.193e-03 2.538e+01
1.733e+01 1.846e+02 2.019e+03 1.622e-01 6.656e-01 7.119e-01 2.654e-01
4.601e-01 1.189e-01]
[2.057e+01 1.777e+01 1.329e+02 1.326e+03 8.474e-02 7.864e-02 8.690e-02
7.017e-02 1.812e-01 5.667e-02 5.435e-01 7.339e-01 3.398e+00 7.408e+01
5.225e-03 1.308e-02 1.860e-02 1.340e-02 1.389e-02 3.532e-03 2.499e+01
2.341e+01 1.588e+02 1.956e+03 1.238e-01 1.866e-01 2.416e-01 1.860e-01
2.750e-01 8.902e-02]
[1.969e+01 2.125e+01 1.300e+02 1.203e+03 1.096e-01 1.599e-01 1.974e-01
1.279e-01 2.069e-01 5.999e-02 7.456e-01 7.869e-01 4.585e+00 9.403e+01
6.150e-03 4.006e-02 3.832e-02 2.058e-02 2.250e-02 4.571e-03 2.357e+01
2.553e+01 1.525e+02 1.709e+03 1.444e-01 4.245e-01 4.504e-01 2.430e-01
3.613e-01 8.758e-02]
[1.142e+01 2.038e+01 7.758e+01 3.861e+02 1.425e-01 2.839e-01 2.414e-01
1.052e-01 2.597e-01 9.744e-02 4.956e-01 1.156e+00 3.445e+00 2.723e+01
9.110e-03 7.458े-02 5.661e-02 1.867e-02 5.963e-02 9.208e-03 1.491e+01
2.650e+01 9.887e+01 5.677e+02 2.098e-01 8.663e-01 6.869e-01 2.575e-01
6.638e-01 1.730e-01]
[2.029e+01 1.434e+01 1.351e+02 1.297e+03 1.003e-01 1.328e-01 1.980e-01
1.043e-01 1.809e-01 5.883e-02 7.572e-01 7.813e-01 5.438e+00 9.444e+01
1.149e-02 2.461e-02 5.688e-02 1.885e-02 1.756e-02 5.115e-03 2.254e+01
1.667e+01 1.522e+02 1.575e+03 1.374e-01 2.050e-01 4.000e-01 1.625e-01
2.364e-01 7.678e-02]]
आइए टारगेट सेट पर नज़र डालें।
# print the cancer labels (0:malignant, 1:benign)
print(cancer.target)
[0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
1 0 0 0 0 0 0 0 0 1 0 1 1 1 1 1 0 0 1 0 0 1 1 1 1 0 1 0 0 1 1 1 1 0 1 0 0
1 0 1 0 0 1 1 1 0 0 1 0 0 0 1 1 1 0 1 1 0 0 1 1 1 0 0 1 1 1 1 0 1 1 0 1 1
1 1 1 1 1 1 0 0 0 1 0 0 1 1 1 0 0 1 0 1 0 0 1 0 0 1 1 0 1 1 0 1 1 1 1 0 1
1 1 1 1 1 1 1 1 0 1 1 1 1 0 0 1 0 1 1 0 0 1 1 0 0 1 1 1 1 0 1 1 0 0 0 1 0
1 0 1 1 1 0 1 1 0 0 1 0 0 0 0 1 0 0 0 1 0 1 0 1 1 0 1 0 0 0 0 1 1 0 0 1 1
1 0 1 1 1 1 1 0 0 1 1 0 1 1 0 0 1 0 1 1 1 1 0 1 1 1 1 1 0 1 0 0 0 0 0 0 0
0 0 0 0 0 0 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1
1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0 1 0 1 1 1 1 0 0 0 1 1
1 1 0 1 0 1 0 1 1 1 0 1 1 1 1 1 1 1 0 0 0 1 1 1 1 1 1 1 1 1 1 1 0 0 1 0 0
0 1 0 0 1 1 1 1 1 0 1 1 1 1 1 0 1 1 1 0 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1
1 0 1 1 1 1 1 0 1 1 0 1 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 0 1 1 1 1 1 0 1 1
0 1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1 1 1 1 1 0 1
1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 0 0 1 0 1 0 1 1 1 1 1 0 1 1 0 1 0 1 0 0
1 1 1 0 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1 1 1 1 0 0 0 0 0 0 1]
डेटा विभाजित करना
मॉडल के प्रदर्शन को समझने के लिए, डेटासेट को प्रशिक्षण सेट और परीक्षण सेट में विभाजित करना एक अच्छी रणनीति है।
train_test_split() फंक्शन का उपयोग करके डेटासेट को विभाजित करें। आपको 3 पैरामीटर पास करने होंगे: फीचर्स, टारगेट, और टेस्ट सेट का आकार। अतिरिक्त रूप से, आप रिकार्ड्स को यादृच्छिक रूप से चुनने के लिए random_state का उपयोग कर सकते हैं।
# Import train_test_split function
from sklearn.model_selection import train_test_split
# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(cancer.data, cancer.target, test_size=0.3,random_state=109) # 70% training and 30% test
मॉडल बनाना
आइए सपोर्ट वेक्टर मशीन मॉडल बनाते हैं। सबसे पहले, SVM मॉड्यूल इम्पोर्ट करें और SVC() फंक्शन में kernel आर्गुमेंट को लीनियर कर्नेल के रूप में पास करके सपोर्ट वेक्टर क्लासिफायर ऑब्जेक्ट बनाएं।
फिर, अपने मॉडल को ट्रेन सेट पर fit() का उपयोग करके फिट करें और टेस्ट सेट पर predict() का उपयोग करके प्रेडिक्शन करें।
#Import svm model
from sklearn import svm
#Create a svm Classifier
clf = svm.SVC(kernel='linear') # Linear Kernel
#Train the model using the training sets
clf.fit(X_train, y_train)
#Predict the response for test dataset
y_pred = clf.predict(X_test)
मॉडल का मूल्यांकन
आइए अनुमान लगाते हैं कि क्लासिफायर या मॉडल मरीजों के ब्रेस्ट कैंसर की भविष्यवाणी कितनी सटीकता से कर सकता है।
सटीकता को वास्तविक टेस्ट सेट मानों और भविष्यवाणी किए गए मानों की तुलना करके गणना किया जा सकता है।
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy: how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
Accuracy: 0.9649122807017544
अच्छा, आपको 96.49% का क्लासिफिकेशन रेट मिला, जिसे बहुत अच्छी सटीकता माना जाता है।
आगे के मूल्यांकन के लिए, आप मॉडल की प्रिसिजन और रिकॉल भी जाँच सकते हैं।
# Model Precision: what percentage of positive tuples are labeled as such?
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall: what percentage of positive tuples are labelled as such?
print("Recall:",metrics.recall_score(y_test, y_pred))
Precision: 0.9811320754716981
Recall: 0.9629629629629629
अच्छा, आपको 98% की प्रिसिजन और 96% का रिकॉल मिला, जिन्हें बहुत अच्छे मान माना जाता है।
हाइपरपैरामीटर ट्यूनिंग
- कर्नेल: कर्नेल का मुख्य कार्य दिए गए डेटासेट के इनपुट डेटा को आवश्यक रूप में बदलना है। लीनियर, पॉलीनोमियल और रेडियल बेसिस फंक्शन (RBF) जैसी विभिन्न प्रकार की फंक्शंस होती हैं। पॉलीनोमियल और RBF नॉन-लीनियर हाइपरप्लेन के लिए उपयोगी हैं। पॉलीनोमियल और RBF कर्नेल उच्च आयाम में सेपरेशन लाइन की गणना करते हैं। कुछ अनुप्रयोगों में, मुड़ी हुई या नॉन-लीनियर क्लासों को अलग करने के लिए अधिक जटिल कर्नेल का उपयोग करने का सुझाव दिया जाता है। यह ट्रांसफॉर्मेशन अधिक सटीक क्लासिफायर तक ले जा सकता है।
- रेग्युलराइज़ेशन: Python के Scikit-learn में रेग्युलराइज़ेशन पैरामीटर C का उपयोग रेग्युलराइज़ेशन बनाए रखने के लिए किया जाता है। यहाँ C पेनल्टी पैरामीटर है, जो मिसक्लासिफिकेशन या एरर टर्म का प्रतिनिधित्व करता है। मिसक्लासिफिकेशन या एरर टर्म SVM ऑप्टिमाइज़ेशन को बताता है कि कितनी त्रुटि स्वीकार्य है। इसी तरह आप निर्णय सीमा और मिसक्लासिफिकेशन टर्म के बीच ट्रेड-ऑफ को नियंत्रित कर सकते हैं। C का छोटा मान छोटा-मार्जिन हाइपरप्लेन बनाता है और C का बड़ा मान बड़ा-मार्जिन हाइपरप्लेन बनाता है।
- Gamma: Gamma का कम मान प्रशिक्षण डेटासेट को ढीले ढंग से फिट करेगा, जबकि gamma का उच्च मान प्रशिक्षण डेटासेट को बिल्कुल फिट करेगा, जिससे ओवर-फिटिंग होती है। अन्य शब्दों में, आप कह सकते हैं कि gamma का कम मान सेपरेशन लाइन की गणना में केवल आस-पास के बिंदुओं पर विचार करता है, जबकि gamma का बड़ा मान सेपरेशन लाइन की गणना में सभी डेटा पॉइंट्स पर विचार करता है।
फायदे
SVM क्लासिफायर अच्छी सटीकता प्रदान करते हैं और Naïve Bayes एल्गोरिदम की तुलना में तेज़ प्रेडिक्शन करते हैं। वे कम मेमोरी का उपयोग भी करते हैं क्योंकि वे निर्णय चरण में प्रशिक्षण बिंदुओं के एक सबसेट का उपयोग करते हैं। SVM स्पष्ट पृथक्करण मार्जिन और उच्च-आयामी स्पेस में अच्छी तरह काम करता है।
नुकसान
SVM बड़े डेटासेट के लिए उपयुक्त नहीं है क्योंकि इसका प्रशिक्षण समय अधिक होता है और यह Naïve Bayes की तुलना में प्रशिक्षण में अधिक समय लेता है। यह ओवरलैपिंग क्लासों के साथ खराब काम करता है और उपयोग किए गए कर्नेल के प्रकार के प्रति भी संवेदनशील होता है।
निष्कर्ष
बधाई हो, आप इस ट्यूटोरियल के अंत तक पहुँच गए हैं!
इस ट्यूटोरियल में, आपने सपोर्ट वेक्टर मशीन एल्गोरिदम, इसका काम करने का तरीका, कर्नेल्स, हाइपरपैरामीटर ट्यूनिंग, Scikit-learn पैकेज का उपयोग करके ब्रेस्ट कैंसर डेटासेट पर मॉडल बनाना और मूल्यांकन जैसे कई पहलुओं को कवर किया। आपने इसके फायदे और नुकसान भी कवर किए। आशा है कि आपने कुछ मूल्यवान सीखा होगा!
इस प्रकार के क्लासिफायरों के बारे में और जानने के लिए, आपको हमारा Linear Classifiers in Python कोर्स देखना चाहिए। यह अन्य प्रकार के रिग्रेशन और लॉस फंक्शंस के साथ-साथ सपोर्ट वेक्टर मशीनों का परिचय कराता है।
मुझे आपके किसी भी फीडबैक या प्रश्न का इंतजार रहेगा। आप टिप्पणी छोड़कर प्रश्न पूछ सकते हैं और मैं यथासंभव उत्तर देने की कोशिश करूंगा/करूंगी।
लॉजिस्टिक रिग्रेशन और डिसीजन ट्री जैसे अन्य क्लासिफायरों की तुलना में SVM बहुत अधिक सटीकता प्रदान करता है। यह नॉन-लीनियर इनपुट स्पेस को संभालने के लिए अपने कर्नेल ट्रिक के लिए जाना जाता है। इसका उपयोग फेस डिटेक्शन, इंट्रूजन डिटेक्शन, ईमेल, समाचार लेख और वेब पेजों का वर्गीकरण, जीन का वर्गीकरण, और हस्तलेखन पहचान जैसी अनेक अनुप्रयोगों में किया जाता है।
इस ट्यूटोरियल में, आप Python में scikit-learn का उपयोग करेंगे। यदि आप इस Python पैकेज के बारे में अधिक जानना चाहते हैं, तो मैं आपको हमारा Supervised Learning with scikit-learn कोर्स देखने की सलाह देता/देती हूं।