Ana içeriğe atla

Scikit-learn ile Destek Vektör Makineleri Eğitimi

Bu eğitimde, en popüler ve yaygın kullanılan denetimli makine öğrenmesi algoritmalarından biri olan Destek Vektör Makinelerini öğreneceksiniz.
Güncel 3 Eki 2026  · 15 dk. oku

Yapay Zeka ile Keşfedin

ChatGPTClaudePerplexity

SVM, lojistik regresyon ve karar ağaçları gibi diğer sınıflandırıcılara kıyasla çok yüksek doğruluk sunar. Doğrusal olmayan girdi uzaylarını ele almak için kernel hilesiyle bilinir. Yüz tanıma, izinsiz giriş tespiti, e-postaların, haber makalelerinin ve web sayfalarının sınıflandırılması, genlerin sınıflandırılması ve el yazısı tanıma gibi çeşitli uygulamalarda kullanılır.

Bu eğitimde Python'da scikit-learn kullanacaksınız. Bu Python paketi hakkında daha fazla bilgi edinmek isterseniz, scikit-learn ile Denetimli Öğrenme kursumuza göz atmanızı öneririm.

SVM heyecan verici bir algoritmadır ve kavramları nispeten basittir. Sınıflandırıcı, veri noktalarını en büyük marja sahip bir hiper düzlem kullanarak ayırır. Bu yüzden bir SVM sınıflandırıcısı ayrımcı sınıflandırıcı olarak da bilinir. SVM, yeni veri noktalarını sınıflandırmaya yardımcı olan optimal bir hiper düzlem bulur.

Bu eğitimde aşağıdaki konuları ele alacaksınız:

Kursumuzdaki bu videoda Scikit-learn ile Destek Vektör Makineleri hakkında izleyin ve daha fazla bilgi edinin.

Destek Vektör Makineleri

Genel olarak Destek Vektör Makineleri bir sınıflandırma yaklaşımı olarak kabul edilir, ancak hem sınıflandırma hem de regresyon problemlerinde kullanılabilir. Birden çok sürekli ve kategorik değişkeni kolayca ele alır. SVM, farklı sınıfları ayırmak için çok boyutlu bir uzayda bir hiper düzlem inşa eder. SVM, hatayı en aza indirmek için kullanılan optimal hiper düzlemi yinelemeli bir şekilde üretir. SVM'nin temel fikri, veri kümesini sınıflara en iyi şekilde bölen maksimum marjinal hiper düzlemi (MMH) bulmaktır.
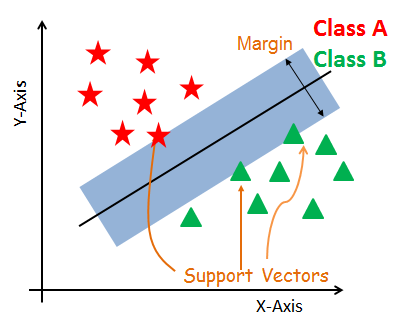
Destek Vektörleri

Destek Vektörleri

Destek vektörleri, hiper düzleme en yakın olan veri noktalarıdır. Bu noktalar, marjları hesaplayarak ayırıcı çizgiyi daha iyi tanımlar. Sınıflandırıcının kurulumu için en ilgili noktalar bunlardır.

Hiper Düzlem

Hiper düzlem, farklı sınıf üyeliklerine sahip bir nesne kümesini birbirinden ayıran karar düzlemidir.

Marj

Marj, en yakın sınıf noktaları üzerindeki iki çizgi arasındaki boşluktur. Bu, çizgiden destek vektörlerine veya en yakın noktalara olan dik uzaklık olarak hesaplanır. Sınıflar arasındaki marj daha büyükse iyi bir marj, daha küçükse kötü bir marj olarak kabul edilir.

SVM nasıl çalışır?

Ana amaç, verilen veri kümesini mümkün olan en iyi şekilde ayırmaktır. Her iki taraftaki en yakın noktalar arasındaki mesafeye marj denir. Amaç, verilen veri kümesindeki destek vektörleri arasındaki marjı mümkün olduğunca maksimize eden bir hiper düzlem seçmektir. SVM, aşağıdaki adımlarla maksimum marjinal hiper düzlemi arar:

  1. Sınıfları en iyi şekilde ayıran hiper düzlemler üretin. Sol taraftaki şekilde siyah, mavi ve turuncu olmak üzere üç hiper düzlem gösterilmektedir. Burada mavi ve turuncu daha yüksek sınıflandırma hatasına sahiptir, ancak siyah olan iki sınıfı doğru şekilde ayırmaktadır.

  2. Sağ taraftaki şekilde gösterildiği gibi, her iki taraftaki en yakın veri noktalarından en fazla ayrımı sağlayan doğru hiper düzlemi seçin.
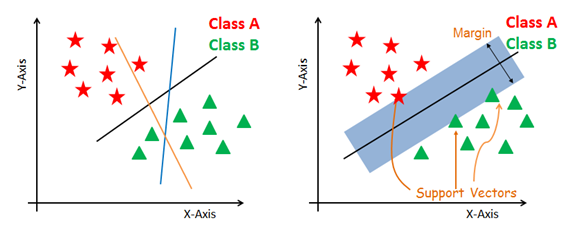
Doğrusal Ayırıcı

Doğrusal olmayan ve ayrılamayan düzlemlerle başa çıkma

Bazı problemler, aşağıdaki şekilde (sol tarafta) gösterildiği gibi doğrusal bir hiper düzlem kullanılarak çözülemez.

Böyle bir durumda, SVM girdiyi sağda gösterildiği gibi daha yüksek boyutlu bir uzaya dönüştürmek için bir kernel hilesi kullanır. Veri noktaları x ekseni ve z ekseninde çizilir (Z, x ve y'nin kareleri toplamıdır: z=x^2=y^2). Artık bu noktaları doğrusal bir ayrımla kolayca ayırabilirsiniz.
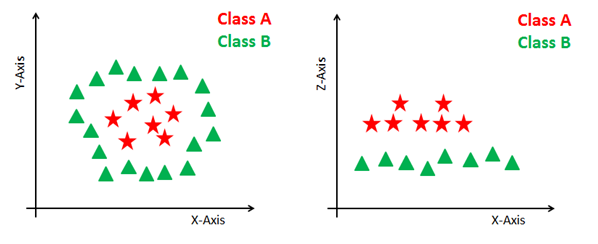
Daha Yüksek Boyut

SVM Kernel'leri

SVM algoritması pratikte bir kernel kullanılarak uygulanır. Kernel, bir girdi veri uzayını gerekli forma dönüştürür. SVM, kernel hilesi adı verilen bir teknik kullanır. Burada kernel, düşük boyutlu bir girdi uzayını daha yüksek boyutlu bir uzaya dönüştürür. Başka bir deyişle, daha fazla boyut ekleyerek ayrılamayan bir problemi ayrılabilir hale getirir diyebilirsiniz. Doğrusal olmayan ayrım problemlerinde en kullanışlı olandır. Kernel hilesi, daha doğru bir sınıflandırıcı oluşturmanıza yardımcı olur.

  • Doğrusal Kernel Doğrusal bir kernel, verilen herhangi iki gözlem için normal noktasal çarpım olarak kullanılabilir. İki vektör arasındaki çarpım, her bir girdi değeri çiftinin çarpımlarının toplamıdır.
K(x, xi) = sum(x * xi)
  • Polinom Kernel Polinom kernel, doğrusal kernelin daha genelleştirilmiş bir biçimidir. Polinom kernel, eğrisel veya doğrusal olmayan girdi uzayını ayırt edebilir.
K(x,xi) = 1 + sum(x * xi)^d

Burada d, polinomun derecesidir. d=1, doğrusal dönüşüme benzer. Derece, öğrenme algoritmasında elle belirtilmelidir.

  • Radyal Tabanlı Fonksiyon Kernel Radyal tabanlı fonksiyon (RBF) kernel, destek vektör makinesi sınıflandırmasında yaygın olarak kullanılan popüler bir kernel fonksiyonudur. RBF, bir girdi uzayını sonsuz boyutlu bir uzaya eşleyebilir.
K(x,xi) = exp(-gamma * sum((x – xi^2))

Burada gamma 0 ile 1 arasında bir parametredir. Daha yüksek gamma değeri, eğitim veri kümesini mükemmel şekilde uydurur ve bu da aşırı uyuma neden olur. Gamma=0.1 iyi bir varsayılan değer olarak kabul edilir. Gamma değeri, öğrenme algoritmasında elle belirtilmelidir.

Scikit-learn ile Sınıflandırıcı Oluşturma

Şimdiye kadar SVM'nin teorik arka planını öğrendiniz. Şimdi Python'da scikit-learn kullanarak nasıl uygulanacağını öğreneceksiniz.

Model kurma kısmında, çok ünlü bir çok sınıflı sınıflandırma problemi olan kanser veri kümesini kullanabilirsiniz. Bu veri kümesi, bir meme kitlesinin ince iğne aspirasyonu (FNA) ile dijitalleştirilmiş bir görüntüsünden elde edilmiştir. Görüntüde bulunan hücre çekirdeklerinin özelliklerini açıklarlar.

Veri kümesi 30 özelliğe (ortalama yarıçap, ortalama doku, ortalama çevre, ortalama alan, ortalama pürüzsüzlük, ortalama sıkılık, ortalama içbükeylik, ortalama içbükey noktalar, ortalama simetri, ortalama fraktal boyut, yarıçap hatası, doku hatası, çevre hatası, alan hatası, pürüzsüzlük hatası, sıkılık hatası, içbükeylik hatası, içbükey noktalar hatası, simetri hatası, fraktal boyut hatası, en kötü yarıçap, en kötü doku, en kötü çevre, en kötü alan, en kötü pürüzsüzlük, en kötü sıkılık, en kötü içbükeylik, en kötü içbükey noktalar, en kötü simetri ve en kötü fraktal boyut) ve bir hedefe (kanser türü) sahiptir.

Bu verilerde iki tip kanser sınıfı vardır: malign (zararlı) ve benign (zararsız). Burada kanser türünü sınıflandırmak için bir model oluşturabilirsiniz. Veri kümesi scikit-learn kütüphanesinde mevcuttur veya UCI Makine Öğrenmesi Kütüphanesi'nden de indirebilirsiniz.

Bu eğitimdeki kodu çevrimiçi olarak çalıştırın ve düzenleyin

Kodu çalıştır

Veri Yükleme

Öncelikle kullanacağınız gerekli veri kümesini yükleyelim.

#Import scikit-learn dataset library
from sklearn import datasets

#Load dataset
cancer = datasets.load_breast_cancer()

Veriyi Keşfetme

Veri kümesini yükledikten sonra, onun hakkında biraz daha fazla şey bilmek isteyebilirsiniz. Özellik ve hedef adlarını kontrol edebilirsiniz.

# print the names of the 13 features
print("Features: ", cancer.feature_names)

# print the label type of cancer('malignant' 'benign')
print("Labels: ", cancer.target_names)
Features:  ['mean radius' 'mean texture' 'mean perimeter' 'mean area'
 'mean smoothness' 'mean compactness' 'mean concavity'
 'mean concave points' 'mean symmetry' 'mean fractal dimension'
 'radius error' 'texture error' 'perimeter error' 'area error'
 'smoothness error' 'compactness error' 'concavity error'
 'concave points error' 'symmetry error' 'fractal dimension error'
 'worst radius' 'worst texture' 'worst perimeter' 'worst area'
 'worst smoothness' 'worst compactness' 'worst concavity'
 'worst concave points' 'worst symmetry' 'worst fractal dimension']
Labels:  ['malignant' 'benign']

Biraz daha keşfedelim. shape kullanarak veri kümesinin şeklini de kontrol edebilirsiniz.

# print data(feature)shape
cancer.data.shape
(569, 30)

Özellik kümesinin ilk 5 kaydına bakalım.

# print the cancer data features (top 5 records)
print(cancer.data[0:5])
[[1.799e+01 1.038e+01 1.228e+02 1.001e+03 1.184e-01 2.776e-01 3.001e-01
  1.471e-01 2.419e-01 7.871e-02 1.095e+00 9.053e-01 8.589e+00 1.534e+02
  6.399e-03 4.904e-02 5.373e-02 1.587e-02 3.003e-02 6.193e-03 2.538e+01
  1.733e+01 1.846e+02 2.019e+03 1.622e-01 6.656e-01 7.119e-01 2.654e-01
  4.601e-01 1.189e-01]
 [2.057e+01 1.777e+01 1.329e+02 1.326e+03 8.474e-02 7.864e-02 8.690e-02
  7.017e-02 1.812e-01 5.667e-02 5.435e-01 7.339e-01 3.398e+00 7.408e+01
  5.225e-03 1.308e-02 1.860e-02 1.340e-02 1.389e-02 3.532e-03 2.499e+01
  2.341e+01 1.588e+02 1.956e+03 1.238e-01 1.866e-01 2.416e-01 1.860e-01
  2.750e-01 8.902e-02]
 [1.969e+01 2.125e+01 1.300e+02 1.203e+03 1.096e-01 1.599e-01 1.974e-01
  1.279e-01 2.069e-01 5.999e-02 7.456e-01 7.869e-01 4.585e+00 9.403e+01
  6.150e-03 4.006e-02 3.832e-02 2.058e-02 2.250e-02 4.571e-03 2.357e+01
  2.553e+01 1.525e+02 1.709e+03 1.444e-01 4.245e-01 4.504e-01 2.430e-01
  3.613e-01 8.758e-02]
 [1.142e+01 2.038e+01 7.758e+01 3.861e+02 1.425e-01 2.839e-01 2.414e-01
  1.052e-01 2.597e-01 9.744e-02 4.956e-01 1.156e+00 3.445e+00 2.723e+01
  9.110e-03 7.458e-02 5.661e-02 1.867e-02 5.963e-02 9.208e-03 1.491e+01
  2.650e+01 9.887e+01 5.677e+02 2.098e-01 8.663e-01 6.869e-01 2.575e-01
  6.638e-01 1.730e-01]
 [2.029e+01 1.434e+01 1.351e+02 1.297e+03 1.003e-01 1.328e-01 1.980e-01
  1.043e-01 1.809e-01 5.883e-02 7.572e-01 7.813e-01 5.438e+00 9.444e+01
  1.149e-02 2.461e-02 5.688e-02 1.885e-02 1.756e-02 5.115e-03 2.254e+01
  1.667e+01 1.522e+02 1.575e+03 1.374e-01 2.050e-01 4.000e-01 1.625e-01
  2.364e-01 7.678e-02]]

Hedef kümesine bir göz atalım.

# print the cancer labels (0:malignant, 1:benign)
print(cancer.target)
[0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
 1 0 0 0 0 0 0 0 0 1 0 1 1 1 1 1 0 0 1 0 0 1 1 1 1 0 1 0 0 1 1 1 1 0 1 0 0
 1 0 1 0 0 1 1 1 0 0 1 0 0 0 1 1 1 0 1 1 0 0 1 1 1 0 0 1 1 1 1 0 1 1 0 1 1
 1 1 1 1 1 1 0 0 0 1 0 0 1 1 1 0 0 1 0 1 0 0 1 0 0 1 1 0 1 1 0 1 1 1 1 0 1
 1 1 1 1 1 1 1 1 0 1 1 1 1 0 0 1 0 1 1 0 0 1 1 0 0 1 1 1 1 0 1 1 0 0 0 1 0
 1 0 1 1 1 0 1 1 0 0 1 0 0 0 0 1 0 0 0 1 0 1 0 1 1 0 1 0 0 0 0 1 1 0 0 1 1
 1 0 1 1 1 1 1 0 0 1 1 0 1 1 0 0 1 0 1 1 1 1 0 1 1 1 1 1 0 1 0 0 0 0 0 0 0
 0 0 0 0 0 0 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1
 1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0 1 0 1 1 1 1 0 0 0 1 1
 1 1 0 1 0 1 0 1 1 1 0 1 1 1 1 1 1 1 0 0 0 1 1 1 1 1 1 1 1 1 1 1 0 0 1 0 0
 0 1 0 0 1 1 1 1 1 0 1 1 1 1 1 0 1 1 1 0 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1
 1 0 1 1 1 1 1 0 1 1 0 1 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 0 1 1 1 1 1 0 1 1
 0 1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1 1 1 1 1 0 1
 1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 0 0 1 0 1 0 1 1 1 1 1 0 1 1 0 1 0 1 0 0
 1 1 1 0 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
 1 1 1 1 1 1 1 0 0 0 0 0 0 1]

Veriyi Bölme

Model performansını anlamak için veri kümesini eğitim ve test seti olarak bölmek iyi bir stratejidir.

train_test_split() fonksiyonunu kullanarak veri kümesini bölün. Üç parametre geçirmeniz gerekir: özellikler, hedef ve test_set boyutu. Ek olarak, kayıtları rastgele seçmek için random_state kullanabilirsiniz.

# Import train_test_split function
from sklearn.model_selection import train_test_split

# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(cancer.data, cancer.target, test_size=0.3,random_state=109) # 70% training and 30% test

Model Oluşturma

Bir destek vektör makinesi modeli oluşturalım. Önce SVM modülünü içe aktarın ve SVC() fonksiyonunda kernel argümanını doğrusal kernel olacak şekilde geçirerek bir destek vektör sınıflandırıcısı nesnesi oluşturun.

Ardından, modelinizi fit() ile eğitim seti üzerinde eğitin ve predict() kullanarak test seti üzerinde tahmin yapın.

#Import svm model
from sklearn import svm

#Create a svm Classifier
clf = svm.SVC(kernel='linear') # Linear Kernel

#Train the model using the training sets
clf.fit(X_train, y_train)

#Predict the response for test dataset
y_pred = clf.predict(X_test)

Modeli Değerlendirme

Sınıflandırıcının veya modelin hastaların meme kanserini ne kadar doğru tahmin edebildiğini tahmin edelim.

Doğruluk, gerçek test seti değerleri ile tahmin edilen değerleri karşılaştırarak hesaplanabilir.

#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics

# Model Accuracy: how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
Accuracy: 0.9649122807017544

Görüldüğü gibi %96,49'luk bir sınıflandırma oranı elde ettiniz; bu çok iyi bir doğruluk olarak kabul edilir.

Daha ileri değerlendirme için modelin kesinlik (precision) ve duyarlılığını (recall) da kontrol edebilirsiniz.

# Model Precision: what percentage of positive tuples are labeled as such?
print("Precision:",metrics.precision_score(y_test, y_pred))

# Model Recall: what percentage of positive tuples are labelled as such?
print("Recall:",metrics.recall_score(y_test, y_pred))
Precision: 0.9811320754716981
Recall: 0.9629629629629629

%98 kesinlik ve %96 duyarlılık elde ettiniz; bunlar çok iyi değerlerdir.

Hiperparametre Ayarlama

  • Kernel: Kernel'in temel işlevi, verilen veri kümesi giriş verilerini gerekli forma dönüştürmektir. Doğrusal, polinom ve radyal tabanlı fonksiyon (RBF) gibi çeşitli türler vardır. Polinom ve RBF, doğrusal olmayan hiper düzlemler için kullanışlıdır. Polinom ve RBF kernel'leri, ayrım çizgisini daha yüksek boyutta hesaplar. Bazı uygulamalarda, eğrisel veya doğrusal olmayan sınıfları ayırmak için daha karmaşık bir kernel kullanılması önerilir. Bu dönüşüm daha doğru sınıflandırıcılara yol açabilir.
  • Düzenlileştirme: Python'un Scikit-learn kütüphanesindeki C parametresi, düzenlileştirmeyi sürdürmek için kullanılır. Burada C, yanlış sınıflandırma veya hata terimini temsil eden ceza parametresidir. Yanlış sınıflandırma veya hata terimi, SVM optimizasyonuna ne kadar hatanın tolere edilebilir olduğunu söyler. Karar sınırı ile yanlış sınıflandırma terimi arasındaki dengeyi bu şekilde kontrol edebilirsiniz. Daha küçük bir C değeri küçük marjlı bir hiper düzlem, daha büyük bir C değeri daha geniş marjlı bir hiper düzlem oluşturur.
  • Gamma: Daha düşük bir Gamma değeri eğitim veri kümesini gevşek biçimde uydururken, daha yüksek bir gamma değeri eğitim veri kümesini tam olarak uydurur ve bu da aşırı uyuma neden olur. Başka bir deyişle, düşük gamma değeri ayrım çizgisini hesaplarken yalnızca yakın çevredeki noktaları dikkate alırken, yüksek bir gamma değeri ayrım çizgisinin hesaplanmasında tüm veri noktalarını dikkate alır.

Avantajlar

SVM Sınıflandırıcıları, Naïve Bayes algoritmasına kıyasla iyi doğruluk sunar ve daha hızlı tahmin yapar. Ayrıca karar aşamasında eğitim noktalarının bir alt kümesini kullandıkları için daha az bellek kullanırlar. SVM, açık bir ayrım marjı ve yüksek boyutlu uzayla iyi çalışır.

Dezavantajlar

SVM, yüksek eğitim süresi nedeniyle büyük veri kümeleri için uygun değildir ve Naïve Bayes'e kıyasla eğitimi daha uzun sürer. Örtüşen sınıflarla kötü performans gösterir ve kullanılan kernel türüne karşı hassastır.

Sonuç

Tebrikler, bu eğitimin sonuna geldiniz!

Bu eğitimde, Destek vektör makinesi algoritması, çalışma prensibi, kernel'ler, hiperparametre ayarlama, model kurma ve Scikit-learn paketi kullanılarak meme kanseri veri kümesi üzerinde değerlendirme gibi pek çok konuyu ele aldınız. Ayrıca avantaj ve dezavantajlarını da incelediniz. Umarım değerli bir şeyler öğrenmişsinizdir!

Bu tür sınıflandırıcılar hakkında daha fazla bilgi edinmek için Python'da Doğrusal Sınıflandırıcılar kursumuza göz atmalısınız. Bu kurs, Destek Vektör Makinelerinin yanı sıra diğer regresyon ve kayıp fonksiyonu türlerini de tanıtır.

Geri bildirim veya sorularınızı duymayı çok isterim. Yorum bırakarak sorunuzu sorabilirsiniz; yanıtlamak için elimden geleni yapacağım.

Konular
Makine Öğrenimi
Veri Bilimi
Python

Scikit-learn Kursları

Kurs

Python'da Unsupervised Learning

4 sa
185.3K
Scikit-learn ve scipy kullanarak etiketlenmemiş veri kümelerini kümelemeyi, dönüştürmeyi, görselleştirmeyi ve bunlardan içgörüler elde etmeyi öğrenin.
Ayrıntıları GörüntüleRight Arrow
Kursa Başla
Devamını GörRight Arrow
İlgili

blog

2026’da En Popüler 40 Yazılım Mühendisi Mülakat Sorusu

Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Dario Radečić's photo

Dario Radečić

15 dk.

blog

Hızlı Sevkiyat İçin Pratik Vibe Kodlama Teknoloji Yığını

Ön uç, arka uç, veritabanları, kimlik doğrulama, depolama, e-posta, test, dağıtım ve izleme için en iyi araçları keşfedin.
Abid Ali Awan's photo

Abid Ali Awan

14 dk.

Eğitim

Python'da Listeyi String'e Nasıl Dönüştürürsünüz

Bu hızlı eğitimde, Python'da bir listeyi string'e nasıl dönüştüreceğinizi öğrenin.
Adel Nehme's photo

Adel Nehme

Eğitim

.gitignore Nasıl Kullanılır: Örneklerle Pratik Bir Giriş

Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!
Kurtis Pykes 's photo

Kurtis Pykes

8 dk.

Devamını GörDevamını Gör

