

SVM là một thuật toán thú vị và các khái niệm tương đối đơn giản. Bộ phân loại này tách các điểm dữ liệu bằng một siêu phẳng với biên lớn nhất. Vì vậy, bộ phân loại SVM còn được gọi là bộ phân loại phân biệt. SVM tìm siêu phẳng tối ưu giúp phân loại các điểm dữ liệu mới.
Trong hướng dẫn này, bạn sẽ tìm hiểu các chủ đề sau:
- Support Vector Machines
- Cách hoạt động
- Kernel
- Xây dựng bộ phân loại trong Scikit-learn
- Điều chỉnh siêu tham số
- Ưu và nhược điểm
Xem và học thêm về Support Vector Machines với Scikit-learn trong video từ khóa học của chúng tôi.
Support Vector Machines
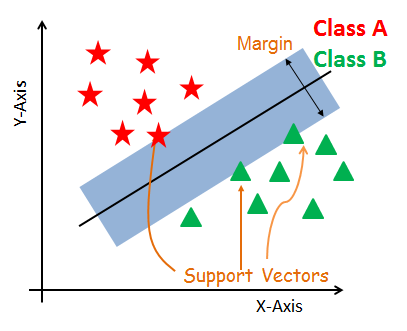
Nhìn chung, Support Vector Machines được coi là một phương pháp phân loại, nhưng có thể áp dụng cho cả bài toán phân loại và hồi quy. Thuật toán dễ dàng xử lý nhiều biến liên tục và phân loại. SVM xây dựng một siêu phẳng trong không gian nhiều chiều để tách các lớp khác nhau. SVM tạo ra siêu phẳng tối ưu theo cách lặp, nhằm giảm thiểu lỗi. Ý tưởng cốt lõi của SVM là tìm một siêu phẳng có biên tối đa (MMH) phân tách tập dữ liệu thành các lớp một cách tốt nhất.
Vector hỗ trợ
Vector hỗ trợ là các điểm dữ liệu gần siêu phẳng nhất. Những điểm này xác định đường phân tách tốt hơn thông qua việc tính toán biên. Chúng có mức độ liên quan cao nhất đối với việc xây dựng bộ phân loại.
Siêu phẳng
Siêu phẳng là một mặt phẳng quyết định, phân tách tập đối tượng có thuộc tính lớp khác nhau.
Biên
Biên là khoảng cách giữa hai đường đi qua các điểm gần nhất của mỗi lớp. Nó được tính như khoảng cách vuông góc từ đường đến các vector hỗ trợ hoặc các điểm gần nhất. Nếu biên giữa các lớp lớn hơn thì được coi là biên tốt, biên nhỏ hơn là biên xấu.
SVM hoạt động như thế nào?
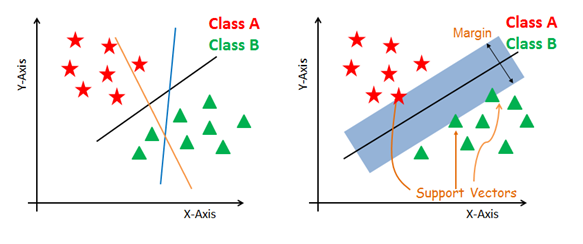
Mục tiêu chính là phân tách tập dữ liệu theo cách tốt nhất có thể. Khoảng cách giữa các điểm gần nhất của mỗi lớp được gọi là biên. Mục tiêu là chọn siêu phẳng có biên lớn nhất giữa các vector hỗ trợ trong tập dữ liệu. SVM tìm kiếm siêu phẳng có biên tối đa theo các bước sau:
-
Tạo các siêu phẳng phân tách các lớp theo cách tốt nhất. Hình bên trái cho thấy ba siêu phẳng đen, xanh và cam. Ở đây, siêu phẳng xanh và cam có lỗi phân loại cao hơn, còn siêu phẳng đen phân tách đúng hai lớp.
-
Chọn siêu phẳng đúng với mức độ phân tách tối đa khỏi các điểm dữ liệu gần nhất như hình bên phải.
Xử lý các siêu phẳng phi tuyến và không thể tách
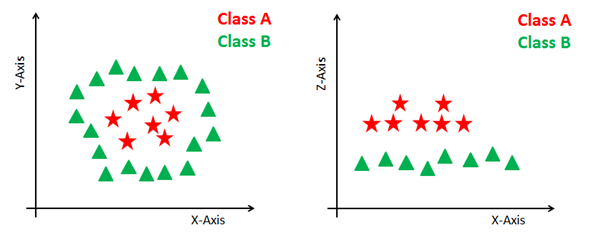
Một số bài toán không thể giải bằng siêu phẳng tuyến tính, như minh họa ở hình dưới (bên trái).
Trong tình huống như vậy, SVM dùng kernel trick để biến đổi không gian đầu vào sang không gian có số chiều cao hơn như ở bên phải. Các điểm dữ liệu được vẽ trên trục x và z (Z là tổng bình phương của x và y: z=x^2=y^2). Khi đó, bạn có thể dễ dàng tách các điểm này bằng đường phân tách tuyến tính.
Kernel trong SVM
Trong thực tế, thuật toán SVM được triển khai bằng cách sử dụng kernel. Kernel biến đổi không gian dữ liệu đầu vào thành dạng phù hợp. SVM dùng kỹ thuật gọi là kernel trick. Ở đây, kernel nhận không gian đầu vào có số chiều thấp và biến đổi thành không gian có số chiều cao hơn. Nói cách khác, có thể xem như chuyển một bài toán không thể tách thành bài toán có thể tách bằng cách thêm nhiều chiều. Điều này hữu ích nhất trong các bài toán phân tách phi tuyến. Kernel trick giúp bạn xây dựng bộ phân loại chính xác hơn.
- Kernel tuyến tính Kernel tuyến tính có thể dùng như tích vô hướng thông thường giữa hai quan sát bất kỳ. Tích giữa hai vector là tổng của tích từng cặp giá trị đầu vào tương ứng.
K(x, xi) = sum(x * xi)
- Kernel đa thức Kernel đa thức là dạng khái quát hơn của kernel tuyến tính. Kernel đa thức có thể phân biệt không gian đầu vào cong hoặc phi tuyến.
K(x,xi) = 1 + sum(x * xi)^d
Trong đó d là bậc của đa thức. d=1 tương tự như phép biến đổi tuyến tính. Bậc cần được chỉ định thủ công trong thuật toán học.
- Kernel hàm cơ sở xuyên tâm Kernel hàm cơ sở xuyên tâm (RBF) là một hàm kernel phổ biến thường dùng trong phân loại bằng SVM. RBF có thể ánh xạ một không gian đầu vào sang không gian có số chiều vô hạn.
K(x,xi) = exp(-gamma * sum((x – xi^2))
Ở đây gamma là một tham số trong khoảng từ 0 đến 1. Giá trị gamma cao sẽ khớp hoàn hảo với tập huấn luyện, dẫn đến quá khớp. Gamma=0.1 thường được coi là giá trị mặc định tốt. Giá trị gamma cần được chỉ định thủ công trong thuật toán học.
Xây dựng bộ phân loại trong Scikit-learn
Đến đây, bạn đã nắm phần lý thuyết về SVM. Giờ bạn sẽ học cách triển khai bằng Python với scikit-learn.
Trong phần xây dựng mô hình, bạn có thể sử dụng bộ dữ liệu ung thư, một bài toán phân loại đa lớp rất nổi tiếng. Bộ dữ liệu này được tính toán từ ảnh số hóa của mẫu chọc hút kim nhỏ (FNA) của một khối u vú. Các đặc trưng mô tả đặc điểm của nhân tế bào trong ảnh.
Bộ dữ liệu gồm 30 đặc trưng (bán kính trung bình, kết cấu trung bình, chu vi trung bình, diện tích trung bình, độ trơn trung bình, độ đặc trung bình, độ lõm trung bình, số điểm lõm trung bình, độ đối xứng trung bình, thứ nguyên fractal trung bình, sai số bán kính, sai số kết cấu, sai số chu vi, sai số diện tích, sai số độ trơn, sai số độ đặc, sai số độ lõm, sai số điểm lõm, sai số đối xứng, sai số thứ nguyên fractal, bán kính tệ nhất, kết cấu tệ nhất, chu vi tệ nhất, diện tích tệ nhất, độ trơn tệ nhất, độ đặc tệ nhất, độ lõm tệ nhất, điểm lõm tệ nhất, đối xứng tệ nhất và thứ nguyên fractal tệ nhất) và một nhãn mục tiêu (loại ung thư).
Dữ liệu có hai lớp ung thư: ác tính (gây hại) và lành tính (không gây hại). Ở đây, bạn có thể xây dựng mô hình để phân loại loại ung thư. Bộ dữ liệu có sẵn trong thư viện scikit-learn hoặc bạn cũng có thể tải từ UCI Machine Learning Library.
Chạy và chỉnh sửa mã từ hướng dẫn trực tuyến này
Chạy mãNạp dữ liệu
Trước tiên hãy nạp bộ dữ liệu cần dùng.
#Import scikit-learn dataset library
from sklearn import datasets
#Load dataset
cancer = datasets.load_breast_cancer()
Khám phá dữ liệu
Sau khi nạp dữ liệu, bạn có thể muốn biết thêm đôi chút. Bạn có thể kiểm tra tên đặc trưng và nhãn mục tiêu.
# print the names of the 13 features
print("Features: ", cancer.feature_names)
# print the label type of cancer('malignant' 'benign')
print("Labels: ", cancer.target_names)
Features: ['mean radius' 'mean texture' 'mean perimeter' 'mean area'
'mean smoothness' 'mean compactness' 'mean concavity'
'mean concave points' 'mean symmetry' 'mean fractal dimension'
'radius error' 'texture error' 'perimeter error' 'area error'
'smoothness error' 'compactness error' 'concavity error'
'concave points error' 'symmetry error' 'fractal dimension error'
'worst radius' 'worst texture' 'worst perimeter' 'worst area'
'worst smoothness' 'worst compactness' 'worst concavity'
'worst concave points' 'worst symmetry' 'worst fractal dimension']
Labels: ['malignant' 'benign']
Khám phá thêm một chút. Bạn cũng có thể kiểm tra kích thước của dữ liệu bằng thuộc tính shape.
# print data(feature)shape
cancer.data.shape
(569, 30)
Hãy xem 5 bản ghi đầu tiên của tập đặc trưng.
# print the cancer data features (top 5 records)
print(cancer.data[0:5])
[[1.799e+01 1.038e+01 1.228e+02 1.001e+03 1.184e-01 2.776e-01 3.001e-01
1.471e-01 2.419e-01 7.871e-02 1.095e+00 9.053e-01 8.589e+00 1.534e+02
6.399e-03 4.904e-02 5.373e-02 1.587e-02 3.003e-02 6.193e-03 2.538e+01
1.733e+01 1.846e+02 2.019e+03 1.622e-01 6.656e-01 7.119e-01 2.654e-01
4.601e-01 1.189e-01]
[2.057e+01 1.777e+01 1.329e+02 1.326e+03 8.474e-02 7.864e-02 8.690e-02
7.017e-02 1.812e-01 5.667e-02 5.435e-01 7.339e-01 3.398e+00 7.408e+01
5.225e-03 1.308e-02 1.860e-02 1.340e-02 1.389e-02 3.532e-03 2.499e+01
2.341e+01 1.588e+02 1.956e+03 1.238e-01 1.866e-01 2.416e-01 1.860e-01
2.750e-01 8.902e-02]
[1.969e+01 2.125e+01 1.300e+02 1.203e+03 1.096e-01 1.599e-01 1.974e-01
1.279e-01 2.069e-01 5.999e-02 7.456e-01 7.869e-01 4.585e+00 9.403e+01
6.150e-03 4.006e-02 3.832e-02 2.058e-02 2.250e-02 4.571e-03 2.357e+01
2.553e+01 1.525e+02 1.709e+03 1.444e-01 4.245e-01 4.504e-01 2.430e-01
3.613e-01 8.758e-02]
[1.142e+01 2.038e+01 7.758e+01 3.861e+02 1.425e-01 2.839e-01 2.414e-01
1.052e-01 2.597e-01 9.744e-02 4.956e-01 1.156e+00 3.445e+00 2.723e+01
9.110e-03 7.458e-02 5.661e-02 1.867e-02 5.963e-02 9.208e-03 1.491e+01
2.650e+01 9.887e+01 5.677e+02 2.098e-01 8.663e-01 6.869e-01 2.575e-01
6.638e-01 1.730e-01]
[2.029e+01 1.434e+01 1.351e+02 1.297e+03 1.003e-01 1.328e-01 1.980e-01
1.043e-01 1.809e-01 5.883e-02 7.572e-01 7.813e-01 5.438e+00 9.444e+01
1.149e-02 2.461e-02 5.688e-02 1.885e-02 1.756e-02 5.115e-03 2.254e+01
1.667e+01 1.522e+02 1.575e+03 1.374e-01 2.050e-01 4.000e-01 1.625e-01
2.364e-01 7.678e-02]]
Hãy xem tập nhãn mục tiêu.
# print the cancer labels (0:malignant, 1:benign)
print(cancer.target)
[0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
1 0 0 0 0 0 0 0 0 1 0 1 1 1 1 1 0 0 1 0 0 1 1 1 1 0 1 0 0 1 1 1 1 0 1 0 0
1 0 1 0 0 1 1 1 0 0 1 0 0 0 1 1 1 0 1 1 0 0 1 1 1 0 0 1 1 1 1 0 1 1 0 1 1
1 1 1 1 1 1 0 0 0 1 0 0 1 1 1 0 0 1 0 1 0 0 1 0 0 1 1 0 1 1 0 1 1 1 1 0 1
1 1 1 1 1 1 1 1 0 1 1 1 1 0 0 1 0 1 1 0 0 1 1 0 0 1 1 1 1 0 1 1 0 0 0 1 0
1 0 1 1 1 0 1 1 0 0 1 0 0 0 0 1 0 0 0 1 0 1 0 1 1 0 1 0 0 0 0 1 1 0 0 1 1
1 0 1 1 1 1 1 0 0 1 1 0 1 1 0 0 1 0 1 1 1 1 0 1 1 1 1 1 0 1 0 0 0 0 0 0 0
0 0 0 0 0 0 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1
1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0 1 0 1 1 1 1 0 0 0 1 1
1 1 0 1 0 1 0 1 1 1 0 1 1 1 1 1 1 1 0 0 0 1 1 1 1 1 1 1 1 1 1 1 0 0 1 0 0
0 1 0 0 1 1 1 1 1 0 1 1 1 1 1 0 1 1 1 0 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1
1 0 1 1 1 1 1 0 1 1 0 1 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 0 1 1 1 1 1 0 1 1
0 1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1 1 1 1 1 0 1
1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 0 0 1 0 1 0 1 1 1 1 1 0 1 1 0 1 0 1 0 0
1 1 1 0 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1 1 1 1 0 0 0 0 0 0 1]
Chia dữ liệu
Để hiểu hiệu suất mô hình, chia bộ dữ liệu thành tập huấn luyện và tập kiểm tra là một chiến lược tốt.
Chia dữ liệu bằng hàm train_test_split(). Bạn cần truyền vào 3 tham số: đặc trưng, nhãn mục tiêu và kích thước tập kiểm tra. Ngoài ra, bạn có thể dùng random_state để chọn ngẫu nhiên các bản ghi.
# Import train_test_split function
from sklearn.model_selection import train_test_split
# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(cancer.data, cancer.target, test_size=0.3,random_state=109) # 70% training and 30% test
Tạo mô hình
Hãy xây dựng mô hình máy vector hỗ trợ. Trước hết, nhập mô-đun SVM và tạo đối tượng bộ phân loại vector hỗ trợ bằng cách truyền đối số kernel là kernel tuyến tính trong hàm SVC().
Sau đó, fit mô hình trên tập huấn luyện bằng fit() và dự đoán trên tập kiểm tra bằng predict().
#Import svm model
from sklearn import svm
#Create a svm Classifier
clf = svm.SVC(kernel='linear') # Linear Kernel
#Train the model using the training sets
clf.fit(X_train, y_train)
#Predict the response for test dataset
y_pred = clf.predict(X_test)
Đánh giá mô hình
Hãy ước lượng mức độ chính xác mà bộ phân loại hoặc mô hình có thể dự đoán ung thư vú của bệnh nhân.
Độ chính xác có thể tính bằng cách so sánh giá trị thực của tập kiểm tra và giá trị dự đoán.
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy: how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
Accuracy: 0.9649122807017544
Bạn đạt tỷ lệ phân loại 96,49%, được coi là rất tốt.
Để đánh giá sâu hơn, bạn cũng có thể kiểm tra precision và recall của mô hình.
# Model Precision: what percentage of positive tuples are labeled as such?
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall: what percentage of positive tuples are labelled as such?
print("Recall:",metrics.recall_score(y_test, y_pred))
Precision: 0.9811320754716981
Recall: 0.9629629629629629
Bạn đạt precision 98% và recall 96%, đều được coi là rất tốt.
Điều chỉnh siêu tham số
- Kernel: Chức năng chính của kernel là biến đổi dữ liệu đầu vào của bộ dữ liệu thành dạng cần thiết. Có nhiều loại hàm như tuyến tính, đa thức và hàm cơ sở xuyên tâm (RBF). Đa thức và RBF hữu ích cho siêu phẳng phi tuyến. Kernel đa thức và RBF tính toán đường phân tách trong không gian chiều cao hơn. Trong một số ứng dụng, nên dùng kernel phức tạp hơn để tách các lớp có dạng cong hoặc phi tuyến. Phép biến đổi này có thể tạo ra các bộ phân loại chính xác hơn.
- Regularization: Tham số điều chuẩn trong Scikit-learn của Python là tham số C dùng để duy trì điều chuẩn. Ở đây C là tham số phạt, biểu thị sai phân loại hoặc hạng mục lỗi. Hạng mục sai phân loại hoặc lỗi cho SVM biết mức lỗi có thể chấp nhận. Bằng cách này, bạn có thể kiểm soát sự đánh đổi giữa biên quyết định và sai phân loại. Giá trị C nhỏ tạo siêu phẳng có biên nhỏ, còn giá trị C lớn tạo siêu phẳng có biên lớn.
- Gamma: Giá trị Gamma thấp sẽ khớp lỏng với dữ liệu huấn luyện, trong khi giá trị gamma cao sẽ khớp chính xác dữ liệu huấn luyện, dẫn đến quá khớp. Nói cách khác, giá trị gamma thấp chỉ xét các điểm lân cận khi tính đường phân tách, trong khi giá trị gamma cao xét tất cả điểm dữ liệu trong phép tính đường phân tách.
Ưu điểm
Các bộ phân loại SVM mang lại độ chính xác tốt và dự đoán nhanh hơn so với thuật toán Naïve Bayes. Chúng cũng dùng ít bộ nhớ hơn vì chỉ sử dụng một tập con điểm huấn luyện trong giai đoạn ra quyết định. SVM hoạt động tốt khi có biên phân tách rõ ràng và trong không gian chiều cao.
Nhược điểm
SVM không phù hợp với các bộ dữ liệu lớn do thời gian huấn luyện cao và cũng tốn nhiều thời gian huấn luyện hơn so với Naïve Bayes. Thuật toán hoạt động kém với các lớp chồng lấn và nhạy với loại kernel được sử dụng.
Kết luận
Chúc mừng bạn đã đi đến cuối hướng dẫn!
Trong hướng dẫn này, bạn đã tìm hiểu nhiều về thuật toán máy vector hỗ trợ, cách hoạt động, kernel, điều chỉnh siêu tham số, xây dựng và đánh giá mô hình trên bộ dữ liệu ung thư vú bằng gói Scikit-learn. Bạn cũng đã điểm qua các ưu và nhược điểm. Hy vọng bạn đã học được điều gì đó hữu ích!
Để học thêm về loại bộ phân loại này, bạn nên xem khóa học Linear Classifiers in Python của chúng tôi. Khóa học giới thiệu các loại hồi quy và hàm mất mát khác, cũng như Support Vector Machines.
Tôi mong nhận được phản hồi hoặc câu hỏi từ bạn. Bạn có thể đặt câu hỏi bằng cách để lại bình luận và tôi sẽ cố gắng trả lời tốt nhất.


SVM mang lại độ chính xác rất cao so với các bộ phân loại khác như hồi quy logistic và cây quyết định. Thuật toán này nổi tiếng với "kernel trick" để xử lý không gian đầu vào phi tuyến. SVM được dùng trong nhiều ứng dụng như phát hiện khuôn mặt, phát hiện xâm nhập, phân loại email, bài báo và trang web, phân loại gen, và nhận dạng chữ viết tay.
Trong hướng dẫn này, bạn sẽ sử dụng scikit-learn trong Python. Nếu muốn tìm hiểu thêm về gói Python này, tôi khuyến nghị bạn xem khóa học Học có giám sát với scikit-learn của chúng tôi.