Cursus
SVM biedt een zeer hoge nauwkeurigheid vergeleken met andere classificaties zoals logistische regressie en beslissingsbomen. Het staat bekend om de kerneltruc om niet-lineaire inputruimtes aan te kunnen. Het wordt gebruikt in allerlei toepassingen, zoals gezichtsherkenning, inbraakdetectie, classificatie van e-mails, nieuwsartikelen en webpagina's, classificatie van genen en handschriftherkenning.
In deze tutorial gebruik je scikit-learn in Python. Wil je meer leren over dit Python-pakket, bekijk dan onze cursus Supervised Learning with scikit-learn.
SVM is een spannend algoritme en de concepten zijn relatief eenvoudig. De classifier scheidt datapunten met een hypervlak met de grootste marge. Daarom staat een SVM-classifier ook bekend als een discriminerende classifier. SVM vindt een optimaal hypervlak dat helpt om nieuwe datapunten te classificeren.
In deze tutorial behandel je de volgende onderwerpen:
- Support Vector Machines
- Hoe werkt het?
- Kernels
- Classifier bouwen in Scikit-learn
- Hyperparameters afstemmen
- Voordelen en nadelen
Bekijk en leer meer over Support Vector Machines met Scikit-learn in deze video uit onze cursus.
Support Vector Machines
Over het algemeen wordt Support Vector Machines gezien als een classificatiebenadering, maar het kan worden toegepast op zowel classificatie- als regressieproblemen. Het kan gemakkelijk omgaan met meerdere continue en categorische variabelen. SVM construeert een hypervlak in een multidimensionale ruimte om verschillende klassen te scheiden. SVM genereert iteratief een optimaal hypervlak dat wordt gebruikt om een fout te minimaliseren. Het kernidee van SVM is het vinden van een maximum marginal hyperplane (MMH) dat de dataset het best in klassen verdeelt.
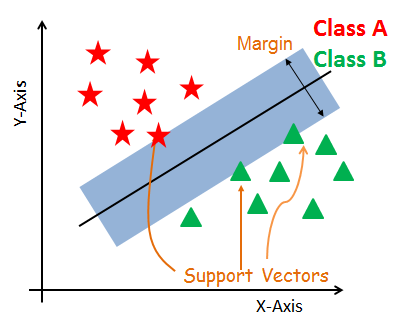
Support vectors
Support vectors zijn de datapunten die het dichtst bij het hypervlak liggen. Deze punten definiëren de scheidingslijn beter door de marges te berekenen. Deze punten zijn het meest relevant voor de opbouw van de classifier.
Hypervlak
Een hypervlak is een beslissingsvlak dat objecten met verschillende klassen van elkaar scheidt.
Marge
Een marge is de kloof tussen de twee lijnen op de dichtstbijzijnde punten van elke klasse. Dit wordt berekend als de loodrechte afstand van de lijn tot de support vectors of dichtstbijzijnde punten. Als de marge tussen de klassen groter is, wordt dat gezien als een goede marge; een kleinere marge is een slechte marge.
Hoe werkt SVM?
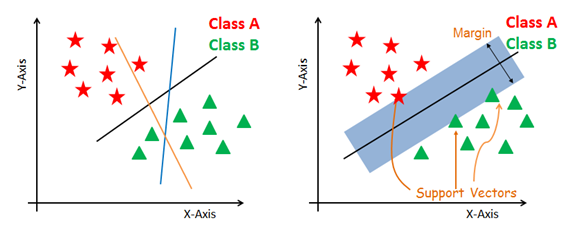
Het hoofddoel is om de gegeven dataset zo goed mogelijk te scheiden. De afstand tussen de dichtstbijzijnde punten heet de marge. Het doel is een hypervlak te kiezen met de maximaal mogelijke marge tussen support vectors in de dataset. SVM zoekt het maximale marginale hypervlak in de volgende stappen:
-
Genereer hypervlakken die de klassen zo goed mogelijk scheiden. De figuur links toont drie hypervlakken: zwart, blauw en oranje. Hier hebben blauw en oranje een hogere classificatiefout, maar zwart scheidt de twee klassen correct.
-
Selecteer het juiste hypervlak met de maximale scheiding vanaf de dichtstbijzijnde datapunten, zoals weergegeven in de figuur rechts.
Omgaan met niet-lineaire en niet-separeerbare vlakken
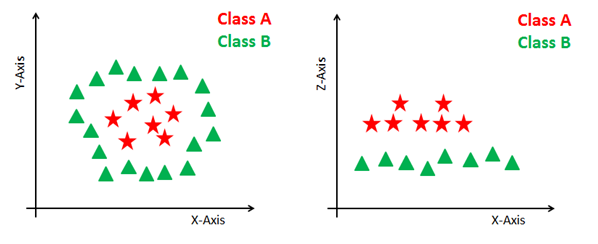
Sommige problemen zijn niet op te lossen met een lineair hypervlak, zoals te zien is in de figuur hieronder (links).
In zulke situaties gebruikt SVM een kerneltruc om de inputruimte te transformeren naar een hoger-dimensionale ruimte, zoals rechts te zien is. De datapunten zijn uitgezet op de x-as en z-as (Z is de kwadratische som van zowel x als y: z=x^2=y^2). Je kunt deze punten nu eenvoudig scheiden met een lineaire scheiding.
SVM-kernels
Het SVM-algoritme wordt in de praktijk geïmplementeerd met behulp van een kernel. Een kernel transformeert een inputdataspace in de vereiste vorm. SVM gebruikt een techniek die de kerneltruc wordt genoemd. Hierbij neemt de kernel een laag-dimensionale inputruimte en transformeert die naar een hoger-dimensionale ruimte. Met andere woorden: het zet een niet-separeerbaar probleem om in een separeerbaar probleem door er meer dimensies aan toe te voegen. Dit is vooral nuttig bij niet-lineaire scheidingsproblemen. De kerneltruc helpt je een nauwkeurigere classifier te bouwen.
- Lineaire kernel Een lineaire kernel kan worden gebruikt als een normale inwendig product van twee gegeven observaties. Het product tussen twee vectoren is de som van de vermenigvuldiging van elk paar inputwaarden.
K(x, xi) = sum(x * xi)
- Polynomiale kernel Een polynomiale kernel is een meer gegeneraliseerde vorm van de lineaire kernel. De polynomiale kernel kan een gekromde of niet-lineaire inputruimte onderscheiden.
K(x,xi) = 1 + sum(x * xi)^d
Waarbij d de graad van het polynoom is. d=1 is vergelijkbaar met de lineaire transformatie. De graad moet handmatig worden opgegeven in het leeralgoritme.
- Radiale basisfunctiekernel De radiale basisfunctiekernel is een populaire kernelfunctie die vaak wordt gebruikt bij supportvectormachine-classificatie. RBF kan een inputruimte naar een oneindig-dimensionale ruimte afbeelden.
K(x,xi) = exp(-gamma * sum((x – xi^2))
Hier is gamma een parameter die varieert van 0 tot 1. Een hogere waarde van gamma past de trainingsdataset perfect, wat overfitting veroorzaakt. Gamma=0.1 wordt gezien als een goede standaardwaarde. De waarde van gamma moet handmatig worden opgegeven in het leeralgoritme.
Classifier bouwen in Scikit-learn
Tot nu toe heb je de theoretische achtergrond van SVM geleerd. Nu leer je hoe je het implementeert in Python met scikit-learn.
Voor het modelbouwgedeelte kun je de kankerdata gebruiken, een zeer bekend multiclass-classificatieprobleem. Deze dataset is afgeleid van een gedigitaliseerde afbeelding van een fijne naaldaspiratie (FNA) van een borsttumor. Ze beschrijven kenmerken van de celkernen in de afbeelding.
De dataset bevat 30 features (gemiddelde straal, gemiddelde textuur, gemiddelde omtrek, gemiddelde oppervlakte, gemiddelde gladheid, gemiddelde compactheid, gemiddelde concaviteit, gemiddelde concave punten, gemiddelde symmetrie, gemiddelde fractale dimensie, straalfout, textuurfout, omtrekfout, oppervlakfout, gladheidsfout, compactheidsfout, concaviteitsfout, fout in concave punten, symmetriefout, fractale dimensiefout, slechtste straal, slechtste textuur, slechtste omtrek, slechtste oppervlakte, slechtste gladheid, slechtste compactheid, slechtste concaviteit, slechtste concave punten, slechtste symmetrie en slechtste fractale dimensie) en een target (type kanker).
Deze data heeft twee soorten kankers: kwaadaardig (schadelijk) en goedaardig (niet schadelijk). Hier kun je een model bouwen om het type kanker te classificeren. De dataset is beschikbaar in de scikit-learn-bibliotheek of je kunt hem ook downloaden uit de UCI Machine Learning Library.
Voer de code van deze tutorial online uit en bewerk deze
Code uitvoerenData laden
Laten we eerst de dataset laden die je gaat gebruiken.
#Import scikit-learn dataset library
from sklearn import datasets
#Load dataset
cancer = datasets.load_breast_cancer()
Data verkennen
Nadat je de dataset hebt geladen, wil je er misschien wat meer over weten. Je kunt de namen van de features en targets controleren.
# print the names of the 13 features
print("Features: ", cancer.feature_names)
# print the label type of cancer('malignant' 'benign')
print("Labels: ", cancer.target_names)
Features: ['mean radius' 'mean texture' 'mean perimeter' 'mean area'
'mean smoothness' 'mean compactness' 'mean concavity'
'mean concave points' 'mean symmetry' 'mean fractal dimension'
'radius error' 'texture error' 'perimeter error' 'area error'
'smoothness error' 'compactness error' 'concavity error'
'concave points error' 'symmetry error' 'fractal dimension error'
'worst radius' 'worst texture' 'worst perimeter' 'worst area'
'worst smoothness' 'worst compactness' 'worst concavity'
'worst concave points' 'worst symmetry' 'worst fractal dimension']
Labels: ['malignant' 'benign']
Laten we het nog iets verder verkennen. Je kunt ook de vorm van de dataset controleren met shape.
# print data(feature)shape
cancer.data.shape
(569, 30)
Laten we de bovenste 5 records van de featureset bekijken.
# print the cancer data features (top 5 records)
print(cancer.data[0:5])
[[1.799e+01 1.038e+01 1.228e+02 1.001e+03 1.184e-01 2.776e-01 3.001e-01
1.471e-01 2.419e-01 7.871e-02 1.095e+00 9.053e-01 8.589e+00 1.534e+02
6.399e-03 4.904e-02 5.373e-02 1.587e-02 3.003e-02 6.193e-03 2.538e+01
1.733e+01 1.846e+02 2.019e+03 1.622e-01 6.656e-01 7.119e-01 2.654e-01
4.601e-01 1.189e-01]
[2.057e+01 1.777e+01 1.329e+02 1.326e+03 8.474e-02 7.864e-02 8.690e-02
7.017e-02 1.812e-01 5.667e-02 5.435e-01 7.339e-01 3.398e+00 7.408e+01
5.225e-03 1.308e-02 1.860e-02 1.340e-02 1.389e-02 3.532e-03 2.499e+01
2.341e+01 1.588e+02 1.956e+03 1.238e-01 1.866e-01 2.416e-01 1.860e-01
2.750e-01 8.902e-02]
[1.969e+01 2.125e+01 1.300e+02 1.203e+03 1.096e-01 1.599e-01 1.974e-01
1.279e-01 2.069e-01 5.999e-02 7.456e-01 7.869e-01 4.585e+00 9.403e+01
6.150e-03 4.006e-02 3.832e-02 2.058e-02 2.250e-02 4.571e-03 2.357e+01
2.553e+01 1.525e+02 1.709e+03 1.444e-01 4.245e-01 4.504e-01 2.430e-01
3.613e-01 8.758e-02]
[1.142e+01 2.038e+01 7.758e+01 3.861e+02 1.425e-01 2.839e-01 2.414e-01
1.052e-01 2.597e-01 9.744e-02 4.956e-01 1.156e+00 3.445e+00 2.723e+01
9.110e-03 7.458e-02 5.661e-02 1.867e-02 5.963e-02 9.208e-03 1.491e+01
2.650e+01 9.887e+01 5.677e+02 2.098e-01 8.663e-01 6.869e-01 2.575e-01
6.638e-01 1.730e-01]
[2.029e+01 1.434e+01 1.351e+02 1.297e+03 1.003e-01 1.328e-01 1.980e-01
1.043e-01 1.809e-01 5.883e-02 7.572e-01 7.813e-01 5.438e+00 9.444e+01
1.149e-02 2.461e-02 5.688e-02 1.885e-02 1.756e-02 5.115e-03 2.254e+01
1.667e+01 1.522e+02 1.575e+03 1.374e-01 2.050e-01 4.000e-01 1.625e-01
2.364e-01 7.678e-02]]
Laten we naar de targetset kijken.
# print the cancer labels (0:malignant, 1:benign)
print(cancer.target)
[0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
1 0 0 0 0 0 0 0 0 1 0 1 1 1 1 1 0 0 1 0 0 1 1 1 1 0 1 0 0 1 1 1 1 0 1 0 0
1 0 1 0 0 1 1 1 0 0 1 0 0 0 1 1 1 0 1 1 0 0 1 1 1 0 0 1 1 1 1 0 1 1 0 1 1
1 1 1 1 1 1 0 0 0 1 0 0 1 1 1 0 0 1 0 1 0 0 1 0 0 1 1 0 1 1 0 1 1 1 1 0 1
1 1 1 1 1 1 1 1 0 1 1 1 1 0 0 1 0 1 1 0 0 1 1 0 0 1 1 1 1 0 1 1 0 0 0 1 0
1 0 1 1 1 0 1 1 0 0 1 0 0 0 0 1 0 0 0 1 0 1 0 1 1 0 1 0 0 0 0 1 1 0 0 1 1
1 0 1 1 1 1 1 0 0 1 1 0 1 1 0 0 1 0 1 1 1 1 0 1 1 1 1 1 0 1 0 0 0 0 0 0 0
0 0 0 0 0 0 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1
1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0 1 0 1 1 1 1 0 0 0 1 1
1 1 0 1 0 1 0 1 1 1 0 1 1 1 1 1 1 1 0 0 0 1 1 1 1 1 1 1 1 1 1 1 0 0 1 0 0
0 1 0 0 1 1 1 1 1 0 1 1 1 1 1 0 1 1 1 0 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1
1 0 1 1 1 1 1 0 1 1 0 1 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 0 1 1 1 1 1 0 1 1
0 1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1 1 1 1 1 0 1
1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 0 0 1 0 1 0 1 1 1 1 1 0 1 1 0 1 0 1 0 0
1 1 1 0 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1 1 1 1 0 0 0 0 0 0 1]
Data splitsen
Om modelprestaties te begrijpen, is het een goede strategie om de dataset op te delen in een trainingsset en een testset.
Split de dataset met de functie train_test_split(). je moet 3 parameters doorgeven: features, target en test_set-grootte. Daarnaast kun je random_state gebruiken om records willekeurig te selecteren.
# Import train_test_split function
from sklearn.model_selection import train_test_split
# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(cancer.data, cancer.target, test_size=0.3,random_state=109) # 70% training and 30% test
Model genereren
Laten we een supportvectormachine-model bouwen. Importeer eerst de SVM-module en maak een support vector classifier-object door het argument kernel als de lineaire kernel in de functie SVC() mee te geven.
Train daarna je model op de trainingsset met fit() en voer voorspellingen uit op de testset met predict().
#Import svm model
from sklearn import svm
#Create a svm Classifier
clf = svm.SVC(kernel='linear') # Linear Kernel
#Train the model using the training sets
clf.fit(X_train, y_train)
#Predict the response for test dataset
y_pred = clf.predict(X_test)
Het model evalueren
Laten we inschatten hoe nauwkeurig de classifier of het model de borstkanker van patiënten kan voorspellen.
Nauwkeurigheid kan worden berekend door de werkelijke waarden uit de testset te vergelijken met de voorspelde waarden.
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy: how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
Accuracy: 0.9649122807017544
Mooi, je hebt een classificatiescore van 96,49%, wat als zeer goed wordt beschouwd.
Voor verdere evaluatie kun je ook de precision en recall van het model controleren.
# Model Precision: what percentage of positive tuples are labeled as such?
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall: what percentage of positive tuples are labelled as such?
print("Recall:",metrics.recall_score(y_test, y_pred))
Precision: 0.9811320754716981
Recall: 0.9629629629629629
Je hebt een precision van 98% en een recall van 96%, wat als zeer goede waarden worden gezien.
Hyperparameters afstemmen
- Kernel: De hoofdtaak van de kernel is om de gegeven inputdata van de dataset te transformeren naar de vereiste vorm. Er zijn verschillende functies, zoals lineair, polynomiaal en radial basis function (RBF). Polynomiaal en RBF zijn nuttig voor een niet-lineair hypervlak. Polynomiale en RBF-kernels berekenen de scheidingslijn in de hogere dimensie. In sommige toepassingen wordt aangeraden een complexere kernel te gebruiken om klassen te scheiden die gekromd of niet-lineair zijn. Deze transformatie kan leiden tot nauwkeurigere classifiers.
- Regularisatie: De regularisatieparameter in de C-parameter van Python's scikit-learn wordt gebruikt om regularisatie te waarborgen. Hier is C de strafparameter die misclassificatie of foutterm vertegenwoordigt. De misclassificatie- of foutterm vertelt de SVM-optimalisatie hoeveel fout acceptabel is. Zo kun je de afweging tussen beslissingsgrens en misclassificatieterm sturen. Een kleinere waarde van C creëert een hypervlak met kleine marge en een grotere waarde van C creëert een hypervlak met grotere marge.
- Gamma: Een lagere waarde van gamma past de trainingsdata losjes, terwijl een hogere waarde van gamma de trainingsdata exact past, wat overfitting veroorzaakt. Met andere woorden: een lage waarde van gamma houdt bij het berekenen van de scheidingslijn alleen rekening met punten in de buurt, terwijl een hoge waarde van gamma met alle datapunten rekening houdt bij het berekenen van de scheidingslijn.
Voordelen
SVM-classifiers bieden goede nauwkeurigheid en leveren snellere voorspellingen op vergeleken met het naïeve Bayes-algoritme. Ze gebruiken ook minder geheugen omdat ze in de beslissingsfase een subset van trainingspunten gebruiken. SVM werkt goed met een duidelijke scheidingsmarge en in hoog-dimensionale ruimtes.
Nadelen
SVM is niet geschikt voor grote datasets vanwege de lange trainingstijd en kost ook meer tijd om te trainen dan Naïeve Bayes. Het presteert slecht bij overlappende klassen en is bovendien gevoelig voor het type gebruikte kernel.
Conclusie
Gefeliciteerd, je bent aan het einde van deze tutorial gekomen!
In deze tutorial heb je veel behandeld over het supportvectormachine-algoritme: de werking, kernels, het afstemmen van hyperparameters, modelbouw en evaluatie op de borstkankerdataset met behulp van het scikit-learn-pakket. Je hebt ook de voor- en nadelen besproken. Hopelijk heb je iets waardevols geleerd!
Wil je meer leren over dit type classifiers, bekijk dan onze cursus Linear Classifiers in Python. Die introduceert andere soorten regressie- en verliesfuncties, evenals Support Vector Machines.
Ik hoor graag je feedback of vragen. Je kunt je vraag stellen door een reactie achter te laten en ik zal mijn best doen om te antwoorden.

