Kursus
SVM menawarkan akurasi yang sangat tinggi dibandingkan pengklasifikasi lain seperti regresi logistik dan pohon keputusan. Algoritme ini dikenal dengan kernel trick untuk menangani ruang input nonlinier. SVM digunakan dalam berbagai aplikasi seperti pendeteksian wajah, deteksi intrusi, klasifikasi email, artikel berita dan halaman web, klasifikasi gen, serta pengenalan tulisan tangan.
Dalam tutorial ini, Anda akan menggunakan scikit-learn di Python. Jika Anda ingin mempelajari lebih lanjut tentang paket Python ini, kami sarankan melihat kursus Supervised Learning with scikit-learn kami.
SVM adalah algoritme yang menarik dan konsepnya relatif sederhana. Pengklasifikasi memisahkan titik data menggunakan sebuah hiperbidang dengan margin terbesar. Itulah mengapa pengklasifikasi SVM juga dikenal sebagai pengklasifikasi diskriminatif. SVM menemukan hiperbidang optimal yang membantu mengklasifikasikan titik data baru.
Dalam tutorial ini, Anda akan membahas topik-topik berikut:
- Support Vector Machines
- Bagaimana cara kerjanya?
- Kernel
- Membangun pengklasifikasi di Scikit-learn
- Penyetelan Hyperparameter
- Kelebihan dan Kekurangan
Tonton dan pelajari lebih lanjut tentang Support Vector Machines dengan Scikit-learn dalam video dari kursus kami ini.
Support Vector Machines
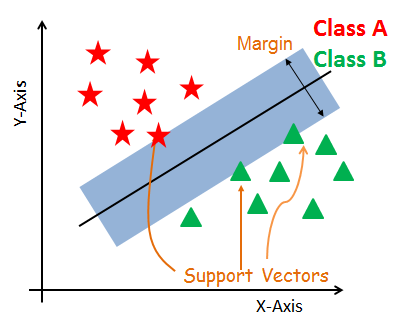
Secara umum, Support Vector Machines dianggap sebagai pendekatan klasifikasi, tetapi dapat digunakan untuk masalah klasifikasi maupun regresi. SVM dapat dengan mudah menangani banyak variabel kontinu dan kategorikal. SVM membangun sebuah hiperbidang di ruang multidimensi untuk memisahkan kelas yang berbeda. SVM menghasilkan hiperbidang optimal secara iteratif, yang digunakan untuk meminimalkan kesalahan. Inti gagasan SVM adalah menemukan maximum marginal hyperplane (MMH) yang paling baik membagi dataset ke dalam kelas.
Support Vectors
Support vector adalah titik-titik data yang paling dekat dengan hiperbidang. Titik-titik ini akan menentukan garis pemisah dengan lebih baik melalui perhitungan margin. Titik-titik ini lebih relevan dalam membangun pengklasifikasi.
Hiperbidang
Hiperbidang adalah bidang keputusan yang memisahkan sekumpulan objek dengan keanggotaan kelas yang berbeda.
Margin
Margin adalah jarak antara dua garis pada titik-titik kelas terdekat. Ini dihitung sebagai jarak tegak lurus dari garis ke support vector atau titik terdekat. Jika margin antarkelas lebih besar, maka dianggap margin yang baik; margin yang lebih kecil dianggap kurang baik.
Bagaimana SVM bekerja?
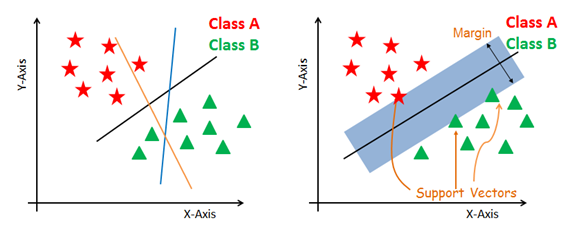
Tujuan utamanya adalah memisahkan dataset yang diberikan sebaik mungkin. Jarak antara titik-titik terdekat disebut margin. Tujuannya adalah memilih hiperbidang dengan margin maksimum antara support vector dalam dataset yang diberikan. SVM mencari maximum marginal hyperplane melalui langkah-langkah berikut:
-
Hasilkan hiperbidang yang memisahkan kelas dengan cara terbaik. Gambar di sisi kiri menunjukkan tiga hiperbidang: hitam, biru, dan oranye. Di sini, yang biru dan oranye memiliki galat klasifikasi lebih tinggi, namun yang hitam memisahkan kedua kelas dengan benar.
-
Pilih hiperbidang yang tepat dengan pemisahan maksimum dari titik data terdekat, seperti ditunjukkan pada gambar di sisi kanan.
Menangani bidang nonlinier dan tak terpisahkan
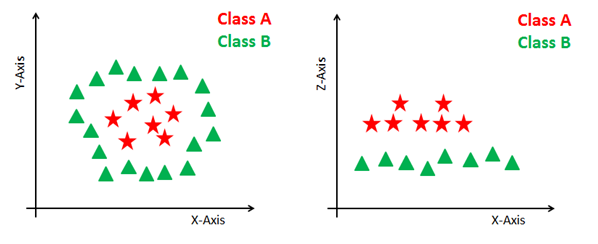
Beberapa masalah tidak dapat diselesaikan menggunakan hiperbidang linier, seperti terlihat pada gambar di bawah (sisi kiri).
Dalam situasi seperti itu, SVM menggunakan kernel trick untuk mentransformasikan ruang input ke ruang berdimensi lebih tinggi seperti terlihat di sisi kanan. Titik data dipetakan pada sumbu x dan z (Z adalah jumlah kuadrat dari x dan y: z=x^2=y^2). Sekarang Anda dapat dengan mudah memisahkan titik-titik ini menggunakan pemisahan linier.
Kernel SVM
Algoritme SVM diimplementasikan dalam praktik menggunakan sebuah kernel. Kernel mentransformasi ruang data input ke bentuk yang diperlukan. SVM menggunakan teknik yang disebut kernel trick. Di sini, kernel mengambil ruang input berdimensi rendah dan mentransformasikannya ke ruang berdimensi lebih tinggi. Dengan kata lain, kernel mengubah masalah yang tidak terpisahkan menjadi terpisahkan dengan menambahkan dimensi. Ini sangat berguna untuk masalah pemisahan nonlinier. Kernel trick membantu Anda membangun pengklasifikasi yang lebih akurat.
- Kernel Linier Kernel linier dapat digunakan sebagai hasil kali titik biasa antara dua observasi. Hasil kali antara dua vektor adalah jumlah dari perkalian setiap pasangan nilai input.
K(x, xi) = sum(x * xi)
- Kernel Polinomial Kernel polinomial adalah bentuk yang lebih umum dari kernel linier. Kernel polinomial dapat membedakan ruang input yang melengkung atau nonlinier.
K(x,xi) = 1 + sum(x * xi)^d
Di mana d adalah derajat polinomial. d=1 serupa dengan transformasi linier. Nilai derajat perlu ditentukan secara manual dalam algoritme pembelajaran.
- Kernel Radial Basis Function Kernel Radial Basis Function adalah fungsi kernel populer yang umum digunakan dalam klasifikasi support vector machine. RBF dapat memetakan ruang input ke ruang berdimensi tak terbatas.
K(x,xi) = exp(-gamma * sum((x – xi^2))
Di sini gamma adalah parameter dengan rentang 0 hingga 1. Nilai gamma yang lebih tinggi akan melakukan pencocokan sempurna pada data latih, yang menyebabkan overfitting. Gamma=0.1 dianggap sebagai nilai bawaan yang baik. Nilai gamma perlu ditentukan secara manual dalam algoritme pembelajaran.
Membangun Pengklasifikasi di Scikit-learn
Sampai di sini, Anda telah mempelajari latar belakang teoretis SVM. Sekarang Anda akan mempelajari implementasinya di Python menggunakan scikit-learn.
Pada bagian pembangunan model, Anda dapat menggunakan dataset kanker, yang merupakan masalah klasifikasi multikelas yang sangat terkenal. Dataset ini dihitung dari citra digital fine needle aspirate (FNA) pada massa payudara. Fitur-fitur tersebut menggambarkan karakteristik inti sel pada citra.
Dataset ini mencakup 30 fitur (mean radius, mean texture, mean perimeter, mean area, mean smoothness, mean compactness, mean concavity, mean concave points, mean symmetry, mean fractal dimension, radius error, texture error, perimeter error, area error, smoothness error, compactness error, concavity error, concave points error, symmetry error, fractal dimension error, worst radius, worst texture, worst perimeter, worst area, worst smoothness, worst compactness, worst concavity, worst concave points, worst symmetry, dan worst fractal dimension) serta sebuah target (jenis kanker).
Data ini memiliki dua jenis kelas kanker: malignant (berbahaya) dan benign (tidak berbahaya). Di sini, Anda dapat membangun model untuk mengklasifikasikan jenis kanker. Dataset tersedia di pustaka scikit-learn atau Anda juga dapat mengunduhnya dari UCI Machine Learning Library.
Jalankan dan edit kode dari Tutorial ini secara online
Jalankan kodeMemuat Data
Pertama, mari muat dataset yang diperlukan yang akan Anda gunakan.
#Import scikit-learn dataset library
from sklearn import datasets
#Load dataset
cancer = datasets.load_breast_cancer()
Menjelajahi Data
Setelah memuat dataset, Anda mungkin ingin mengetahui lebih banyak tentangnya. Anda dapat memeriksa nama fitur dan target.
# print the names of the 13 features
print("Features: ", cancer.feature_names)
# print the label type of cancer('malignant' 'benign')
print("Labels: ", cancer.target_names)
Features: ['mean radius' 'mean texture' 'mean perimeter' 'mean area'
'mean smoothness' 'mean compactness' 'mean concavity'
'mean concave points' 'mean symmetry' 'mean fractal dimension'
'radius error' 'texture error' 'perimeter error' 'area error'
'smoothness error' 'compactness error' 'concavity error'
'concave points error' 'symmetry error' 'fractal dimension error'
'worst radius' 'worst texture' 'worst perimeter' 'worst area'
'worst smoothness' 'worst compactness' 'worst concavity'
'worst concave points' 'worst symmetry' 'worst fractal dimension']
Labels: ['malignant' 'benign']
Mari kita jelajahi sedikit lebih jauh. Anda juga dapat memeriksa bentuk dataset menggunakan shape.
# print data(feature)shape
cancer.data.shape
(569, 30)
Mari periksa 5 rekaman teratas dari himpunan fitur.
# print the cancer data features (top 5 records)
print(cancer.data[0:5])
[[1.799e+01 1.038e+01 1.228e+02 1.001e+03 1.184e-01 2.776e-01 3.001e-01
1.471e-01 2.419e-01 7.871e-02 1.095e+00 9.053e-01 8.589e+00 1.534e+02
6.399e-03 4.904e-02 5.373e-02 1.587e-02 3.003e-02 6.193e-03 2.538e+01
1.733e+01 1.846e+02 2.019e+03 1.622e-01 6.656e-01 7.119e-01 2.654e-01
4.601e-01 1.189e-01]
[2.057e+01 1.777e+01 1.329e+02 1.326e+03 8.474e-02 7.864e-02 8.690e-02
7.017e-02 1.812e-01 5.667e-02 5.435e-01 7.339e-01 3.398e+00 7.408e+01
5.225e-03 1.308e-02 1.860e-02 1.340e-02 1.389e-02 3.532e-03 2.499e+01
2.341e+01 1.588e+02 1.956e+03 1.238e-01 1.866e-01 2.416e-01 1.860e-01
2.750e-01 8.902e-02]
[1.969e+01 2.125e+01 1.300e+02 1.203e+03 1.096e-01 1.599e-01 1.974e-01
1.279e-01 2.069e-01 5.999e-02 7.456e-01 7.869e-01 4.585e+00 9.403e+01
6.150e-03 4.006e-02 3.832e-02 2.058e-02 2.250e-02 4.571e-03 2.357e+01
2.553e+01 1.525e+02 1.709e+03 1.444e-01 4.245e-01 4.504e-01 2.430e-01
3.613e-01 8.758e-02]
[1.142e+01 2.038e+01 7.758e+01 3.861e+02 1.425e-01 2.839e-01 2.414e-01
1.052e-01 2.597e-01 9.744e-02 4.956e-01 1.156e+00 3.445e+00 2.723e+01
9.110e-03 7.458e-02 5.661e-02 1.867e-02 5.963e-02 9.208e-03 1.491e+01
2.650e+01 9.887e+01 5.677e+02 2.098e-01 8.663e-01 6.869e-01 2.575e-01
6.638e-01 1.730e-01]
[2.029e+01 1.434e+01 1.351e+02 1.297e+03 1.003e-01 1.328e-01 1.980e-01
1.043e-01 1.809e-01 5.883e-02 7.572e-01 7.813e-01 5.438e+00 9.444e+01
1.149e-02 2.461e-02 5.688e-02 1.885e-02 1.756e-02 5.115e-03 2.254e+01
1.667e+01 1.522e+02 1.575e+03 1.374e-01 2.050e-01 4.000e-01 1.625e-01
2.364e-01 7.678e-02]]
Mari kita lihat himpunan target.
# print the cancer labels (0:malignant, 1:benign)
print(cancer.target)
[0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
1 0 0 0 0 0 0 0 0 1 0 1 1 1 1 1 0 0 1 0 0 1 1 1 1 0 1 0 0 1 1 1 1 0 1 0 0
1 0 1 0 0 1 1 1 0 0 1 0 0 0 1 1 1 0 1 1 0 0 1 1 1 0 0 1 1 1 1 0 1 1 0 1 1
1 1 1 1 1 1 0 0 0 1 0 0 1 1 1 0 0 1 0 1 0 0 1 0 0 1 1 0 1 1 0 1 1 1 1 0 1
1 1 1 1 1 1 1 1 0 1 1 1 1 0 0 1 0 1 1 0 0 1 1 0 0 1 1 1 1 0 1 1 0 0 0 1 0
1 0 1 1 1 0 1 1 0 0 1 0 0 0 0 1 0 0 0 1 0 1 0 1 1 0 1 0 0 0 0 1 1 0 0 1 1
1 0 1 1 1 1 1 0 0 1 1 0 1 1 0 0 1 0 1 1 1 1 0 1 1 1 1 1 0 1 0 0 0 0 0 0 0
0 0 0 0 0 0 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1
1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0 1 0 1 1 1 1 0 0 0 1 1
1 1 0 1 0 1 0 1 1 1 0 1 1 1 1 1 1 1 0 0 0 1 1 1 1 1 1 1 1 1 1 1 0 0 1 0 0
0 1 0 0 1 1 1 1 1 0 1 1 1 1 1 0 1 1 1 0 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1
1 0 1 1 1 1 1 0 1 1 0 1 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 0 1 1 1 1 1 0 1 1
0 1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1 1 1 1 1 0 1
1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 0 0 1 0 1 0 1 1 1 1 1 0 1 1 0 1 0 1 0 0
1 1 1 0 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1 1 1 1 0 0 0 0 0 0 1]
Membagi Data
Untuk memahami kinerja model, membagi dataset menjadi himpunan latih dan uji adalah strategi yang baik.
Bagi dataset menggunakan fungsi train_test_split(). Anda perlu memasukkan 3 parameter: fitur, target, dan ukuran himpunan uji. Selain itu, Anda dapat menggunakan random_state untuk memilih rekaman secara acak.
# Import train_test_split function
from sklearn.model_selection import train_test_split
# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(cancer.data, cancer.target, test_size=0.3,random_state=109) # 70% training and 30% test
Membangun Model
Mari membangun model support vector machine. Pertama, impor modul SVM dan buat objek support vector classifier dengan memberikan argumen kernel sebagai kernel linier dalam fungsi SVC().
Kemudian, latih model pada himpunan latih menggunakan fit() dan lakukan prediksi pada himpunan uji menggunakan predict().
#Import svm model
from sklearn import svm
#Create a svm Classifier
clf = svm.SVC(kernel='linear') # Linear Kernel
#Train the model using the training sets
clf.fit(X_train, y_train)
#Predict the response for test dataset
y_pred = clf.predict(X_test)
Mengevaluasi Model
Mari perkirakan seberapa akurat pengklasifikasi atau model dapat memprediksi kanker payudara pada pasien.
Akurasi dapat dihitung dengan membandingkan nilai himpunan uji aktual dan nilai prediksi.
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy: how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
Accuracy: 0.9649122807017544
Anda mendapatkan tingkat klasifikasi 96,49%, yang dianggap sangat baik.
Untuk evaluasi lebih lanjut, Anda juga dapat memeriksa precision dan recall model.
# Model Precision: what percentage of positive tuples are labeled as such?
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall: what percentage of positive tuples are labelled as such?
print("Recall:",metrics.recall_score(y_test, y_pred))
Precision: 0.9811320754716981
Recall: 0.9629629629629629
Anda memperoleh precision sebesar 98% dan recall sebesar 96%, yang keduanya dianggap sangat baik.
Penyetelan Hyperparameter
- Kernel: Fungsi utama kernel adalah mentransformasi data input dataset yang diberikan ke bentuk yang diperlukan. Ada berbagai jenis fungsi seperti linier, polinomial, dan radial basis function (RBF). Polinomial dan RBF berguna untuk hiperbidang nonlinier. Kernel polinomial dan RBF menghitung garis pemisah pada dimensi yang lebih tinggi. Dalam beberapa aplikasi, disarankan menggunakan kernel yang lebih kompleks untuk memisahkan kelas yang melengkung atau nonlinier. Transformasi ini dapat menghasilkan pengklasifikasi yang lebih akurat.
- Regularisasi: Parameter regularisasi C di Scikit-learn Python digunakan untuk mempertahankan regularisasi. Di sini C adalah parameter penalti yang merepresentasikan salah klasifikasi atau suku galat. Suku salah klasifikasi atau galat memberi tahu optimisasi SVM seberapa besar galat yang dapat ditoleransi. Dengan cara inilah Anda mengendalikan trade-off antara batas keputusan dan suku salah klasifikasi. Nilai C yang lebih kecil menghasilkan hiperbidang dengan margin kecil dan nilai C yang lebih besar menghasilkan hiperbidang dengan margin lebih besar.
- Gamma: Nilai Gamma yang lebih rendah akan kurang pas terhadap data latih, sedangkan nilai gamma yang lebih tinggi akan pas sempurna pada data latih, yang menyebabkan overfitting. Dengan kata lain, nilai gamma yang rendah hanya mempertimbangkan titik yang berdekatan dalam menghitung garis pemisah, sementara nilai gamma yang tinggi mempertimbangkan semua titik data dalam perhitungan garis pemisah.
Kelebihan
Pengklasifikasi SVM menawarkan akurasi yang baik dan prediksi yang lebih cepat dibandingkan algoritme Naïve Bayes. SVM juga menggunakan lebih sedikit memori karena hanya menggunakan subset titik latih pada fase keputusan. SVM bekerja dengan baik ketika terdapat margin pemisahan yang jelas dan pada ruang berdimensi tinggi.
Kekurangan
SVM tidak cocok untuk dataset besar karena waktu pelatihannya yang tinggi dan juga membutuhkan waktu pelatihan lebih lama dibandingkan Naïve Bayes. SVM bekerja kurang baik pada kelas yang tumpang tindih dan sensitif terhadap jenis kernel yang digunakan.
Kesimpulan
Selamat, Anda telah mencapai akhir dari tutorial ini!
Dalam tutorial ini, Anda telah membahas banyak hal tentang algoritme Support Vector Machine, cara kerjanya, kernel, penyetelan hyperparameter, pembangunan model, dan evaluasi pada dataset kanker payudara menggunakan paket Scikit-learn. Anda juga telah membahas kelebihan dan kekurangannya. Semoga Anda mempelajari sesuatu yang berharga!
Untuk mempelajari lebih lanjut tentang jenis pengklasifikasi ini, lihat kursus Linear Classifiers in Python kami. Kursus ini memperkenalkan jenis regresi dan fungsi rugi lainnya, serta Support Vector Machines.
Saya menantikan umpan balik atau pertanyaan Anda. Anda dapat mengajukan pertanyaan dengan meninggalkan komentar dan saya akan berusaha sebaik mungkin untuk menjawabnya.
