课程
R 语言入门
4 小时
3.1M
实践并学习路径你的进步。
使用 Google 继续在线运行和编辑此教程中的代码
运行代码我们将同时讲解这些方法的数学性质与实用的 R 示例,并附上一些额外的小技巧。闲话少说,让我们开始吧!
先从基础谈起:简单的线性回归模型。目标是用 m 个预测变量 X 的线性组合与一个方差为 σ2 的正态误差项来预测响应变量 Y 的 n 个观测:
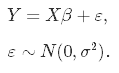
由于我们不知道真实参数 β,需要基于样本来估计它们。在普通最小二乘(OLS)方法中,我们将其估计为 $\hat\beta$,使残差平方和尽可能小。换言之,我们最小化以下损失函数:
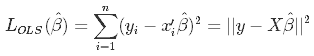
从而得到著名的 OLS 参数估计:$\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$。
在统计学中,评估估计量有两个关键特性:偏差与方差。偏差是总体真值与估计量期望之间的差:
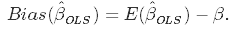
它衡量估计的准确性。另一方面,方差衡量这些估计的离散程度或不确定性,其形式为
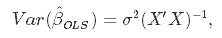
其中未知的误差方差 σ2 可以用残差估计为
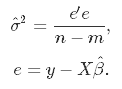
下图形象说明了偏差与方差。想象靶心是真实的总体参数 β,而射向靶心的子弹是四种不同估计量得到的估计值——低偏差低方差、高偏差高方差及其组合。
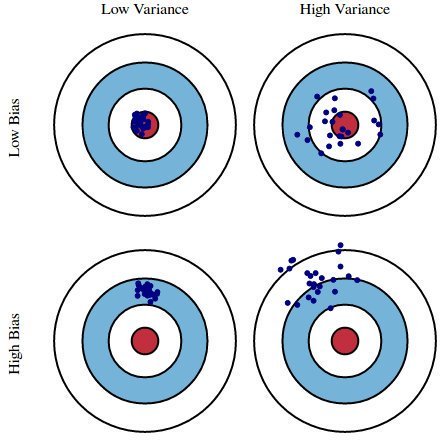
来源:kdnuggets.com
偏差和方差都希望尽可能小,因为大的偏差或方差都会导致模型预测不佳。事实上,模型误差可以分解为三部分:由高方差导致的误差、由显著偏差导致的误差,以及其余无法解释的部分。
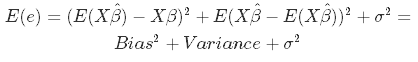
OLS 估计具有无偏这一理想性质。然而,它的方差可能很大。具体来说,当以下情况发生时会如此:
通用的解决思路是:以引入一定偏差为代价来降低方差。这种方法称为正则化,几乎总能提升模型的预测性能。为加深理解,来看下面这张图。
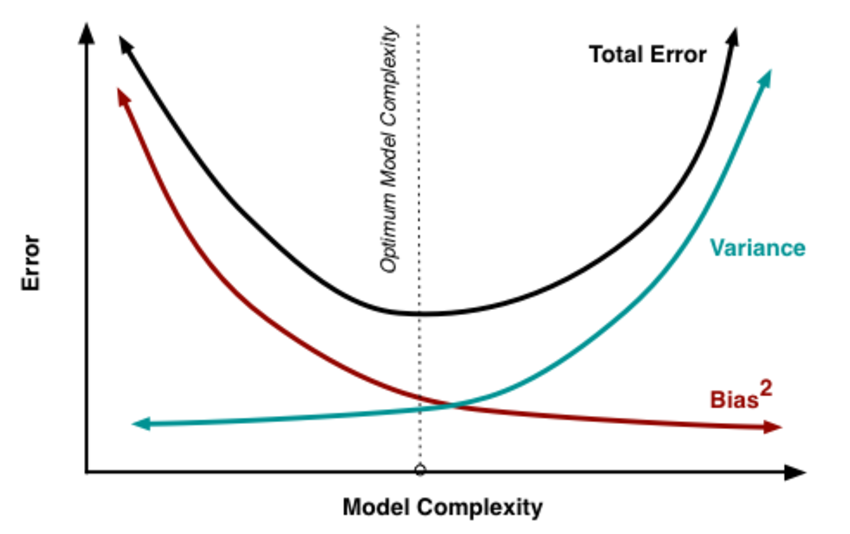
来源:researchgate.net
随着模型复杂度(在线性回归中可理解为预测变量的数量)上升,估计的方差增加,但偏差下降。无偏的 OLS 会把我们置于图的右侧,远非最优。这就是我们进行正则化的原因:以一定偏差换取更低的方差,从而在图上向左移动,趋近最优点。
到目前为止我们得出结论:希望降低模型复杂度,即预测变量的数量。我们可以使用前向或后向选择,但那样就无法说明被剔除变量对响应的影响。将预测变量从模型中移除可看作将其系数设为零。与其强行令其恰为零,不如当它们偏离零过多时给予惩罚,从而以连续的方式将其收缩变小。这样既降低了模型复杂度,又保留了所有变量。这基本上就是岭回归所做的事。
在岭回归中,我们对 OLS 的损失函数进行扩展:不仅最小化残差平方和,还对参数估计的大小进行惩罚,将其向零收缩:
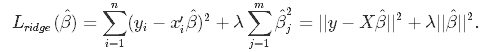
解得 $\hat\beta$ 可得到岭回归估计 $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$,其中 I 为单位矩阵。
λ 参数是正则化惩罚。稍后我们会讨论如何选择它,但此刻请注意:
因此,将 λ 设为 0 与使用 OLS 等价;而 λ 越大,对系数大小的惩罚越强。
将正则化系数引入偏差与方差的公式可得
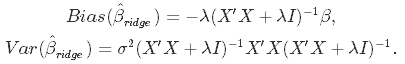
由此可见,随着 λ 增大,方差下降而偏差上升。这引出一个问题:我们愿意接受多大的偏差来换取方差的下降?或者说:λ 的最优取值是多少?
有两种途径可解决这个问题。更传统的方法是选择能使某个信息准则(如 AIC 或 BIC)最小的 λ。更偏机器学习的方法是进行交叉验证,选择让交叉验证残差平方和(或其他度量)最小的 λ。前者强调模型对数据的拟合,后者更关注其预测表现。我们分别讨论。
最小化信息准则
该方法的实操是:用多个不同的 λ 估计模型,选择使赤池或贝叶斯信息准则最小的那个:
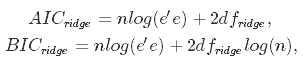
其中 dfridge 为自由度。注意!岭回归的自由度与常规 OLS 不同!这常被忽略,导致推断错误。在 OLS 与岭回归中,自由度均等于所谓帽子矩阵的迹。该矩阵把响应向量映射为拟合值向量:$\hat y = H y$。
在 OLS 中,HOLS = X(X′X)−1X,因此有 dfOLS = trHOLS = m,其中 m 是预测变量个数。而在岭回归中,帽子矩阵的公式应包含正则化惩罚:Hridge = X(X′X + λI)−1X,于是 dfridge = trHridge,这已不再等于 m。有些岭回归软件仍用 OLS 公式计算信息准则。为确保正确,手动计算更稳妥,我们稍后将在本教程中这样做。
最小化交叉验证残差
通过交叉验证选择 λ 时,您应选取一组 P 个待测的 λ 值,将数据集划分为 K 折,并按以下算法进行:
当然,无需自己动手编程——R 已提供专用函数。
在 R 中,glmnet 包已包含实现岭回归所需的一切。我们用著名的 mtcars 数据集演示,任务是根据汽车的其他特征预测每加仑英里数。还有一点:岭回归假定预测变量已标准化、响应已居中!您很快会看到这一假设的原因。现在,我们在建模前先做标准化。
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)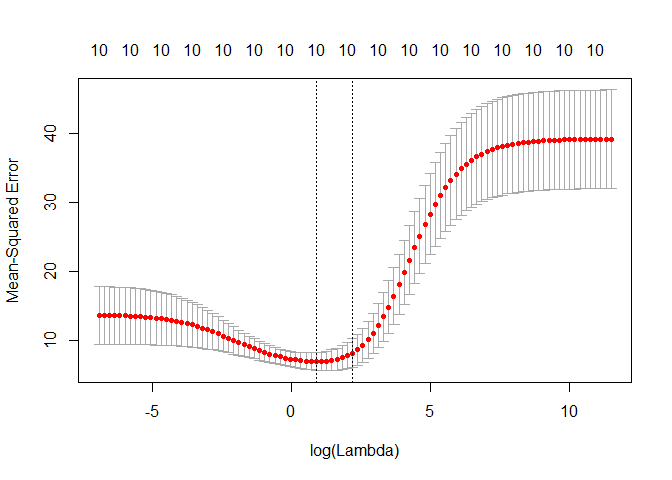
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))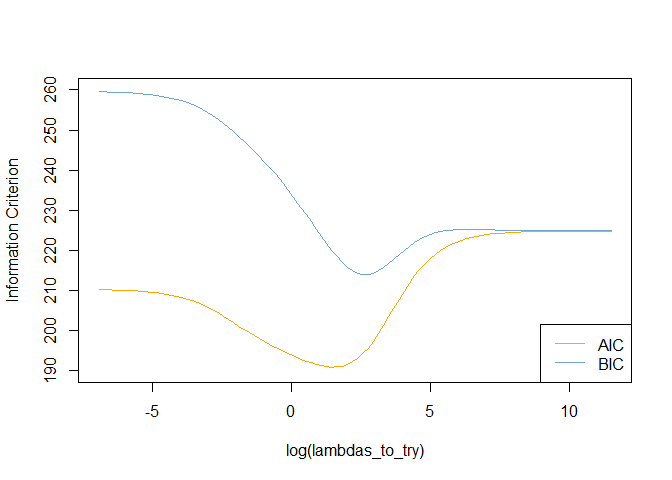
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)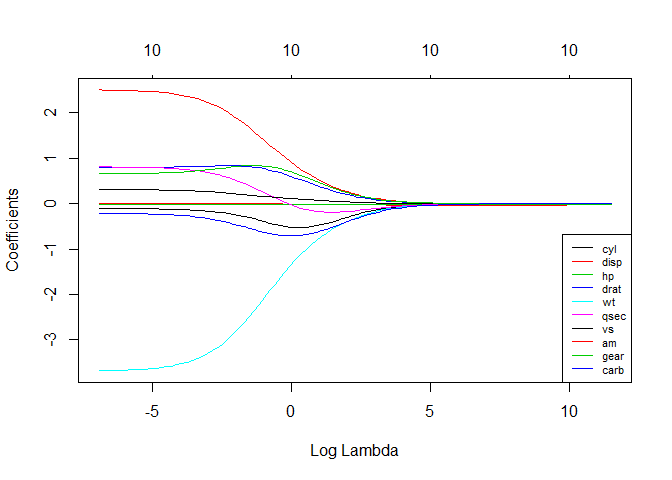
我之前提到过,岭回归假设预测变量被缩放到 z 分数。为什么需要这样做?这种缩放可确保惩罚项对每个系数的惩罚相同,使其呈 $\lambda \sum_{j=1}^m\hat\beta_j^2$ 的形式。若预测变量未标准化,它们的标准差并不都为 1,可以通过一些推导表明,惩罚项会变为 $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$。因此,未标准化的系数会按对应预测变量标准差的倒数加权。我们通过对 X 矩阵缩放来避免这一点,但是……与其通过统一各预测变量的方差来解决异方差问题,我们也可以直接在估计过程中把它们当作权重!这就是差异加权或异方差岭回归的思路。
其核心是通过在损失函数中引入权重,以不同强度惩罚不同系数:
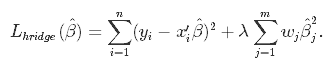
如何选择权重 wj?对所有预测变量分别运行一元回归(响应对单一预测变量),提取系数方差的估计 $\hat\sigma_{j}$,并将其用作权重!这样:
下面是在 R 中的实现。由于 glmnet 尚未实现该方法,我们需要稍作编程。
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RLasso,全称为最小绝对收缩与选择算子,在概念上与岭回归相当相似。它同样对非零系数添加惩罚,但不同于对系数平方和惩罚(L2 惩罚)的岭回归,lasso 对系数绝对值之和(L1 惩罚)进行惩罚。其结果是,当 λ 取较大值时,lasso 会将许多系数直接压到零,而岭回归则不会出现这种情况。
岭回归与 lasso 的损失函数只在惩罚项上不同。对于 lasso,损失定义为:
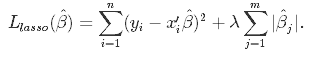
要运行 Lasso 回归,您可以复用 glmnet() 函数,但将 alpha 参数设为 1。
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)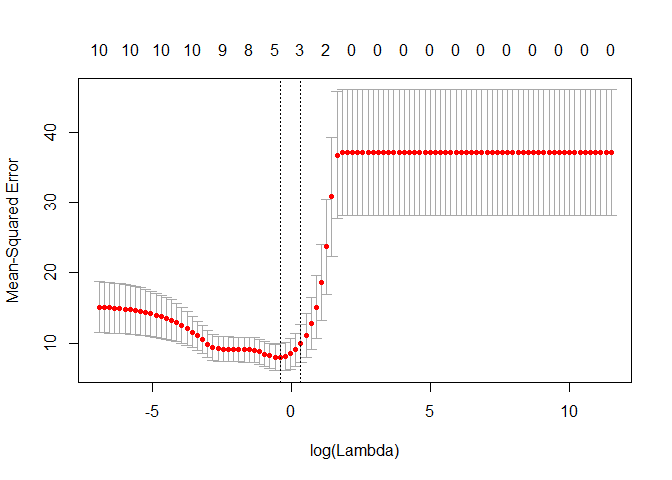
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)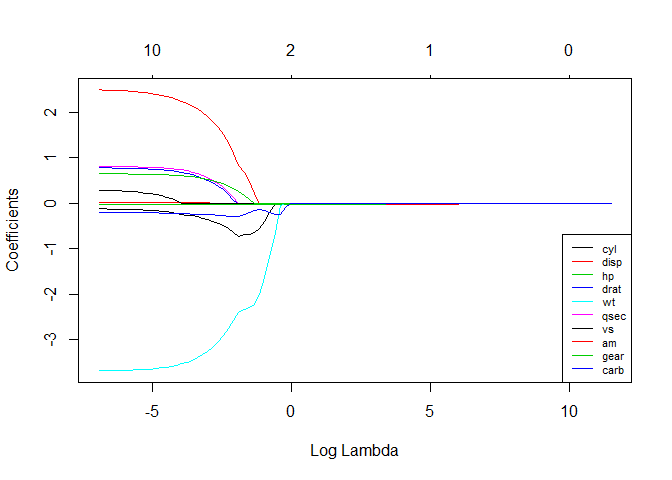
让我们比较一下已估计模型的多重 R 平方!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
在这组数据上,它们的表现看起来相近。请记住,异方差模型尚未调参,lambda 也非最优!关于岭回归和 lasso 的一些更一般性的比较:
弹性网最初源于对 lasso 的批评:其变量选择可能过度依赖数据而不够稳定。解决方案是结合岭回归与 lasso 的惩罚,取两者之长。弹性网旨在最小化以下损失函数:
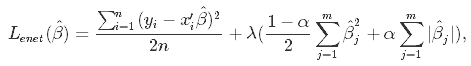
其中 α 是在岭回归(α = 0)与 lasso(α = 1)之间的混合参数。
现在需要调优两个参数:λ 与 α。glmnet 包允许在固定 α 的情况下通过交叉验证调 λ,但不支持 α 的调优,因此我们将借助 caret 来完成这项工作。
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2恭喜您!读到这里,您已经知道:
如果您想进一步学习 R 中的回归,请学习 DataCamp 的 Supervised Learning in R: Regression 课程。也可以查看我们的 Linear Regression in R 和 Logistic Regression in R 教程。