Khóa học
Nhập môn Ngôn ngữ lập trình R
4 giờ
3.1M
Chạy và chỉnh sửa mã từ hướng dẫn trực tuyến này
Chạy mãChúng ta sẽ đề cập cả các thuộc tính toán học của phương pháp lẫn các ví dụ R thực tiễn, kèm thêm một số mẹo và tinh chỉnh. Không dài dòng nữa, bắt đầu thôi!
Hãy khởi động với những điều cơ bản: mô hình hồi quy tuyến tính đơn giản, trong đó bạn muốn dự đoán n quan sát của biến phản hồi, Y, bằng tổ hợp tuyến tính của m biến dự báo, X, và một sai số phân phối chuẩn với phương sai σ2:
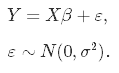
Vì không biết tham số thật, β, ta phải ước lượng chúng từ mẫu. Trong phương pháp Bình phương tối thiểu thông thường (OLS), ta ước lượng chúng là $\hat\beta$ sao cho tổng bình phương phần dư là nhỏ nhất có thể. Nói cách khác, ta cực tiểu hóa hàm mất mát sau:
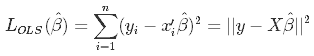
để thu được ước lượng tham số OLS nổi tiếng, $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$.
Trong thống kê, có hai đặc trưng quan trọng của bộ ước lượng cần xét đến: độ chệch (bias) và phương sai. Độ chệch là chênh lệch giữa tham số tổng thể thật và kỳ vọng của ước lượng:
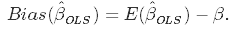
Nó đo lường độ chính xác của ước lượng. Ngược lại, phương sai đo độ phân tán hay mức độ bất định của các ước lượng. Nó được cho bởi
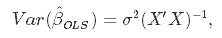
trong đó phương sai sai số chưa biết σ2 có thể được ước lượng từ phần dư như sau
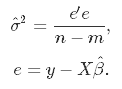
Hình minh họa này cho thấy độ chệch và phương sai là gì. Hãy tưởng tượng hồng tâm là tham số tổng thể thật mà ta đang ước lượng, β, và các phát bắn vào đó là các giá trị ước lượng thu được từ bốn bộ ước lượng khác nhau - độ chệch và phương sai thấp, độ chệch và phương sai cao, và các kết hợp của chúng.
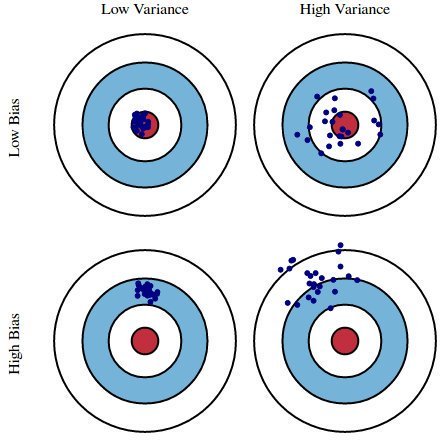
Nguồn: kdnuggets.com
Cả độ chệch và phương sai đều cần thấp, vì giá trị lớn dẫn đến dự đoán kém từ mô hình. Thực ra, lỗi của mô hình có thể được phân rã thành ba phần: lỗi do phương sai lớn, lỗi do độ chệch đáng kể, và phần còn lại - phần không thể giải thích.
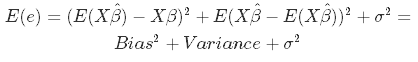
Bộ ước lượng OLS có thuộc tính mong muốn là không chệch. Tuy nhiên, nó có thể có phương sai rất lớn. Cụ thể, điều này xảy ra khi:
Giải pháp chung là: giảm phương sai với cái giá phải trả là đưa vào một chút độ chệch. Cách tiếp cận này gọi là regularization và gần như luôn có lợi cho hiệu năng dự đoán của mô hình. Để trực quan hơn, hãy xem biểu đồ sau.
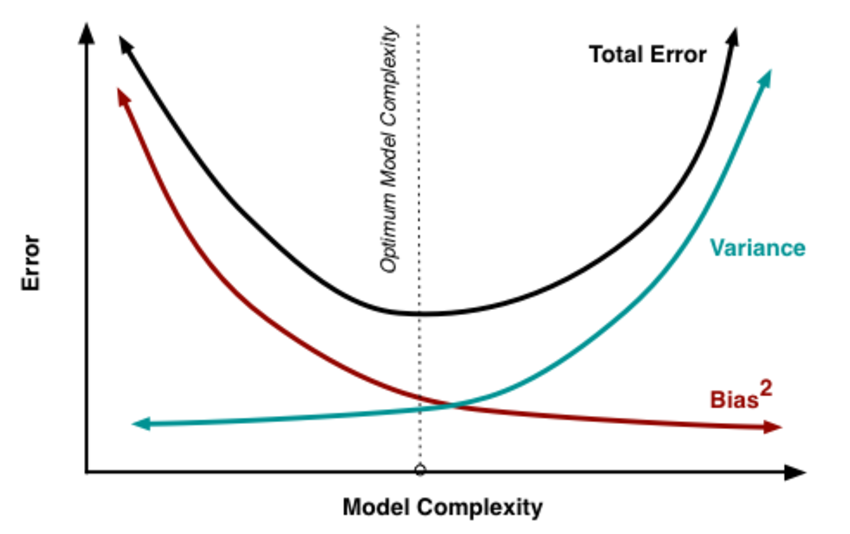
Nguồn: researchgate.net
Khi độ phức tạp của mô hình tăng, mà trong hồi quy tuyến tính có thể hiểu là số lượng biến dự báo, phương sai của ước lượng cũng tăng, nhưng độ chệch giảm. OLS không chệch sẽ đặt chúng ta ở phía bên phải của hình, khá xa tối ưu. Đó là lý do ta regularize: hạ phương sai với cái giá một chút độ chệch, do đó di chuyển sang trái trên biểu đồ, tiến về điểm tối ưu.
Từ thảo luận đến đây, ta kết luận rằng muốn giảm độ phức tạp mô hình, tức là số biến dự báo. Ta có thể dùng chọn biến tiến hoặc lùi, nhưng khi đó ta không nói được gì về ảnh hưởng của các biến đã loại đối với phản hồi. Loại biến khỏi mô hình có thể xem như đặt hệ số của chúng về 0. Thay vì buộc chúng bằng đúng 0, hãy phạt chúng nếu chúng quá xa 0, từ đó ép chúng nhỏ lại một cách liên tục. Bằng cách này, ta giảm độ phức tạp mô hình mà vẫn giữ tất cả biến trong mô hình. Về cơ bản, đó là điều hồi quy Ridge làm.
Trong hồi quy Ridge, hàm mất mát OLS được bổ sung sao cho ta không chỉ cực tiểu tổng bình phương phần dư mà còn phạt độ lớn của ước lượng tham số, nhằm co chúng về 0:
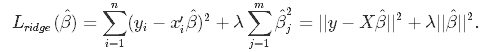
Giải theo $\hat\beta$ cho ta ước lượng ridge $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$, trong đó I là ma trận đơn vị.
Tham số λ là hệ số phạt regularization. Ta sẽ bàn cách chọn nó ở các phần sau, nhưng trước mắt hãy lưu ý rằng:
Vậy, đặt λ bằng 0 tương đương dùng OLS, còn giá trị càng lớn thì mức phạt độ lớn hệ số càng mạnh.
Đưa hệ số regularization vào các công thức độ chệch và phương sai cho ta
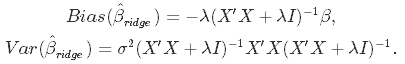
Từ đó thấy rằng khi λ lớn hơn, phương sai giảm, và độ chệch tăng. Điều này đặt ra câu hỏi: ta chấp nhận bao nhiêu độ chệch để giảm phương sai? Hay: giá trị tối ưu của λ là bao nhiêu?
Có hai cách tiếp cận. Cách truyền thống hơn là chọn λ sao cho một tiêu chí thông tin nào đó, ví dụ AIC hoặc BIC, là nhỏ nhất. Cách theo tinh thần machine learning hơn là thực hiện cross-validation và chọn giá trị λ tối thiểu hóa tổng bình phương phần dư đã cross-validate (hoặc thước đo khác). Cách thứ nhất nhấn mạnh mức độ khớp dữ liệu của mô hình, trong khi cách thứ hai tập trung hơn vào hiệu năng dự đoán. Hãy bàn cả hai.
Tối thiểu hóa tiêu chí thông tin
Cách này quy về ước lượng mô hình với nhiều giá trị λ khác nhau và chọn giá trị làm nhỏ nhất Tiêu chí Thông tin Akaike hoặc Bayes:
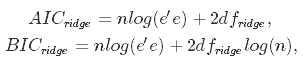
trong đó dfridge là số bậc tự do. Lưu ý! Số bậc tự do trong hồi quy ridge khác với trong OLS thông thường! Điều này hay bị bỏ qua dẫn đến suy luận sai. Trong cả OLS và ridge, bậc tự do bằng vết (trace) của cái gọi là ma trận mũ, là ma trận ánh xạ vectơ giá trị phản hồi sang vectơ giá trị khớp theo: $\hat y = H y$.
Trong OLS, ta có HOLS = X(X′X)−1X, suy ra dfOLS = trHOLS = m, trong đó m là số biến dự báo. Tuy nhiên, trong ridge, công thức ma trận mũ phải bao gồm hệ số phạt regularization: Hridge = X(X′X + λI)−1X, dẫn tới dfridge = trHridge, không còn bằng m. Một số phần mềm ridge đưa ra tiêu chí thông tin dựa trên công thức OLS. Để chắc chắn làm đúng, an toàn hơn là tự tính thủ công, điều mà ta sẽ làm ở phần sau của hướng dẫn.
Tối thiểu hóa phần dư đã cross-validate
Để chọn λ qua cross-validation, bạn chọn một tập P giá trị λ để thử, chia bộ dữ liệu thành K fold, và làm theo thuật toán sau:
Tất nhiên, không cần tự lập trình - R đã có đầy đủ hàm chuyên dụng.
Trong R, gói glmnet có mọi thứ bạn cần để triển khai ridge. Ta sẽ dùng bộ dữ liệu mtcars nổi tiếng để minh họa, với nhiệm vụ dự đoán miles per gallon dựa trên các đặc tính khác của xe. Thêm một điểm nữa: hồi quy ridge giả định các biến dự báo đã được chuẩn hóa và biến phản hồi được lấy trung bình! Bạn sẽ thấy vì sao giả định này cần thiết ngay sau đây. Trước mắt, ta sẽ chuẩn hóa trước khi mô hình hóa.
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)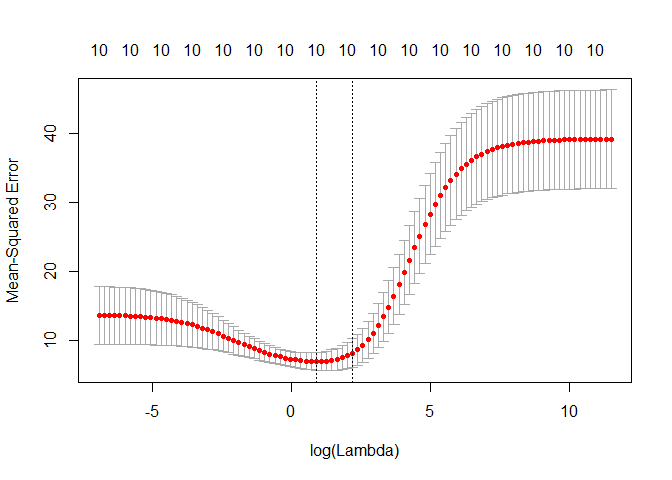
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))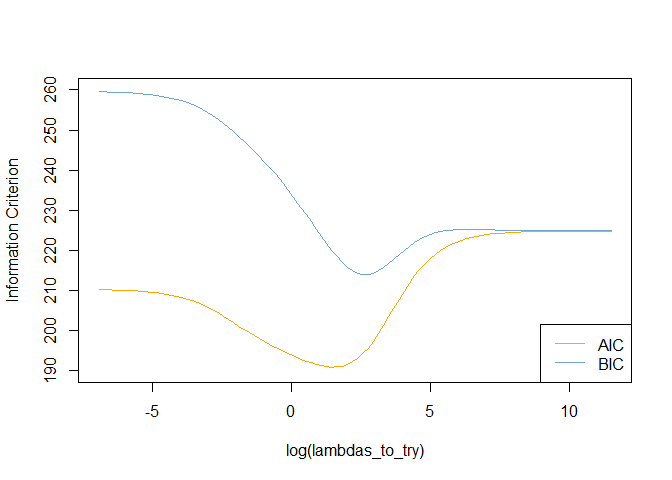
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)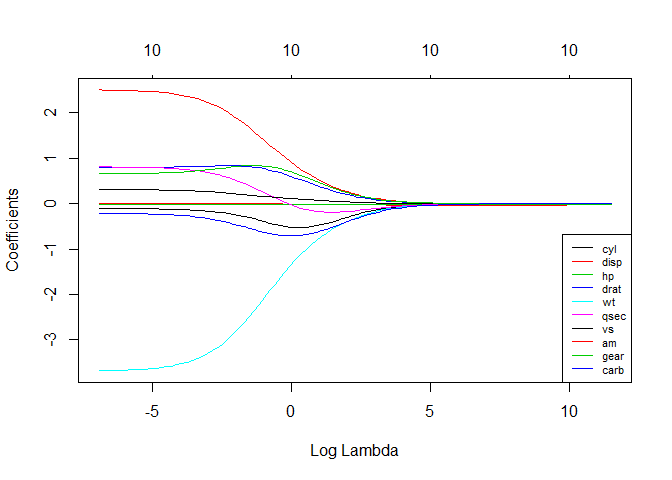
Tôi đã nhắc trước rằng hồi quy ridge giả định các biến dự báo được chuẩn hóa về z-score. Vì sao cần vậy? Việc chuẩn hóa đảm bảo hạng mục phạt trừng phạt mỗi hệ số như nhau để có dạng $\lambda \sum_{j=1}^m\hat\beta_j^2$. Nếu các biến dự báo không được chuẩn hóa, độ lệch chuẩn của chúng không bằng 1, và có thể chứng minh rằng điều này dẫn tới hạng mục phạt có dạng $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$. Như vậy, các hệ số chưa chuẩn hóa sẽ được trọng số theo nghịch đảo độ lệch chuẩn của biến dự báo tương ứng. Ta chuẩn hóa ma trận X để tránh điều này, nhưng... Thay vì giải bài toán không đồng nhất phương sai bằng cách làm bằng nhau phương sai của mọi biến dự báo qua chuẩn hóa, ta cũng có thể dùng chính chúng làm trọng số trong quá trình ước lượng! Đây là ý tưởng phía sau Hồi quy Ridge phân trọng hay Hồi quy Ridge không đồng nhất phương sai.
Ý tưởng là phạt các hệ số khác nhau với cường độ khác nhau bằng cách đưa trọng số vào hàm mất mát:
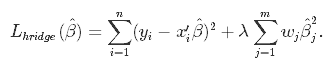
Chọn trọng số wj thế nào? Chạy một tập hồi quy đơn biến (phản hồi so với từng biến dự báo) cho tất cả biến dự báo, trích xuất ước lượng phương sai của hệ số, $\hat\sigma_{j}$, và dùng nó làm trọng số! Cách này:
Dưới đây là cách làm trong R. Vì phương pháp này chưa có trong glmnet, ta sẽ cần chút lập trình.
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RLasso, hay Least Absolute Shrinkage and Selection Operator, về khái niệm khá giống ridge. Nó cũng thêm phạt cho các hệ số khác 0, nhưng khác với ridge phạt tổng bình phương hệ số (phạt L2), lasso phạt tổng trị tuyệt đối của chúng (phạt L1). Hệ quả là, với giá trị λ cao, nhiều hệ số sẽ bị đặt về đúng 0 dưới lasso, điều không bao giờ xảy ra trong ridge.
Khác biệt duy nhất giữa hàm mất mát của ridge và lasso là ở hạng mục phạt. Với lasso, mất mát được định nghĩa là:
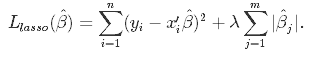
Để chạy Hồi quy Lasso bạn có thể dùng lại hàm glmnet(), nhưng đặt tham số alpha bằng 1.
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)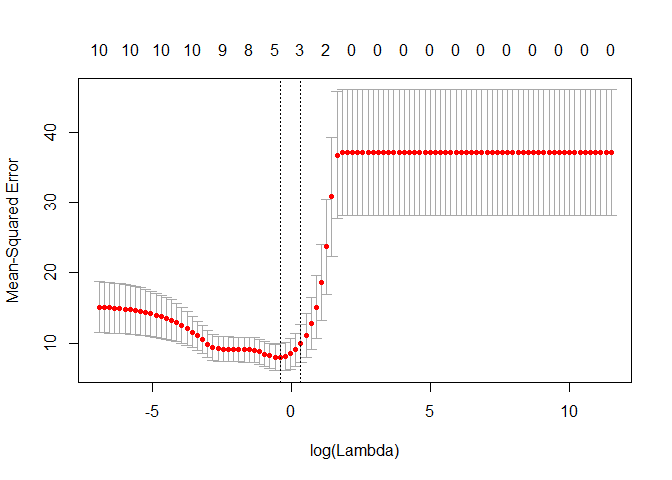
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)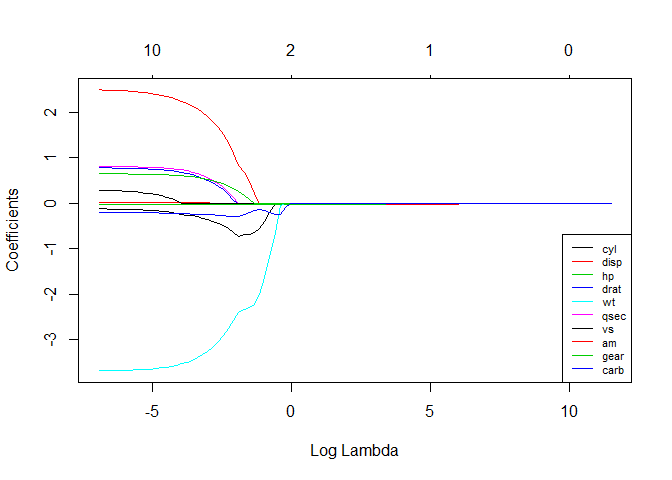
Hãy so sánh hệ số xác định R-bình phương của các mô hình đã ước lượng!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
Có vẻ chúng cho hiệu năng tương tự trên dữ liệu này. Hãy nhớ, mô hình không đồng nhất phương sai chưa được tinh chỉnh, và lambda chưa tối ưu! Một vài nhận xét tổng quát hơn về so sánh ridge và lasso:
Elastic Net ra đời từ phê bình đối với lasso, khi việc chọn biến có thể quá phụ thuộc dữ liệu và do đó thiếu ổn định. Giải pháp là kết hợp các hạng mục phạt của ridge và lasso để hưởng lợi từ cả hai. Elastic Net hướng tới cực tiểu hóa hàm mất mát sau:
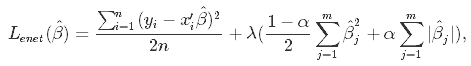
trong đó α là tham số trộn giữa ridge (α = 0) và lasso (α = 1).
Giờ đây có hai tham số cần tinh chỉnh: λ và α. Gói glmnet cho phép tinh chỉnh λ bằng cross-validation với α cố định, nhưng không hỗ trợ tinh chỉnh α, vì vậy ta sẽ dùng caret cho việc này.
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2Chúc mừng! Nếu bạn đã đọc đến đây, bạn đã biết rằng:
Nếu bạn muốn học thêm về hồi quy trong R, hãy tham gia khóa Supervised Learning in R: Regression của DataCamp. Cũng đừng bỏ qua các hướng dẫn Linear Regression in R và Logistic Regression in R của chúng tôi.
Khóa học R
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
